

Doporučuji se seznámit s přepisem přednášky z počátku roku 2016 od Vladimíra Sitnikova "PostgreSQL a JDBC - vymačkáme z toho maximum"
Dobrý den! Jmenuji se Vladimír Sitnikov. Pracuji 10 let ve společnosti NetCracker. Hlavně se zabývám výkonem. Vše, co souvisí s Javou, a vše, co souvisí se SQL - to je to, co mám rád.
Dnes vám povím o tom, s čím jsme se v naší společnosti setkali, když jsme začali používat PostgreSQL jako server databází. Hlavně pracujeme s Javou. To, co dnes řeknu, však souvisí nejen s Javou. Jak praxe ukázala, objevuje se to i v jiných jazycích.
Budeme mluvit o:
- výběru dat.
- o ukládání dat.
- a také o výkonu.
- a o úskalích, která tam jsou skryta.
Začněme jednoduchou otázkou. Vybereme jeden řádek z tabulky podle primárního klíče.
Databáze se nachází na stejném hostiteli. A to vše trvá 20 milisekund.
Těchto 20 milisekund je opravdu hodně. Pokud máte takových 100 dotazů, pak ztrácíte čas v sekundách na to, abyste tyto dotazy zpracovali, tedy zbytečně trávíte čas.
Tohle nemáme rádi a podíváme se, co nám databáze nabízí. Databáze nám nabízí dva způsoby provádění dotazů.
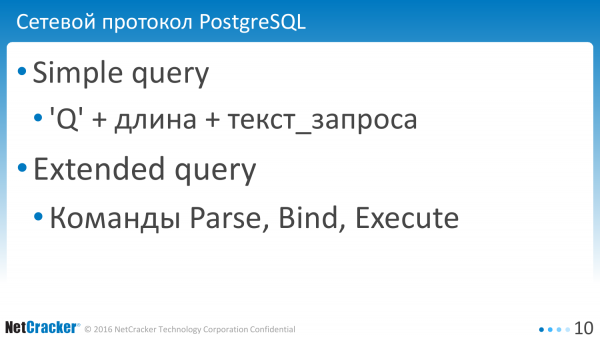
První možnost je jednoduchý dotaz. Čím je dobrý? Tím, že ho vezmeme a odešleme, a nic víc.
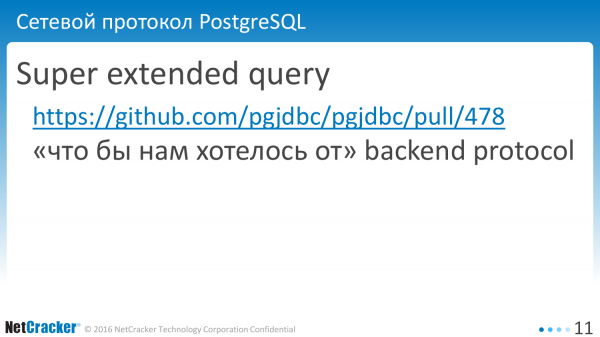
Databáze má také rozšířený dotaz, který je složitější, ale funkčnější. Můžete samostatně posílat dotazy na analýzu, provedení, propojení proměnných atd.
Super rozšířený dotaz - to je něco, co nebudeme pokrývat v této přednášce. Možná máme od databáze nějaké požadavky a existuje seznam přání, který byl nějak sestaven, tedy to, co chceme, ale teď a v příštím roce to není možné. Takže jsme to jen zapsali a budeme chodit a třást hlavními lidmi.
To, co můžeme udělat, je - jednoduchý dotaz a rozšířený dotaz.
Jaké jsou zvláštnosti každého přístupu?
Jednoduchý dotaz je dobré použít pro jednorázové provedení. Jednou provedeno a zapomenuto. A problém je v tom, že nepodporuje binární formát dat, tedy pro některé vysoce výkonné systémy není vhodný.
Rozšířené dotazy - umožňují ušetřit čas při analýze. To je to, co jsme udělali a začali používat. Velmi nám to pomohlo. Nejde jen o úsporu při analýze. Je tu také úspora při přenosu dat. Přenášení dat ve binárním formátu je mnohem efektivnější.
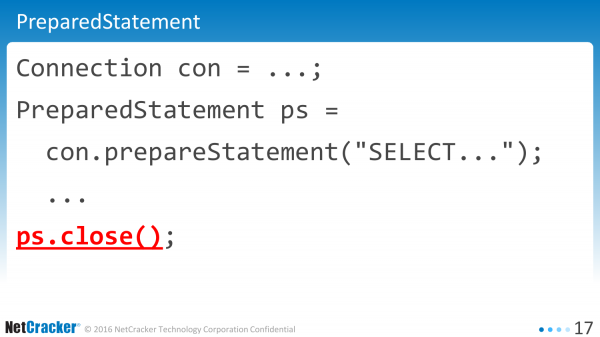
Přejdeme k praxi. Takto vypadá typická aplikace. Může to být Java atd.
Vytvořili jsme statement. Provedli jsme příkaz. Vytvořili jsme close. Kde je chyba? Jaký je problém? Nejsou žádné problémy. Tak je napsáno ve všech knihách. Tak to je třeba psát. Pokud chcete maximální výkon, pište tak.
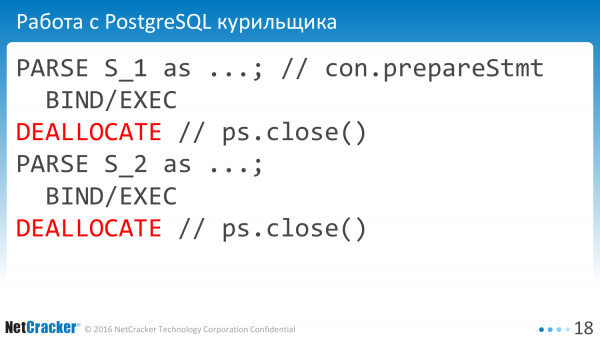
Ale praxe ukázala, že to nefunguje. Proč? Protože máme metodu „close“. A když to děláme, pak z pohledu databáze to vypadá, jako by kuřák pracoval s databází. Řekli jsme „PARSE EXECUTE DEALLOCATE“.
Proč ty zbytečné vytváření a vykládání statements? Nikdo je nepotřebuje. Ale obvykle v PreparedStatement to tak funguje, když je zavíráme, zavírají všechno v databázi. To není to, co chceme.
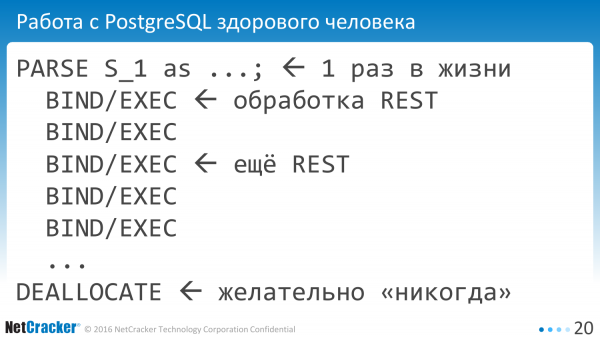
Chceme, jako zdraví lidé, pracovat s databází. Jednou jsme vzali a připravili náš statement, poté ho vykonáváme mnohokrát. Ve skutečnosti mnohokrát znamená jednou za celý život aplikace jsme ho analyzovali. A na různých REST používáme stejný id statementu. To je náš cíl.
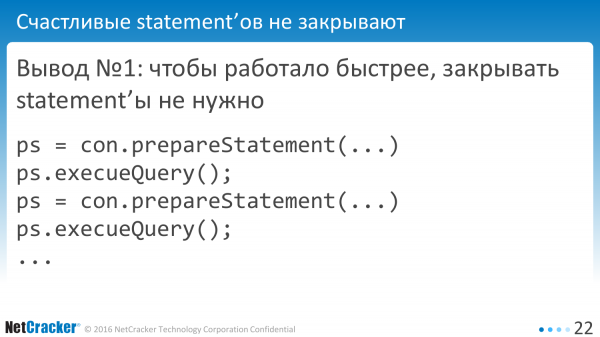
Jak toho dosáhnout?
Velmi jednoduše - není třeba zavírat statements. Píšeme takto: „prepare“ „execute“.
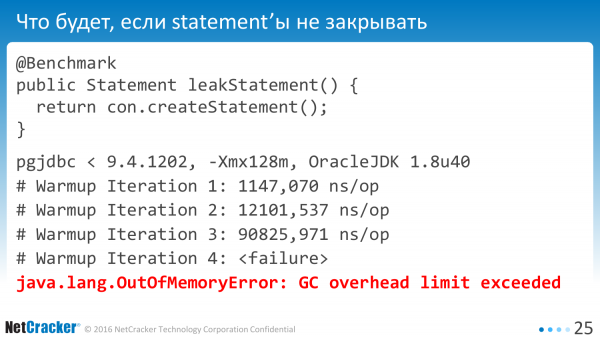
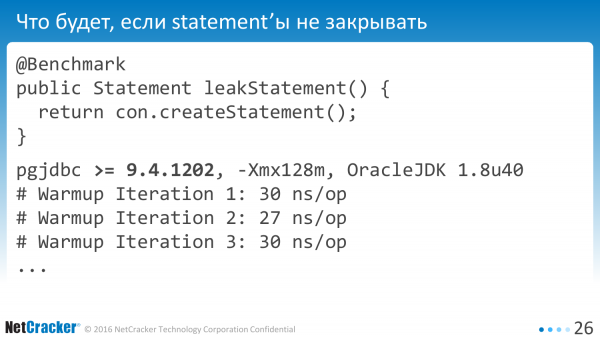
Pokud toto spustíme, je jasné, že někde něco přeteče. Pokud není jasné, tak to můžeme změřit. Vezmeme a napíšeme benchmark, ve kterém bude taková jednoduchá metoda. Vytvoříme statement. Spustíme na nějaké verzi ovladače a zjistíme, že docela rychle selhává s ztrátou veškeré paměti, kterou máme.
Je jasné, že takové chyby se snadno opravují. O těchto nebudu mluvit. Ale řeknu, že v nové verzi to funguje mnohem rychleji. Metoda je bezvýznamná, ale i tak.
Jak pracovat správně? Co pro to musíme udělat?
Ve skutečnosti aplikace vždy zavírají statements. Ve všech knihách píší, že je mají zavírat, jinak dojde k úniku paměti.
A PostgreSQL neumí cachovat dotazy. Každá sezení si musí sama vytvářet tento cache.
A čas na analýzu také nechceme trávit.
A jak obvykle máme dvě možnosti.
První možnost – vezmeme a řekneme, že všechno zabalíme do PgSQL. Tam je cache. Všechno to cachuje. Dopadne to skvěle. Na to jsme se podívali. Máme 100500 dotazů. Nefunguje to. Nesouhlasíme – ručně převádět dotazy do procedur. Ne, ne.
Máme druhou možnost – vzít a sami to napsat. Otevřeme zdrojové kódy, začneme pracovat. Pracujeme a pracujeme. Ukázalo se, že to není tak složité udělat.
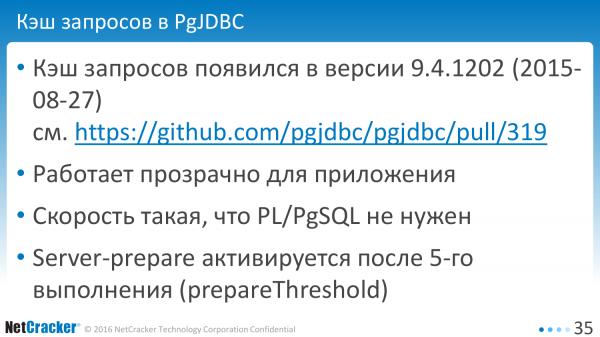
To se objevilo v srpnu 2015. Teď už je to modernější verze. A všechno je skvělé. Funguje to tak dobře, že nic v aplikaci neměníme. A dokonce jsme přestali uvažovat o PgSQL, tj. toho máme dost, abychom všechny režijní náklady snížili prakticky na nulu.
Server-prepared statements se aktivují při pátém provedení, aby se šetřily paměť v databázi na každý jednorázový dotaz.
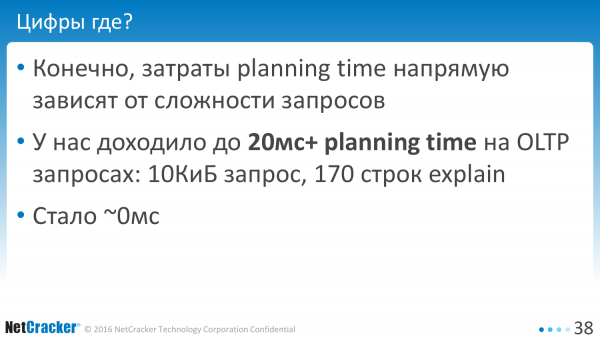
Můžete se zeptat – kde jsou čísla? Co dostáváte? A zde čísla nedám, protože pro každý dotaz jsou jiná.
Naše dotazy byly takové, že jsme na OLTP dotazech trávili asi 20 milisekund na parsování. Tam bylo 0,5 milisekundy na provedení, 20 milisekund na parsování. Dotaz – 10 KiB textu, 170 řádků plánu. To je OLTP dotaz. Dotazuje se na 1, 5, 10 řádků, někdy více.
Ale vůbec jsme nechtěli trávit 20 milisekund. Snížili jsme to na 0. Všechno je skvělé.
Co si odtud můžete odnést? Pokud máte Java, vezmete moderní verzi ovladače a radujete se.
Pokud máte nějaký jiný jazyk, tak si promyslete – možná to také potřebujete? Protože z pohledu koncového jazyka, například, pokud máte PL 8 nebo LibPQ, není vám jasné, že trávíte čas ne na provedení, ale na parsování a to stojí za to ověřit. Jak? Vše zdarma.
S výjimkou toho, že jsou chyby, nějaké zvláštnosti. A o těch budeme mluvit právě teď. Většina bude o průmyslové archeologii, o tom, co jsme našli, na co jsme narazili.
Pokud se dotaz generuje dynamicky. To se stává. Někdo skládá řetězce, vzniká SQL dotaz.
Proč je špatný? Je špatný tím, že každý čas máme na konci jiný řetězec.
I u tohoto různorodého řetězce je potřeba znovu spočítat hashCode. To je skutečně úkol pro CPU – najít dlouhý text dotazu v již existujícím hashi není tak jednoduché. Proto je jednoduché doporučení – negenerujte dotazy. Uchovávejte je v nějaké jedné proměnné. A radujte se.
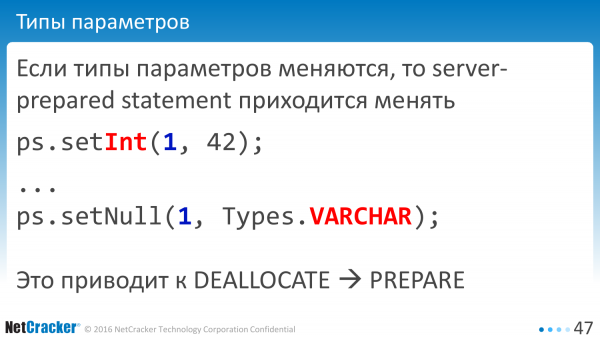
Další problém. Typy dat jsou důležité. Existují ORM, které tvrdí, že na tom nezáleží, jaký je NULL, ať je to nějaký. Pokud je to Int, říkáme setInt. A pokud je NULL, ať je to vždy VARCHAR. A nakonec, jaký je vlastně rozdíl, jaký tam je NULL? Databáze si to stejně všechno pochopí. A taková situace nefunguje.
V praxi databáze rozhodně není lhostejná. Pokud jste poprvé řekli, že to máte číslo, a podruhé jste řekli, že to je VARCHAR, není možné znovu použít serverem připravené příkazy. A v takovém případě se musíme znovu vytvořit náš příkaz.
Pokud provádíte stejný dotaz, dbejte na to, abyste měli typy dat ve sloupcích neuspořádané. Je třeba dávat pozor na NULL. To je častá chyba, která se nám stala poté, co jsme začali používat PreparedStatements.
Dobře, zapnuli jsme to. Vzali jsme možná ovladač. A výkon klesl. Všechno se zhoršilo.
Jak se to může stát? Je to chyba nebo funkce? Bohužel se nám nepodařilo pochopit – je to chyba nebo funkce. Ale existuje zcela jednoduchý scénář pro reprodukci tohoto problému. Naprosto nečekaně nás to přepadlo. A spočívá to v výběru doslova z jedné tabulky. Samozřejmě, že takových dotazů jsme měli víc. Většinou zahrnovaly dvě až tři tabulky, ale existuje tento scénář reprodukce. Vezmete na vaší databázi jakoukoli verzi a reprodukujete.
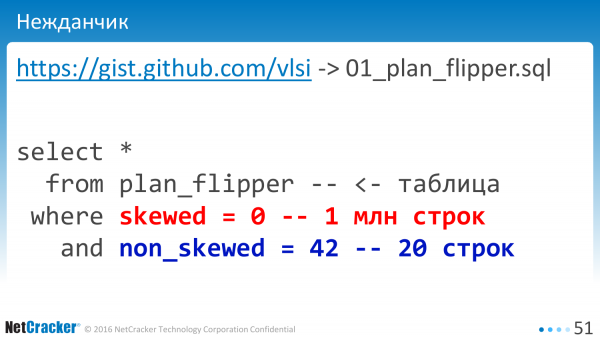
Smyslem je, že máme dva sloupce, z nichž každý je indexován. V jednom sloupci je podle hodnoty NULL milion řádků. A ve druhém sloupci je celkem 20 řádků. Když provádíme bez vázaných proměnných, všechno funguje dobře.
Pokud začneme provádět s vázanými proměnnými, tj. provádíme znak „?“ nebo „$1“ pro náš dotaz, co na konec dostaneme?
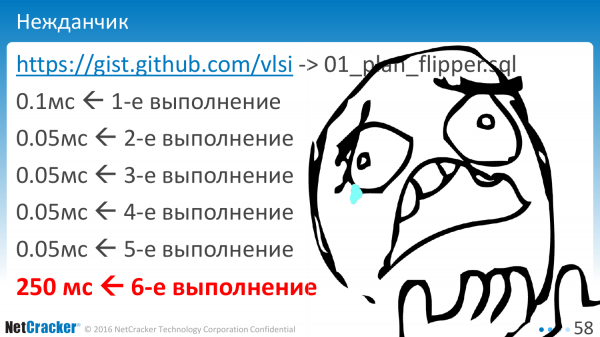
První provádění – jak má být. Druhé – trochu rychlejší. Něco bylo uloženo do cache. Třetí-čtvrté-páté. Pak bum – a nějak to takhle. A nejhorší je, že se to stává při šestém provádění. Kdo věděl, že je potřeba dělat přesně šest provádění, abychom pochopili, jaký je skutečný plán provádění?
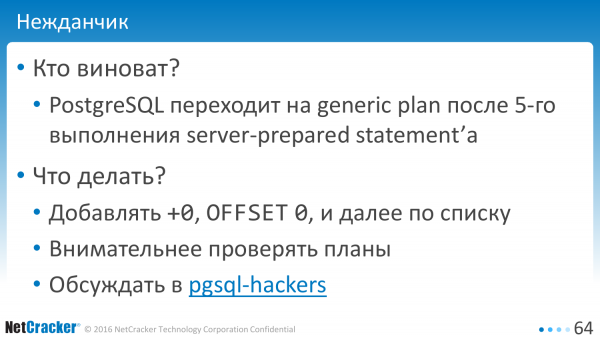
Kdo je vinen? Co se stalo? Databáze obsahuje optimalizaci. A je jaksi optimalizována pro obecný případ. A začínaje od určitého okamžiku se přesune na obecný plán, který, bohužel, může být jiný. Může být stejný, ale také jiný. A existuje nějaká prahová hodnota, která vede k takovému chování.
Co s tím lze dělat? Tady je pochopitelně složité něco předpokládat. Existuje jednoduché řešení, které používáme. To je +0, OFFSET 0. Určitě taková řešení znáte. Prostě vezmeme a do dotazu přidáme „+0“ a vše je v pořádku. Ukážu později.
A je tu ještě jedna možnost – pečlivěji se dívat na plány. Vývojář by měl nejen napsat dotaz, ale také 6krát říct „explain analyze“. Pokud 5krát, tak to nebude vyhovovat.
A existuje i třetí možnost – napsat dopis na pgsql-hackers. Napsal jsem to, ale zatím není jasné, jestli je to chyba, nebo funkce.
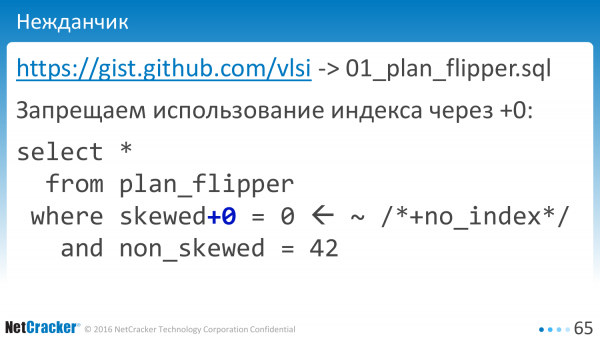
Zatímco přemýšlíme – jestli je to chyba nebo funkce, pojďme to opravit. Vezmeme náš dotaz a přidáme „+0“. Vše je v pořádku. Dva symboly a ani nemusíme přemýšlet, jak to tam a co tam. Velmi jednoduché. Jen jsme databázi znemožnili použít index na tomto sloupci. Nemáme index na sloupci „+0“ a hotovo, databáze nepoužívá index, vše je v pořádku.
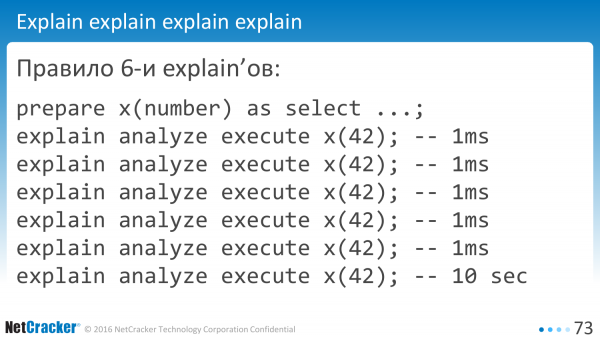
Toto je pravidlo 6 explainů. V aktuálních verzích je třeba to udělat 6krát, pokud máte propojené proměnné. Pokud nemáte propojené proměnné, děláme to takto. A nakonec právě tento dotaz selhává. Není to složité.
Zdálo by se, kolik toho ještě může být? Tady je chyba, tam je chyba. Opravuji, chyba je všude.
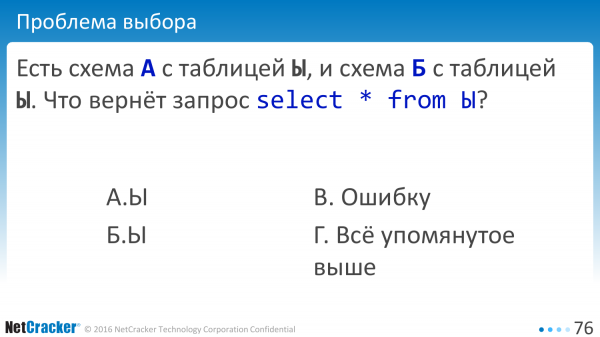
Podívejme se znovu. Například máme dvě schémata. Schéma A se tabulkou Y a schéma B se tabulkou Y. Dotaz – vybrat data z tabulky. Co nám při tom vznikne? Budeme mít chybu. Budeme mít všechno, co bylo zmíněno výše. Pravidlo je takové – chyba je všude, budeme mít vše, co je uvedeno výše.
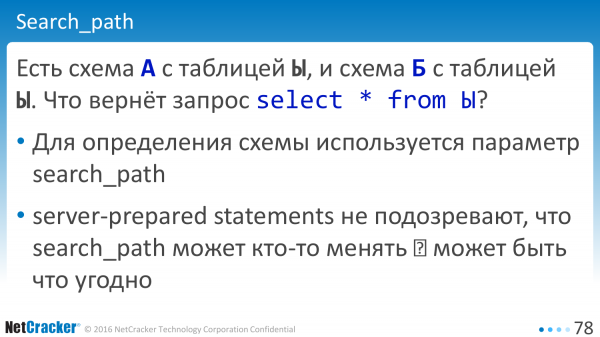
Teď otázka: „Proč?“. Zdálo by se, že existuje dokumentace, která říká, že pokud máme schéma, existuje proměnná „search_path“, která určuje, kde hledat tabulku. Zdálo by se, že proměnná existuje.
Jaký je problém? Problém je v tom, že server-prepared statements netuší, že search_path může někdo měnit. Tato hodnota zůstává jakoby konstantní pro databázi. A některé části nemusí zachytit nové hodnoty.
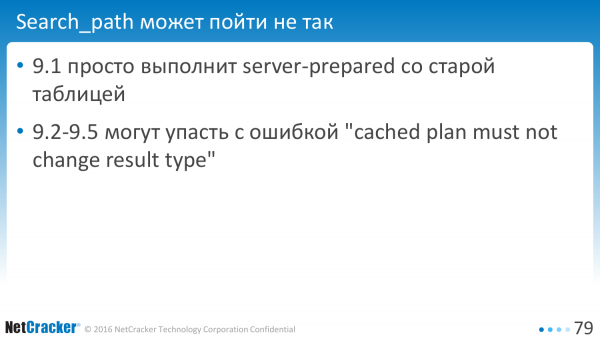
Samozřejmě, záleží na verzi, na které testujete. Záleží na tom, jak moc se vaše tabulky liší. A verze 9.1 prostě zpracuje staré dotazy. Nové verze mohou odhalit úskok a říct, že máte chybu.
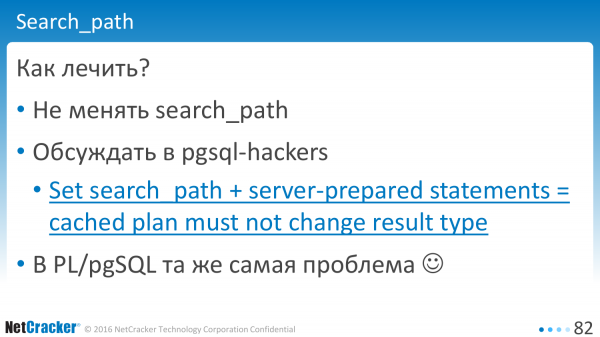
Jak to napravit? Je tu jednoduchý recept - nedělejte to. Neměli byste měnit search_path za běhu aplikace. Pokud to změníte, je lepší vytvořit nové připojení.
Můžeme o tom diskutovat, tj. otevřít, probrat, doplnit. Možná přesvědčíme vývojáře databáze, že v případě, kdy někdo změní hodnotu, by databáze měla klientovi říct: „Podívejte, vaše hodnota se aktualizovala. Možná byste měli resetovat, znovu vytvořit statements.“. Nyní se databáze chová skrytě a nijak neoznamuje, že se někde uvnitř statements změnily.
A znovu zdůrazním - to není typické pro Java. Totéž uvidíme v PL/pgSQL jeden k jednomu. Ale tam se to reprodukuje.
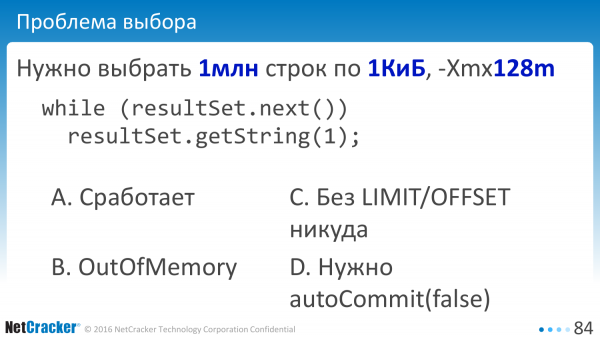
Pojďme zkusit zvolit další data. Vybíráme. Máme tabulku s milionem řádků. Každý řádek má kilobajt. Přibližně gigabajt dat. A máme pracovní paměť v Java stroji 128 megabajtů.
Jak je doporučeno ve všech knihách, používáme proudovou zpracování. Tj. otevřeme resultSet a čteme data po částech. Bude to fungovat? Nepadneme z důvodu nedostatku paměti? Bude to číst po trochu? Pojďme věřit databázi, důvěřujme Postgresu. Nedůvěřujeme. Spadneme OutOfMemory? Kdo měl OutOfMemory? A kdo to po tom dokázal opravit? Někdo to opravil.
Pokud máte milion řádků, není možné vybírat jen tak. Musíte určitě použít OFFSET/LIMIT. Kdo podporuje tuto variantu? A kdo podporuje variantu, že je třeba si hrát s autoCommit?
Zde se jako obvykle ukazuje, že nejneočekávanější varianta je správná. A pokud náhodou vypnete autoCommit, pomůže to. Proč? Věda o tom neví.
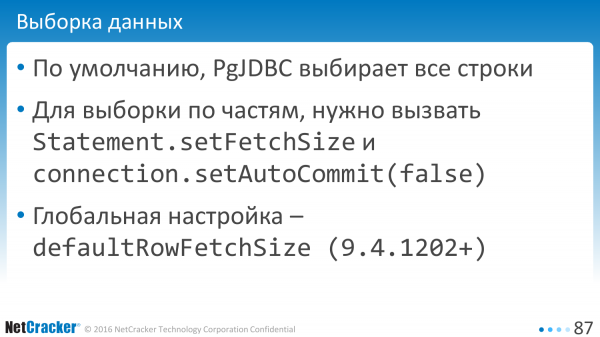
Ale ve výchozím nastavení všichni klienti, kteří se připojují k databázi Postgres, vybírají data kompletně. PgJDBC v tomhle směru není výjimka, vybírá všechny řádky.
Existuje varianta na téma FetchSize, tj. můžete na úrovni jednotlivého statementu říct, že zde, prosím, vybírejte data po 10, 50. Ale to nefunguje, dokud nevypnete autoCommit. Vypnuli jste autoCommit – začne to fungovat.
Chodit po kódu a všude nastavit setFetchSize je nepraktické. Proto jsme udělali takové nastavení, které pro celé připojení říká výchozí hodnotu.
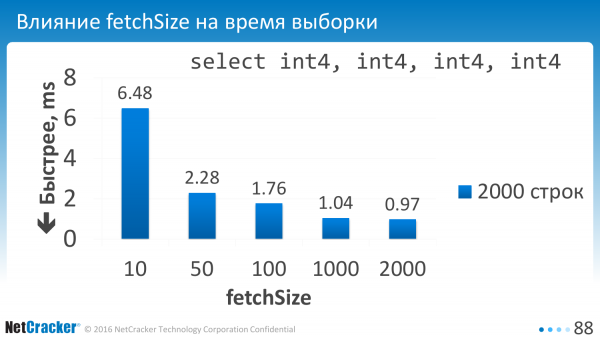
Takhle jsme to řekli. Nastavili jsme parametr. A co jsme získali? Pokud vybíráme málo, například po 10 řádcích, máme docela velké režijní náklady. Proto je třeba tuto hodnotu nastavit na přibližně sto.
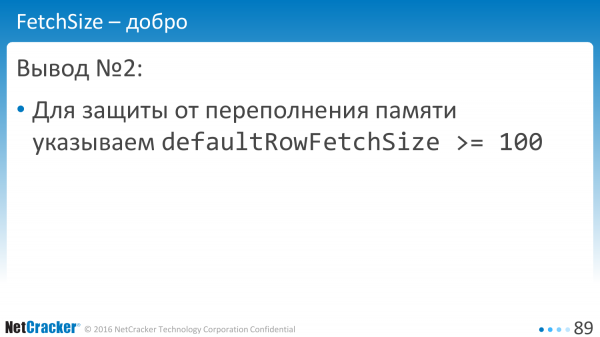
Ideálně, samozřejmě, se ještě naučit omezit na bajty, ale recept je následující: nastavíme defaultRowFetchSize na více než sto a radujeme se.
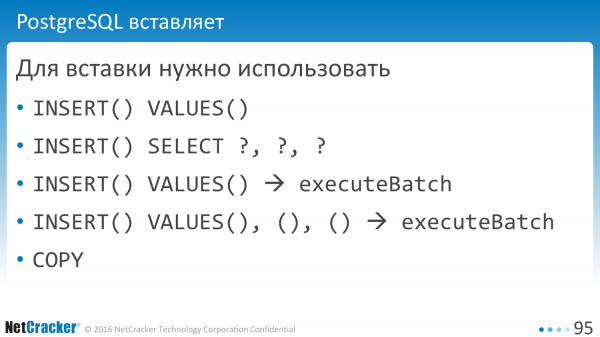
Přejděme k vkládání dat. Vkládání je jednodušší, jsou tu různé varianty. Například, INSERT, VALUES. To je dobrá varianta. Můžeme mluvit o „INSERT SELECT“. Prakticky to je to samé. Není žádný rozdíl v výkonu.
Knihy říkají, že je třeba provádět dávková prohlášení, knihy říkají, že je možné provádět složitější příkazy s několika závorkami. A v Postgres je skvělá funkce — můžete provádět COPY, tj. dělat to rychleji.

Pokud to změříme, můžeme udělat několik zajímavých objevů. Jak chceme, aby to fungovalo? Chceme nepřetěžovat a nevykonávat zbytečné příkazy.
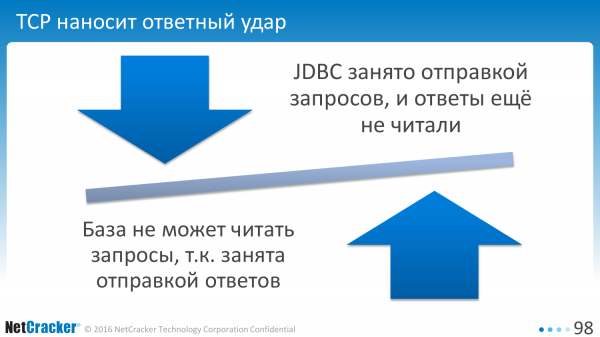
V praxi nám to TCP takto nedovoluje. Pokud je klient zaneprázdněn odesíláním požadavku, databáze se pokouší poslat nám odpovědi, požadavky nečte. Výsledkem je, že klient čeká na databázi, dokud si přečte požadavek, a databáze čeká na klienta, dokud si přečte odpověď.
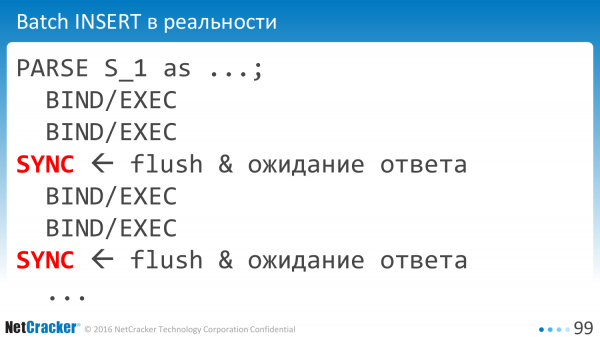
A proto je klient nucen periodicky posílat synchronizační paket. Zbytečné síťové interakce, zbytečné ztráty času.
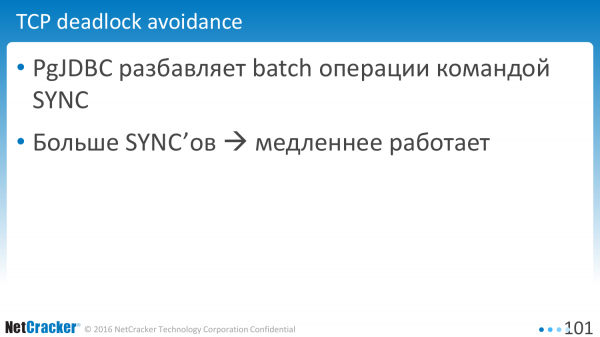 A čím více jich přidáváme, tím hůře to je. Ovladač je velmi pesimistický a přidává je poměrně často, přibližně jednou za 200 řádků, v závislosti na velikosti řádků atd.
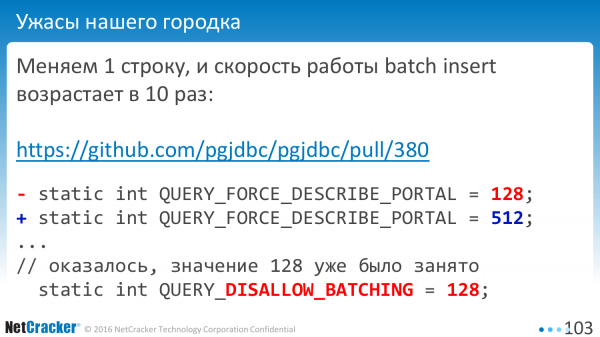
Někdy stačí opravit pouze jeden řádek a vše se zrychlí desetkrát. Takové věci se stávají. Proč? Jak obvykle, někde už byla použita podobná konstanta. A hodnota „128“ znamenala — nepoužívat dávkování.
Je dobře, že to neprošlo do oficiální verze. Objevili jsme to dříve, než jsme začali vydávat verzi. Všechny hodnoty, které uvádím, vycházejí z moderních verzí.
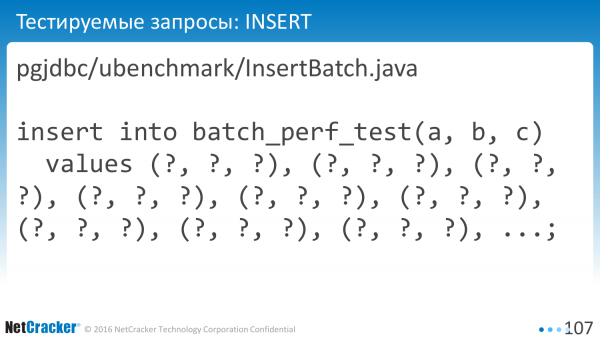
Změřme to. Měříme jednoduchý InsertBatch. Měříme vícečetný InsertBatch, tj. to samé, ale s mnoha hodnotami. Chytrý krok. Ne každý to umí, ale je to takový jednoduchý krok, mnohem snadnější než COPY.
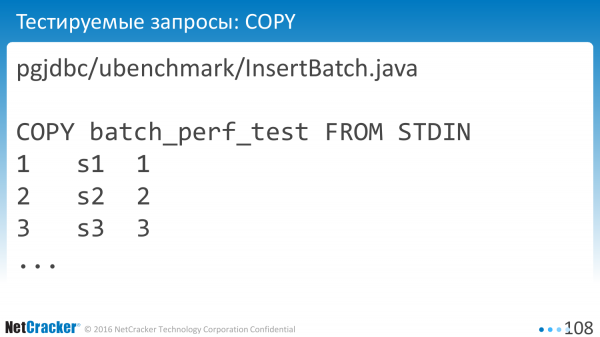
Můžete dělat COPY.
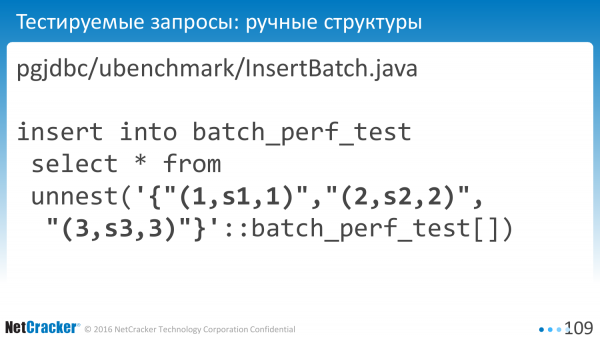
A to lze provádět na strukturách. Deklarovat výchozí typ User, předat pole a přímo vložit do tabulky.
Pokud otevřete odkaz: pgjdbc/ubenchmsrk/InsertBatch.java, tento kód je na GitHubu. Můžete si konkrétně prohlédnout, jaké dotazy jsou tam generovány. O to nejde.
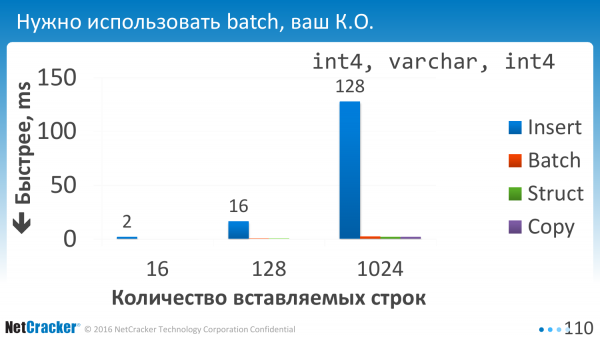
Spustili jsme to. A první, co jsme pochopili, je, že používat batch – to se prostě nedá. Všechny varianty batchování jsou na nule, tj. doba provádění je téměř nulová ve srovnání s jednorázovým provedením.
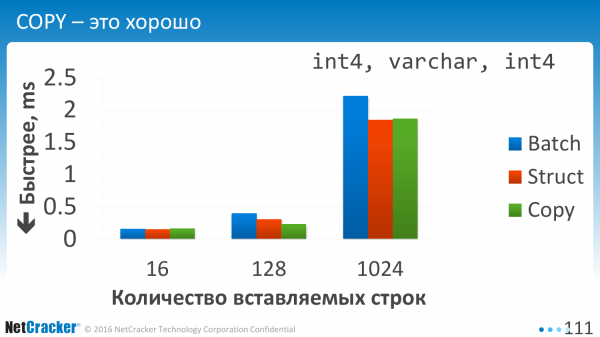
Vkládáme data. Je to tam docela jednoduchá tabulka. Tři sloupce. A co tady vidíme? Vidíme, že všechny tyto tři varianty jsou přibližně srovnatelné. A COPY je samozřejmě nejlepší.
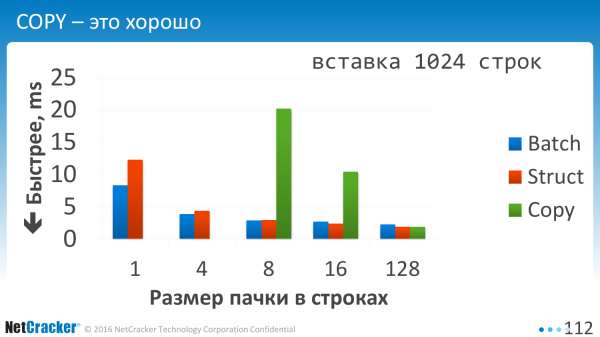
To je, když vkládáme po kouskách. Když jsme říkali, že jedno hodnota VALUES, dvě hodnota VALUES, tři hodnota VALUES nebo jich tam máme 10 oddělených čárkou. To je nyní horizontálně. 1, 2, 4, 128. Je vidět, že Batch Insert, který je vyznačen modře, je tím značně usnadněn. Tj. když vkládáte po jednom nebo dokonce když vkládáte po čtyřech, je to dvakrát lepší, jen z toho důvodu, že jsme do VALUES vložili o něco více. Méně operací EXECUTE.
Používat COPY na malých objemech – to je naprosto nevhodné. Na první dva jsem ani nenakreslil. Jdou do nebes, tj. tyto zelené čísla pro COPY.
COPY byste měli používat, když máte objem dat alespoň větší než sto řádků. Náklady na otevření tohoto spojení jsou vysoké. A upřímně, do této oblasti jsem se víc nepodíval. Batch jsem optimalizoval, COPY – ne.
Co děláme dál? Změřili jsme. Chápeme, že je třeba použít buď struktury, nebo rafinovaný batch, který spojuje několik hodnot.
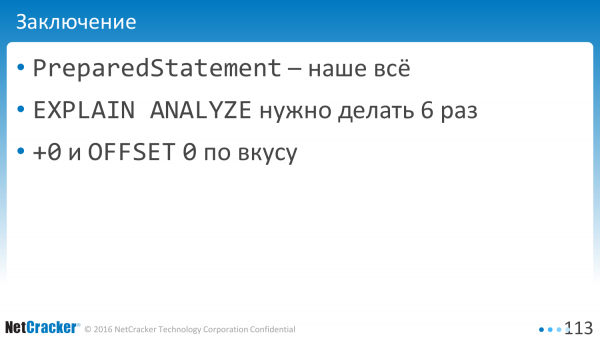
Co bychom měli vyvodit z dnešní přednášky?
- PreparedStatement – to je naše všechno. To velmi pomáhá výkonu. Dává to velkou nádobu smůly.
- A je třeba provést EXPLAIN ANALYZE 6krát.
- A je třeba zředit OFFSET 0, a triky typu +0, abychom opravili zbytek procenta z našich problémových dotazů.
Zdroj: habr.com
