

Překlad článku byl připraven speciálně pro studenty kurzu .
Během posledních několika týdnů jsme s přidali do binární streamovací formát, který doplnil již existující formát souborů pro náhodný přístup/IPc. Máme implementace v Javě a C++ a vazby na Python. V tomto článku vám ukážu, jak tento formát funguje, a demonstruji, jak dosáhnout velmi vysoké propustnosti dat pro DataFrame pandas.
Streamování sloupcových dat
Častá otázka, kterou dostávám od uživatelů Arrow, se týká vysokých nákladů na přenos velkých tabulkových datových sad z formátu orientovaného na řádky nebo záznamy do sloupcového formátu. Pro vícegigabajtové datové sady může být transponování v paměti nebo na disku neúnosným úkolem.
Pro streamování dat, bez ohledu na to, zda jsou zdrojová data řádková nebo sloupcová, jednou z možností zůstává odeslání malých balíčků řádků, z nichž každý obsahuje uspořádání ve sloupcích.
V Apache Arrow se kolekce sloupcových polí v paměti, která představuje část tabulky, nazývá balíček záznamů (record batch). Aby se představila jednotná struktura dat logické tabulky, lze sestavit několik balíčků záznamů.
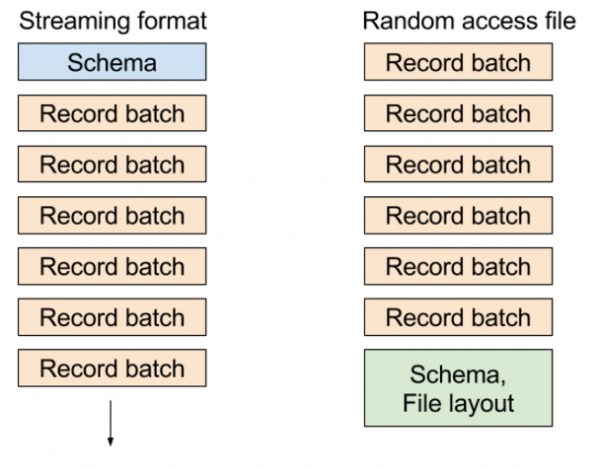
V existujícím formátu souborů „náhodného přístupu“ zapisujeme metadata, která obsahují schéma tabulky a umístění bloků na konci souboru, což vám umožňuje velmi levně vybrat jakýkoli balíček záznamů nebo jakýkoli sloupec z datové sady. V streamovacím formátu posíláme sérii zpráv: schéma a poté jeden nebo více balíčků záznamů.
Různé formáty vypadají přibližně takto, jak je znázorněno na tomto obrázku:
Streamování dat v PyArrow: aplikace
Abych vám ukázal, jak to funguje, vytvořím příklad datové sady, představující jeden streamovací chunk:
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = int(total_size / ncols / np.dtype('float64').itemsize)\n    return pd.DataFrame({\n        'c' + str(i): np.random.randn(nrows)\n        for i in range(ncols)\n    })
Nyní, předpokládejme, že chceme zapsat 1 GB dat složených z chunků velikosti 1 MB, celkem 1024 chunků. Začněme tím, že vytvoříme první datový rámec velikosti 1 MB se 16 sloupci:
KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

df = generate_data(MEGABYTE, NCOLS)
Poté je převedu na pyarrow.RecordBatch:
batch = pa.RecordBatch.from_pandas(df) Nyní vytvořím výstupní stream, který bude zapisovat do paměti a vytvořím StreamWriter:
sink = pa.InMemoryOutputStream()
stream_writer = pa.StreamWriter(sink, batch.schema)
Poté zapíšeme 1024 bloků, které celkem tvoří 1GB datového souboru:
for i in range(DATA_SIZE // MEGABYTE):
    stream_writer.write_batch(batch)
Jelikož jsme zapisovali do RAM, můžeme celý stream získat v jednom bufferu:
In [13]: source = sink.get_result()

In [14]: source
Out[14]:

In [15]: source.size
Out[15]: 1074750744
Protože jsou tato data v paměti, čtení bloků záznamů Arrow je operací zero-copy. Otevírám StreamReader a čtu data do pyarrow.Table, a poté je převádím na DataFrame pandas:
In [16]: reader = pa.StreamReader(source)

In [17]: table = reader.read_all()

In [18]: table
Out[18]:

In [19]: df = table.to_pandas()

In [20]: df.memory_usage().sum()
Out[20]: 1073741904
To vše je samozřejmě fajn, ale můžete mít otázky. Jak rychle to probíhá? Jak velikost bloku ovlivňuje výkon při získávání DataFrame pandas?
Výkon přenosu dat
Jak se velikost bloku snižuje, náklady na rekonstrukci kontinua DataFrame v pandas se zvyšují kvůli neefektivním schématům přístupu do cache. Existují také určité režijní náklady spojené s prací se strukturovanými daty C++ a jejich paměťovými buffery.
Pro 1 MB, jak bylo uvedeno výše, na mém notebooku (Quad-core Xeon E3-1505M) to vychází:
In [20]: %timeit pa.StreamReader(source).read_all().to_pandas()
10 smyček, nejlepší ze 3: 129 ms na smyčku
Ukazuje se, že účinný přenos je 7.75 GB/s pro obnovu DataFrame o velikosti 1GB ze 1024 bloků po 1MB. Co se stane, když použijeme bloky větší nebo menší? Tady jsou výsledky:
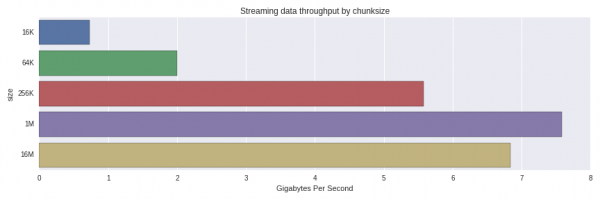
Výkon výrazně klesá při přechodu z 256K na 64K bloky. Překvapilo mě, že bloky o velikosti 1 MB byly zpracovávány rychleji než 16 MB. Je třeba provést důkladnější výzkum a pochopit, zda se jedná o normální rozložení, nebo zda na to má vliv něco jiného.
V aktuální implementaci formátu nejsou data v podstatě vůbec komprimována, takže velikost v paměti a "v drátech" je přibližně stejná. V budoucnu by komprese mohla být další volbou.
Výsledek
Streamování sloupcových dat se může ukázat jako efektivní způsob přenosu velkých souborů dat do sloupcových analytických nástrojů, jako je například pandas, pomocí malých bloků. Datové služby používající úložiště orientované na řádky mohou přenášet a transponovat malé bloky dat, které jsou lépe přizpůsobeny pro L2 a L3 mezipaměť vašeho procesoru.
Celý kód
import time
import numpy as np
import pandas as pd
import pyarrow as pa

def generate_data(total_size, ncols):
    nrows = total_size / ncols / np.dtype('float64').itemsize
    return pd.DataFrame({
        'c' + str(i): np.random.randn(nrows)
        for i in range(ncols)
    })

KILOBYTE = 1 << 10
MEGABYTE = KILOBYTE * KILOBYTE
DATA_SIZE = 1024 * MEGABYTE
NCOLS = 16

def get_timing(f, niter):
    start = time.clock_gettime(time.CLOCK_REALTIME)
    for i in range(niter):
        f()
    return (time.clock_gettime(time.CLOCK_REALTIME) - start) / NITER

def read_as_dataframe(klass, source):
    reader = klass(source)
    table = reader.read_all()
    return table.to_pandas()
NITER = 5
results = []

CHUNKSIZES = [16 * KILOBYTE, 64 * KILOBYTE, 256 * KILOBYTE, MEGABYTE, 16 * MEGABYTE]

for chunksize in CHUNKSIZES:
    nchunks = DATA_SIZE // chunksize
    batch = pa.RecordBatch.from_pandas(generate_data(chunksize, NCOLS))

    sink = pa.InMemoryOutputStream()
    stream_writer = pa.StreamWriter(sink, batch.schema)

    for i in range(nchunks):
        stream_writer.write_batch(batch)

    source = sink.get_result()

    elapsed = get_timing(lambda: read_as_dataframe(pa.StreamReader, source), NITER)

    result = (chunksize, elapsed)
    print(result)
    results.append(result)
Zdroj: habr.com
