

Ahoj, Habr.
Nedávno jsem o tom, jaké parametry v našem týmu nejčastěji používáme pro Kafka Producer a Consumer, abychom dosáhli zaručené dodávky. V tomto článku chci vysvětlit, jak jsme zorganizovali opětovné zpracování události, kterou jsme obdrželi z Kafka, v důsledku dočasné nedostupnosti externího systému.
Moderní aplikace fungují ve velmi složitém prostředí. Obchodní logika, zabalená v moderním technologickém zásobníku, pracující v Dockeru, který je řízen orchestrátorem jako Kubernetes nebo OpenShift, a komunikující s jinými aplikacemi nebo podnikových řešeními prostřednictvím řetězce fyzických a virtuálních směrovačů. V takovém prostředí se může vždy něco pokazit, proto je opětovné zpracování událostí v případě nedostupnosti jednoho z externích systémů důležitou součástí našich obchodních procesů.
Jak to bylo před Kafka
Dříve jsme v projektu používali IBM MQ pro asynchronní doručování zpráv. Když nastala nějaká chyba v průběhu práce služby, obdržená zpráva mohla být umístěna do dead-letter-queue (DLQ) pro další ruční zpracování. DLQ byla vytvořena vedle příchozí fronty, přenesení zprávy probíhalo uvnitř IBM MQ.
Pokud byla chyba dočasná a mohli jsme to určit (např. ResourceAccessException při HTTP volání nebo MongoTimeoutException při dotazu v MongoDb), pak byla aktivována strategie opakovaných volání. Nezávisle na větvení logiky aplikace byla původní zpráva umístěna buď do systémové fronty pro odložené odeslání, nebo do samostatné aplikace, která byla kdysi vytvořena pro opětovné odesílání zpráv. Přitom je do záhlaví zprávy zapsáno číslo opakovaného odeslání, které je vázáno na interval zpoždění nebo na konec strategie na úrovni aplikace. Pokud jsme dosáhli konce strategie, ale externí systém byl stále nedostupný, zpráva bude umístěna do DLQ pro ruční zpracování.
Hledání řešení
, můžeme najít následující . Stručně řečeno, navrhuje se vytvořit jednu frontu pro každý interval zpoždění a realizovat na straně aplikace Consumer’y, které budou číst zprávy s potřebným zpožděním.
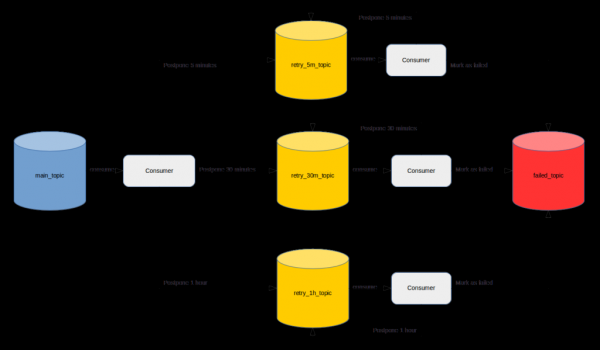
Navzdory velkému počtu pozitivních hodnocení se mi zdá poněkud neúspěšné. Především proto, že vývojáři, kromě realizace obchodních požadavků, budou muset věnovat hodně času realizaci popsaného mechanismu.
Kromě toho, pokud je na Kafka clusteru povoleno řízení přístupu, bude nutné strávit nějaký čas vytvářením témat a zajišťováním potřebných přístupů k nim. Kromě toho bude třeba vybrat správný parametr retention.ms pro každé z retry témat, aby zprávy byly odesílány znovu a nezmizely. Realizaci a žádost o přístupy bude nutné opakovat pro každý existující nebo nový službu.
Nyní se podívejme, jaké mechanismy pro opětovné zpracování zpráv nám spring celkově a spring-kafka konkrétně poskytují. Spring-kafka má tranzitivní závislost na spring-retry, který poskytuje abstrakce pro správu různých BackOffPolicy. Toto je poměrně flexibilní nástroj, ale jeho významnou nevýhodou je uchovávání zpráv pro opětovné odeslání v paměti aplikace. To znamená, že restart aplikace v důsledku aktualizace nebo chyby během provozu povede ke ztrátě všech zpráv, které čekají na opětovné zpracování. Vzhledem k tomu, že tento bod je kritický pro náš systém, rozhodli jsme se dále ho nezvažovat.
Samotná spring-kafka poskytuje několik implementací ContainerAwareErrorHandler, například , s jehož pomocí lze zpracovat zprávu později, aniž by došlo k posunutí offsetu v případě chyby. Od verze spring-kafka 2.3 je možné nastavit BackOffPolicy.
Tento přístup umožňuje opětovně zpracovávaným zprávám přežít restart aplikace, ale mechanismus DLQ stále chybí. Tento variant jsme zvolili na začátku roku 2019, optimisticky přitom předpokládali, že DLQ nebude potřeba (měli jsme štěstí a skutečně nebyl potřeba během několika měsíců provozu aplikace s tímto systémem opětovného zpracování). Dočasné chyby vedly k aktivaci SeekToCurrentErrorHandler. Ostatní chyby byly vytištěny do logu, což vedlo k posunu offsetu, a zpracování pokračovalo s další zprávou.
Konečné řešení
Implementace založená na SeekToCurrentErrorHandler nás přiměla vyvinout vlastní mechanismus pro opakované odesílání zpráv.
Především jsme chtěli využít již existující zkušenosti a rozšířit je v závislosti na logice aplikace. Pro aplikaci s lineární logikou by bylo optimální na krátkou dobu pozastavit příjem nových zpráv, což by bylo určeno v rámci strategie opakovaných volání. Pro ostatní aplikace bylo žádoucí mít jednotné místo, které by zajišťovalo provádění strategie opakovaných volání. Dále by toto jednotné místo mělo mít funkčnost DLQ pro oba přístupy.
Samotná strategie opakovaných volání by měla být uložena v aplikaci, která je zodpovědná za získání dalšího intervalu při výskytu dočasné chyby.
Pozastavení Consumer’a pro aplikaci s lineární logikou
Při práci s spring-kafka může kód pro zastavení Consumer’a vypadat přibližně takto:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // to DLQ
    }
V příkladu retryAt je čas, kdy je třeba znovu spustit MessageListenerContainer, pokud stále běží. Opětovné spuštění proběhne v samostatném vlákně spuštěném v TaskScheduler, jehož implementaci také poskytuje spring.
Hodnotu retryAt nalezneme následujícím způsobem:
- Hledá se hodnota počitadla opakování.
- Podle hodnoty počitadla se hledá aktuální interval zpoždění ve strategii opakovaných volání. Strategie je vyhlášena v samotné aplikaci, k jejímu uložení jsme zvolili formát JSON.
- Nalezený interval v JSON poli obsahuje počet sekund, po kterých je nutné zpracování zopakovat. Tento počet sekund se přičte k aktuálnímu času, což vytvoří hodnotu pro retryAt.
- Pokud interval není nalezen, hodnota retryAt je null a zpráva bude odeslána do DLQ k ručnímu zpracování.
Při tomto přístupu je nutné uchovávat pouze počet opakovaných pokusů pro každou zprávu, která je aktuálně zpracovávána, například v paměti aplikace. Uchovávání počtu pokusů v paměti není pro tento přístup kritické, protože aplikace s lineární logikou nemůže provádět zpracování v celku. Na rozdíl od spring-retry restart aplikace nevede ke ztrátě všech zpráv pro opětovné zpracování, ale pouze k restartu strategie.
Tento přístup pomáhá snížit zátěž na externí systém, který nemusí být k dispozici kvůli velmi vysoké zátěži. Jinými slovy, kromě opětovného zpracování jsme dosáhli realizace vzoru. .
V našem případě je prahem chyby pouze 1 a abychom minimalizovali prostoje systému kvůli dočasnému síťovému přerušení, používáme velmi granularní strategii opakovaných pokusů s malými zpožděními. To nemusí vyhovovat všem aplikacím skupiny společností, proto je třeba poměr mezi prahem chyby a velikostí intervalu přizpůsobit podle vlastností systému.
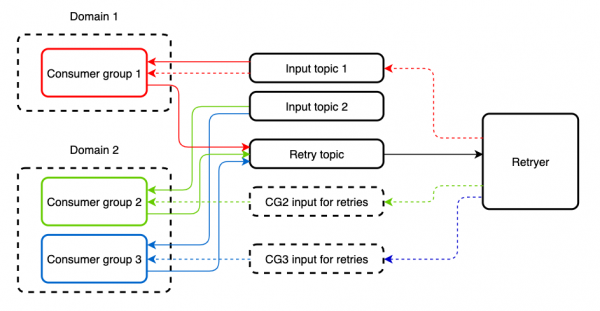
Samostatná aplikace pro zpracování zpráv z aplikací s nedeterministickou logikou.
Zde je příklad kódu, který odesílá zprávu do takové aplikace (Retryer), která provede opětovné odeslání do topiku DESTINATION při dosažení času RETRY_AT:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
Z příkladu je patrné, že se do headerů předává mnoho informací. Hodnota RETRY_AT se nachází stejně jako pro mechanismus opakování pomocí zastavení Consumer’a. Kromě DESTINATION a RETRY_AT předáváme:
- GROUP_ID, podle kterého seskupujeme zprávy pro ruční analýzu a usnadnění vyhledávání.
- ORIGINAL_PARTITION, aby se pokusil zachovat stejného spotřebitele pro opětovné zpracování. Tento parametr může být roven null, v takovém případě bude nová partition získána podle klíče record.key() původní zprávy.
- Aktualizovaná hodnota COUNTER, aby sledovala strategii opakovaných volání.
- SEND_TO — konstanta, která ukazuje, zda má být zpráva zaslána k opětovnému zpracování po dosažení RETRY_AT nebo umístěna do DLQ.
- REASON — důvod, proč bylo zpracování zprávy přerušeno.
Retryer uchovává zprávy pro opětovné odeslání a ruční analýzu v PostgreSQL. Na základě časovače se spouští úloha, která nachází zprávy s dosaženým RETRY_AT a odesílá je zpět do partition ORIGINAL_PARTITION tématu DESTINATION s klíčem record.key().
Po odeslání jsou zprávy odstraněny z PostgreSQL. Ruční analýza zpráv probíhá v jednoduchém UI, které komunikuje s Retryerem přes REST API. Hlavními funkčnostmi jsou opětovné odeslání nebo odstranění zpráv z DLQ, prohlížení chybových informací a hledání zpráv, například podle názvu chyby.
Jelikož máme na našich clusterech povoleno řízení přístupu, je nutné navíc požadovat přístupy k tématu, které poslouchá Retryer, a umožnit Retryerovi zapisovat do DESTINATION tématu. Je to nepohodlné, ale na rozdíl od přístupu s tématem na interval máme plnohodnotnou DLQ a UI pro její správu.
Existují případy, kdy příchozí téma čtou různé spotřebitelské skupiny, jejichž aplikace implementují různé logiky. Opětovné zpracování zprávy přes Retryer pro jednu z těchto aplikací povede k duplicitu u jiné. Abychom se před tím chránili, vytvoříme samostatné téma pro opětovné zpracování. Příchozí a retry téma může číst stejný spotřebitel bez jakýchkoli omezení.
Ve výchozím nastavení tento přístup nenabízí možnost circuit breakeru, avšak lze ho přidat do aplikace pomocí nebo nového , obalením míst výzev k externím službám do příslušných abstrakcí. Kromě toho se objevuje možnost výběru strategie pro vzorec, což může být také užitečné. Například ve spring-cloud-netflix to může být thread pool nebo semafor.
Výstup
V důsledku toho jsme vytvořili samostatnou aplikaci, která umožňuje opakovat zpracování zprávy v případě dočasné nedostupnosti nějakého externího systému.
Jednou z hlavních výhod aplikace je to, že ji mohou používat externí systémy pracující na stejném Kafka clusteru, aniž by na své straně musely provádět podstatné úpravy! Taková aplikace potřebuje pouze získat přístup k retry tématu, naplnit několik Kafka hlaviček a odeslat zprávu do Retryer. Není potřeba vybudovat žádnou další infrastrukturu. Abychom snížili počet přenášených zpráv mezi aplikací a Retryerem, vyčlenili jsme aplikace s lineární logikou a provedli v nich opakované zpracování zastavením Consumer.
Zdroj: habr.com
