

Vážení čtenáři, přeji vám hezký den!
Úkolem budování IT platforem pro shromažďování a analýzu dat se dříve či později setká každá společnost, jejíž obchodní model spočívá na intelektuálně náročných službách nebo technicky složitých produktech. Vytváření analytických platforem je složitý a časově náročný úkol. Každý úkol však lze zjednodušit. V tomto článku se chci podělit o zkušenosti s použitím nástrojů low-code, které pomáhají při vytváření analytických řešení. Tato zkušenost byla získána při realizaci řady projektů zaměřených na Big Data Solutions společnosti „Neoflex“. Oddělení Big Data Solutions společnosti „Neoflex“ se od roku 2005 zabývá otázkami výstavby datových úložišť a datových jezer, řeší úkoly optimalizace rychlosti zpracování informací a pracuje na metodologii řízení kvality dat.
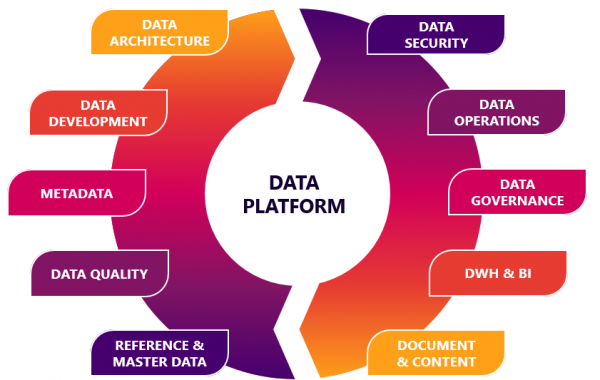
Vyhnout se vědomému shromažďování slabě a/nebo silně strukturovaných dat se nikomu nepodaří. Snad i když půjde o malé podniky. Při rozšiřování podnikání se perspektivní podnikatel setká s otázkami týkajícími se vývoje věrnostních programů, chce provést analýzu efektivity prodejních míst, uvažuje o cílené reklamě a trápí se poptávkou po podpůrných produktech. V prvním přiblížení může být podíl úkolu vyřešen „narychlo“. Ale s růstem podnikání se přechod k analytické platformě stává nevyhnutelným.
Ale za jakých okolností se úkoly analýzy dat mohou stát úkoly třídy „Rocket Science“? Snad v okamžiku, kdy jde o opravdu velká data.
Abychom zjednodušili úkol „Rocket Science“, můžeme sníst slona po částech.
Čím větší diskretnost a autonomnost budou mít vaše aplikace/služby/mikroslužby, tím snazší bude pro vás, vaše kolegy a celé podnikání „trávit“ slona.
K tomuto postulátu dospěli prakticky všichni naši klienti, když přeorganizovali krajinu na základě inženýrských praktik týmů DevOps.
Ale i při „oddělené, sloní“ dietě máme slušné šance na „přesycení“ IT krajiny. V tuto chvíli byste se měli zastavit, vydechnout a podívat se směrem k low-code engineering platform.
Mnohé vývojáře děsí představa kariérní stagnace při přechodu od přímého psaní kódu k „přetahování“ šipek v uživatelských rozhraních low-code systémů. Avšak příchod strojů nezpůsobil zmizení inženýrů, ale posunul jejich práci na novou úroveň!
Pojďme se podívat, proč.
Analýza dat v oblasti logistiky, telekomunikačního průmyslu, médií, finančního sektoru je vždy spojena s následujícími otázkami:
- Rychlost provádění automatizované analýzy;
- Možnost provádění experimentů bez vlivu na hlavní tok produkce dat;
- Důvěryhodnost připravených dat;
- Sledování změn a verzování;
- Data provenance, Data lineage, CDC;
- Rychlost dodání nových funkcí do produkčního prostředí;
- A proslulé: náklady na vývoj a údržbu.
To znamená, že inženýři mají obrovské množství úkolů na vysoké úrovni, které lze efektivně splnit pouze tím, že se zbaví myšlenek na úkoly nízké úrovně vývoje.
Předpoklady pro přechod vývojářů na novou úroveň byly evoluce a digitalizace podnikání. Hodnota vývojáře se také mění: nedostatek vývojářů schopných proniknout do podstaty konceptů automatizovaného podnikání je značný.
Pojďme si udělat analogii mezi nízkoúrovňovými a vysokou úrovní programovacími jazyky. Přechod od nízkoúrovňových jazyků k vysokou úrovni – to je přechod od psaní „přímých direktiv v jazyce hardwaru“ k „direktivám v jazyce lidí“. To znamená přidání určité vrstvy abstrakce. V tomto případě je přechod na low-code platformy z vysokouúrovňových programovacích jazyků přechodem od „direktiv v jazyce lidí“ k „direktivám v jazyce podnikání“. Pokud se najdou vývojáři, které tento fakt znepokojuje, pak jsou asi znepokojeni už od chvíle, kdy se objevil JavaScript, který obsahuje funkce pro třídění pole. A tyto funkce mají samozřejmě pod kapotou programovou implementaci jinými prostředky téhož vysokého programování.
Proto je low-code jen dalším úrovní abstrakce.
Aplikační zkušenosti s používáním low-code
Téma low-code je velmi široké, ale nyní bych rád hovořil o praktickém využití „malokodových konceptů“ na příkladu jednoho z našich projektů.
Pododdělení Big Data Solutions společnosti „Neoflex“ se převážně specializuje na finanční sektor, buduje datové sklady a jezera dat a automatizuje různé reporty. V této oblasti se používání low-code stalo standardem. Mezi dalšími nástroji low-code lze zmínit prostředky pro organizaci ETL procesů: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Nebo Oracle Apex, který slouží jako prostředí pro rychlý vývoj rozhraní pro přístup a úpravu dat. Nicméně použití malokodových nástrojů pro vývoj není vždy spojeno s vytvářením úzce specializovaných aplikací na komerčním technologickém stacku s jasným závislostí na dodavateli.
S pomocí platforem low-code je také možné organizovat orchestraci datových toků, vytvořit data science platformy nebo například moduly pro kontrolu kvality dat.
Jedním z praktických příkladů zkušeností s využitím malokodových nástrojů je spolupráce „Neoflex“ se společností Mediascope, jedním z lídrů na ruském trhu médií a výzkumu. Jedním z úkolů této společnosti je produkce dat, na jejichž základě se zadavatelé reklamy, internetové platformy, televizní kanály, rozhlasové stanice, reklamní agentury a značky rozhodují o nákupu reklamy a plánují své marketingové komunikace.
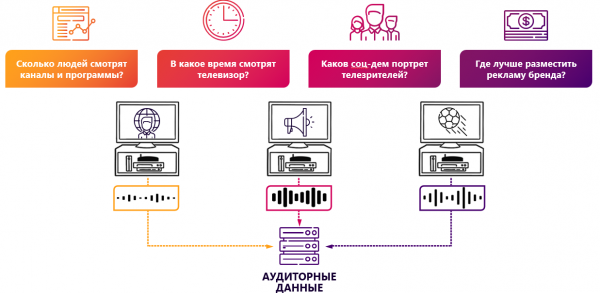
Mediální výzkumy jsou technologicky náročnou oblastí podnikání. Rozpoznávání videa, sběr dat z zařízení analyzujících sledování, měření aktivity na webových stránkách – to vše zahrnuje nutnost mít velký IT tým a obrovské zkušenosti ve vývoji analytických řešení. Avšak exponenciální růst množství informací, počtu a rozmanitosti jejich zdrojů nutí IT průmysl dat neustále se vyvíjet. Nejjednodušším řešením pro škálování již fungující analytické platformy Mediascope by mohlo být zvýšení počtu IT pracovníků. Ale mnohem efektivnějším řešením je urychlení procesu vývoje. Jedním z kroků, které vedou tímto směrem, může být používání platforem low-code.
V době zahájení projektu měla společnost již funkční produktové řešení. Nicméně implementace řešení na MSSQL nemohla plně splnit očekávání ohledně škálovatelnosti funkcionality při zachování přijatelné ceny úprav.
Úkol, který před námi stál, byl skutečně ambiciózní – 'Neoflex' a Mediascope měly vytvořit průmyslové řešení za méně než rok, přičemž MVP mělo být uvedeno na trh již během prvního čtvrtletí od data zahájení prací.
Jako základ pro vybudování nové datové platformy, založené na low-code výpočtech, byl vybrán technologický stack Hadoop. Standardem pro ukládání dat se stal HDFS s využitím souborů ve formátu parquet. Pro přístup k datům v platformě byl použit Hive, ve kterém jsou všechny dostupné pohledy prezentovány jako externí tabulky. Načítání dat do úložiště bylo realizováno pomocí Kafka a Apache NiFi.
Low-code nástroj v této koncepci byl aplikován pro optimalizaci nejpracnější úlohy při vytváření analytické platformy – úlohy výpočtu dat.
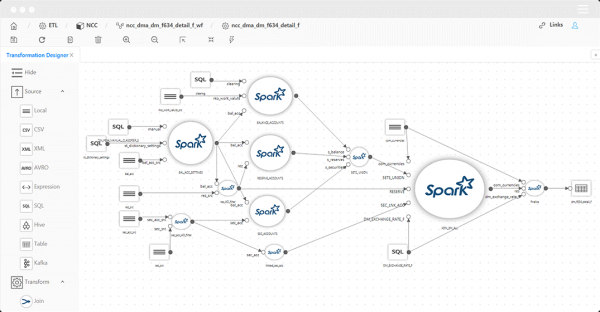
Hlavním mechanismem pro mapování dat byl vybrán low-code nástroj Datagram. Neoflex Datagram je prostředek pro vývoj transformací a toků dat.
Použitím tohoto nástroje lze obejít ruční psaní kódu ve Scalě. Scala kód je automaticky generován s využitím přístupu Model Driven Architecture.
Zřejmou výhodou takového přístupu je zrychlení procesu vývoje. Avšak kromě rychlosti existují také následující přednosti:
- Náhled obsahu a struktury zdrojů/příjemců;
- Sledování původu objektů datového toku až do jednotlivých polí (lineage);
- Částečné provádění transformací s náhledem na mezisouhrny;
- Náhled zdrojového kódu a jeho úprava před provedením;
- Automatická validace transformací;
- Automatické nahrávání dat 1 na 1.
Prahová hodnota pro vstup do low-code řešení pro generování transformací není příliš vysoká: vývojář by měl mít znalosti SQL a zkušenosti s ETL nástroji. Je však třeba podotknout, že generátory transformací řízené kódem nejsou ETL nástroji v širším smyslu. Low-code nástroje nemusí mít vlastní prostředí pro provádění kódu. To znamená, že vygenerovaný kód se bude spouštět v tom prostředí, které bylo na clusteru k dispozici před instalací low-code řešení. A to je pravděpodobně další plus pro low-code. Protože vedle low-code týmu může pracovat "tradiční" tým, který implementuje funkčnost například v čistém Scala kódu. Zařazení úprav obou týmů do výrobního prostředí bude snadné a "bezproblémové".
Možná stojí za to také zmínit, že kromě low-code existují i no-code řešení. A v podstatě se jedná o různé věci. Low-code v větší míře umožňuje vývojáři zasahovat do generovaného kódu. V případě Datagram je možné zobrazit a upravit generovaný kód Scala, no-code takovou možnost nemusí poskytovat. Tento rozdíl je velmi důležitý nejen z hlediska flexibility řešení, ale také z pohledu komfortu a motivace v práci data inženýrů.
Architektura řešení
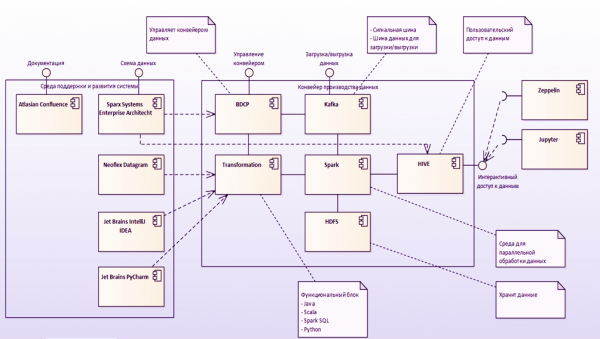
Pojďme se pokusit pochopit, jak konkrétně low-code nástroj pomáhá řešit úkol optimalizace rychlosti vývoje funkčnosti pro výpočty dat. Nejdříve se podívejme na funkční architekturu systému. V tomto případě příkladem je model výroby dat pro mediální výzkum.
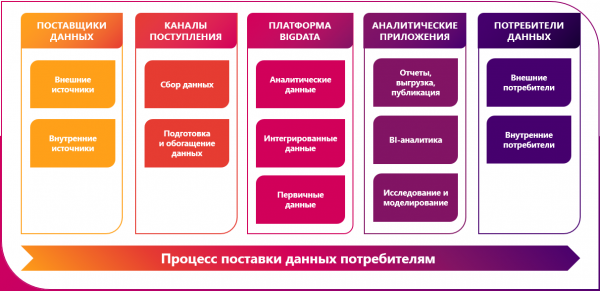
Zdrojové datové informace jsou v našem případě velmi rozmanité a různorodé:
- Peoplemetry (TV meters) jsou programově-hardwarová zařízení, která zaznamenávají chování uživatelů respondentů televizní panelu – kdo, kdy a kterou televizní stanici sledoval v domácnosti zapojené do výzkumu. Dodávané informace jsou proud intervalů sledování vysílání spojené s mediálním balíčkem a mediálním produktem. Data v procesu načítání do Data Lake mohou být obohacena demografickými atributy, spojením s geografickým umístěním, časovými zónami a dalšími informacemi nezbytnými pro analýzu sledovanosti určitého mediálního produktu. Provedená měření mohou být využita pro analýzu nebo plánování reklamních kampaní, hodnocení aktivity a preferencí publika, vypracování vysílacího plánu;
- Data mohou pocházet z monitorovacích systémů streamovaného televizního vysílání a měření sledovanosti obsahu video zdrojů na internetu;
- Měřicí nástroje ve webovém prostředí, mezi kterými se nacházejí jak site-centric, tak i user-centric počitadla. Dodavatelem dat pro Data Lake může sloužit rozšíření prohlížeče research bar a mobilní aplikace se zabudovaným; VPN.
- Data mohou také pocházet z platformy, která konsoliduje výsledky vyplňování online dotazníků a závěry telefonních rozhovorů v průzkumech společnosti;
- Dodatečné obohacení datového jezera může probíhat prostřednictvím načítání informací z logů partnerských společností.
Implementace as is načítání ze zdrojových systémů do primárního stagingu syrových dat může být organizována různými způsoby. V případě použití low-code pro tyto účely je možná automatická generace skriptů načítání na základě metadat. V tomto případě není nutné se dostávat na úroveň vývoje mapování source to target. Pro realizaci automatického načítání je třeba vytvořit spojení se zdrojem, po čemž je nutné v uživatelském rozhraní načítání definovat seznam entit, které mají být načteny. Vytvoření struktury adresářů v HDFS proběhne automaticky a bude odpovídat struktuře ukládání dat v systémě zdroje.
Nicméně v kontextu tohoto projektu jsme se rozhodli nevyužít tuto možnost low-code platformy, protože společnost Mediascope již sama zahájila práci na výrobě podobné služby na základě Nifi + Kafka.
Je třeba hned zdůraznit, že tyto nástroje nejsou vzájemně zaměnitelné, ale spíše se navzájem doplňují. Nifi a Kafka mohou pracovat jak v přímém (Nifi -> Kafka), tak v opačném (Kafka -> Nifi) režimu. Pro platformu mediálních analýz byl použit první zmíněný režim.
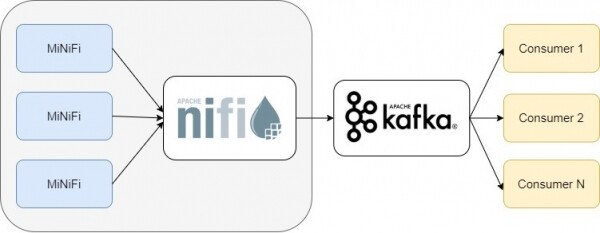
V našem případě bylo nutné, aby Nifi zpracovával různé typy dat ze systémů-zdrojů a odesílal je brokerovi Kafka. Přitom bylo směrování zpráv do určitého topicu Kafka prováděno pomocí Nifi procesorů PublishKafka. Orchestraci a údržbu těchto pipeline provádíme v vizuálním rozhraní. Nástroj Nifi a použití kombinace Nifi + Kafka lze také označit jako low-code přístup k vývoji, který má nízký vstupní práh do technologií Big Data a urychluje proces vývoje aplikací.
Dalším krokem v realizaci projektu bylo přenesení do formátu jednotné sémantické vrstvy podrobných dat. V případě, že má entita historické atributy, je výpočet prováděn v kontextu zvažované partition. Pokud entita není historická, může být volitelně buď přepočítáno celé obsahu objektu, nebo se od přepočtu tohoto objektu zcela upustí (v důsledku absence změn). V této fázi dochází k vytváření klíčů pro všechny entity. Klíče jsou ukládány do odpovídajících seznamů master-objektů v Hbase, obsahujících shodu mezi klíči v analytické platformě a klíči ze systémů-zdrojů. Konsolidace atomárních entit je doprovázena obohacením výsledky předběžného výpočtu analytických dat. Frameworkem pro výpočet dat byl Spark. Popisovaná funkce přenosu dat do jednotné sémantiky byla také realizována na základě mappingů low-code nástroje Datagram.
V cílové architektuře bylo nutné zajistit SQL přístup k datům pro obchodní uživatele. Pro tuto možnost byl použit Hive. Registrace objektů v Hive se provádí automaticky při aktivaci možnosti „Registr Hive Table“ v low-code nástroji.
Správa toku výpočtu
Datagram má rozhraní pro návrh workflow toků. Mapování lze spouštět pomocí plánovače Oozie. V rozhraní pro vývojáře toků je možné vytvořit schémata paralelního, sekvenčního nebo na podmínkách závislého zpracování dat. Podporovány jsou shell skripty a java programy. Je také možné využití serveru Apache Livy. Apache Livy se používá ke spouštění aplikací přímo z vývojového prostředí.
Pokud má společnost již vlastního orchestrátora procesů, je možné použít REST API k integraci mapování do stávajícího toku. Například jsme měli docela úspěšné zkušenosti s integrací mapování napsaného ve Scale do orchestrátorů napsaných v PLSQL a Kotlin. REST API nízko-kódového nástroje zahrnuje operace, jako je generování spustitelného kódu na základě návrhu mapování, volání mapování, volání sekvence mapování a samozřejmě předávání parametrů v URL pro spuštění mapování.
Kromě Oozie je možné organizovat tok výpočtu prostřednictvím Airflow. Nechci se příliš zabývat porovnáváním Oozie a Airflow, jen řeknu, že v kontextu práce na projektu mediálních výzkumů bylo rozhodnuto ve prospěch Airflow. Hlavními argumenty tentokrát byly aktivnější komunita, která vyvíjí produkt, a rozvinutější rozhraní + API.
Airflow je také výhodný, protože pro popis výpočtových procesů se v něm používá široce oblíbený Python. A vůbec, platforem pro správu pracovních toků s otevřeným zdrojovým kódem není mnoho. Spuštění a monitorování provádění procesů (včetně Ganttova diagramu) přidává body do karmy Airflow.
Formát konfiguračního souboru pro spuštění mapování nízko-kódového řešení se stal spark-submit. K tomu došlo ze dvou důvodů. Za prvé, spark-submit umožňuje přímo spustit jar soubor z konzole. Za druhé, může obsahovat všechny potřebné informace pro konfiguraci pracovního toku (což usnadňuje psaní skriptů pro vytváření Dag).
Nejčastějším prvkem pracovního toku Airflow v našem případě se stal SparkSubmitOperator.
SparkSubmitOperator umožňuje spouštět jar soubory — zabalené mapování Datagram s předem definovanými vstupními parametry.
Je třeba poznamenat, že každá úloha Airflow běží v samostatném vlákně a nic neví o ostatních úlohách. Proto se interakce mezi úlohami provádí pomocí řídících operátorů, jako jsou DummyOperator nebo BranchPythonOperator.
Kombinace použití low-code řešení Datagram se zjednodušením konfiguračních souborů (vytvářejících Dag) vedla k výraznému urychlení a zjednodušení procesu vývoje datových toků.
Výpočet vitrín
Snad nejinteligentněji zatěžovaný krok ve výrobě analytických dat je krok výstavby vitrín. V kontextu jednoho z datových toků výzkumné společnosti v tomto kroku probíhá přizpůsobení standardnímu vysílání s ohledem na úpravu časových pásem ve spojení s vysílací sítí. Také je možná úprava na místní vysílací síť (místní zprávy a reklama). Mezi jiným se v tomto kroku provádí rozdělení intervalů nepřetržitého sledování mediálních produktů na základě analýzy intervalů sledování. Zde se také provádí „vážení“ hodnot sledování na základě informací o jejich významnosti (výpočet korekčního koeficientu).
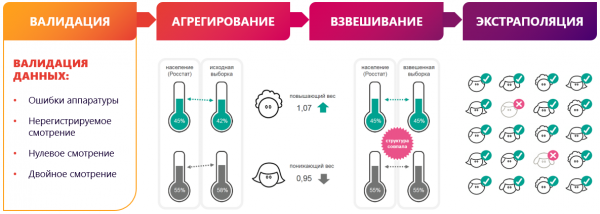
Samostatným krokem přípravy vitrín je validace dat. Algoritmus validace je spojen s aplikací řady matematických vědeckých modelů. Nicméně použití platformy low-code umožňuje rozdělit složitý algoritmus na řadu jednotlivých vizuálně srozumitelných mapování. Každé mapování vykonává úzký úkol. V důsledku toho je možná mezifázová debuggování, logování a vizualizace fází přípravy dat.
Algoritmus validace byl rozhodnut disretizovat na následující podkroky:
- Sestavení regresí závislostí sledování televizní sítě v regionu na sledování všech sítí v regionu za 60 dní.
- Výpočet studentizovaných reziduí (odchylky skutečných hodnot od předpovězených regresními modely) pro všechny body regrese a pro vypočítaný den.
- Výběr anomálních párů region-televize, kde studentizovaný zbytek vypočítaného dne překračuje normu (stanovenou nastavením operace).
- Přepočet upraveného studentizovaného zbytku podle anomálních párů region-síť pro každého respondenta, který sledoval síť v regionu, s určením příspěvku tohoto respondenta (velikost změny studentizovaného zbytku) při vyloučení sledování tohoto respondenta ze vzorku.
- Vyhledávání kandidátů, jejichž vyloučení přivádí studentizovaný zbytek výpočtového dne na normu.
Výše uvedený příklad potvrzuje hypotézu, že datový inženýr má již tak příliš mnoho věcí na mysli… A pokud je to skutečně „inženýr“, a ne „kodér“, pak by měl strach z profesní degradace při používání nástrojů low-code nakonec ustoupit.
Co dalšího může low-code?
Oblast použití nástroje low-code pro dávkovou a streamovou zpracování dat bez nutnosti ručního psaní kódu ve Scalě nekončí.
Použití low-code v vývoji datových jezer se pro nás stalo již jakýmsi standardem. Asi můžeme říci, že řešení na stacku Hadoop opakují vývojovou cestu klasických DWH založených na RDBMS. Nástroje s nízkým kódem na stacku Hadoop mohou řešit jak úkoly zpracování dat, tak úkoly výstavby konečných BI rozhraní. A je třeba poznamenat, že pod BI se nemusí chápat pouze reprezentace dat, ale i jejich editace ze strany business uživatelů. Tato funkce je námi často využívána při tvorbě analytických platforem pro finanční sektor.
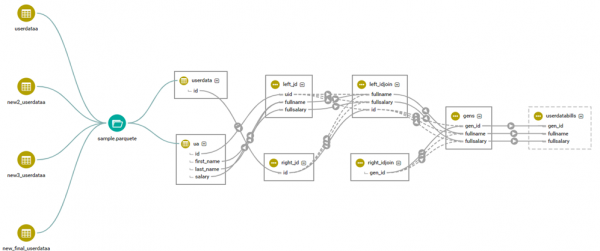
Mezi jinými, pomocí low-code a zejména Datagram je možné řešit úkol sledování původu objektů datového proudu s atomárností až na jednotlivá pole (lineage). K tomu bylo v low-code nástroji implementováno propojení s Apache Atlas a Cloudera Navigator. V podstatě musí vývojář zaregistrovat sadu objektů ve slovnících Atlas a odkazovat na registrované objekty při vytváření mapování. Mechanismus sledování původu dat nebo analýza závislostí objektů šetří spoustu času při potřebě provádět úpravy v algoritmech výpočtu. Například při sestavování finančního výkaznictví tato funkce umožňuje lépe zvládat období změn legislativy. Čím lépe chápeme meziformátovou závislost v rámci objektů podrobného vrstvy, tím méně se setkáme s „náhlými“ defekty a zkrátíme počet revorků.
Kvalita dat & Low-code
Dalším úkolem, který byl realizován low-code nástrojem na projektu společnosti Mediascope, byl úkol třídy Kvalita dat. Zvláštností implementace konvejeru kontroly dat pro projekt výzkumné společnosti byla absence vlivu na funkčnost a rychlost práce hlavního toku výpočtu dat. Pro možnost orchestraci nezávislými toky kontroly dat byl použit již známý Apache Airflow. Jakmile byla připravena každá fáze výroby dat, proběhla paralelně aktivace oddělené části DQ konvejeru.
Dobrou praxí je sledovat kvalitu dat od okamžiku jejich vzniku na analytické platformě. Majíc informace o metadatech, můžeme již od okamžiku, kdy informace vstupuje do primární vrstvy, kontrolovat dodržování základních podmínek — not null, constraints, foreign keys. Tato funkce byla realizována na základě automaticky generovaných mapování rodiny data quality v Datagram. Kódová generace v tomto případě také vychází z metadat modelu. Na projektu společnosti Mediascope probíhalo propojení s metadaty produktu Enterprise Architect.
Díky propojení low-code nástroje a Enterprise Architect byly automaticky generovány následující kontroly:
- Kontrola přítomnosti hodnot "null" v polích s modifikátorem "not null";
- Kontrola přítomnosti duplicit primárního klíče;
- Ověření cizího klíče entity;
- Ověření uniqueness řádku podle sady polí.
Pro složitější kontroly dostupnosti a přesnosti dat byl vytvořen mapping se Scala Expression, který přijímá externí Spark SQL kód kontroly, sestavený analytiky v Zeppelin.
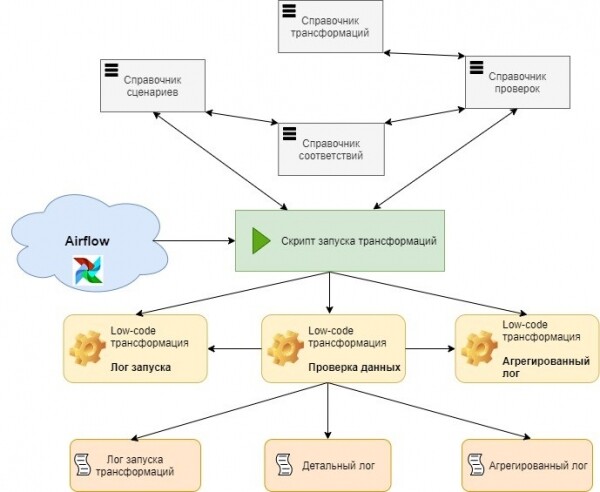
Samozřejmě, k automatizaci kontrol je třeba přistupovat postupně. V rámci popisovaného projektu tomu předcházely následující kroky:
- DQ, realizované v noteboocích Zeppelin;
- DQ, integrované do mappingu;
- DQ ve formě samostatných velkých mappingů, obsahujících celý soubor kontrol pro jednotlivou entitu;
- Univerzální parametrizované DQ mappingy, které přijímají vstupní informace o metadatech a obchodních kontrolách.
Hlavní výhodou vytvoření služby parametrizovaných kontrol je zkrácení času dodání funkcionality do produkčního prostředí. Nové kontroly kvality mohou obcházet klasický vzor dodání kódu prostřednictvím vývojových a testovacích prostředí:
- Všechny kontroly metadat jsou generovány automaticky při změně modelu v EA;
- Kontroly dostupnosti dat (určení přítomnosti jakýchkoli dat v určitý okamžik) mohou být generovány na základě rejstříku, který uchovává očekávaný čas vzniknutí další dávky dat v rámci objektů;
- Obchodní kontroly přesnosti dat jsou vytvářeny analytiky v noteboocích Zeppelin. Odtud jsou přímo odesílány do konfiguračních tabulek modulu DQ v produkčním prostředí.
Rizika přímého dodání skriptů do produkce prakticky neexistují. I při syntaktické chybě je maximum, co nám hrozí, – neprovedení jedné kontroly, neboť toky výpočtu dat a tok spouštění kontrol kvality jsou odděleny.
V podstatě, služba DQ je trvale spuštěna v produkčním prostředí a je připravena začít svou práci v okamžiku, kdy se objeví další dávka dat.
Na závěr
Výhoda využití low-code je zřejmá. Vývojáři nemusí vyvíjet aplikaci „od základu“. A programátor zbavený dodatečných úkolů dosahuje rychlejších výsledků. Rychlost na druhé straně osvobozuje další časové zdroje k řešení otázek optimalizace. V tomto případě se tedy lze spolehnout na vyšší kvalitu a rychlost řešení.
Samozřejmě, low-code není panacea a kouzlo se samo od sebe nestane:
- Malokodová odvětví procházejí etapou „zpevnění“ a dosud neexistují jednotné průmyslové standardy;
- Mnoho low-code řešení není zdarma a jejich pořízení by mělo být uváženým krokem, který by měl být učiněn s plným přesvědčením o finančních výhodách jejich využití;
- Mnohá malokodová řešení si ne vždy dobře rozumějí s GIT / SVN. Buď jsou nepohodlná na používání v případě skrytí generovaného kódu;
- Při rozšiřování architektury může být potřeba úprava malokodového řešení – což na druhé straně vyvolává efekt „připoutanosti a závislosti“ na poskytovateli low-code řešení.
- Požadovaná úroveň zabezpečení je možná, ale velmi pracná a složitá na realizaci motorů low-code systémů. Malokodové platformy by měly být vybírány nejen na základě hledání výhody z jejich využití. Při výběru je dobré si položit otázku ohledně přítomnosti funkcí správy přístupu a delegování / eskalace identifikačních dat na úroveň celého IT prostředí organizace.
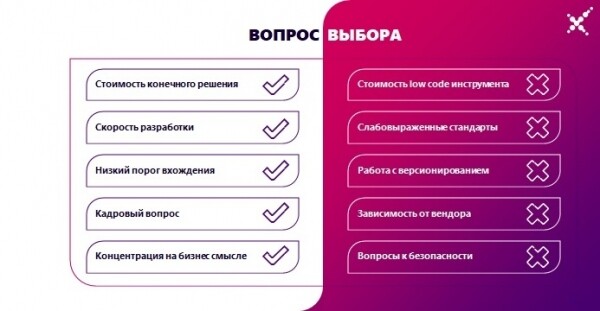
Pokud však znáte všechny nevýhody vybraného systému a přesto převládají benefity z jeho používání, pak přejděte na malý kód bez obav. Tím spíše, že přechod na něj je nevyhnutelný – jako každá evoluce.
Pokud jeden vývojář na low-code platformě provádí svou práci rychleji než dva vývojáři bez low-code, dává to společnosti výhodu ve všech ohledech. Prah vstupu do low-code řešení je nižší než u "tradičních" technologií, což má pozitivní dopad na problém nedostatku pracovních sil. Použití low-code nástrojů může urychlit spolupráci mezi funkčními týmy a rychlejší rozhodování o správnosti zvoleného směru datově-vědních výzkumů. Nízkokódové platformy mohou být příčinou digitální transformace organizace, protože vyprodukovaná řešení mohou být srozumitelná netechnickým specialistům (zejména obchodním uživatelům).
Pokud máte krátké termíny, zatíženou obchodní logiku, nedostatek technologických odborníků a potřebujete urychlit uvedení na trh, low-code je jedním ze způsobů, jak uspokojit vaše potřeby.
Nelze popřít význam tradičních vývojových nástrojů, nicméně v mnoha případech je použití low-code řešení nejlepším způsobem, jak zvýšit účinnost řešení úloh.
Zdroj: habr.com
