

Článek se zabývá problematikou čištění obrazů, které se hromadí v registrech kontejnerů (Docker Registry a jeho obdobách) v reáliích moderních CI/CD pipeline pro cloud native aplikace dodávané do Kubernetes. Uvedeny jsou hlavní kritéria relevance obrazů a vyplývající složitosti při automatizaci čištění, zachování místa a uspokojování potřeb týmů. Nakonec na příkladu konkrétního open source projektu ukážeme, jak tyto složitosti lze překonat.
Úvod
Počet obrazů v registru kontejnerů může rychle růst, zabírat více místa ve storage a tím pádem výrazně zvyšovat jeho náklady. Pro kontrolu, omezení či udržení přijatelný růst místa, které zaujímají v registry, je obvyklé:
- používat pevný počet tagů pro obrazy;
- nějakým způsobem očišťovat obrazy.
První omezení je občas přijatelné pro malé týmy. Pokud vývojářům stačí stálé tagy (latest, main, test, boris atd.), registr se nebude rozšiřovat a dlouho se nemusí přemýšlet o čištění. Všechny neaktuální obrazy se přepisují a pro čištění zkrátka nezůstává žádná práce (vše dělá systémový garbage collector).
Nicméně takový přístup silně omezuje vývoj a zřídka se uplatňuje v CI/CD moderních projektů. Nezbytnou součástí vývoje se stala automatizace, která umožňuje mnohem rychleji testovat, nasazovat a dodávat nové funkce uživatelům. Například ve všech našich projektech se při každém commitu automaticky vytváří CI pipeline. V ní se sestavuje obraz, testuje se, nasazuje do různých Kubernetes okruhů pro ladění a zbývající kontroly, a pokud je vše v pořádku — změny se dostanou k koncovému uživateli. A to už dávno není rocket science, ale běžnost pro mnohé — pravděpodobně i pro vás, když čtete tento článek.
Jelikož eliminace chyb a vývoj nových funkcí probíhá paralelně, a vydání mohou probíhat několikrát denně, je jasné, že proces vývoje je provázen významným množstvím commitů, což znamená — velké množství obrazů v registry. V důsledku toho se naléhavě vynořuje otázka organizace efektivního čištění registry, tj. odstranění neaktuálních obrazů.
Ale jak vůbec určit, zda je obraz aktuální?
Kritéria aktuálnosti obrazu
Ve většině případů budou hlavní kritéria následující:
1. První (nejzřejmější a nejkritičtější ze všech) — to jsou obrazy, které jsou aktuálně používány v Kubernetes. Odstranění těchto obrazů může vést k vážným nákladům v důsledku prostojů production (například obrazy mohou být potřebné při replikaci) nebo zmařit úsilí týmu, který se zabývá laděním na některém z kontur. (Z tohoto důvodu jsme dokonce vytvořili speciální , který sleduje nepřítomnost takových obrazů v jakémkoli Kubernetes clusteru.)
2. Druhé (méně zřejmé, ale také velmi důležité a opět se vztahuje k provozu) — to jsou obrazy, které jsou potřebné pro rollback v případě odhalení závažných problémů v aktuální verzi. Například v případě Helm to jsou obrazy, které se používají ve uložených verzích vydání. (Mimochodem, ve výchozím nastavení má Helm limit 256 revizí, ale těžko by někdo měl skutečnou potřebu uchovávat takové velké množství verzí?..) Vždyť právě kvůli tomu uchováváme verze, abychom je mohli později použít, tj. „vrátit se“ k nim v případě potřeby.
3. Třetí — potřeby vývojářů: všechny obrazy, které souvisejí s jejich aktuálními pracemi. Například pokud zvažujeme PR, má smysl ponechat obraz odpovídající poslednímu commitu a, dejme tomu, předchozímu commitu: tak se může vývojář rychle vrátit k jakékoli úloze a pracovat s posledními změnami.
4. Čtvrtý — obrazy, které odpovídají verzím naší aplikace, tj. představují konečný produkt: v1.0.0, 20.04.01, sierra atd.
NB: Kritéria uvedená zde byla formulována na základě zkušeností z interakcí s desítkami vývojářských týmů z různých společností. Nicméně samozřejmě mohou tato kritéria v závislosti na specifikách v procesech vývoje a používané infrastruktuře (například pokud se Kubernetes nepoužívá) lišit.
Soulad s kritérii a existujícími řešeními
Populární služby s registry kontejnerů obvykle nabízejí své politiky pro čištění obrazů: v nich můžete definovat podmínky, za kterých je tag odstraněn z registry. Možnosti těchto podmínek jsou však omezeny na takové parametry, jako jsou názvy, čas vytvoření a počet tagů*.
* Závisí na konkrétních implementacích registru kontejnerů. Zvažovali jsme možnosti následujících řešení: Azure CR, Docker Hub, ECR, GCR, GitHub Packages, GitLab Container Registry, Harbor Registry, JFrog Artifactory, Quay.io — k datu září 2020.
Takový set parametrů je zcela dostatečný k tomu, aby splnil čtvrté kritérium — tedy vybírat obrazy odpovídající verzím. Nicméně pro všechna ostatní kritéria je nutné zvolit nějaké kompromisní řešení (přísnější nebo naopak mírnější politiku) — v závislosti na očekáváních a finančních možnostech.
Například třetí kritérium — související s potřebami vývojářů — může být řešeno organizací procesů uvnitř týmů: specifickým pojmenováním obrazů, vedením speciálních allow listů a vnitřními dohodami. Ale nakonec je stejně třeba to automatizovat. A pokud schopnosti hotových řešení nestačí, musí se dělat něco vlastního.
Podobně je tomu i s dvěma prvními kritérii: nelze je splnit bez získání dat z externího systému — toho samého, kde dochází k nasazování aplikací (v našem případě je to Kubernetes).
Ilustrace workflow v Gitu
Předpokládejme, že pracujete přibližně podle této schémy v Gitu:
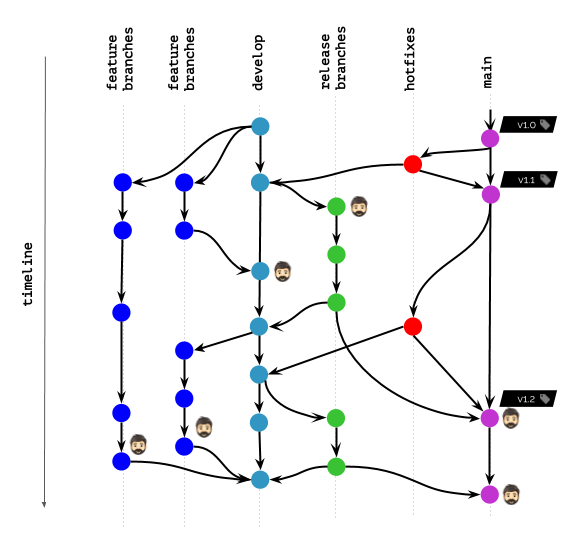
Ikonou s hlavou na schématu jsou označeny obrazy kontejnerů, které jsou v současnosti nasazeny v Kubernetes pro jakékoli uživatele (koncové uživatele, testery, manažery atd.) nebo je používají vývojáři k ladění a podobným účelům.
Co se stane, pokud politiky čištění umožňují ponechávat (neodstraňovat) obrazy pouze podle zadaných názvů tagů?
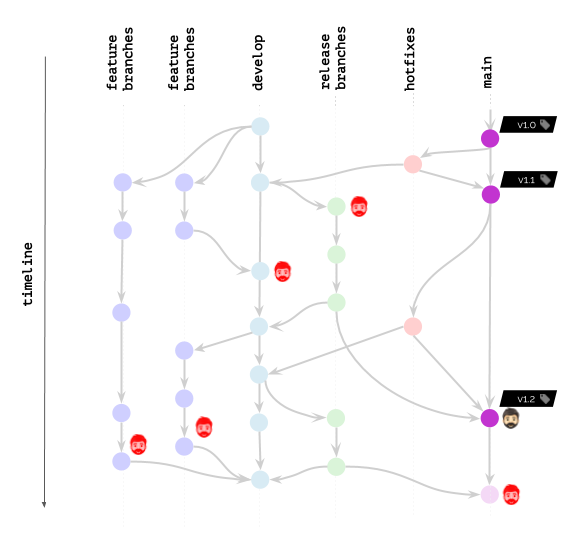
Je zřejmé, že takový scénář nikoho nepotěší.
Co se změní, pokud politiky umožňují neodstraňovat obrazy podle zadaného časového intervalu / počtu posledních commitů?
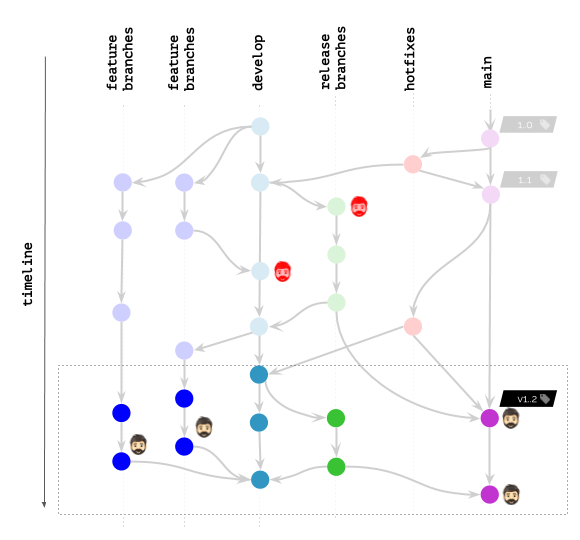
Výsledek se stal výrazně lepším, nicméně stále je daleko od ideálu. Vždyť stále máme vývojáře, kteří potřebují obrazy v registru (nebo dokonce nasazené v K8s) k ladění chyb...
Shrnující situaci na trhu: dostupné funkce v registrech kontejnerů nenabízejí dostatečnou flexibilitu při čištění, a hlavní příčinou toho je — nedostatek možnosti interakce se zevním světem. Zdá se, že týmy, které vyžadují takovou flexibilitu, jsou nuceny samy implementovat odstraňování obrazů „zvenku“, pomocí Docker Registry API (nebo nativního API příslušné implementace).
Hledali jsme však univerzální řešení, které by automatizovalo čištění obrazů pro různé týmy používající různé registry…
Naše cesta k univerzálnímu čištění obrazů
Odkud taková potřeba? Jde o to, že nejsme samostatná skupina vývojářů, ale tým, který obsluhuje hned několik takových, a pomáhá komplexně řešit otázky CI/CD. A hlavním technickým nástrojem pro toto je Open Source utility . Jejím znakem je, že nevykonává jedinou funkci, ale doprovází procesy kontinuální dodávky na všech úrovních: od sestavení po nasazení.
Publikování v registru* obrazů (ihned po jejich sestavení) — je zřejmá funkce takové utility. A protože se obrazy ukládají na uchování, pak — pokud vaše úložiště není nekonečné — musíte zajišťovat i jejich následné čištění. O tom, jak jsme toho dosáhli, a to splněním všech stanovených kritérií, bude dále řečeno.
* I když se samotné registry mohou lišit (Docker Registry, GitLab Container Registry, Harbor atd.), jejich uživatelé čelí stejným problémům. Univerzální řešení v našem případě nezávisí na implementaci registru, protože probíhá mimo samotné registry a nabízí stejnou funkčnost pro všechny.
I když používáme werf jako příklad realizace, doufáme, že použité přístupy budou přínosné i dalším týmům, které se setkaly s podobnými obtížemi.
Takže jsme se pustili do externí implementace mechanismu pro čištění obrazů — místo těch možností, které již jsou vestavěny v registrech pro kontejnery. Prvním krokem bylo využití Docker Registry API k vytvoření stejných primitivních politik ohledně počtu tagů a doby jejich vytvoření (jak bylo uvedeno výše). K nim byl přidán allow list založený na obrazech používaných v nasazené infrastruktuře, tj. Kubernetes. Pro poslední bylo dost prostě procházet všechny nasazené zdroje přes Kubernetes API a získat seznam hodnot obrázek.
Takové triviální řešení vyřešilo nejkritičtější problém (kritérium č. 1), ale bylo to jen začátkem naší cesty k vylepšení mechanismu čištění. Dalším — a mnohem zajímavějším — krokem bylo rozhodnutí svázat publikované obrazy s historií Git.
Schémy tagování
Na začátku jsme zvolili přístup, při kterém koncový obraz musí obsahovat potřebné informace pro čištění, a vybudovali jsme proces na základě schémat tagování. Při publikaci obrazu si uživatel vybral určitou možnost tagování (git-branch, git-commit nebo git-tag) a použil odpovídající hodnotu. V CI systémech byla tato hodnota automaticky nastavena na základě proměnných prostředí. V podstatě byl koncový obraz svázán s určitou Git primitivou,, uchovávající potřebná data pro čištění v labelech.
V rámci takového přístupu vznikl soubor politik, který umožnil používat Git jako jediný zdroj pravdy:
- Při odstranění větve/tagu v Gitu byly automaticky odstraněny i související obrazy v registry.
- Počet obrazů spojených s Git tagy a commity bylo možné regulovat množstvím tagů použitých ve zvolené схемě a časem vytvoření souvisejícího commitu.
Celkově splněná implementace vyhovovala našim potřebám, ale brzy nás čekala nová výzva. Skutečnost je taková, že během používání schémat tagování podle Git primitivů jsme narazili na řadu nedostatků. (Protože jejich popis vychází mimo rámec tohoto článku, všichni zájemci se mohou seznámit s podrobnostmi .) Proto, když jsme se rozhodli pro přechod na efektivnější přístup k tagování (tagování na základě obsahu), museli jsme přehodnotit i implementaci čištění obrazů.
Nový algoritmus
Proč? Při tagování na základě obsahu může každý tag splňovat více commitů v Gitu. Při čištění obrazů už nemůžeme vycházet pouze z commitu, ve kterém byl nový tag přidán do registry.
Pro nový algoritmus čištění bylo rozhodnuto opustit schémy tagování a vybudovat proces na meta-obrazech,, každý z nichž uchovává vazbu z:
- komit, na kterém bylo provedeno publikování (přitom nezáleží na tom, zda byl přidán, změněn, nebo zůstal původní obraz v registru kontejnerů);
- a našeho interního identifikátoru odpovídajícího sestavenému obrazu.
Jinými slovy, byla zajištěna věc publikovaných tagů s commity v Git..
Konečná konfigurace a obecný algoritmus
Uživatelům při konfiguraci čistění se staly dostupné politiky, podle kterých se vybírají aktuální obrazy. Každá taková politika je definována:
- množstvím reference, tj. Git-tagů nebo Git-větví, které se používají při skenování;
- a limitem hledaných obrazů pro každou referenci z množství.
Pro ilustraci — takto začala vypadat konfigurace politik podle defaultu:
cleanup:
  keepPolicies:
  - references:
      tag: \/.*\/
      limit:
        last: 10
  - references:
      branch: \/.*\/
      limit:
        last: 10
        in: 168h
        operator: And
    imagesPerReference:
      last: 2
      in: 168h
      operator: And
  - references:
      branch: \/^(main|staging|production)$\/
    imagesPerReference:
      last: 10
Tato konfigurace obsahuje tři politiky, které odpovídají následujícím pravidlům:
- Udržovat obraz pro 10 posledních Git-tagů (podle data vytvoření tagu).
- Udržovat maximálně 2 obrazy publikované za poslední týden pro maximálně 10 větví s aktivitou za poslední týden.
- Udržovat 10 obrazů pro větve
main,stagingaproduction.
Konečný algoritmus se tedy skládá z následujících kroků:
- Získání manifestů z registru kontejnerů.
- Vyloučení obrazů používaných v Kubernetes, protože ty jsme již předem vybrali, dotazem na K8s API.
- Skenování Git historie a vyloučení obrazů podle zadaných politik.
- Odstranění zbývajících obrazů.
Vracím se k naší ilustraci, takto to vypadá s werf:
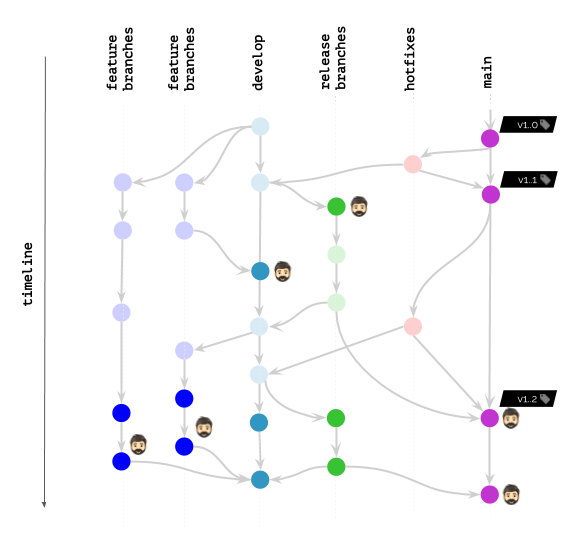
Nicméně, i když nepoužíváte werf, podobný přístup k pokročilému čištění obrazů — v jakékoli implementaci (v souladu s preferovaným přístupem k tagování obrazů) — může být aplikován i v jiných systémech/nástrojích. Stačí si vzpomenout na problémy, které vznikají, a najít ty možnosti ve vašem stacku, které umožňují integrovat jejich řešení nejplynuleji. Doufáme, že cesta, kterou jsme prošli, pomůže podívat se i na váš specifický případ s novými detaily a myšlenkami.
Závěr
- Dříve či později se většina týmů setká s problémem přeplnění registru.
- Při hledání řešení je nejprve třeba určit kritéria relevance obrazu.
- Nástroje nabízené populárními službami container registry umožňují velmi jednoduché čištění, které nebere v úvahu "vnější svět": obrazy používané v Kubernetes a specifika pracovních procesů v týmu.
- Flexibilní a efektivní algoritmus by měl mít přehled o CI/CD procesech a pracovat nejen s daty Docker obrazů.
P.S.
Přečtěte si také náš blog:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
