

Budoucnost přišla, technologie umělé inteligence a strojového učení již úspěšně používají vaše oblíbené obchody, dopravní společnosti a dokonce i farmy chovající krůty.
A pokud něco existuje, znamená to, že na internetu o tom už něco je… otevřený projekt! Podívejte se, jak Open Data Hub pomáhá škálovat nové technologie a vyhýbat se obtížím při jejich zavádění.
I přes všechny výhody umělé inteligence (artificial intelligence, AI) a strojového učení (machine learning, ML) mají organizace často potíže se škálováním těchto technologií. Hlavní problémy obvykle zahrnují následující:
- Výměna informací a spolupráce – sdílení informací bez zbytečných obtíží a spolupráce v režimu rychlých iterací je téměř nemožné.
- Přístup k datům – pro každou úlohu je potřeba jej vytvářet znovu a ručně, což zabírá spoustu času.
- Přístup na vyžádání – není možné získat on-demand přístup k nástrojům a platformě strojového učení i k výpočetní infrastruktuře.
- Produkce – modely zůstávají ve fázi prototypu a nejsou uvedeny do provozu.
- Sledování a vysvětlování výsledků práce AI – reprodukovatelnost, sledování a vysvětlování výsledků AI/ML je obtížné.
Pokud zůstanou tyto problémy nevyřešeny, negativně ovlivňují rychlost, efektivitu a produktivitu cenných odborníků na zpracování a analýzu dat. To vede k jejich frustraci, zklamání v práci a nakonec očekávání podniků ohledně AI/ML se nenaplní.
Odpovědnost za řešení těchto problémů leží na IT odbornících, kteří musí poskytnout datovým analytikům – správně, něco jako cloud. Pokud to rozšíříme, je třeba platforma, která poskytuje svobodu volby a má snadný, jednoduchý přístup. Přitom by měla být rychlá, snadno přeprogramovatelná, škálovatelná na vyžádání a odolná vůči selhání. Vytváření takové platformy na základě technologií s otevřeným zdrojovým kódem pomáhá vyhnout se závislosti na dodavatelích a udržet dlouhodobou strategickou výhodu v oblasti kontroly nákladů.
Před několika lety se něco podobného dělo ve vývoji aplikací a vedlo k vzniku mikroslužeb, hybridních cloudových prostředí, IT automatizace a agile procesů. Aby se s tímto vyrovnali, IT specialisté začali používat kontejnery, Kubernetes a otevřené hybridní cloudy.
Nyní se tato zkušenost aplikuje na odpovědi na výzvy AI. Proto IT specialisté vytvářejí platformy, které se zakládají na kontejnerech, umožňují vytvářet AI/ML služby v rámci agile procesů, zrychlují inovace a jsou konstruovány s ohledem na hybridní cloud.
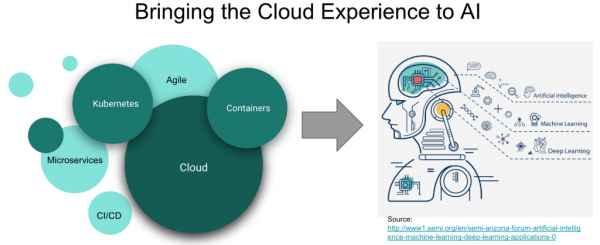
Budování takové platformy začneme s Red Hat OpenShift, naší kontejnerovou Kubernetes platformou pro hybridní cloud, která má rychle rostoucí ekosystém softwarových a hardwarových ML řešení (NVIDIA, H2O.ai, Starburst, PerceptiLabs atd.). Někteří z klientů Red Hat, jako například BMW Group, ExxonMobil a další, již nasadili kontejnerizované řetězce ML nástrojů a DevOps procesy založené na této platformě a jejím ekosystému, aby uvedli své ML architektury do průmyslového provozu a urychlili práci datových analytiků.
Dalším důvodem, proč jsme spustili projekt Open Data Hub, je předvést příklad architektury na základě několika projektů se otevřeným kódem a ukázat, jak realizovat celý životní cyklus ML řešení na platformě OpenShift.
Projekt Open Data Hub
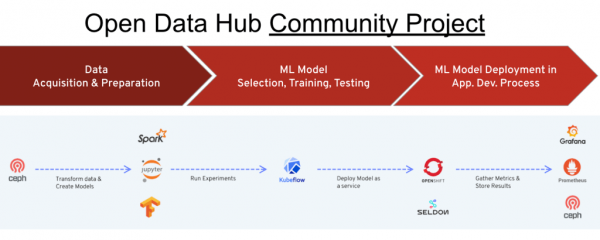
Je to projekt s otevřeným kódem, který se vyvíjí v rámci příslušného komunitního vývoje a realizuje plný cyklus operací – od načítání a transformace vstupních dat až po tvorbu, trénování a údržbu modelu – při řešení úloh AI/ML pomocí kontejnerů a Kubernetes na platformě OpenShift. Tento projekt lze považovat za referenční implementaci, příklad toho, jak vybudovat otevřené řešení typu "AI/ML jako služba" na základě OpenShift a odpovídajících nástrojů s otevřeným kódem, jako jsou Tensorflow, JupyterHub, Spark a další. Je důležité poznamenat, že Red Hat tento projekt využívá k poskytování svých služeb AI/ML. Kromě toho se OpenShift integruje s klíčovými softwarovými a hardwarovými ML řešeními od NVIDIA, Seldon, Starbust a dalších dodavatelů, což usnadňuje budování a spouštění vlastních systémů strojového učení.
Projekt Open Data Hub se zaměřuje na následující kategorie uživatelů a scénáře použití:
- Datový analytik, který potřebuje řešení pro implementaci ML projektů organizované jako cloudové řešení se samoobslužnými funkcemi.
- Datový analytik, který potřebuje maximální výběr z nejnovějších nástrojů a platforem AI/ML s otevřeným zdrojovým kódem.
- Datový analytik, který potřebuje přístup k datovým zdrojům při trénování modelů.
- Datový analytik, který potřebuje přístup k výpočetním prostředkům (CPU, GPU, paměť).
- Datový analytik, kterému je třeba umožnit spolupráci a výměnu pracovních výsledků s kolegy, získávání zpětné vazby a implementaci vylepšení pomocí rychlých iterací.
- Datový analytik, který chce spolupracovat s vývojáři (a devops týmy), aby jeho ML modely a výsledky pracovního procesu přešly do produkce.
- Datový inženýr, který musí zajistit, aby datoví analytici měli přístup k různým datovým zdrojům při dodržení bezpečnostních předpisů a požadavků.
- Administrátor/provozovatel IT systémů, který potřebuje snadno řídit životní cyklus (instalace, konfigurace, aktualizace) komponent a technologií s otevřeným zdrojovým kódem. Také jsou potřeba odpovídající nástroje pro správu a kvótování.
Projekt Open Data Hub zahrnuje celou řadu nástrojů s otevřeným zdrojovým kódem pro provádění celého cyklu operací AI/ML. Jako hlavní pracovní nástroj datového analytika se zde používá Jupyter Notebook. Tento nástroj je dnes široce populární mezi odborníky na zpracování a analýzu dat, a Open Data Hub jim umožňuje snadno vytvářet a spravovat pracovní oblasti Jupyter Notebooků pomocí vestavěného JupyterHubu. Kromě vytváření a importu Jupyter notebooků obsahuje projekt Open Data Hub také řadu již připravených notebooků ve formě knihovny AI Library.
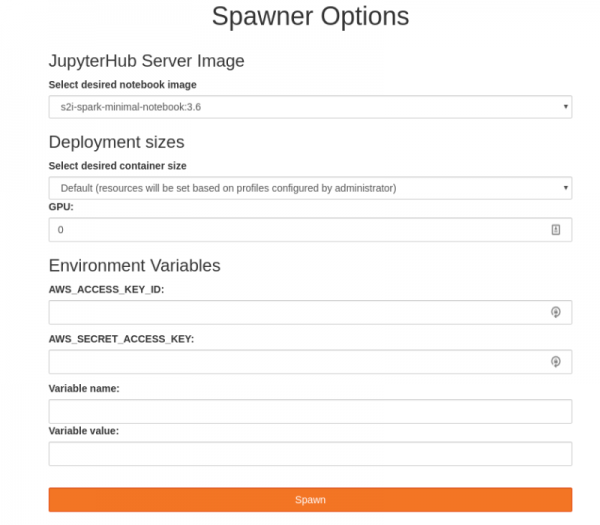
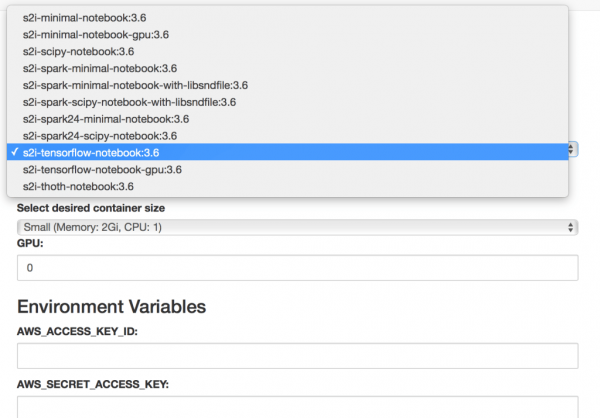
Tato knihovna představuje sbírku open-source komponent strojového učení a řešení pro standardní scénáře, která usnadňují rychlé prototypování. JupyterHub je integrován s RBAC modelem přístupu OpenShift, což umožňuje používat již existující účty OpenShift a implementovat jednotné přihlášení do systému. Kromě toho JupyterHub nabízí uživatelsky přívětivé rozhraní nazvané spawner, pomocí něhož si uživatel může snadno nakonfigurovat objem výpočetních zdrojů (procesorová jádra, paměť, GPU) pro vybraný Jupyter Notebook.
Až data analytik vytvoří a nakonfiguruje notebook, veškerou další péči o něj přebírá plánovač Kubernetes, který je součástí OpenShift. Uživatelům zbývá pouze provádět své experimenty, ukládat a sdílet výsledky své práce. Kromě toho mohou pokročilí uživatelé přímo přistupovat k CLI shellu OpenShift přímo z Jupyter notebooks, aby využili Kubernetes primitiva, jako je Job, nebo funkčnost OpenShift, například Tekton nebo Knative. Nebo k tomu lze použít pohodlné uživatelské rozhraní OpenShift, které se nazývá „webová konzole OpenShift“.
Při přechodu na další fázi Open Data Hub umožňuje spravovat datové kanály (data pipelines). K tomu se používá objekt Ceph, který je poskytován jako S3-kompatibilní objektový úložiště dat. Apache Spark zajišťuje streaming dat z externích zdrojů nebo integrovaného úložiště Ceph S3 a umožňuje provádět předběžné transformace dat. Apache Kafka zajišťuje pokročilou správu datových kanálů (kde lze provádět opakované načítání a také operace transformace, analýzy a ukládání dat).
Takže datový analytik získal přístup k datům a vybudoval model. Nyní má touhu sdílet získané výsledky se svými kolegy nebo vývojáři aplikací a poskytnout jim svůj model na principu služby. K tomu je potřeba výstupní server a Open Data Hub má takový server, který se nazývá Seldon a umožňuje publikovat model ve formě RESTful služby.
V určitém okamžiku se na serveru Seldon objevuje několik takových modelů a vzniká potřeba monitorovat, jak jsou používány. V této souvislosti Open Data Hub nabízí kolekci relevantních metrik a reportovací engine založený na široce používaných open-source nástrojích pro monitorování Prometheus a Grafana. Výsledkem je zpětná vazba pro sledování používání AI modelů, zejména v produkčním prostředí.
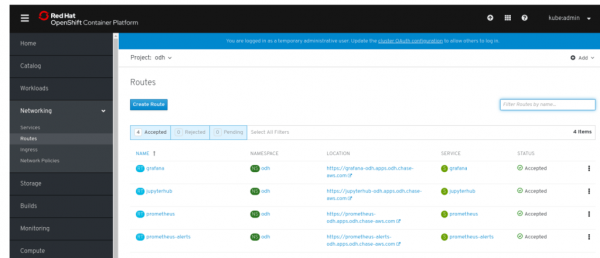
Open Data Hub tak poskytuje cloudový přístup po celou dobu životního cyklu AI/ML operací, začínaje přístupem a přípravou dat a konče trénováním a průmyslovým nasazením modelu.
Dáváme vše dohromady
Teď se objevuje otázka, jak to vše zorganizovat administrátorovi OpenShift. A zde přichází na řadu speciální Kubernetes operator pro projekty Open Data Hub.
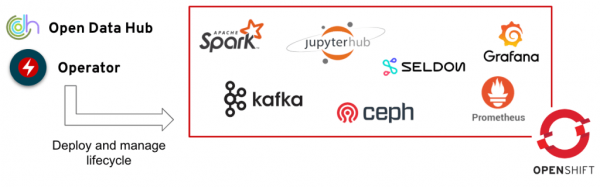
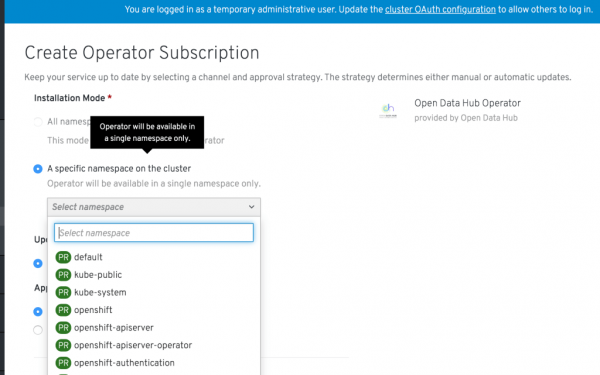
Tento operator spravuje instalaci, konfiguraci a životní cyklus projektu Open Data Hub, včetně nasazení výše zmíněných nástrojů jako JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus a Grafana. Projekt Open Data Hub lze najít ve webové konzoli OpenShift v sekci komunitních operátorů. Tímto způsobem může administrátor OpenShift nastavit, že příslušné projekty OpenShift patří do kategorie „projekt Open Data Hub“. Tato operace se provádí jednou. Poté datový analytik prostřednictvím webové konzole OpenShift vstoupí do svého projektového prostoru a vidí, že pro jeho projekty je nainstalován a dostupný příslušný Kubernetes operator. Následně vytvoří instanci projektu Open Data Hub jedním kliknutím a okamžitě získá přístup k výše popsaným nástrojům. A to vše lze nastavit v režimu vysoké dostupnosti a odolnosti vůči poruchám.
Pokud chcete projekt Open Data Hub vyzkoušet na vlastní kůži, začněte s . Technické podrobnosti architektury Open Data Hub lze najít , plány rozvoje projektu – . V budoucnu se plánuje realizace další integrace s Kubeflow, řešení různých problémů s regulací dat a bezpečností, a také organizace integrace se systémovými pravidly na základě Drools a Optaplanner. Vyjádřit svůj názor a stát se účastníkem projektu lze na stránce .
Shrnutí: vážné problémy se škálováním brání organizacím plně využít potenciál umělé inteligence a strojového učení. Red Hat OpenShift je dlouhodobě a úspěšně používán k řešení podobných problémů v softwarovém sektoru. Projekt Open Data Hub, realizovaný v rámci komunity otevřeného vývoje, nabízí referenční architekturu pro organizaci celého cyklu operací AI/ML založených na hybridním cloudu OpenShift. Máme jasný a promyšlený plán rozvoje tohoto projektu a jsme vážně odhodláni vytvořit kolem něj aktivní a plodnou komunitu vývoje otevřených AI řešení na platformě OpenShift.
Zdroj: habr.com
