

Webové aplikace jsou dnes používány všude a mezi všemi transportními protokoly zaujímá HTTP velkou část. Při studiu nuancí vývoje webových aplikací většina věnuje velmi málo pozornosti operačnímu systému, na kterém se tyto aplikace skutečně spouštějí. Rozdělení vývoje (Dev) a provozu (Ops) situaci pouze zhoršovalo. S rozšiřováním kultury DevOps však začínají vývojáři nést odpovědnost za spuštění svých aplikací v cloudu, a proto je pro ně velmi užitečné důkladně se seznámit s backendem operačního systému. To je obzvláště užitečné, pokud se snažíte nasadit systém pro tisíce nebo desítky tisíc souběžných připojení.
Omezení ve webových službách jsou velmi podobná omezením v jiných aplikacích. Ať už jde o load balancery nebo servery DB, všechna tato aplikační řešení mají podobné problémy v prostředí s vysokým výkonem. Pochopení těchto základních omezení a způsobů, jak je překonat, umožní celkově vyhodnotit výkon a škálovatelnost vašich webových aplikací.
Píšu tuto sérii článků jako reakci na otázky mladých vývojářů, kteří chtějí být dobře informovanými systémovými architekty. Není možné jasně pochopit metody optimalizace aplikací Linux bez ponoření se do základů, jak fungují na úrovni operačního systému. I když existuje mnoho typů aplikací, v této sérii chci prozkoumat síťové aplikace, nikoli desktopové, jako je prohlížeč nebo textový editor. Tento materiál je určen pro vývojáře a architekty, kteří chtějí pochopit, jak programy Linux nebo Unix fungují a jak je strukturovat pro vysoký výkon.
Linux je serverový operační systém a většina vašich aplikací běží na tomto OS. Ačkoli říkám "Linux", většinu času můžete s jistotou předpokládat, že mám na mysli všechny unixové podobné operační systémy jako celek. Nicméně, nesledoval jsem doprovodný kód na jiných systémech. Takže pokud vás zajímá FreeBSD nebo OpenBSD, výsledky se mohou lišit. Když zkouším něco specifického pro Linux, tak to uvádím.
I když můžete využít nabyté znalosti k vytvoření aplikace od nuly a ta bude skvěle optimalizovaná, je lepší to nedělat. Pokud napíšete nový webový server v C nebo C++ pro obchodní aplikaci vaší organizace, pravděpodobně to bude váš poslední den v práci. Nicméně znalost struktury těchto aplikací pomůže při výběru již existujících programů. Budete moci porovnávat systémy založené na procesech se systémy založenými na vláknech, stejně jako na událostech. Pochopíte a oceníte, proč Nginx funguje lépe než Apache httpd, a proč aplikace Python založená na Tornadu může obsluhovat více uživatelů ve srovnání s aplikací Python na základě Django.
ZeroHTTPd: vzdělávací nástroj
je webový server, který jsem napsal od nuly v C jako vzdělávací nástroj. Nemá žádné externí závislosti, včetně přístupu k Redis. Spouštíme vlastní procedury Redis. Podrobnosti viz níže.
I když bychom mohli dlouho diskutovat o teorii, není nic lepšího než napsat kód, spustit ho a vzájemně porovnat všechny architektury serverů. To je nejpřehlednější metoda. Proto budeme psát jednoduchý webový server ZeroHTTPd, využívající každý model: založený na procesech, vláknech a událostech. Ověříme každý z těchto serverů a podíváme se, jak spolupracují. ZeroHTTPd je realizován v jednom souboru C. Součástí serveru založeného na událostech je , skvělá implementace hash tabulky, která se dodává v jednom hlavičkovém souboru. V ostatních případech žádné závislosti nejsou, aby se projekt jejich nekomplikoval.
V kódu je spousta komentářů, které pomáhají se zorientovat. Jako jednoduchý webový server v několika řádcích kódu, ZeroHTTPd je také minimální rámec pro webový vývoj. Má omezenou funkčnost, ale dokáže servírovat statické soubory a velmi jednoduché „dynamické“ stránky. Musím říct, že ZeroHTTPd je dobře uzpůsoben pro učení, jak vytvářet vysoce výkonné aplikace pro Linux. V podstatě většina webových služeb čeká na požadavky, kontroluje je a zpracovává. Přesně to bude ZeroHTTPd dělat. Je to nástroj pro učení, nikoli pro produkční prostředí. Není silný v zpracování chyb a pravděpodobně se nemůže pochlubit nejlepšími bezpečnostními praktikami (oh ano, použil jsem strcpy) nebo složitými triky jazyka C. Ale doufám, že si se svou úlohou poradí dobře.
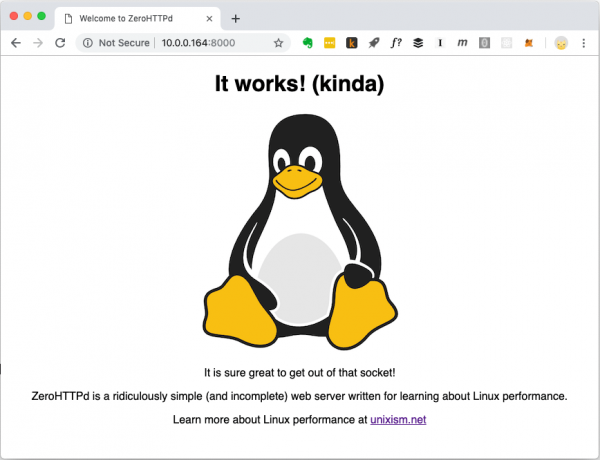
Domovská stránka ZeroHTTPd. Může poskytovat různé typy souborů, včetně obrázků
Aplikace knihy hostů
Moderní webové aplikace obvykle nejsou omezeny na statické soubory. Mají složitou interakci s různými databázemi, cache atd. Proto vytvoříme jednoduchou webovou aplikaci s názvem „Kniha hostů“, kde návštěvníci zanechávají záznamy pod svými jmény. V knize hostů se ukládají předchozí záznamy. Na dolní části stránky je také počitadlo návštěvníků.
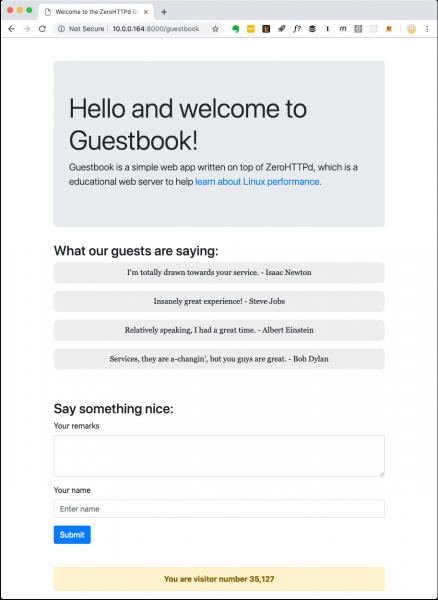
Webová aplikace „Kniha hostů“ ZeroHTTPd
Počitadlo návštěvníků a záznamy knihy hostů jsou uloženy v Redis. Pro komunikaci s Redis jsme implementovali vlastní procedury, které nezávisí na externí knihovně. Nejsem velký fanoušek používání domácího kódu, když existují veřejně dostupná a dobře testovaná řešení. Ale cílem ZeroHTTPd je prozkoumat výkon Linuxu a přístup k externím službám, zatímco zpracování HTTP požadavků má značný dopad na výkon. Musíme plně kontrolovat komunikaci s Redis ve všech našich serverových architekturách. V jedné architektuře používáme blokující volání, v jiných procedury založené na událostech. Použití externí klientské knihovny Redis nám neposkytne takovou kontrolu. Navíc náš malý klient Redis provádí pouze několik funkcí (získání, nastavení a zvýšení klíče; získání a přidání do pole). Kromě toho je protokol Redis mimořádně elegantní a jednoduchý. Není potřeba se jej ani speciálně učit. Samotný fakt, že veškerou práci protokol provádí zhruba ve sto řádcích kódu, naznačuje, jak dobře je navržen.
Na dalším obrázku jsou znázorněny akce aplikace, když klient (prohlížeč) provádí požadavek /guestbookURL.

Mechanismus fungování aplikace knihy hostů
Když je potřeba vyřídit stránku návštěvní knihy, dojde k jednomu volání na souborový systém pro načtení šablony do paměti a třem síťovým voláním k Redis. Soubor šablony obsahuje většinu obsahu HTML pro stránku na vrchním snímku. Obsahuje také speciální zástupné symboly pro dynamickou část obsahu: příspěvky a počítadlo návštěvníků. Ty získáváme z Redis, vkládáme je na stránku a vydáváme klientovi kompletně sestavený obsah. Třetího volání k Redis se lze vyhnout, protože Redis vrací novou hodnotu klíče při zvýšení. Nicméně pro náš server s asynchronní architekturou založenou na událostech jsou četná síťová volání dobrým testem pro vzdělávací účely. Takže ignorujeme vracenou hodnotu Redis ohledně počtu návštěvníků a žádáme o ni samostatným voláním.
Serverové architektury ZeroHTTPd
Vytváříme sedm verzí ZeroHTTPd se stejnou funkcionalitou, ale různými architekturami:
- Iterativní
- Fork server (jediný podproces na žádost)
- Pre-fork server (předběžné forkování procesů)
- Server s vlákny (jedno vlákno na žádost)
- Server s předem vytvořenými vlákny
- Architektura založená na
poll() - Architektura založená na
epoll
Měříme výkon každé architektury tím, že zatížíme server HTTP požadavky. Nicméně při srovnávání architektur s vysokou mírou paralelismu se počet požadavků zvyšuje. Testujeme třikrát a počítáme průměr.
Metodologie testování
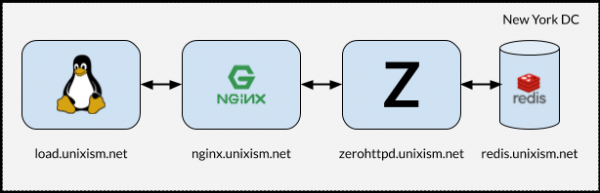
Nastavení pro zatěžkávací testování ZeroHTTPd
Je důležité, aby při provádění testů všechny komponenty nepracovaly na jednom stroji. V tomto případě má OS další režijní náklady na plánování, protože komponenty soutěží o CPU. Měření režijních nákladů operačního systému s každou z vybraných serverových architektur je jedním z nejdůležitějších cílů tohoto cvičení. Přidání většího počtu proměnných by bylo škodlivé pro proces. Proto nastavení na výše uvedeném obrázku funguje nejlépe.
Co dělá každý z těchto serverů
- load.unixism.net: zde spouštíme
ab, nástroj Apache Benchmark. Generuje zátěž potřebnou pro testování našich serverových architektur. - nginx.unixism.net: Někdy chceme spustit více než jednu instanci serverového programu. K tomu server Nginx s příslušnými nastaveními funguje jako vyrovnávač zatížení pro ab naše serverové procesy.
- zerohttpd.unixism.net: zde spouštíme naše serverové programy na sedmi různých architekturách, po jedné najednou.
- redis.unixism.net: na tomto serveru běží démon Redis, kde jsou uloženy záznamy v návštěvní knize a počítadlo návštěvníků.
Všechny servery pracují na jednom procesorovém jádře. Myšlenkou je zhodnotit maximální výkon každé architektury. Vzhledem k tomu, že všechny serverové programy jsou testovány na stejném hardwaru, to je základní úroveň pro jejich srovnání. Moje testovací instalace se skládá z virtuálních serverů, které si pronajímám od Digital Ocean.
Co měříme?
Můžeme měřit různé ukazatele. Hodnotíme výkon každé architektury v této konfiguraci, zatěžováním serverů požadavky na různých úrovních paralelismu: zatížení vzrůstá od 20 do 15 000 současných uživatelů.
Výsledky testů
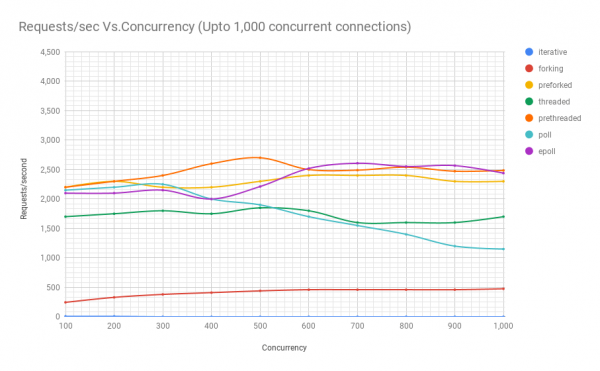
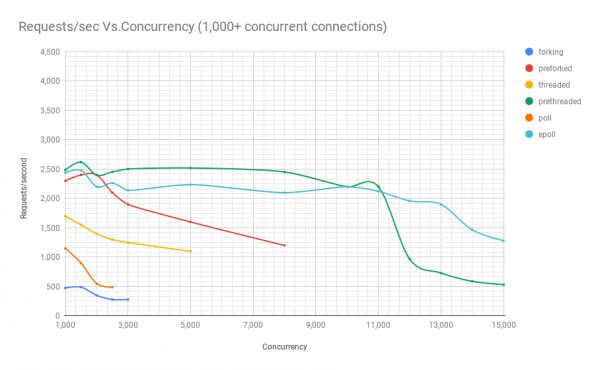
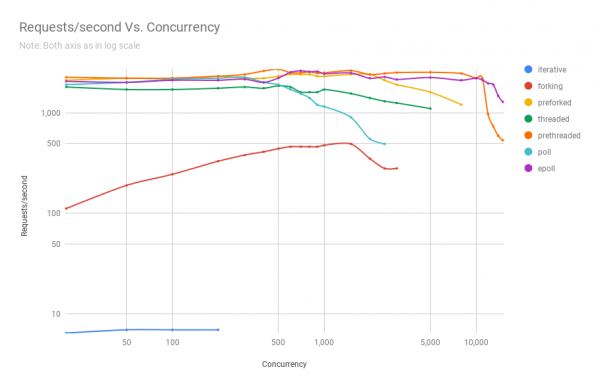
Na následujícím diagramu je znázorněn výkon serverů na různých architekturách při různých úrovních paralelismu. Na ose y je počet požadavků za sekundu, na ose x paralelní spojení.
Níže je tabulka s výsledky.
požadavků za sekundu
paralelismus
iterativní
fork
pre-fork
datumový
pre-threading
poll
epoll
20
7
112
2100
1800
2250
1900
2050
50
7
190
2200
1700
2200
2000
2000
100
7
245
2200
1700
2200
2150
2100
200
7
330
2300
1750
2300
2200
2100
300
–
380
2200
1800
2400
2250
2150
400
–
410
2200
1750
2600
2000
2000
500
–
440
2300
1850
2700
1900
2212
600
–
460
2400
1800
2500
1700
2519
700
–
460
2400
1600
2490
1550
2607
800
–
460
2400
1600
2540
1400
2553
900
–
460
2300
1600
2472
1200
2567
1000
–
475
2300
1700
2485
1150
2439
1500
–
490
2400
1550
2620
900
2479
2000
–
350
2400
1400
2396
550
2200
2500
–
280
2100
1300
2453
490
2262
3000
–
280
1900
1250
2502
velký rozsah
2138
5000
–
velký rozsah
1600
1100
2519
–
2235
8000
–
–
1200
velký rozsah
2451
–
2100
10 000
–
–
velký rozsah
–
2200
–
2200
11 000
–
–
–
–
2200
–
2122
12 000
–
–
–
–
970
–
1958
13 000
–
–
–
–
730
–
1897
14 000
–
–
–
–
590
–
1466
15 000
–
–
–
–
532
–
1281
Z grafu a tabulky je zřejmé, že nad 8000 současných požadavků zůstávají pouze dva hráči: pre-fork a epoll. S rostoucím zatížením server na bázi poll funguje hůře než datový. Architektura s předběžným vytvářením vláken představuje důstojnou konkurenci epoll: to dokazuje, jak dobře jádro Linuxu plánuje velké množství vláken.
Zdrojový kód ZeroHTTPd
Zdrojový kód ZeroHTTPd . Pro každou architekturu samostatný adresář.
ZeroHTTPd
│
├── 01_iterative
│   ├── main.c
├── 02_forking
│   ├── main.c
├── 03_preforking
│   ├── main.c
├── 04_threading
│   ├── main.c
├── 05_prethreading
│   ├── main.c
├── 06_poll
│   ├── main.c
├── 07_epoll
│    └── main.c
├── Makefile
├── public
│   ├── index.html
│   └── tux.png
└── templates
    └── guestbook
        └── index.html
Kromě sedmi adresářů pro všechny architektury existují ještě dvě v kořenovém adresáři: public a templates. V prvním se nachází soubor index.html a obrázek z prvního screenshotu. Do něj můžete vložit další soubory a složky, a ZeroHTTPd by měl bez problémů vydávat tyto statické soubory. Pokud cesta v prohlížeči odpovídá cestě ve složce public, ZeroHTTPd hledá v tomto adresáři soubor index.html. Obsah pro návštěvní knihu se generuje dynamicky. Má pouze hlavní stránku a její obsah je založen na souboru ‘templates/guestbook/index.html’. V ZeroHTTPd je snadné přidávat dynamické stránky pro rozšíření. Myšlenka spočívá v tom, že uživatelé mohou do tohoto adresáře přidávat šablony a rozšiřovat ZeroHTTPd podle potřeby.
Pro sestavení všech sedmi serverů spusťte make all z kořenového adresáře – a všechny buildy se objeví v tomto adresáři. Spustitelné soubory hledají adresáře public a templates v tom adresáři, odkud jsou spuštěny.
Linux API
Abychom porozuměli informacím v tomto cyklu článků, není nutné mít dobré znalosti o Linux API. Doporučuji však přečíst si více na toto téma, v síti je mnoho referenčních zdrojů. Ačkoli se dotkneme několika kategorií Linux API, naše pozornost se zaměří především na procesy, vlákna, události a síťový zásobník. Kromě knih a článků o Linux API také doporučuji přečíst si manuály pro systémové volání a používané knihovní funkce.
Výkon a škálovatelnost
Malá poznámka k výkonu a škálovatelnosti. Teoreticky mezi nimi není žádná vazba. Můžete mít webovou službu, která funguje velmi dobře, s dobou odezvy několika milisekund, ale není vůbec škálovatelná. Stejně tak může existovat špatně fungující webová aplikace, která potřebuje několik sekund k odezvě, ale je škálovatelná na desítky pro zpracování desítek tisíc simultánních uživatelů. Přesto je kombinace vysokého výkonu a škálovatelnosti velmi silná kombinace. Vysokovýkonné aplikace obecně hospodárně využívají zdroje a tím efektivně obsluhují více simultánních uživatelů na serveru, čímž snižují náklady.
Úlohy CPU a I/O
Nakonec existují dva možné typy úloh ve výpočtech: pro I/O a CPU. Získávání požadavků přes internet (síťový vstup/výstup), správa souborů (síťový a diskový vstup/výstup), komunikace s databází (síťový a diskový vstup/výstup) – to vše jsou činnosti I/O. Některé požadavky na databázi mohou mírně zatěžovat CPU (třídění, výpočet průměru milionu výsledků atd.). Většina webových aplikací je omezená maximálním možným I/O, zatímco procesor je zřídka využíván na plnou kapacitu. Když vidíte, že nějaká úloha vstupu/výstupu využívá hodně CPU, pravděpodobně to naznačuje špatnou architekturu aplikace. To může znamenat, že se zdroje CPU utrácí na správu procesů a přepínání kontextu – a to není úplně užitečné. Pokud děláte něco jako zpracování obrázků, převod audio souborů nebo strojové učení, pak aplikace vyžaduje silné zdroje CPU. Ale většinou aplikací tomu tak není.
Podrobněji o serverových architekturách
Zdroj: habr.com
