

Dnes si povíme, jak nejlépe uchovávat data ve světě, kde pátá generace sítí, genomové skenery a bezpilotní vozidla generují za den více dat, než lidstvo vytvořilo od průmyslové revoluce.
Náš svět generuje čím dál více informací. Některé z nich jsou jen pomíjivé a ztrácí se tak rychle, jak se shromažďují. Jiné musí být uchovávány déle a některé jsou určeny dokonce na "věky" – minimálně, tak to vidíme z dnešního pohledu. Informační toky se usazují v datových centrech takovou rychlostí, že jakýkoli nový přístup nebo technologie, které mají uspokojit tento nekonečný "dopyt", rychle zastarávají.
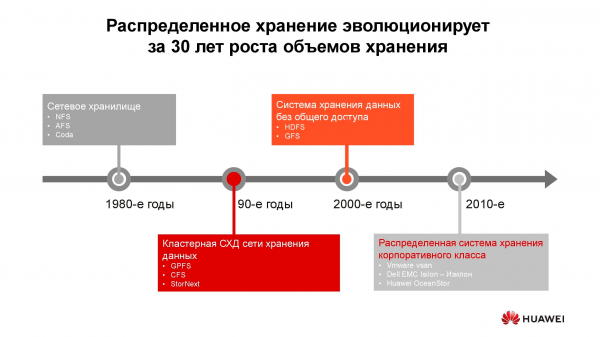
40 let vývoje distribuovaných úložišť
První síťová úložiště v podobě, kterou známe dnes, se objevila v 80. letech. Mnozí z vás se setkali s NFS (Network File System), AFS (Andrew File System) nebo Coda. Po deseti letech se móda a technologie změnily a distribuované souborové systémy ustoupily klastrovým úložištím založeným na GPFS (General Parallel File System), CFS (Clustered File Systems) a StorNext. Jako základ byla používána bloková úložiště klasické architektury, nad nimiž byl pomocí softwarového vrstvy vytvářen jednotný souborový systém. Tato a podobná řešení se stále používají, zabírají svou niku a jsou velmi žádaná.
Na přelomu tisíciletí se paradigma distribuovaných úložišť poněkud změnilo a na vedoucí pozice se dostaly systémy s architekturou SN (Shared-Nothing). Došlo k přechodu od klastrového ukládání k ukládání na jednotlivých uzlech, přičemž tyto uzly představovaly obvykle klasické servery s poskytovaným spolehlivým ukládacím softwarem; na těchto principech byly postaveny například HDFS (Hadoop Distributed File System) a GFS (Global File System).
Kolem roku 2010 se koncepty, které tvořily základ distribuovaných systémů ukládání, čím dál více začaly odrážet v plnohodnotných komerčních produktech, jako jsou VMware vSAN, Dell EMC Isilon a naše . Za zmíněnými platformami už nestojí jen komunita nadšenců, ale konkrétní prodejci, kteří zodpovídají za funkčnost, podporu, servisní údržbu produktu a zaručují jeho dalšímu vývoji. Tato řešení jsou nejžádanější v několika oblastech.
Telekomunikační operátoři
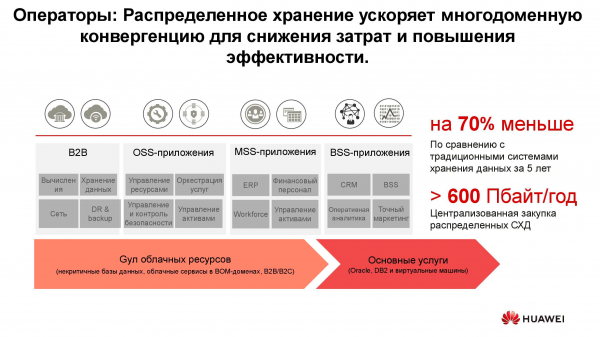
Jedním z nejstarších spotřebitelů distribuovaných systémů ukládání dat jsou operátoři telekomunikací. Na schématu je vidět, jaké skupiny aplikací generují hlavní objem dat. OSS (systémy podporující provoz), MSS (systémy podporující management) a BSS (systémy podporující podnikání) představují tři vzájemně doplňující se softwarové vrstvy potřebné k poskytování služby zákazníkům, finančnímu reportingu poskytovateli a provozní podpoře technikům operátora.
Často jsou data těchto vrstev silně promíchána, a aby se zabránilo akumulaci nežádoucích kopií, slouží právě distribuované úložiště, která akumulují celý objem informací přicházejících z fungující sítě. Úložiště se spojují do společného poolu, na který se odkazují všechny služby.
Naše kalkulace ukazují, že přechod od klasických SDD k blokovým umožňuje ušetřit až 70 % rozpočtu pouze tím, že se vzdáme dedikovaných SDD třídy hi-end a použijeme běžné servery klasické architektury (obvykle x86), které pracují v kombinaci se specializovaným softwarem. Mobilní operátoři již delší dobu začali nakupovat podobná řešení ve značných objemech. Zejména ruské operátory používají podobné produkty od společnosti Huawei déle než šest let.
Ano, některé úkoly pomocí distribuovaných systémů nelze splnit. Například při zvýšených požadavcích na výkon nebo kompatibilitu se starými protokoly. Ale minimálně 70 % dat, která operátor zpracovává, lze určitě umístit do distribuovaného poolu.
Bankovní sféra
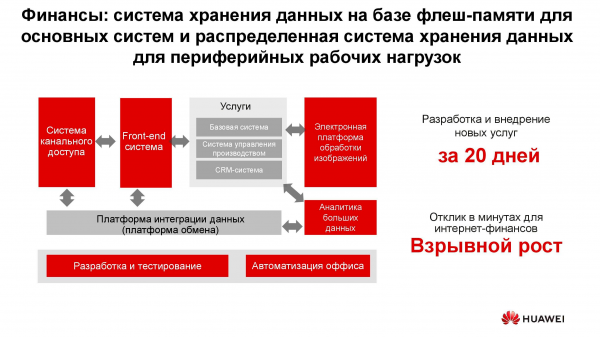
V každé bance koexistuje řada různorodých IT systémů, počínaje procesingem a konče automatizovaným bankovním systémem. Tato infrastruktura také pracuje s obrovským objemem informací, přičemž většina úkolů nevyžaduje zvýšenou výkonnost a spolehlivost ukládání dat, jako je například vývoj, testování, automatizace kancelářských procesů atd. Použití klasických SDD je zde možné, ale s každým rokem je to stále méně výhodné. Navíc v tomto případě chybí flexibilita při využívání prostředků SDD, jejichž výkonnost je vypočítávána z maximální zátěže.
Při použití distribuovaných systémů ukládání mohou být jejich uzly, které jsou ve skutečnosti běžnými servery, kdykoli převedeny na serverovou farmu a použity jako výpočetní platforma.
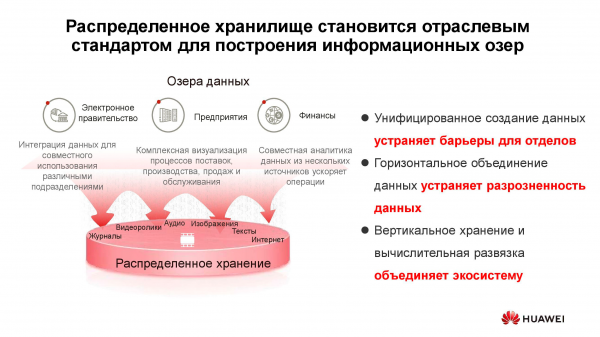
Datová jezera
Na výše uvedeném schematu je uveden seznam typických spotřebitelů služeb . Mohou to být služby elektronického vládnutí (například „Státní služby“), které prošly digitalizací podniku, finanční struktury a další. Všem jim je třeba pracovat s velkými objemy různorodých informací.
Provoz klasických SDD pro řešení těchto úkolů není efektivní, protože je zapotřebí jak vysoce výkonný přístup k blokovým databázím, tak běžný přístup k knihovnám skenovaných dokumentů uložených jako objekty. Sem může být také přidružena například objednávková systém přes webový portál. Aby bylo možné vše toto realizovat na platformě klasických SDD, bude zapotřebí velká skupina zařízení pro různé úkoly. Jedna horizontální univerzální úložiště může plně pokrýt všechny předtím uvedené úkoly: je třeba pouze vytvořit v ní několik poolů s různými charakteristikami ukládání.
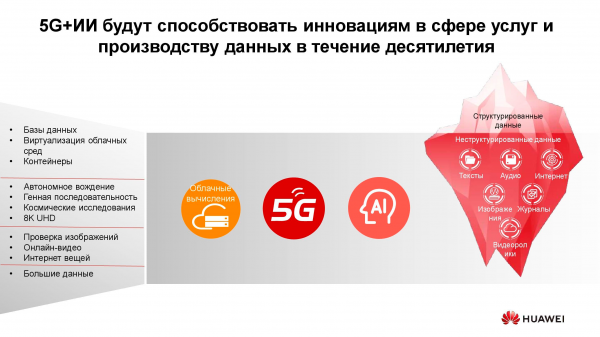
Generátory nové informace
Množství informací uložených ve světě roste přibližně o 30 % ročně. To jsou dobré zprávy pro poskytovatele systémů ukládání, ale co je a bude hlavním zdrojem těchto dat?
Před deseti lety se takovými generátory staly sociální sítě, což vyžadovalo vznik velkého množství nových algoritmů, hardwarových řešení atd. V současnosti jsou vyzdvihovány tři hlavní motor růstu objemu ukládání. Prvním je cloud computing. V současné době přibližně 70 % firem jakýmkoli způsobem využívá cloudové služby. Může to být elektronická pošta, zálohy a další virtualizované entity.
Druhým motorem se stávají sítě páté generace. To jsou nové rychlosti a nové objemy přenosu dat. Podle našich předpovědí široké rozšíření 5G povede k poklesu poptávky po paměťových kartách. Ať už je v telefonu jakákoliv paměť, stejně se zaplní, a při existenci 100megabitového kanálu není žádná potřeba uchovávat fotografie lokálně.
Mezi třetí skupiny důvodů, proč roste poptávka po úložištích, patří rychlý rozvoj umělé inteligence, přechod na analýzu velkých dat a trend k celkové automatizaci všeho, co je vůbec možné.
Předností "nového provozu" je jeho . Musíme tato data uchovávat, aniž bychom určovali jejich formát. Ten je potřebný pouze při následném čtení. Například bankovní scoring systém určuje dostupnou výši úvěru tím, že zkoumá fotografie, které jste zveřejnili na sociálních sítích, určuje, jak často navštěvujete moře a restaurace, a zároveň zkoumá dostupné bankovní výpisy vašich lékařských dokumentů. Tato data jsou na jedné straně vševypovídající, a na druhé straně zbavená homogenity.
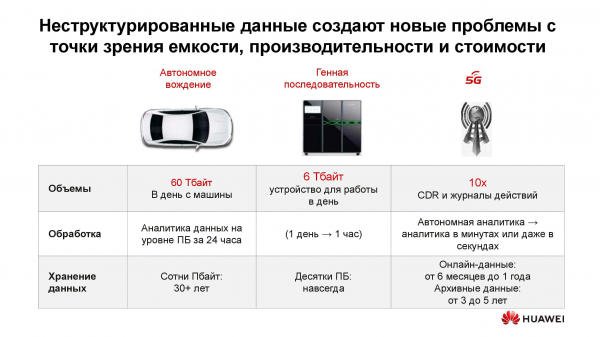
Oceán nestrukturovaných dat
Jaké problémy přináší vznik "nových dat"? Nejdůležitější mezi nimi je samozřejmě objem informací a výpočtové doby jejich uchovávání. Moderní autonomní auto bez řidiče generuje každý den až 60 TB dat z všech svých senzorů a mechanismů. Pro vývoj nových algoritmů jízdy je třeba tuto informaci zpracovat ve stejný den, jinak se začne hromadit. Musí být přitom uchovávána velmi dlouho — desítky let. Pouze potom můžeme v budoucnosti vyvodit závěry na základě velkých analytických vzorků.
Jedno zařízení pro dešifrování genetických sekvencí produkuje přibližně 6 TB denně. A data získaná tímto způsobem vůbec neimplikují odstranění, tedy hypoteticky by měla být uchovávána navždy.
Nakonec, stále stejné sítě páté generace. Kromě údajů, které jsou předávány, taková síť sama o sobě generuje obrovské množství dat: protokoly činností, záznamy hovorů, mezivýsledky mezi strojovými interakcemi atd.
To vše vyžaduje vývoj nových přístupů a algoritmů pro uchovávání a zpracování informací. A takové přístupy se objevují.
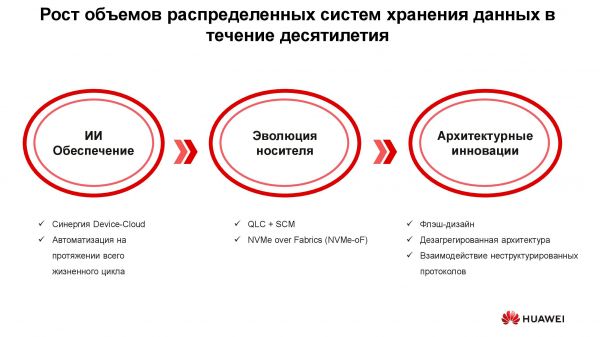
Technologie nové éry
Lze vyčlenit tři skupiny řešení, která mají čelit novým požadavkům na informační úložiště: implementace umělé inteligence, technická evoluce nosičů dat a inovace v oblasti systémové architektury. Začněme s AI.
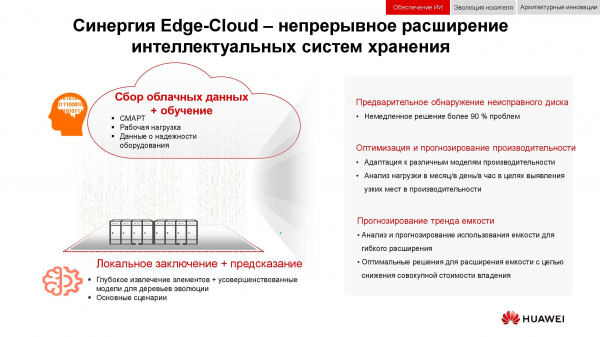
V nových řešeních Huawei se umělá inteligence už používá na úrovni samotného úložiště, které je vybaveno procesorem AI, umožňujícím systému analyzovat svůj stav a předpovědět selhání. Pokud je úložiště připojeno ke službě cloudového úložiště, která má značné výpočetní schopnosti, umělá inteligence může zpracovávat více informací a zvýšit přesnost svých hypotéz.
Kromě selhání umí tato AI také předpovídat budoucí špičkovou zátěž a čas zbývající do vyčerpání kapacity. To umožňuje optimalizovat výkon a škálovat systém ještě předtím, než dojde k jakýmkoli nežádoucím událostem.
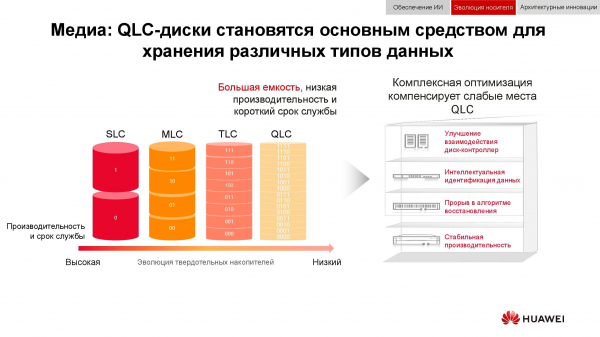
Nyní k evoluci datových nosičů. První flash disky byly vyrobeny na technologii SLC (Single-Level Cell). Zařízení na této bázi byla rychlá, spolehlivá, stabilní, ale měla malou kapacitu a byla velmi drahá. Zvýšení objemu a snížení ceny se podařilo dosáhnout díky určitým technickým ústupkům, což vedlo ke snížení rychlosti, spolehlivosti a životnosti nosičů. Nicméně trend neměl vliv na samotná úložiště, která díky různým architektonickým úpravám v zásadě zlepšila výkon a spolehlivost.
Ale proč byly potřeba úložiště třídy All-Flash? Nebylo by dostatek prostě vyměnit staré HDD za nové SSD stejného formátu v již provozovaném systému? Bylo to potřeba pro efektivní využití všech zdrojů nových pevných disků, což ve starých systémech nebylo jednoduše možné.
Společnost Huawei například pro vyřešení tohoto úkolu vyvinula řadu technologií, z nichž jedna je , která umožnila maximálně optimalizovat interakci "disk - řadič".
Inteligentní identifikace umožnila rozdělit data na několik toků a vyrovnat se s řadou nežádoucích jevů, jako je (write amplification). Spolu s tím nové algoritmy obnovy, zejména , zvýšily rychlost rebuildingu a zkrátily jeho čas na zcela zanedbatelné hodnoty.
Selhání, přeplnění, "shromažďování odpadu" — tyto faktory již také nemají vliv na výkon úložiště díky speciálnímu vylepšení řadičů.
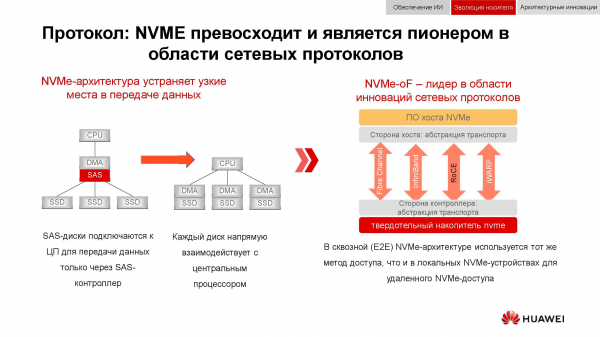
A také bloková úložiště dat se chystají na přijetí . Připomeňme, že klasická schéma organizace přístupu k datům fungovala takto: procesor se obracel na RAID kontroler přes sběrnici PCI Express. Ten zase interagoval s mechanickými disky přes SCSI nebo SAS. Použití NVMe v backendu výrazně zrychlilo celý proces, avšak neslo v sobě jednu nevýhodu: úložiště musela mít přímé připojení k procesoru, aby mu zajistila přímý přístup do paměti.
Další fází vývoje technologie, kterou nyní sledujeme, je aplikace NVMe-oF (NVMe over Fabrics). Co se týče blokových technologií Huawei, ty již nyní podporují FC-NVMe (NVMe over Fibre Channel) a chystá se NVMe over RoCE (RDMA over Converged Ethernet). Testovací modely jsou plně funkční, do jejich oficiální prezentace zbývá několik měsíců. Upozorňujeme, že to vše se objeví i v distribuovaných systémech, kde bude "Ethernet bez ztrát" velmi žádaný.
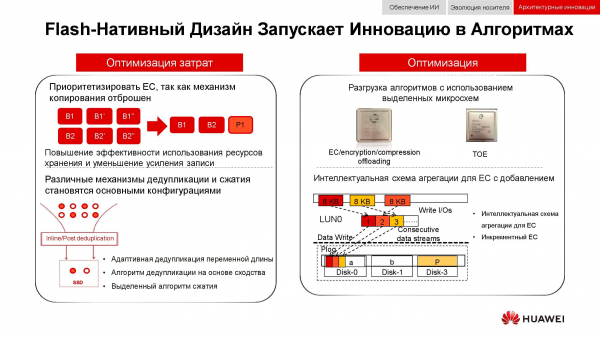
Dalším způsobem optimalizace práce právě distribuovaných úložišť je úplný odstup od zrcadlení dat. Řešení Huawei již více nepoužívají n kopií, jak je obvyklé v RAID 1, a plně přecházejí na mechanismus (Erasure coding). Specializovaný matematický balík s určitou periodicitou vypočítává kontrolní bloky, které umožňují obnovit mezilehlá data v případě jejich ztráty.
Mechanismy deduplikace a komprese se stávají povinnými. Pokud jsme v klasických SANS omezeni počtem procesorů nainstalovaných v kontrolerech, pak v distribuovaných horizontálně škálovatelných úložištích každý uzel obsahuje vše potřebné: disky, paměť, procesory a interkonnect. Těchto zdrojů je dostatek, aby deduplikace a komprese měly na výkon minimální vliv.
A také o hardwarových metodách optimalizace. Zde se podařilo snížit zátěž na centrální procesory pomocí dalších specializovaných čipů (nebo specializovaných bloků v samotném procesoru), které hrají roli (TCP/IP Offload Engine) nebo přebírají matematické úkoly EC, deduplikace a komprese.
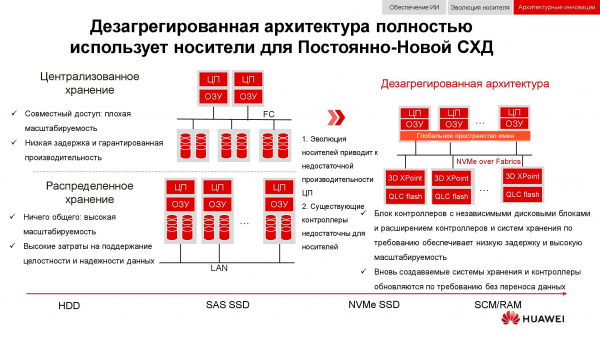
Nové přístupy k ukládání dat se projevují v dekomponované (distribuované) architektuře. V systémech centralizovaného ukládání je k dispozici továrna na servery, která je připojena přes Fibre Channel k s velkým množstvím polí. Mezi nevýhody tohoto přístupu patří obtíže s škálováním a zajištěním garantované úrovně služeb (ohledně výkonu nebo latence). Hyperkonvergované systémy využívají stejné hostitele — jak pro ukládání, tak pro zpracování informací. To dává prakticky neomezené možnosti škálování, ale s sebou nese vysoké náklady na udržení integrity dat.
Na rozdíl od obou výše uvedených, dekomponovaná architektura předpokládá rozdělení systému na výpočetní továrnu a horizontální úložný systém.To zajišťuje výhody obou architektur a umožňuje prakticky neomezeně škálovat pouze tu komponentu, jejíž výkon je nedostatečný.
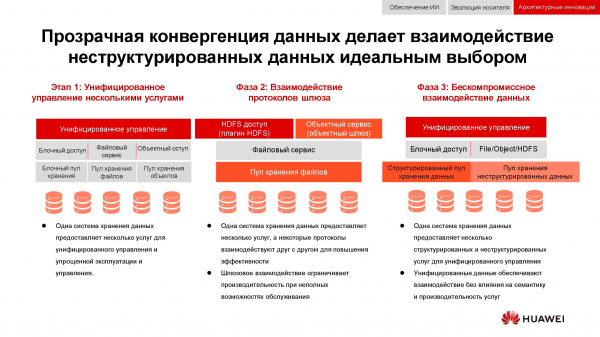
Od integrace k konvergenci
Klasickým úkolem, jehož význam v posledních 15 letech pouze rostl, je potřeba zároveň zajistit blokové úložiště, přístup k souborům, přístup k objektům, provoz farmy pro velká data atd. Třešničkou na dortu může být například ještě systém zálohování na magnetickou pásku.
V prvním kroku se podařilo unifikovat pouze správu těchto služeb. Různé systémy ukládání dat byly uzavřeny do jakéhokoli specializovaného softwaru, pomocí něhož administrátor rozděloval zdroje z dostupných poolů. Avšak vzhledem k tomu, že hardware těchto poolů byl odlišný, migrace zátěže mezi nimi byla nemožná. Na vyšší úrovni integrace se sjednocení provádělo na úrovni brány. Při existenci společného přístupu k souborům bylo možné je poskytovat prostřednictvím různých protokolů.
Nejsofistikovanější z dostupných metod konvergence, kterou nyní máme, předpokládá vytvoření univerzální hybridní systém. Přesně takový, jakým by se měla stát naše . Univerzální přístup využívá stejné hardwarové zdroje, které jsou logicky rozděleny do různých skupin, avšak umožňují migraci zátěže. To vše lze provádět prostřednictvím jediné řídicí konzole. Tímto způsobem se nám podařilo realizovat koncept „jedno datové centrum — jedno úložiště“.
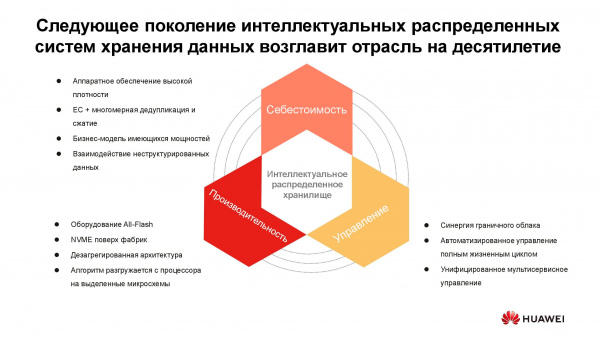
Náklady na ukládání informací dnes určují mnoho architektonických řešení. A i když je lze bez obav postavit do centra, dnes diskutujeme o „živém“ ukládání s aktivním přístupem, takže je třeba také zohlednit výkonnost. Dalším důležitým atributem distribuovaných systémů nové generace je unifikace. Vždyť nikdo nechce mít několik oddělených systémů řízených z různých konzolí. Všechny tyto vlastnosti našly své uplatnění v nové řadě produktů Huawei. .
Nová generace masového úložiště
OceanStor Pacific vyhovuje požadavkům na spolehlivost na úrovni „šesti devítek“ (99,9999 %) a může být používán pro vytváření datových center třídy HyperMetro. Při vzdálenosti mezi dvěma datovými centry do 100 km systémy vykazují přídavnou latenci na úrovni 2 ms, což umožňuje vytváření jakýchkoli katastroficky odolných řešení, včetně těch s quorum servery.
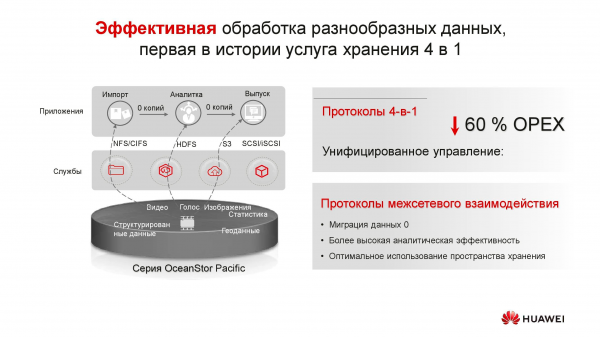
Produkty nové řady vykazují univerzálnost podle protokolů. Již nyní OceanStor 100D podporuje blokový přístup, objektový přístup a přístup Hadoop. V blízké budoucnosti bude zaveden také souborový přístup. Není třeba uchovávat několik kopií dat, pokud je lze dodávat prostřednictvím různých protokolů.
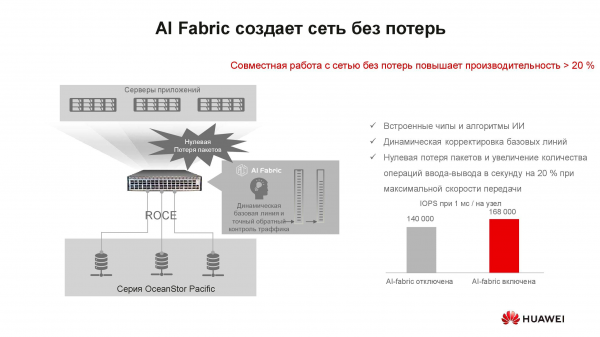
Mohlo by se zdát, jaký vztah má koncept „síť bez ztrát“ k úložišti? Skutečnost je taková, že distribuované systémy ukládání dat jsou postaveny na základě rychlé sítě, která podporuje odpovídající algoritmy a mechanismus RoCE. Další zvýšení rychlosti sítě a snížení latencí podporuje systém umělé inteligence, který naše switche podporují. . Zisk výkonnosti úložiště při aktivaci AI Fabric může dosahovat až 20 %.
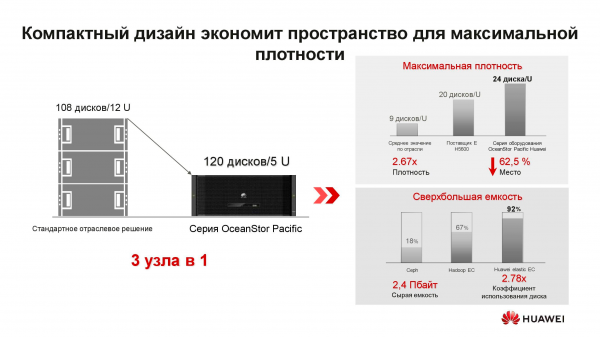
Co tedy představuje nový uzel distribuovaného úložiště OceanStor Pacific? Řešení formátu 5U zahrnuje 120 disků a může nahradit tři klasické uzly, což přináší více než dvojnásobnou úsporu místa v racku. Díky zrušení uchovávání kopií se účinnost disku znatelně zvyšuje (až o +92 %).
Jsme zvyklí si myslet, že softwarově definovaná úložiště - to je speciální software, který je nainstalován na klasickém serveru. Nyní však pro optimální parametry toto architektonické řešení vyžaduje také speciální uzly. Součástí jsou dva servery založené na procesorech ARM, které řídí pole třípalcových disků.
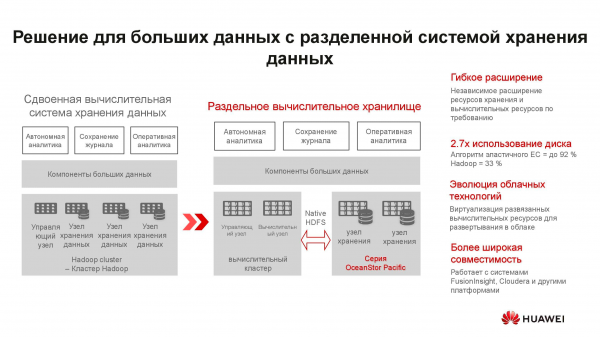
Tyto servery jsou málo vhodné pro hyperkonvergovaná řešení. Zaprvé, aplikací pro ARM je dosti málo, a zadruhé, je těžké zachovat vyvážení zátěže. Navrhujeme přejít k oddělenému ukládání: výpočetní klastr, reprezentovaný klasickými nebo rackovými servery, funguje samostatně, ale je připojen k úložištím OceanStor Pacific, která také plní své přímé úkoly. A to se osvědčuje.
Pro příklad vezměme klasické řešení pro ukládání velkých dat s hyperkonvergovaným systémem, který zabírá 15 serverových stojanů. Pokud rozdělíme zátěž mezi jednotlivé výpočetní servery a úložiště OceanStor Pacific, oddělíme je od sebe, množství potřebných stojanů se sníží na polovinu! To snižuje náklady na provoz datového centra a zmenšuje celkové náklady na vlastnictví. Ve světě, kde objem ukládaných informací roste o 30 % ročně, se podobnými výhodami neplýtvá.
***
Více informací o řešeních Huawei a scénářích jejich využití získáte na našem nebo kontaktováním přímo zástupců společnosti.
Zdroj: habr.com
