

Doporučuji se seznámit s rozborem zprávy Nikolaje Samochvalova "Průmyslový přístup k ladění PostgreSQL: experimenty s databázemi"
Shared_buffers = 25% – je to hodně nebo málo? Nebo akorát správně? Jak pochopit, zda je tato – dost zastaralá – doporučení vhodná pro váš konkrétní případ?
Přišel čas přistoupit k otázce výběru parametrů postgresql.conf "dospělým" způsobem. Ne přílišným způsobem slepých "autoladících" nástrojů nebo zastaralých rad z článků a blogů, ale na základě:
- přísně vybalancovaných experimentů na databázích prováděných automatizovaně, v hojném množství a za podmínek co nejblíže "bojovým",
- hlubokého porozumění specifikům fungování DBMS a OS.
Použitím Nancy CLI (), se podíváme na konkrétní příklad – notoricky známé shared_buffers – v různých situacích, v různých projektech a pokusíme se přijít na to, jak optimálně nastavit naši infrastrukturu, databázi a zátěž.
Bude řeč o experimentech s databázemi. Toto je příběh, který trvá něco málo přes půl roku.
Trochu o mě. Zkušenosti s Postgres mám už více než 14 let. Založil jsem několik společností v oblasti sociálních sítí. Všude byl Postgres používán a je používán.
Také skupina RuPostgres na Meetupu, 2. místo na světě. Pomalu se blížíme k 2 000 lidem. RuPostgres.org.
A na různých konferencích, včetně Highload, odpovídám za databáze, zejména Postgres od jeho založení.
A v posledních několika letech jsem restartoval svou praxi v oblasti poradenství k Postgres v 11 časových pásmech odtud.
A když jsem to udělal před několika lety, měl jsem určitý přestávku od aktivní manuální práce s Postgres, pravděpodobně od roku 2010. Byl jsem překvapen, jak málo se změnily pracovní dny DBA, jak moc je stále potřeba používat manuální práci. A hned mě napadlo, že tu něco není v pořádku, je třeba více automatizovat.
A protože to všechno bylo v cloudu, většina klientů byla v oblacích. A už bylo mnoho věcí automatizováno, to je očividné. O tom více později. Tedy z toho všeho vzešla myšlenka, že by měl být soubor nástrojů, t.j. jakási platforma, která by automatizovala prakticky všechny úkony DBA, abychom mohli spravovat velké množství databází.
V této zprávě nebudou:
- "Stříbrné kulky" a tvrzení typu – dejte 8 GB nebo 25 % shared_buffers a budete spokojeni. O shared_buffers nebude tolik.
- Hardwarové "vnitřnosti".
Co se stane?
- Budou zde principy optimalizace, které používáme a rozvíjíme. Budou různé nápady, které nám přicházejí na mysl a různá nástroje, které vytváříme většinou v Open Source, tj. základy děláme v Open Source. Navíc máme tikety, veškerá komunikace probíhá prakticky v Open Source. Můžete sledovat, co právě děláme, co bude v následující verzi atd.
- A také nějaké zkušenosti s používáním těchto principů a nástrojů v řadě firem: od malých startupů po velké společnosti.
Jak se to všechno vyvíjí?
Za prvé, hlavním úkolem DBA kromě zajištění vytváření instances, nasazování záloh atd. je hledání úzkých míst a optimalizace výkonu.
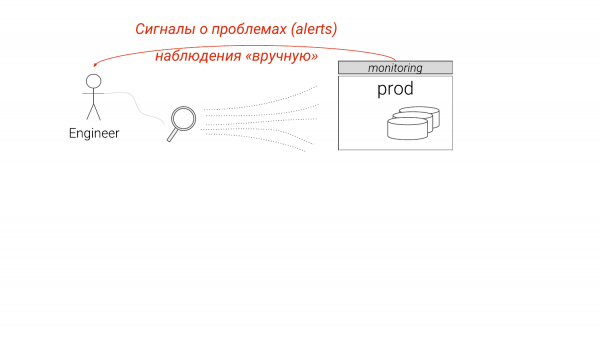
Nyní je to uspořádáno tímto způsobem. Sledujeme monitoring, něco vidíme, chybí nám nějaké podrobnosti. Začínáme se podrobněji prohrabovat, obvykle ručně, a chápeme, co s tím dělat tak či onak.
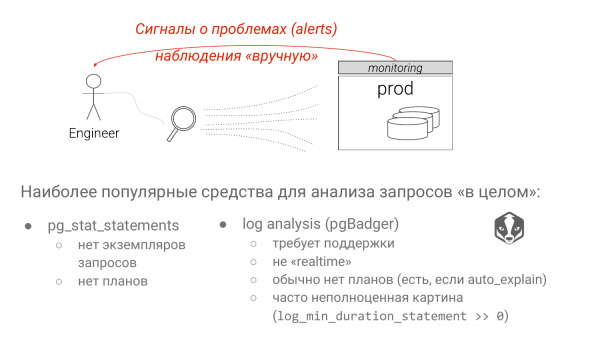
Existují dva přístupy. Pg_stat_statements – standardní výchozí řešení pro identifikaci pomalých dotazů. A analýza logů Postgres pomocí pgBadger.
Každý z přístupů má vážné nedostatky. U prvního přístupu máme vyhozeny všechny parametry. A pokud vidíme skupiny SELECT * FROM table where sloupec odpovídá znaku „?“ nebo „$“ od verze Postgres 10. Nevíme, zda jde o index scan nebo seq scan. Velmi silně to závisí na parametru. Pokud tam dosadíte hodnotu, která se vyskytuje zřídka, bude to index scan. Pokud tam dosadíte hodnotu, která tvoří 90 % tabulky, bude to očividně seq scan, protože Postgres zná statistiku. A to je velký nedostatek pg_stat_statements, i když se nějaké práce provádějí.
U analýz logů je největší nedostatek v tom, že si většinou nemůžete dovolit „log_min_duration_statement = 0“. O tom také budeme mluvit. Podle toho nevidíte celý obraz. A nějaký dotaz, který je velmi rychlý, může spotřebovávat obrovské množství zdrojů, ale neuvidíte ho, protože je pod vaším prahem.
Jak DBA řeší nalezené problémy?
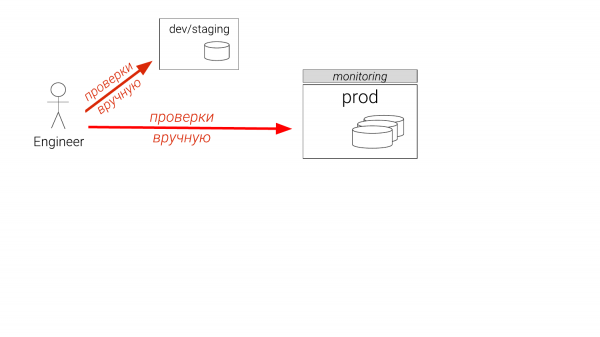
Například jsme objevili nějaký problém. Co se obvykle dělá? Pokud jste vývojář, budete něco dělat na nějakém instance, který není tak velký. Pokud jste DBA, máte staging. A ten může být jen jeden. A je pozadu o půl roku. A přemýšlíte, že půjdete na produkci. A dokonce i zkušení DBA to kontrolují na produkci, na replikaci. A někdy vytvoří dočasný index, ujistí se, že to pomáhá, zlikvidují ho a vrátí vývojářům, aby ho zařadili do migračních souborů. Takové nesmysly se teď dějí. A to je tragédie.
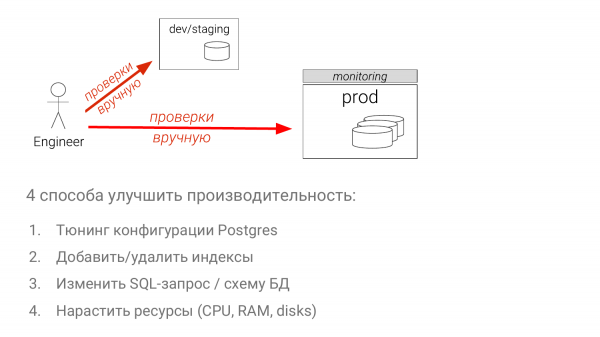
- Ladit konfigurace.
- Optimalizovat sadu indexů.
- Měnit samotný SQL dotaz (to je nejkomplexnější způsob).
- Přidávat výkon (to je většinou nejjednodušší způsob).
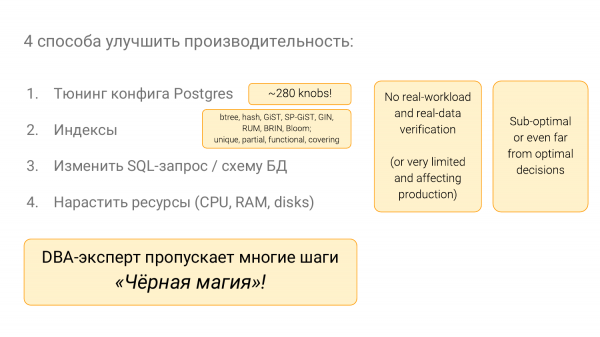
S těmito věcmi je toho hodně. V Postgresu je spousta možností. Je potřeba hodně vědět. V Postgresu je mnoho indexů, také díky organizátorům této konference. A to všechno je potřeba znát, a právě to u ne-DBA vyvolává pocit, že se DBA zabývají černou magií. Tedy je potřeba se věnovat tomu 10 let, abyste tomu začali normálně rozumět.
A já jsem bojovník proti této černé magii. Chci všechno dělat tak, aby technologie převládala a ne intuice.
Příklady z praxe
To jsem pozoroval minimálně ve dvou projektech, včetně svého. Další příspěvek na blogu nám říká, že hodnota 1 000 pro default_statistict_target je dobrá. Dobře, zkusme to na produkci.
A teď, s pomocí našeho nástroje po dvou letech experimentování s databázemi, o kterých dnes mluvíme, můžeme porovnat, co bylo a co je nyní.
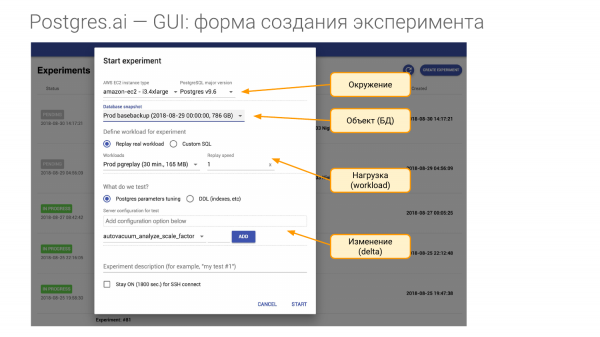
A k tomu potřebujeme vytvořit experiment. Ten se skládá ze čtyř částí.
- První část – to je prostředí. Potřebujeme hardware. A když přicházím do nějaké firmy a uzavírám smlouvu, říkám, aby mi dali stejný hardware jako na produkci. Pro každého z vašich Majstrů potřebuji alespoň jeden stejný hardware. Buď je to virtuální stroj instance na Amazonu nebo Google, nebo potřebuji přesně takový hardware. Tedy chci reprodukovat prostředí. A do pojmu prostředí zahrnujeme hlavní verzi Postgres.
- Druhá část – to je objekt našich výzkumů. To je databáze. Může být vytvořena několika způsoby. Ukážu jak.
- Třetí část – to je zátěž. To je nejkomplexnější moment.
- A čtvrtá část je to, co kontrolujeme, t.j. co s čím porovnáme. Předpokládejme, že můžeme v konfiguraci změnit jeden nebo více parametrů, nebo můžeme vytvořit index atd.
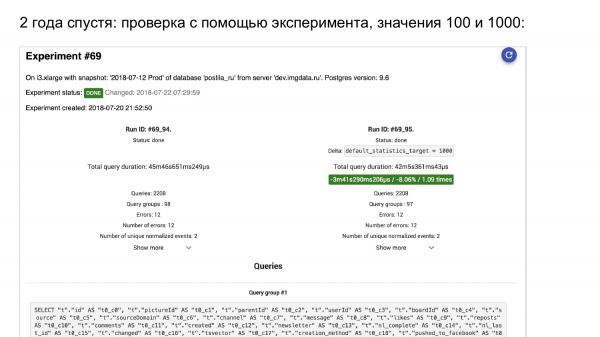
Zahajujeme experiment. Tady je pg_stat_statements. Vlevo – co bylo. Vpravo – co se stalo.
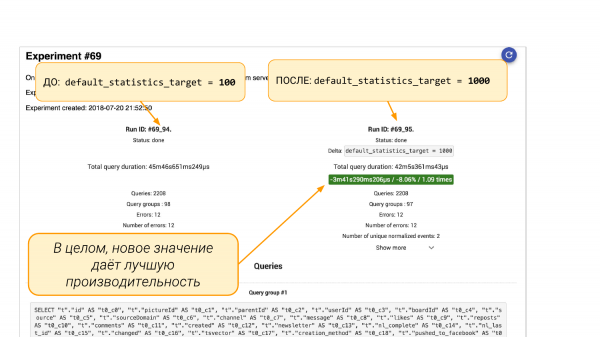
Vlevo default_statistics_target = 100, vpravo = 1 000. Vidíme, že nám to pomohlo. Celkově se to zlepšilo o 8 %.
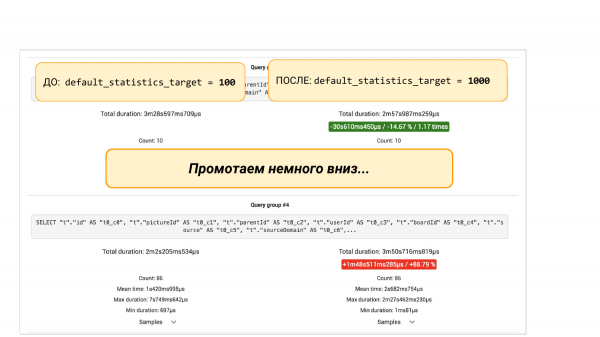
Ale pokud se posuneme dolů, uvidíme skupiny dotazů z pgBadger nebo z pg_stat_statements. Jsou zde dvě možnosti. Uvidíme, že nějaký dotaz klesl o 88 %. A zde už je inženýrský přístup. Můžeme kopat hlouběji, protože je zajímavé, proč klesl. Je třeba pochopit, co se dělo se statistikou. Proč větší počet bucketů ve statistice vede k horšímu výsledku.
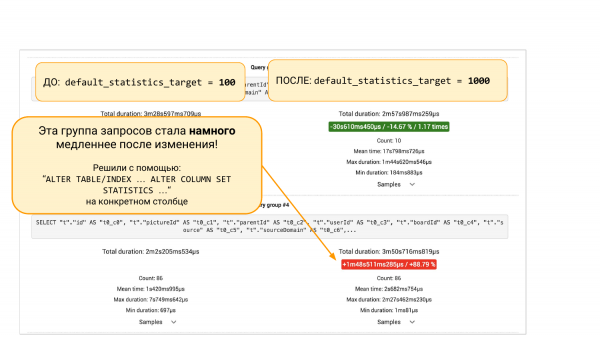
Můžeme ale také nekopat a provést „ALTER TABLE … ALTER COLUMN“ a vrátíme mu zpět 100 bucketů ve statistice tohoto sloupce. A dále můžeme experimentálně ověřit, že tato oprava pomohla. To je inženýrský přístup, který nám pomáhá vidět celkový obraz a rozhodovat se na základě dat, nikoli na základě intuice.
Pár příkladů z jiných oblastí. V testech jsou CI testy už mnoho let. A žádný rozumný projekt už nebude žít bez automatických testů.
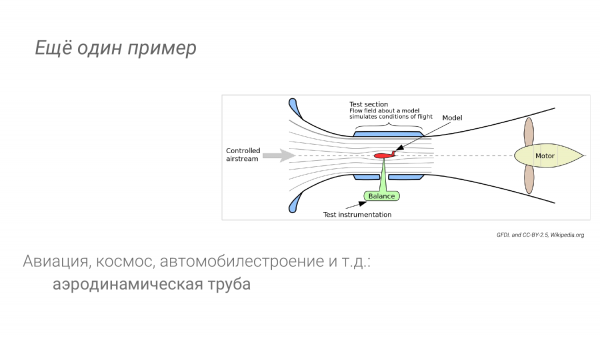
V jiných oborech: v letectví, automobilovém průmyslu, když testujeme aerodynamiku, máme také možnost provádět experimenty. Nezahájíme něco rovnou z výkresu do vesmíru, ani nevyjedeme žádné auto rovnou na silnici. Například existuje aerodynamický tunel.
Z pozorování v jiných oblastech můžeme vyvodit závěry.
Za prvé, máme speciální prostředí. To je blízko produkce, ale není blízko. Jeho hlavním rysem je, že by mělo být levné, opakovatelné a maximálně automatizované. A také by měly být speciální nástroje pro provádění podrobné analýzy.
Pravděpodobně, když jsme spustili letadlo a letíme, nemáme tolik příležitostí prozkoumat každý milimetr povrchu křídla jako v aerodynamickém tunelu. Máme více prostředků pro diagnostiku. Můžeme si dovolit přívěsit více těžkých věcí, než si můžeme dovolit mít na letadle ve vzduchu. Stejně je to s Postgres. V některých případech můžeme při experimentech zapnout úplné logování dotazů. A na produkci to dělat nechceme. Možná to dokonce zapneme pomocí auto_explain.
A jak jsem již řekl, vysoká úroveň automatizace znamená, že jsme stiskli tlačítko a zopakovali to. Tak by to mělo být, aby bylo hodně experimentů, aby to bylo v procesu.
Nancy CLI – základ "laboratoře DB"
A tak jsme vytvořili tuto věc. Tedy, o těchto nápadech jsem mluvil v červnu, téměř před rokem. A už máme v Open Source takzvanou Nancy CLI. To je základ pro vybudování laboratoře databáze.
— Je to v Open Source, na Gitlab. Můžete říct, můžete zkusit. Dal jsem odkaz na slajdech. Můžete kliknout a tam bude ve všech parametrech.
Samozřejmě, že tam je ještě mnoho ve vývoji. Je tam spousta nápadů. Ale to už je něco, co prakticky používáme každý den. A když máme nápad – co se stane, když při mazání 40 000 000 řádků se vše zasekne v IO, pak můžeme provést experiment a podívat se podrobněji, abychom pochopili, co se děje a pokusili se to opravit za běhu. Tedy provádíme experiment. Například něco upravíme a podíváme se, co z toho nakonec dostaneme. A děláme to ne na produkci. To je podstata myšlenky.
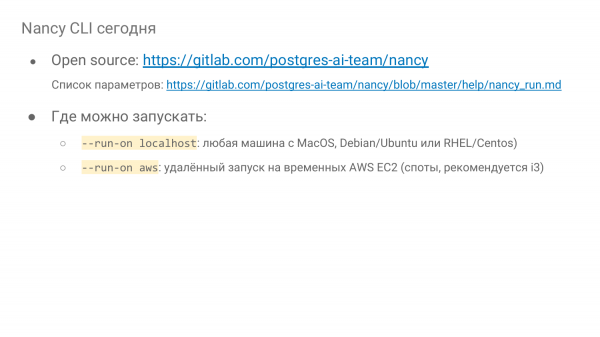
Kde to může fungovat? Může to fungovat lokálně, tedy to můžete dělat kdekoliv, dokonce i na MacBooku. Potřebujete Docker, jedeme. A je to. Můžete to spustit na nějakém instance na železe, nebo ve virtuálce, kdekoliv.
A je zde také možnost spuštění vzdáleně v Amazonu na EC2 Instance, ve spotech. A to je skutečně skvělá možnost. Například včera jsme provedli více než 500 experimentů na i3 instance, začínaje tím nejmenším a konče i3-16-xlarge. A těch 500 experimentů nás stálo 64 dolarů. Každý trval 15 minut. To znamená, že díky používání spotů je to velmi levné – sleva 70 %, cenová nabídka Amazonu se účtuje po vteřinách. Můžete dělat velmi mnoho. Můžete provádět skutečný výzkum.
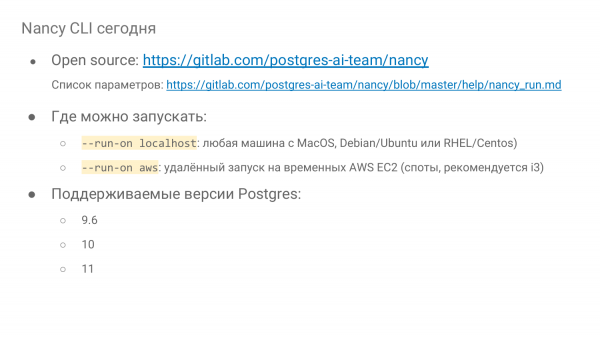
A podporovány jsou tři major verze Postgres. Není tak složité doladit nějaké staré a také novou 12. verzi.
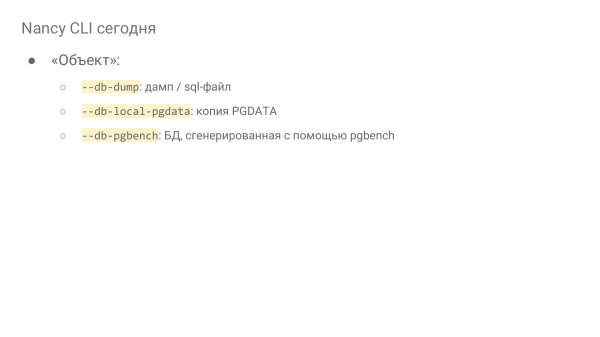
Objekt můžeme zadávat třemi způsoby. To je:
- Dump/sql soubor.
- Hlavní způsob je klon PGDATA adresáře. Obvykle se bere z backup serveru. Pokud máte normální binární zálohy, odtud můžete dělat klony. Pokud máte cloud, tak za vás to udělá cloudová firma jako Amazon nebo Google. To je hlavní způsob klonů skutečného produkčního prostředí. Takhle to rozvíjíme.
- A poslední způsob je vhodný pro výzkum, když je touha pochopit, jak v Postgres funguje nějaká věc. To je pgbench. Můžete to vygenerovat pomocí pgbench. To je jednoduše jedna volba „db-pgbench“. Řeknete mu, jaký scale. A všechno bude v cloudu vygenerováno, jak je řečeno.
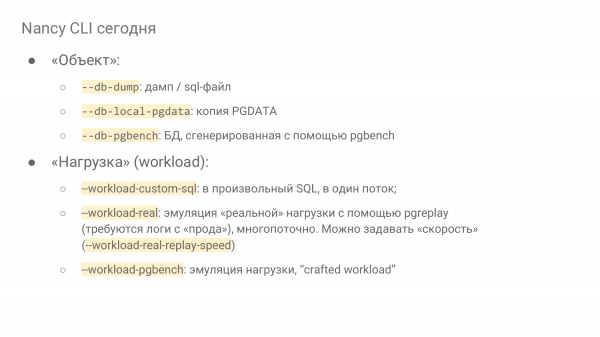
A zátěž:
- Zátěž můžeme vykonávat v jednom vláknu SQL. To je nejsaPikodnější způsob.
- Nebo můžeme emulovat zátěž. A emulovat ji můžeme především následujícím způsobem. Musíme sbírat všechny logy. A to je bolestivé. Ukážu, proč. A pomocí pgreplay přehráváme, který je vestavěn v Nancy.
- Nebo jiná varianta. Takzvaná řemeslná zátěž, kterou děláme s určitým množstvím úsilí. Analyzováním naší aktuální zátěže na bojovém systému vybereme nejlepší skupiny dotazů. A pomocí pgbench můžeme emulovat tuto zátěž v laboratoři.
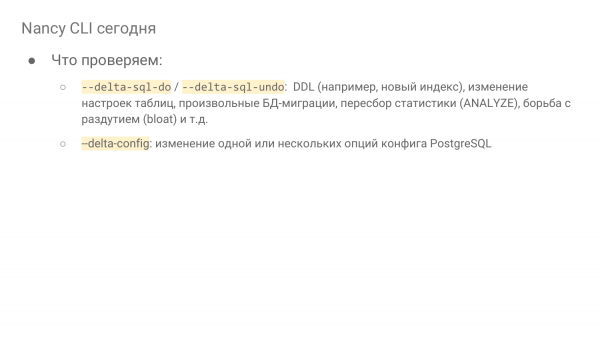
- Nebo musíme vykonat nějaký SQL, to znamená, kontrolujeme nějakou migraci, vytváříme index, provádíme ANALYZE. A sledujeme, co bylo před vakuem a po vaku. Obecně jakýkoli SQL.
- Buď změníme jeden nebo více parametrů v konfiguraci. Můžeme říct, aby nám zkontrolovali například 100 hodnot na Amazonu pro naši terabajtovou databázi. A během několika hodin budete mít výsledek. Obvykle se terabajtová databáze nasazuje několik hodin. Ale ve vývoji máme patch, což znamená, že můžete postupně na jednom a tom samém serveru použít stejnou pgdata a kontrolovat. Postgres se restartuje, cache se vyprázdní. A můžete spouštět zátěž.
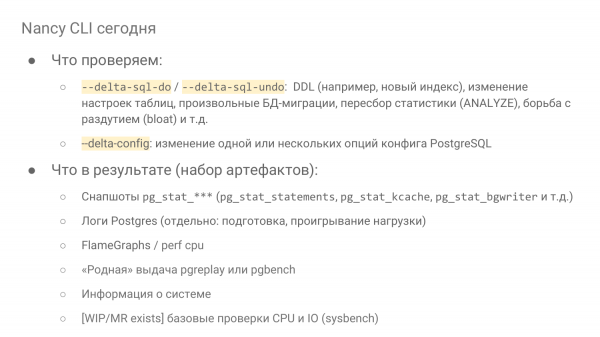
- Přijde adresář, ve kterém je spousta různých souborů, počínaje snapshoty pgstat***. A tam je to nejzajímavější – pg_stat_statements, pg_stat_kcache. To jsou dvě rozšíření, která analyzují dotazy. A pg_stat_bgwriter obsahuje nejen statistiku pgwriter, ale také informace o checkpointu a o tom, jak se backendy zbavují špinavých bufferů. A to je všechno zajímavé si prohlédnout. Například když nastavujeme shared_buffers, je velmi zajímavé podívat se, kolik kdo vyřadil.
- Také přicházejí logy Postgres. Dva logy – log přípravy a log přehrávání zátěže.
- Relativně nová funkce – FlameGraphs.
- Také, pokud jste používali pgreplay nebo pgbench varianty přehrávání zátěže, tak bude i jejich výstup. A uvidíte latency a TPS. Můžete pochopit, jak to viděli.
- Informace o systému.
- Základní kontroly CPU a IO. To je více pro EC2 instance na Amazonu, když chcete spustit 100 stejných instancí v proudu a provést 100 různých běhů, dostanete 10 000 experimentů. A musíte se ujistit, že jste nenarazili na poškozenou instanci, kterou už někdo zatěžuje. Na tomto hardwaru aktivně pracují další a vám zůstává málo zdrojů. Takové výsledky je lepší vynechat. A právě díky sysbench od Alexeje Kopytova provádíme několik krátkých kontrol, které přijdou a budete moci je porovnat s ostatními, tj. pochopíte, jak se CPU chová a jak se IO chová.
Jaké jsou technické složitosti na příkladu různých společností?
Představme si, že chceme opakovat skutečnou zátěž pomocí logů. Skvělý nápad, pokud je to napsáno na Open Source pgreplay. Používáme ho. Ale aby dobře fungoval, musíte povolit úplné logování dotazů s parametry a časováním.
Existují určité problémy ohledně duration a timestamp. O tuto část se nebudeme starat. Hlavní otázka je, zda si to můžete dovolit nebo ne.
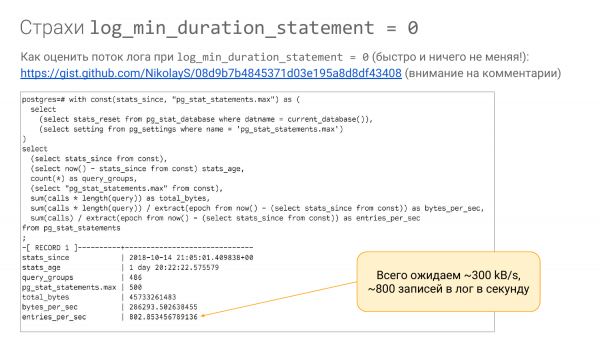
Problém je v tom, že to nemusí být dostupné. Nejprve musíte porozumět tomu, jaký tok se bude zapisovat do logu. Pokud máte pg_stat_statements, můžete tímto dotazem (odkaz bude dostupný na slidach) zjistit, kolik bajtů se přibližně zapisuje za sekundu.
Sledujeme délku dotazu. Ignorujeme fakt, že tam nejsou parametry, ale víme délku dotazu a víme, kolikrát za sekundu byl vykonán. Takto můžeme odhadnout, kolik přibližně bajtů za sekundu. Můžeme udělat chybu až dvakrát, ale pořadí přesně pochopíme tímto způsobem.
Můžeme vidět, že tento dotaz se vykonává 802krát za sekundu. A vidíme, že bytes_per sec – 300 kB/s se zapisuje plus mínus. A obvykle si takový tok můžeme dovolit.
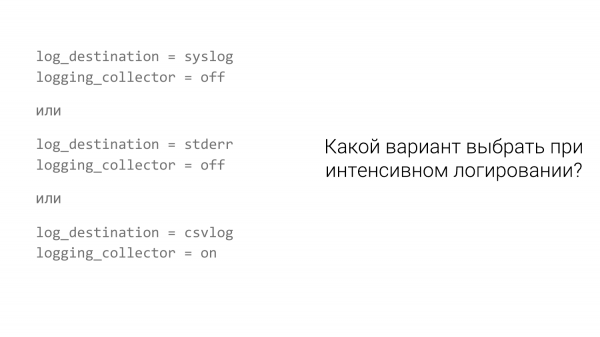
Ale! Faktem je, že existují různé systémy logování. A lidé obvykle používají defaultně „syslog“.
A pokud máte syslog, může to vypadat takto. Vezmeme pgbench, zapneme logování dotazů a podíváme se, co se stane.
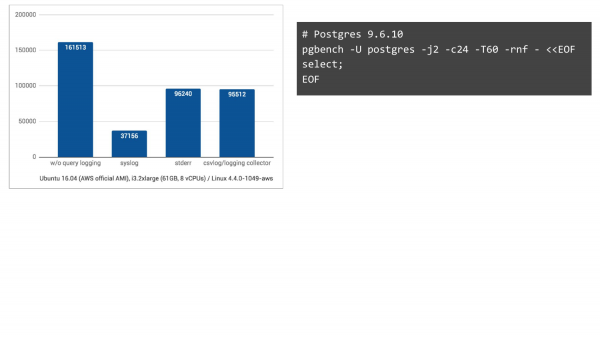
Bez logování – to je sloupec nalevo. Měli jsme 161 000 TPS. Se syslogem – na Ubuntu 16.04 v Amazonu máme 37 000 TPS. A pokud změníme na dva jiné způsoby logování, situace se výrazně zlepší. Tedy očekávali jsme pokles, ale ne takový.
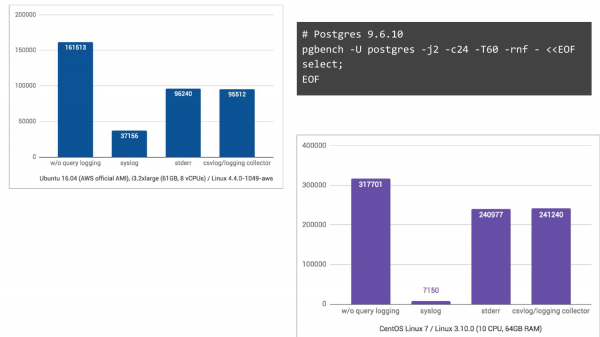
A na CentOS 7, kde se podílí také journald, který převádí logy do binárního formátu pro snadné vyhledávání atd., je to úplná katastrofa, pokles o 44krát ve TPS.
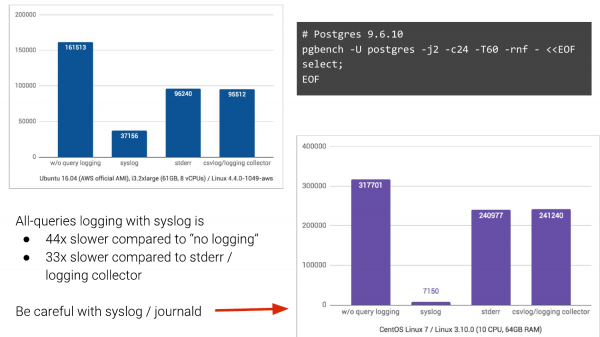
A s tímto lidé žijí. A často je to ve firmách, zvláště ve velkých, velmi obtížné změnit. Pokud se můžete vzdát syslogu, prosím, udělejte to.
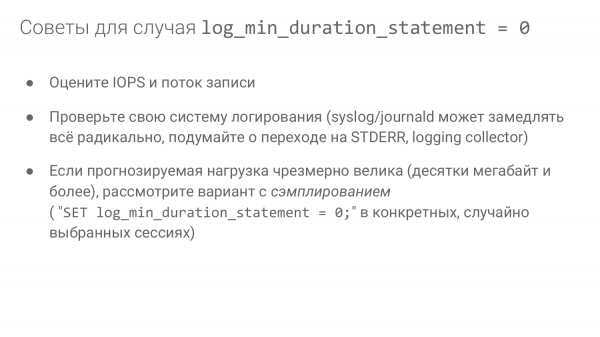
- Vyhodnoťte IOPS a tok zápisu.
- Ověřte svůj systém logování.
- Pokud je předpokládaná zátěž příliš vysoká, zvažte možnost vzorkování.
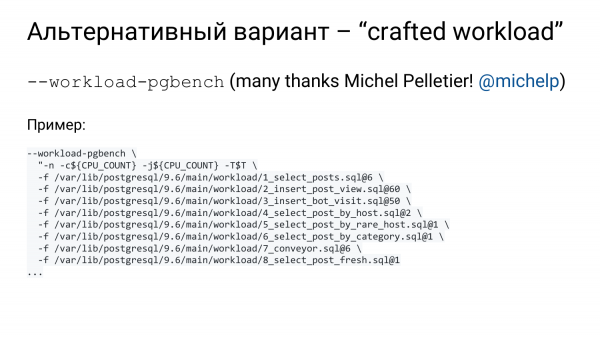
Máme pg_stat_statements. Jak jsem již řekl, ten musí být určitě aktivován. Můžeme vzít a každou skupinu dotazů speciálním způsobem popsat v souboru. A poté můžeme použít velmi užitečnou funkci v pgbench – možnost dodat několik souborů pomocí volby „-f“.
Chápe mnoho „-f“. A můžeme říct pomocí „@“ na konci, jaký podíl by měl mít každý soubor. T. j. můžeme říct, že toto by se mělo vykonávat ve 10 % případů a toto ve 20 %. A to nás přiblíží k tomu, co vidíme na produkci.
A jak pochopíme, co máme na produkci? Jaký podíl a čeho? Tady se trochu odbočuje. Máme ještě jeden produkt. . Také založený na Open Source. A nyní ho aktivně vyvíjíme.
Vznikl trochu z jiných důvodů. Z důvodů, že monitorování nestačilo. T. j. přicházíte, podíváte se na databázi, zkontrolujete problémy, které existují. A většinou děláte health_check. Pokud jste zkušený DBA, tak děláte health_check. Podívali jste se na využití indexů atd. Pokud máte OKmeter, pak je to skvělé. Je to skvělé monitorování pro Postgres. OKmeter.io – prosím, nainstalujte ho, je tam všechno skvěle udělané. Je to placené.
Pokud ho nemáte, pak obvykle máte málo věcí. V monitoringu obvykle jsou CPU, IO a to s výhradami, a všechno. A potřebujeme více. Musíme vidět, jak funguje autovakuum, jak funguje checkpoint, v IO je třeba oddělit checkpoint od bgwriter a backendů atd.
Problém je, že když pomáháte nějaké velké společnosti, nemohou rychle něco implementovat. Nemohou rychle zakoupit OKmeter. Možná ho koupí až za půl roku. Nemohou rychle nainstalovat nějaké balíčky.
A vznikla nám myšlenka, že potřebujeme takový speciální nástroj, který nevyžaduje žádnou instalaci, t. j. nemusíte na produkci instalovat vůbec nic. Nainstalujete si ho na svůj notebook nebo na server pro sledování, odkud ho budete spouštět. A ten bude analyzovat mnoho věcí: jak operační systém, tak souborový systém, a samotný Postgres, provádějící nějaké lehké dotazy, které můžete provozovat přímo na produkci a nic se nezhroutí.
Nazvali jsme ho Postgres-checkup. Pokud to vezmeme lékařsky, je to pravidelná kontrola zdraví. Pokud v automobilovém kontextu, tak – to je jako technická prohlídka. Provádíte technickou prohlídku u auta každých šest měsíců nebo rok, v závislosti na značce. A děláte technickou prohlídku pro svou databázi? T. j. děláte pravidelně hluboké vyšetření? Je to potřeba. Pokud děláte zálohy, dělejte i checkup, to je stejně důležité.
A máme takový nástroj. Začal se aktivně rozvíjet teprve před třemi měsíci. Je ještě mladý, ale je tam hodně zajímavého.
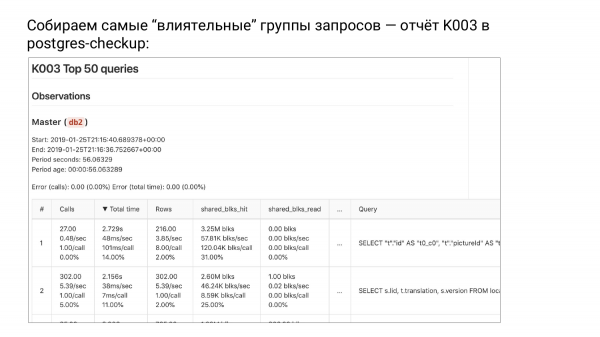
Sestavujeme ty nejvlivnější skupiny dotazů – zpráva K003 v Postgres-checkup
A tam je skupina reportů K. Zatím tři reporty. A je tu zpráva K003. Tam je vrchol z pg_stat_statements, seřazený podle total_time.
Když seřadíme skupiny dotazů podle total_time, vidíme na vrcholu takovou skupinu, která nejvíce zatěžuje náš systém, tedy spotřebovává větší množství zdrojů. Proč je nazývám skupinami dotazů? Protože jsme vyřadili parametry. To už nejsou dotazy, ale skupiny dotazů, tedy jsou abstrahované.
A pokud budeme optimalizovat shora dolů, usnadníme naše zdroje a oddálíme okamžik, kdy budeme muset provést upgrade. To je velmi dobrý způsob, jak ušetřit peníze.
Možná to není nejlepší způsob, jak se starat o uživatele, protože možná nezaznamenáme vzácné, ale velmi nepříjemné případy, kdy člověk čekal 15 sekund. Celkově jsou takové případy tak vzácné, že je nevidíme, ale zabýváme se zdroji.
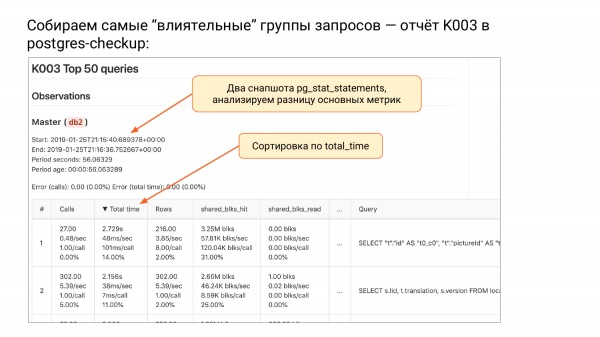
Co se stalo v této tabulce? Učinili jsme dva snapshoty. Postgres_checkup vám udělá delta pro každou metriky: podle total-time, calls, rows, shared_blks_read atd. Všechno, delta byla spočítaná. U pg_stat_statements je velký problém, že si nepamatuje, kdy došlo k resetu. Pokud pg_stat_database pamatuje, pg_stat_statements si nepamatuje. Vidíte, že tam je číslo 1 000 000, ale odkud jsme ho spočítali, nevíme.
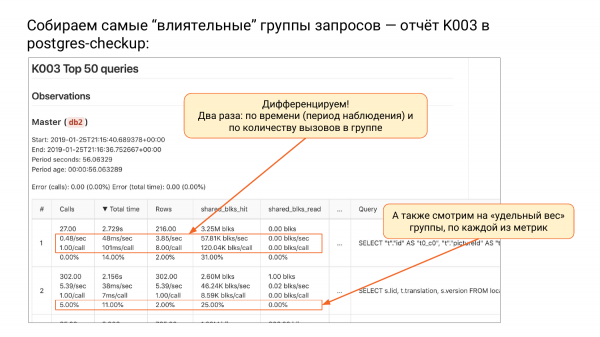
A tady to víme, máme dva snapshoty. Víme, že delta v tomto případě byla 56 sekund. Velmi malý interval. Seřadili jsme podle total_time. A dále můžeme diferencovat, tedy všechny metriky dělíme na duration. Pokud každou metriku vydělíme duration, dostaneme počet volání za sekundu.
Dále total_time za sekundu – to je moje oblíbená metrika. Měří se v sekundách, za sekundu, tedy kolik sekund našeho systému bylo potřeba k provedení této skupiny dotazů za sekundu. Pokud tam vidíte více než sekundu za sekundu, znamená to, že vám bylo potřeba dát více než jedno jádro. To je velmi dobrá metrika. Můžete pochopit, že tomuto chlapíkovi například potřebujete alespoň tři jádra.
Tohle je naše know-how, něco takového jsem nikde neviděl. Všimněte si – je to velmi jednoduchá věc – sekunda za sekundu. Někdy, když máte CPU na 100 %, je to půl hodiny za sekundu, tedy jste půl hodiny zabíjeli pouze tímto dotazem.
Dále vidíme počet řádků za sekundu. Víme, kolik řádků za sekundu se vrátilo.
A dále tu máme zajímavou věc. Kolik jsme přečetli ze shared_buffers za sekundu. Hity už byly tam, a řádky jsme vzali z cache operačního systému nebo z disku. První varianta je rychlá, a druhá může být rychlá, ale také může být pomalá, záleží na situaci.
Druhý způsob diferenciace spočívá v tom, že dělíme počet dotazů v této skupině. Ve druhém sloupci bude vždy jeden dotaz dělený na dotaz. A dále je zajímavé, kolik milisekund bylo v tomto dotazu. Víme, jak se ten dotaz v průměru chová. 101 milisekund bylo potřeba na každý dotaz. To je tradiční metrika, kterou potřebujeme pro pochopení.
Kolik řádků každý dotaz vrátil v průměru. Vidíme, že tato skupina vrací 8. Kolik v průměru bylo vzato a přečteno z cache. Vidíme, že všechno je skvěle zakováno. Samé hity pro první skupinu.
A čtvrtý podřádek v každém řádku je procento ze celkového počtu. Máme například callů. Předpokládejme, že 1 000 000. A můžeme pochopit, jaký příspěvek tato skupina přináší. Vidíme, že v tomto případě první skupina přináší příspěvek menší než 0,01 %. Tedy je tak pomalá, že ji v celkovém obrazci nevidíme. A druhá skupina – 5 % ze všech volání. Tedy 5 % všech volání patří do druhé skupiny.
Ohledně total_time to také je zajímavé. Na první skupinu dotazů jsme vynaložili 14 % celkového času. A na druhou – 11 % a tak dále.
Nechci zabíhat do detailů, ale tam jsou jemnosti. Na začátku vykazujeme chybu, protože když porovnáváme, snapshoty mohou selhat, tedy některé dotazy mohou chybět a ve druhém už nemusí být přítomny, a některé mohou nově vzniknout. A tam počítáme chybu. Pokud vidíte 0, je to dobré. To znamená, že není žádná chyba. Pokud je chybovost do 20 %, je to v pořádku.
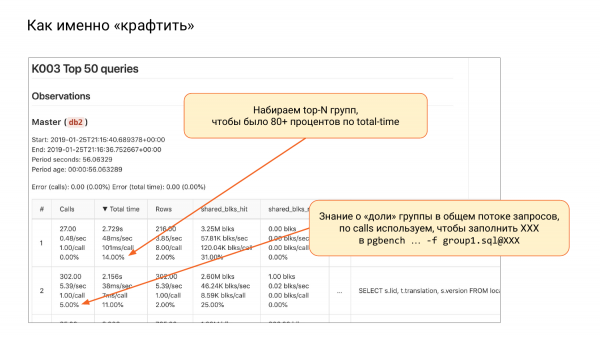
Dále se vracíme k našemu tématu. Musíme sestavit workload. Jdeme shora dolů, dokud nenashromáždíme 80 % nebo 90 %. Obvykle je to 10-20 skupin. A vytváříme soubory pro pgbench. Tam používáme random. Někdy to bohužel nevyjde. A v Postgres 12 bude více možností, jak takový přístup použít.
A dále takto získáváme 80-90 % podle total_time. Co dále přidávat za „@“? Sledujeme volání, kolik procent a chápeme, že zde bychom měli mít tolik procent. Z těchto procent můžeme pochopit, jak balancovat každý z souborů. Poté použijeme pgbench a jdeme pracovat.
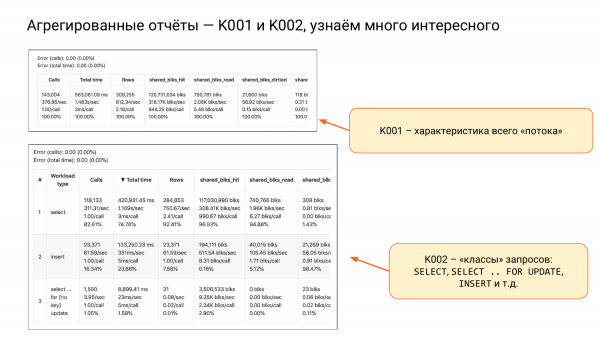
Máme také K001 a K002.
K001 – to je jeden velký řetězec se čtyřmi podřetězci. To je charakteristika našeho zatížení. Podívejte se na druhý sloupec a druhý podřetězec. Vidíme, že přibližně 1,5 sekundy za sekundu, t.j. pokud budou dvě jádra, bude to dobré. Budeme mít přibližně 75 % zatížení. A tak to bude fungovat. Pokud budeme mít 10 jader, budeme naprosto klidní. Takto můžeme hodnotit zdroje.
K002 – to nazývám třídami požadavků, t.j. SELECT, INSERT, UPDATE, DELETE. A zvlášť SELECT FOR UPDATE, protože ten zamyká.
A zde můžeme dojít k závěru, že běžné čtení SELECT představuje 82 % všech volání, ale přitom 74 % podle total_time. T.j. jsou často volány, ale méně spotřebovávají zdroje.
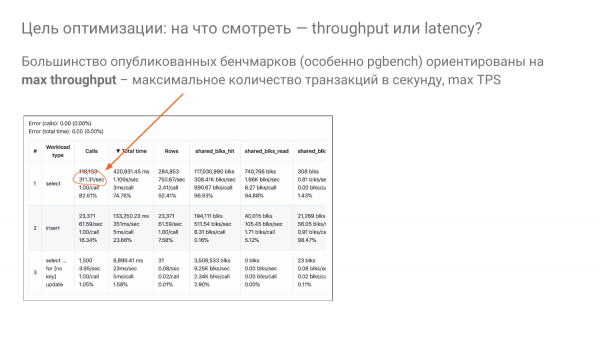
A vracíme se k otázce: „Jak správně nastavit shared_buffers?“. Pozoruji, že většina benchmarků je založena na myšlence – pojďme se podívat, jaký throughput bude, t.j. jaká bude propustnost. Obvykle se měří v TPS nebo QPS.
A snažíme se z vozu vyždímat co nejvíce transakcí za sekundu pomocí ladicích parametrů. Tady máme právě 311 za sekundu pro select.
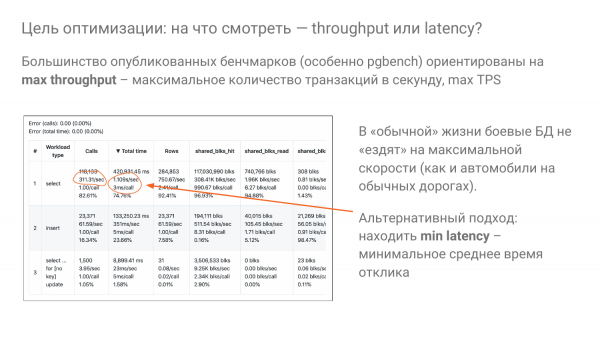
Ale nikdo nejezdí do práce a zpět domů autem na plnou rychlost. To je hloupé. Tak i s databázemi. Neměli bychom jezdit na plnou rychlost, nikdo to ani nedělá. Nikdo nežije v prostředí produkce, kde je 100% CPU. Ačkoliv, možná někteří žijí, ale to není dobré.
Myšlenka je taková, že obvykle jezdíme na 20 % našich možností, ideálně ne více než 50 %. A snažíme se optimalizovat dobu odezvy pro naše uživatele především. T.j. musíme naše nastavení konfigurovat tak, abychom zajistili minimální latenci při 20% rychlosti, podmíněně. To je koncept, který také snažíme aplikovat v našich experimentech.
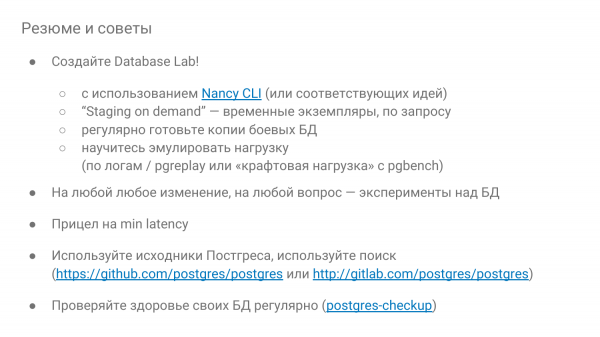
A na závěr doporučení:
- Určitě vytvořte Database Lab.
- Pokud to je možné, udělejte to na vyžádání, aby se to spustilo na určitou dobu – vyzkoušeli a zahodili. Pokud máte cloud, tak to je samozřejmost, t.j. mějte hodně standing.
- Buďte zvídaví. A pokud něco není v pořádku, ověřte si to experimenty, jak to funguje. Nancy lze použít k tomu, abyste se učili, jak databáze funguje.
- A mířte na minimální dobu odezvy.
- A nebojte se zdrojových kódů Postgres. Když pracujete se zdrojovými kódy, musíte znát angličtinu. Je tam spousta komentářů, všechno je vysvětleno.
- A pravidelně kontrolujte zdraví databáze, alespoň jednou za tři měsíce ručně, nebo pomocí Postgres-checkup.
Otázky
Děkuji mnohokrát! Velmi zajímavá věc.
Dvě věci.
Ano, dvě věci. Jenom jsem to úplně nepochopil. Když pracujeme s Nancy, můžeme měnit jen jeden parametr, nebo celou skupinu?
Máme delta-config parametr. Můžete do něj najednou změnit kolik chcete. Ale je třeba mít na paměti, že když změníte moc věcí, můžete udělat nesprávné závěry.
Ano. Proč jsem se ptal? Protože je složité provádět experimenty, když máte jen jeden parametr. Změníte ho, podíváte se, jak to funguje. Nastavili jste ho. Pak začnete s dalším.
Lze měnit více parametrů současně, ale samozřejmě záleží na situaci. Ale je lepší testovat jednu myšlenku. Včera nás napadla myšlenka. Měli jsme velmi podobnou situaci. Měli jsme dvě konfigurace. A nemohli jsme pochopit, proč je tak velký rozdíl. A napadlo nás, že musíme použít dichotomii k tomu, abychom postupně pochopili a našli, v čem je rozdíl. Můžete okamžitě nastavit polovinu parametrů stejně, pak čtvrtinu a tak dále. Všechno je flexibilní.
A ještě mám otázku. Projekt je mladý, rozvíjí se. Je již k dispozici dokumentace a podrobný popis?
Udělala jsem tam speciální odkaz na popis parametrů. To je k dispozici. Ale ještě není hodně věcí. Hledám spřízněné duše. A já je nacházím, když vystupuji. To je velmi skvělé. Někdo už se mnou pracuje, někdo pomohl a něco udělal. A pokud vás toto téma zajímá, dejte mi zpětnou vazbu – co chybí.
Až uděláme laboratoř, možná bude zpětná vazba. Uvidíme. Děkuji!
Dobrý den! Děkuji za přednášku! Viděl jsem, že je podpora Amazonu. Plánuje se podpora GSP?
Dobrý dotaz. Začali jsme pracovat. A zatím jsme to pozastavili, protože chceme šetřit. Tedy je zde podpora pomocí spuštění na localhostu. Můžete si vytvořit instance a pracovat lokálně. Mimochodem, tak to děláme. V Getlabu to dělám takto, tam na GSP. Ale dělat přesně takovou orchestraci zatím nevidíme smysl, protože Google nemá levné spoty. Existují ??? instance, ale mají omezení. Za prvé, tam je vždy pouze sleva 70 % a není možné si s cenou hrát. Spoty zvyšujeme cenu o 5-10 %, abychom snížili pravděpodobnost, že vás vyřadí. Tedy u spotů šetříte, ale mohou vám je kdykoliv vzít. Pokud máte cenu o něco vyšší než ostatní, budete eliminováni později. U Googlu je to úplně jiná specifika. A také existuje velmi špatné omezení – žijí pouze 24 hodin. A někdy chceme experiment provádět 5 dní. Ale na spotech se to dá dělat, spoty občas žijí měsíce.
Dobrý den! Děkuji za prezentaci! Zmínili jste se o checkupu. Jak počítáte chyby stat_statements?
Velmi dobrý dotaz. Mohu to podrobně ukázat a vysvětlit. Stručně – sledujeme, jak se vyvíjí soubor skupin dotazů: kolik jich selhalo a kolik nových se objevilo. A pak se díváme na dvě metriky: total_time a calls, proto tam jsou dvě chyby. A sledujeme, jaký přínos mají selhávající skupiny. Tam jsou dvě podskupiny: odcházející a přicházející. Díváme se, jaký mají přínos v celkovém obraze.
Nebojíte se, že se tam během doby mezi snapshoty otočí dvakrát či třikrát?
Tedy se znovu zaregistrovali nebo jak?
Například tento dotaz už jednou byl vyřazen, pak se vrátil a znovu byl vyřazen, pak znovu přišel a znovu byl vyřazen. A vy jste něco spočítali, a kde je to všechno?
Dobrý dotaz, je třeba se podívat.
Podobnou věc jsem dělal. Samozřejmě jednodušší, dělal jsem ji sám. Ale musel jsem to resetovat, udělat reset stat_statements a orientovat se v okamžiku snapshotu, že tam je méně určitého podílu, že se to stejně nedostalo na maximum, kolik stat_statements může nahromadit. A orientuji se, že pravděpodobně nic nebylo vyřazeno.
Ano, ano.
Ale nevím, jak jinak to udělat spolehlivě.
Bohužel si přesně nepamatuji – zda tam používáme text dotazu nebo queryid s pg_stat_statements a na to se orientujeme. Pokud se orientujeme na queryid, tak bychom v ideálním případě porovnávali porovnatelné věci.
Ne, může se několikrát uvolnit mezi snapshoty a znovu přijet.
S tímto ID?
Ano.
Zkoumáme to. Dobrý dotaz. Musíme to prostudovat. Ale zatím to, co vidíme, máme buď 0 napsané...
To je samozřejmě vzácný případ, ale šokovalo mě, když jsem zjistil, že stat_statements tam může uvolnit.
V Pg_stat_statements může být spousta věcí. Setkali jsme se s tím, že pokud máte track_utility = on, také se vám sledují sety.
Ano, samozřejmě.
A pokud máte java hibernate, který je náhodný, tak se začne zamykat hash tabulka. A jakmile vypnete velmi zatíženou aplikaci, máte 50-100 skupin. A tam je to víceméně stabilní. Jedním z způsobů, jak s tím bojovat, je zvýšit pg_stat_statements.max.
Ano, ale musíte vědět, o kolik. A nějak ho musíte sledovat. Dělám to takto. T. j. mám pg_stat_statements.max. A sleduji, že na okamžik snapshotu jsem nedosáhl 70 %. Dobře, znamená to, že jsme nic neztratili. Děláme reset. A znovu sbíráme. Pokud v dalším snapshotu bude méně než 70, pak pravděpodobně opět nic neztratíme.
Ano. Ve výchozím nastavení je to nyní 5 000. A mnoha lidem to stačí.
Obvykle – ano.
Video:
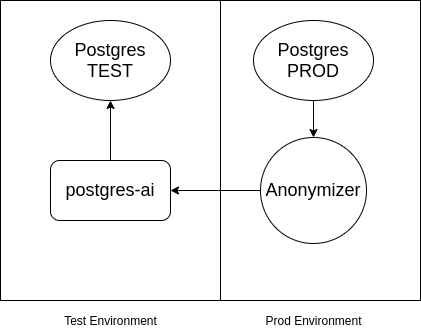
P.S. Přidám, že pokud se v Postgresu nacházejí citlivá data, která nesmí skončit v testovacím prostředí, je možné využít . Schéma je zhruba následující:
Zdroj: habr.com
