

Tento příspěvek byl napsán, protože jsme měli s našimi klienty řadu rozhovorů o vývoji aplikací na Kubernetes a specifikách tohoto vývoje na OpenShift.
Obvykle začínáme tvrzením, že Kubernetes je prostě Kubernetes, zatímco OpenShift je již platforma Kubernetes, jako Microsoft AKS nebo Amazon EKS. Každá z těchto platforem má své výhody zaměřené na určité cílové publikum. A po tomto úvodu přecházíme k porovnání silných a slabých stránek konkrétních platforem.
Obecně jsme chtěli napsat tento příspěvek s závěrem typu „Poslyšte, na tom opravdu nezáleží, kde spouštět kód, na OpenShift nebo na AKS, na EKS, na nějakém custom Kubernetes, prostě na jakémkoliv Kubernetes (zkráceně ho nazveme KUK) – je to skutečně jednoduché, jak tam, tak i tady.“
Pak jsme plánovali vzít nejjednodušší "Hello World" a na jeho příkladu ukázat, co je společné a jaké jsou rozdíly mezi KUK a Red Hat OpenShift Container Platform (dále OCP nebo jednoduše OpenShift).
Během psaní tohoto příspěvku jsme si však uvědomili, že jsme si tak dlouho a silně zvykli používat OpenShift, že si ani neuvědomujeme, jak vyrostl a stal se ohromnou platformou, která je mnohem víc než jen distribucí Kubernetes. Na zralost a jednoduchost OpenShift jsme si zvykli brát jako samozřejmost, zapomínajíce na jeho skvost.
Obecně přišel čas na aktivní lítost a teď krok za krokem porovnáme nasazení našeho "Hello World" na KUK a na OpenShift a uděláme to co nejobjektivněji (alespoň občas vyjádříme svůj osobní názor na věc). Pokud vás zajímají pouze subjektivní názory na toto téma, můžete si je přečíst . V tomto příspěvku se však budeme držet faktů a pouze faktů.
Klastery
Pro naše "Hello World" jsou potřebné klastery. Hned říkáme „ne“ všem veřejným cloudům, abychom nemuseli platit za servery, registry, sítě, přenosy dat atd. Tím pádem vybíráme jednoduchý jednodeskový klastr na (pro KUK) a (pro klastr OpenShift). Obě tyto varianty jsou opravdu jednoduché na instalaci, ale vyžadují docela dost zdrojů na vašem notebooku.
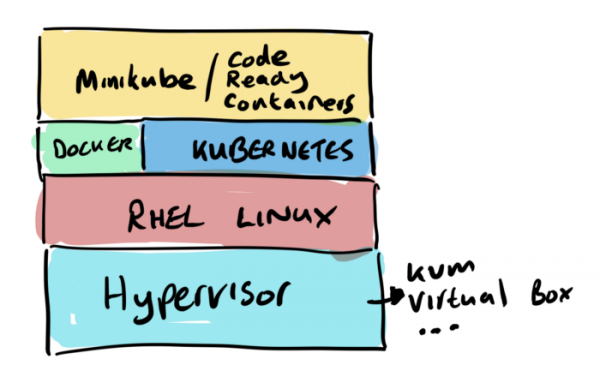
Sestavení na KUK-u
Tak pojďme na to.
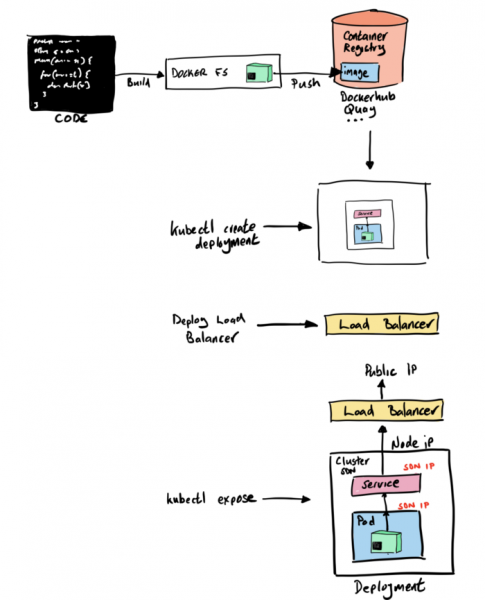
Krok 1 – shromáždíme náš kontejnerový obraz
Začneme tím, že na minikube nasadíme naše "Hello World". K tomu potřebujeme:
- 1. Nainstalovaný Docker.
- 2. Nainstalovaný Git.
- 3. Nainstalovaný Maven (ve skutečnosti se v tomto projektu používá mvnw-binárka, takže se bez něj dá obejít).
- 4. Přímo zdrojový kód, tedy klon repozitáře
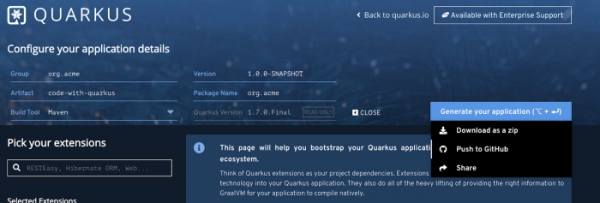
Nejprve je třeba vytvořit projekt Quarkus. Nebojte se, pokud jste nikdy nepracovali se stránkami Quarkus.io – je to snadné. Jednoduše vyberete komponenty, které chcete v projektu použít (RestEasy, Hibernate, Amazon SQS, Camel atd.), a poté Quarkus sám, bez vašeho jakéhokoliv zapojení, nastaví archetyp maven a nahodí vše na github. To znamená doslova jedno kliknutí myší – a je hotovo. Za to máme Quarkus rádi.
Nejjednodušší způsob, jak sestavit náš „Hello World“ do kontejnerového obrazu, je použít rozšíření quarkus-maven pro Docker, které udělá veškerou potřebnou práci. S příchodem Quarkus to bylo opravdu snadné a jednoduché: přidáte rozšíření container-image-docker a můžete vytvářet obrazy pomocí příkazů maven.
./mvnw quarkus:add-extension -Dextensions="container-image-docker"
A nakonec provedeme sestavení našeho obrazu pomocí Maven. Výsledkem je, že náš zdrojový kód se přetvoří v hotový kontejnerový obraz, který lze již spustit v prostředí kontejnerů.
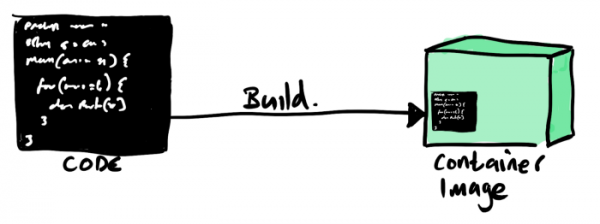
./mvnw -X clean package -Dquarkus.container-image.build=true
A to je vlastně všechno, nyní můžeme spustit kontejner pomocí příkazu docker run, mapováním našeho servisu na port 8080, abychom k němu mohli přistupovat.
docker run -i — rm -p 8080:8080 gcolman/quarkus-hello-world
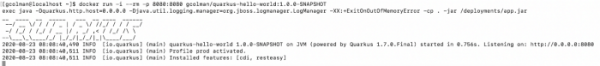
Jakmile se kontejnerový instance spustí, zbývá pouze ověřit příkazem curl, že náš servis funguje:

Takže, vše funguje, a bylo to opravdu snadné a jednoduché.
Krok 2 – posíláme náš kontejner do repozitáře kontejnerových obrazů
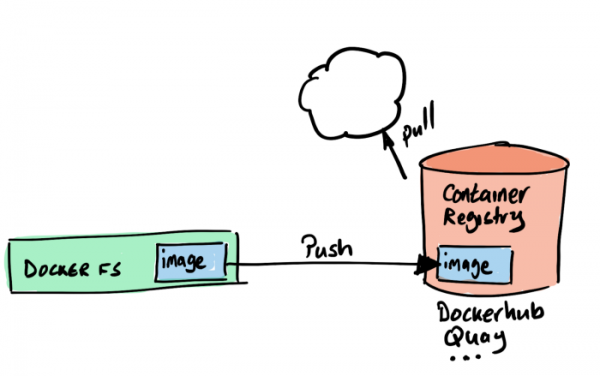
Zatímco náš obraz je uložen místně v našem místním kontejnerovém úložišti. Pokud chceme tento obraz použít ve svém KUK prostředí, musíme ho umístit do nějakého jiného repozitáře. V Kubernetes takové funkce neexistují, proto budeme používat dockerhub. Protože, za prvé, je to zdarma, a za druhé, (skoro) všichni to tak dělají.
To je také velmi jednoduché a potřebujete zde pouze účet na dockerhub.
Takže, přihlašujeme se na dockerhub a posíláme tam náš obraz.
Krok 3 – spouštíme Kubernetes
Existuje mnoho způsobů, jak sestavit konfiguraci kubernetes pro spuštění našeho „Hello World“, ale použijeme ten nejjednodušší, jaký jen existuje...
Nejprve spouštíme klastr minikube:
minikube start
Krok 4 – nasazujeme náš kontejnerový obraz
Nyní musíme převést náš kód a kontejnerový obraz do konfigurací kubernetes. Jinými slovy, potřebujeme pod a definici nasazení s odkazem na náš kontejnerový obraz na dockerhub. Jedním z nejjednodušších způsobů, jak to udělat, je spustit příkaz create deployment, s odkazem na náš obraz:
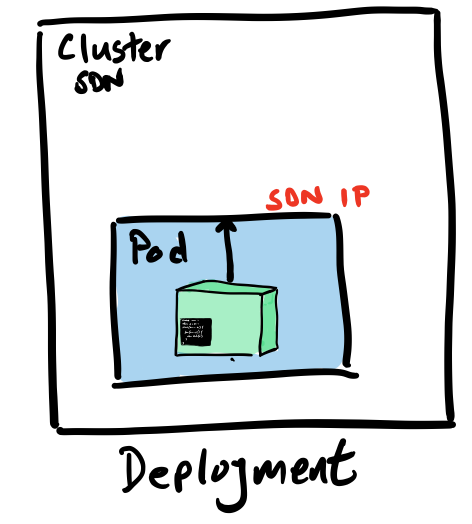
kubectl create deployment hello-quarkus --image=gcolman/quarkus-hello-world:1.0.0-SNAPSHOT
Tímto příkazem jsme řekli našemu KUBERNETES, aby vytvořil konfigurační nasazení, které bude obsahovat specifikaci podu pro náš kontejnerový obraz. Tento příkaz také aplikujte tuto konfiguraci na náš cluster minikube a vytvoří nasazení, které stáhne náš kontejnerový obraz a spustí pod v clusteru.
Krok 5 – otevíráme přístup k našemu službě
Nyní, když máme nasazený kontejnerový obraz, je čas přemýšlet o tom, jak nakonfigurovat externí přístup k této Restful službě, která je vlastně naprogramována v našem kódu.
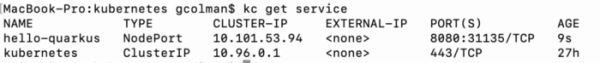
Existuje mnoho způsobů. Například můžeme použít příkaz expose, abychom automaticky vytvořili odpovídající komponenty Kubernetes, jako jsou služby a koncové body. Vlastně to tak uděláme, když vykonáme příkaz expose pro náš objekt nasazení:
kubectl expose deployment hello-quarkus --type=NodePort --port=8080
Na chvíli se zastavme u volby "--type" příkazu expose.
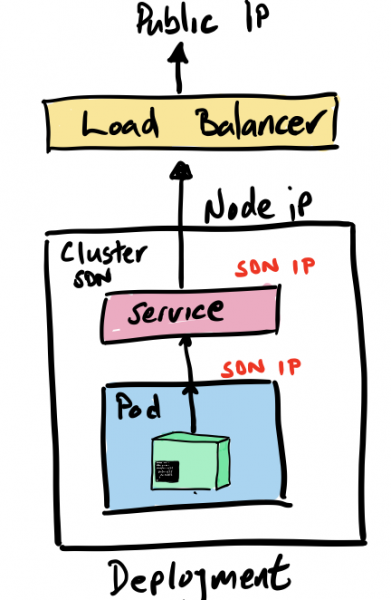
Když provádíme expose a vytváříme komponenty potřebné pro spuštění naší služby, potřebujeme, abychom se zvenčí mohli připojit k službě hello-quarkus, která je uvnitř naší softwarově definované sítě. A parametr type nám umožňuje vytvořit a připojit takové věci, jako jsou vyvažovače zátěže, aby směrovaly provoz do této sítě.
Například, pokud napíšeme type=LoadBalancer, automaticky inicializujeme vyvažovač zátěže v veřejném cloudu, abychom se připojili k našemu clusteru Kubernetes. To je samozřejmě skvělé, ale je třeba mít na paměti, že taková konfigurace bude pevně svázaná s konkrétním veřejným cloudem a bude obtížnější ji přenášet mezi Kubernetes instancemi v různých prostředích.
V našem příkladu type=NodePort, tedy přístup k naší službě se provádí pomocí IP adresy uzlu a čísla portu. Tato varianta nevyžaduje využití žádných veřejných cloudů, ale vyžaduje několik dalších kroků. Za prvé, potřebujeme vlastní vyrovnávač zátěže, proto nasadíme ve svém clusteru vyrovnávač zátěže NGINX.
Krok 6 – instalujeme vyrovnávač zátěže
Minikube má řadu platformových funkcí, které usnadňují vytváření potřebných komponentů pro přístup z venku, jako jsou ingress kontroléry. Minikube přichází s ingress kontrolérem Nginx a my ho teď jen musíme zapnout a nakonfigurovat.
minikube addons enable ingress
Nyní jedním příkazem vytvoříme ingress kontrolér Nginx, který bude fungovat uvnitř našeho clusteru minikube:
ingress-nginx-controller-69ccf5d9d8-j5gs9 1/1 Running 1 33m
Krok 7 – Konfigurujeme ingress
Nyní musíme nakonfigurovat ingress kontrolér Nginx, aby zpracovával požadavky na hello-quarkus.
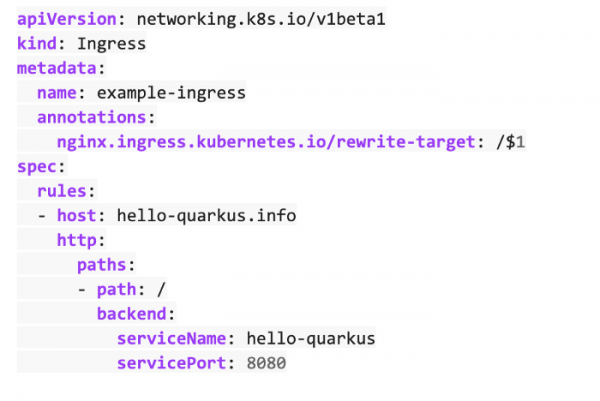
A nakonec musíme aplikovat tuto konfiguraci.
kubectl apply -f ingress.yml

Protože to všechno děláme na svém počítači, jednoduše přidáme IP adresu svého uzlu do souboru /etc/hosts, abychom směrovali http požadavky na náš minikube na vyrovnávač zátěže NGINX.
192.168.99.100 hello-quarkus.info
Hotovo, nyní je naše služba minikube dostupná zvenku přes ingress kontrolér Nginx.
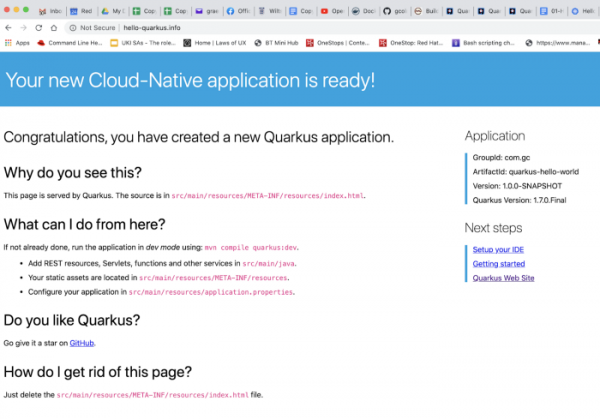
No co, bylo to snadné, že? Nebo ne tak úplně?
Nasazení na OpenShift (Code Ready Containers)
A teď se podíváme, jak to všechno funguje na Red Hat OpenShift Container Platform (OCP).
Jak v případě minikube, vybíráme schéma s jednouzlovým clusterem OpenShift ve formě Code Ready Containers (CRC). Dříve se to nazývalo minishift a vycházelo z projektu OpenShift Origin, nyní je to CRC a postaveno na OpenShift Container Platform od Red Hat.
Tady se, promiňte, nemůžeme zdržet a neříct: "OpenShift je skvělý!"
Původně jsme chtěli napsat, že vývoj na OpenShift se ničím neliší od vývoje na Kubernetes. A v podstatě to tak je. Ale během psaní tohoto příspěvku jsme si vzpomněli, kolik zbytečných kroků je třeba udělat, když nemáte OpenShift, a proto jsme, opakujeme, jeho fanoušci. Milujeme, když se všechno dělá snadno, a to, jak snadno se náš příklad nasazuje a spouští na OpenShift ve srovnání s minikube, nás vlastně k napsání tohoto příspěvku podnítilo.
Pojďme projít procesem a podívat se, co všechno budeme muset udělat.
Takže v příkladu s minikube jsme začínali s Dockerem… Počkejte, už nepotřebujeme, aby byl na stroji nainstalován Docker.
A lokální git už nepotřebujeme.
A Maven není potřeba.
A není potřeba ručně vytvářet kontejnerový obraz.
A není potřeba hledat žádný repozitář kontejnerových obrazů.
A není potřeba instalovat ingress kontroler.
A konfigurace ingressu také není nutná.
Rozumíte, že? Abychom nasadili a spustili naši aplikaci na OpenShift, nepotřebujeme nic z výše uvedeného. A samotný proces vypadá takto.
Krok 1 – Spustíme svůj OpenShift klastr
Používáme Code Ready Containers od Red Hat, což je v podstatě stejné jako Minikube, ale pouze s plnohodnotným jednom uzlovým klastry Openshift.
crc start
Krok 2 – Provádíme sestavení a nasazení aplikace do klastru OpenShift
Právě v tomto kroku se projevuje jednoduchost a pohodlí OpenShift v plné kráse. Stejně jako u všech distribucí Kubernetes máme mnoho způsobů, jak spustit aplikaci v klastru. A stejně jako u K8S si volíme ten nejjednodušší.
OpenShift byl vždy vybudován jako platforma pro vytváření a spuštění kontejnerových aplikací. Sestavení kontejnerů bylo vždy nedílnou součástí této platformy, a proto zde máme spoustu dalších Kubernetes zdrojů pro odpovídající úkoly.
Budeme používat OpenShiftův proces Source 2 Image (S2I), který má několik různých způsobů, jak vzít náš zdroj (kód nebo binární soubory) a přetvořit ho na kontejnerový obraz, spustitelný v klastru OpenShift.
K tomu budeme potřebovat dvě věci:
- Náš zdrojový kód v git repozitáři
- Builder obraz, na jehož základě proběhne sestavení.
Existuje mnoho takových obrazů, spravovaných jak silami Red Hat, tak na úrovni komunity, a využijeme obraz OpenJDK, protože však sestavuji Java aplikaci.
Spustit S2I sestavení můžeme jak z grafické konzole OpenShift Developer, tak z příkazového řádku. Použijeme příkaz new-app, kterému uvedeme, odkud brát builder obraz a náš zdrojový kód.
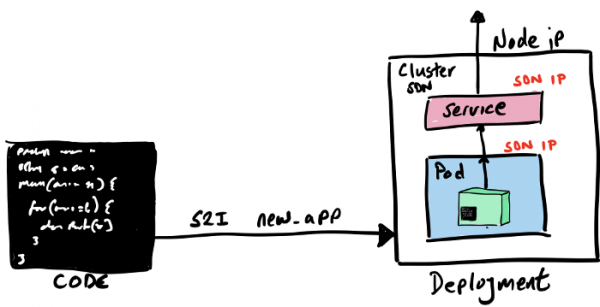
oc new-app registry.access.redhat.com/ubi8/openjdk-11:latest~https://github.com/gcolman/quarkus-hello-world.git
Hotovo, naše aplikace je vytvořena. Přitom proces S2I vykonal následující věci:
- Vytvořil služební build-pod pro vše, co souvisí se sestavením aplikace.
- Vytvořil konfiguraci OpenShift Build.
- Stáhl builder obraz do vnitřního docker registru OpenShift.
- Odkopíroval „Hello World“ do místního repozitáře.
- Viděl jsem, že tam je maven pom, a proto jsem aplikaci zkompiloval pomocí maven.
- Vytvořil jsem nový kontejnerový obraz obsahující zkompilovanou Java aplikaci a dal tento obraz do interního registru kontejnerů.
- Vytvořil jsem Kubernetes Deployment se specifikacemi podu, služby atd.
- Spustil jsem nasazení kontejnerového obrazu.
- Smazal jsem pomocný build-pod.
Na tomto seznamu je mnoho položek, ale hlavní je, že celá sestava probíhá výhradně uvnitř OpenShiftu, interní Docker registr se nachází uvnitř OpenShiftu, a proces sestavení vytváří všechny komponenty Kubernetes a spouští je v clusteru.
Pokud vizuálně sledujete spuštění S2I v konzoli, můžete vidět, jak se při sestavení spouští build pod.
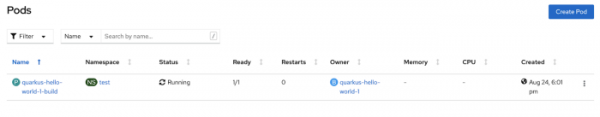
A teď se podívejme na logy builder podu: za prvé, je tam vidět, jak maven dělá svou práci a stahuje závislosti pro sestavení naší java aplikace.
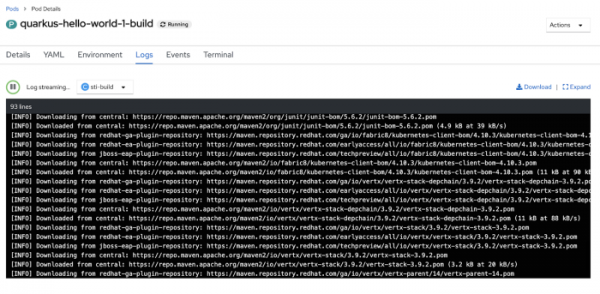
Po dokončení maven sestavení se spustí sestavení kontejnerového obrazu a poté se tento zkompilovaný obraz odešle do interního repozitáře.
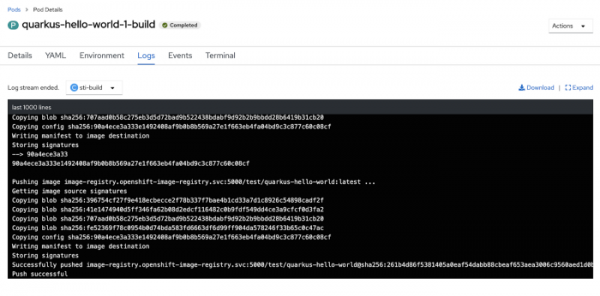
Hotovo, proces sestavení je dokončen. Teď se ujistíme, že v clusteru byly spuštěny pody a služby naší aplikace.
oc get service
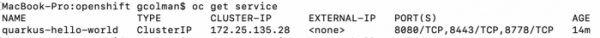
A to je vše. A pouze jeden příkaz. Zbývá nám jen vystavit tuto službu pro přístup zvenčí.
Krok 3 – vystavujeme službu pro přístup zvenčí
Stejně jako v případě KUB, na platformě OpenShift potřebuje náš "Hello World" také router, aby směroval externí provoz na službu uvnitř clustru. V OpenShift to funguje velmi jednoduše. Za prvé, v clusteru je ve výchozím nastavení nainstalována součást pro směrování HAProxy (tu můžete vyměnit za NGINX). Za druhé, existují zde speciální a variabilní zdroje, kterým se říká Routes a připomínají Ingress objekty ve starém dobrém Kubernetes (ve skutečnosti OpenShiftové Routes silně ovlivnily design Ingress objektů, které nyní lze používat i v OpenShiftu), ale pro náš "Hello World", a vlastně v téměř všech ostatních případech, stačí standardní Route bez dalšího nastavení.
Abychom vytvořili pro "Hello World" směrovatelný FQDN (ano, v OpenShiftu je svůj DNS pro směrování podle názvů služeb), jednoduše provedeme expose pro naši službu:
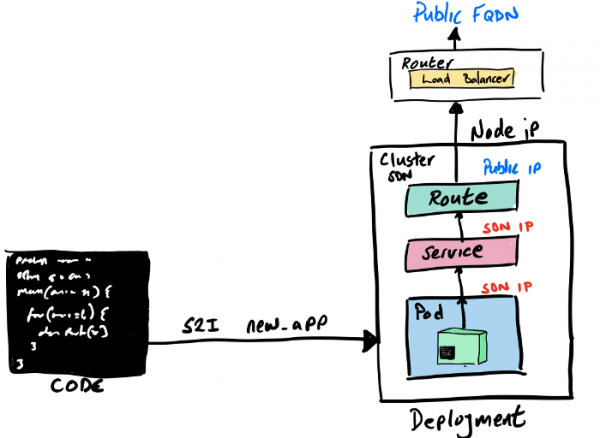
oc expose service quarkus-hello-world
Pokud se podíváte na právě vytvořenou Route, najdete tam FQDN a další informace o směrování:
oc get route

A nakonec se obracíme na naši službu z prohlížeče:
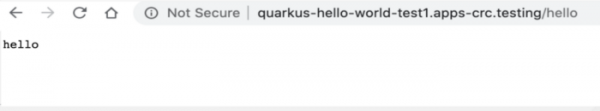
A teď to bylo opravdu snadné!
Milujeme Kubernetes a vše, co tato technologie umožňuje, a také máme rádi jednoduchost a snadnost. Kubernetes byl navržen tak, aby neuvěřitelně zjednodušil provoz distribuovaných škálovatelných kontejnerů, ale pro uvedení aplikací do provozu už dnes jeho jednoduchosti není dost. A zde přichází na scénu OpenShift, který jde s dobou a nabízí Kubernetes zaměřený především na vývojáře. Bylo vloženo mnoho úsilí do přizpůsobení platformy OpenShift právě pro vývojáře, včetně vytvoření takových nástrojů jako S2I, ODI, Developer Portal, OpenShift Operator Framework, integrace s IDE, Developer Catalogues, integrace s Helm, monitorování a mnohé další.
Doufáme, že tento článek byl pro vás zajímavý a užitečný. Další zdroje, materiály a další užitečné věci pro vývoj na platformě OpenShift naleznete na portálu .
Zdroj: habr.com
