

je standard (ISO, ITU-T, GOST) jazyka popisujícího strukturované informace a také pravidla pro kódování těchto informací. Pro mne jako programátora je to prostě další formát serializace a prezentace dat, vedle JSON, XML, XDR a dalších. Je široce využíván v našem každodenním životě a mnoho lidí se s ním setkává: v mobilních, telefonních a VoIP komunikacích (UMTS, LTE, WiMAX, SS7, H.323), v síťových protokolech (LDAP, SNMP, Kerberos), ve všech aspektech kryptografie (X.509, CMS, PKCS standardy), na bankovních kartách a biometrických pasech a mnoha dalších místech.
V tomto článku se zkoumá : Python ASN.1 knihovna aktivně používaná v projektech souvisejících s kryptografií v .
Opravu bych vlastně doporučoval se vyhnout použití ASN.1 pro kryptografické úkoly: ASN.1 a jeho kodeky jsou složité. To znamená, že kód nebude jednoduchý, a to vždy představuje další útočný vektor. Stačí se podívat zranitelností v knihovnách ASN.1. Bruce Schneier ve své také nedoporučuje používat tento standard kvůli jeho složitosti: „Nejznámějším TLV kódováním je ASN.1, ale je to neuvěřitelně složité a vyhýbáme se mu.“ Bohužel však dnes máme ve kterých se aktivně používají , CRL, OCSP, TSP, protokoly CMP, , zprávy , a řada standardů . Proto je nutné umět pracovat s ASN.1, pokud se zabýváte něčím spojeným s kryptografií.
ASN.1 může být kódován mnoha způsoby/kodeky:
- (Basic Encoding Rules)
- (Canonical Encoding Rules)
- (Distinguished Encoding Rules)
- (Generic String Encoding Rules)
- (JSON Encoding Rules)
- LWER (Light Weight Encoding Rules)
- (Octet Encoding Rules)
- (Packed Encoding Rules)
- SER (Signalling specific Encoding Rules)
- (XML Encoding Rules)
a řadou dalších. Ale v kryptografických úlohách se ve skutečnosti používají dva: BER a DER. I v podepsaných XML dokumentech (, ) budou stále Base64 kódované ASN.1 DER objekty, stejně jako v JSON orientovaném protokolu od Let’s Encrypt. Je lepší se podrobně seznámit se všemi těmito kodeky a principy kódování BER/CER/DER v článcích a knihách: , , .
BER je binární bajtově orientovaný (např. PER, populární v mobilní komunikaci — bitově orientovaný) TLV formát. Každý prvek je kódován ve formě: tagu (Tag), identifikující typ kódovaného prvku (celé číslo, řetězec, datum atd.), délky (Ldélka) obsahu a samotného obsahu (Value). BER volitelně umožňuje nezadávat hodnotu délky, udávající zvláštní neomezenou délku hodnotu a končící zprávou značkou End-Of-Octets. Kromě kódování délky nabízí BER mnoho variabilit v kódování typů dat, například:
- INTEGER, OBJECT IDENTIFIER, BIT STRING a délka prvku může být neregulována (nezakódována v minimální formě);
- BOOLEAN je pravdivý pro jakýkoli nenulový obsah;
- BIT STRING může obsahovat „přebytečné“ nulové bity;
- BIT STRING, OCTET STRING a všechny jejich odvozené řetězcové typy, včetně data/času, mohou být rozděleny na kousky (chunk) proměnné délky, jejichž délka není při (de)kódování předem známa;
- UTCTime/GeneralizedTime mohou mít různé způsoby určení posunu časové zóny a „přebytečné“ nulové zlomky sekund;
- DEFAULT hodnoty SEQUENCE lze kódovat, ale také nemusí;
- Pojmenované hodnoty posledních bitů v BIT STRING lze podle potřeby nekódovat;
- SEQUENCE (OF)/SET (OF) mohou mít libovolné pořadí prvků.
Vzhledem k výše uvedenému, kódování dat tak, aby byla identická s originální formou — není vždy možné. Proto byla vytvořena podmnožina pravidel: DER — striktně regulující pouze jeden povolený způsob kódování, což je kritické pro kryptografické úkoly, kde například změna jednoho bitu udělá podpis nebo kontrolní součet neplatným. DER má podstatnou nevýhodu: délky všech prvků musí být předem známy během kódování, což neumožňuje streamovat data. CER kodek tuto nevýhodu postrádá, přičemž také zaručuje jednoznačné zobrazení dat. Bohužel (nebo k štěstí, že zatím nemáme ještě složitější dekodéry?) se nestal populárním. Proto se v praxi setkáváme s „smíšeným“ použitím dat zakódovaných pomocí BER a DER. Protože jak CER tak DER jsou podmnožinou BER, jakýkoli BER-dekodér je schopen je zpracovat.
Problémy s pyasn1
V práci píšeme mnoho programů v Pythonu souvisejících s kryptografií. A před několika lety byla nabídka volně dostupných knihoven prakticky nulová: buď to byly velmi nízkoúrovňové knihovny, které umožňovaly pouze kódovat/dekódovat například celé číslo a hlavičku struktury, nebo to byla knihovna . Na ní jsme žili několik let a zpočátku byli velmi spokojeni, protože umožňuje pracovat se strukturovanými daty ASN.1 jako s vysoce úrovňovými objekty: například dekódovaný objekt X.509 certifikátu nám umožňuje přistupovat k jeho polím prostřednictvím rozhraní slovníku: cert[„tbsCertificate“][„serialNumber“] nám ukáže sériové číslo tohoto certifikátu. Podobně lze „sestavovat“ složité objekty, když s nimi pracujeme jako se seznamy, slovníky, a pak jednoduše zavolat funkci pyasn1.codec.der.encoder.encode a získat serializované zobrazení dokumentu.
Nicméně, objevily se nedostatky, problémy a omezení. V pyasn1 byly a bohužel stále jsou chyby: k okamžiku psaní článku je v pyasn1 jeden z základních typů — GeneralizedTime, dekodován a kódován.
V našich projektech, pro úsporu místa, často uchováváme pouze cestu k souboru, posun a délku v bytech objektu, na který se chceme odkazovat. Například libovolně podepsaný soubor určitě bude v rámci struktury CMS SignedData ASN.1:
  0     [1,3,1018]  ContentInfo SEQUENCE
  4     [1,1,   9]   . contentType: ContentType OBJECT IDENTIFIER 1.2.840.113549.1.7.2 (id_signedData)
 19-4   [0,0,1003]   . content: [0] EXPLICIT [UNIV 16] ANY
 19     [1,3, 999]   . . DEFINED BY id_signedData: SignedData SEQUENCE
 23     [1,1,   1]   . . . version: CMSVersion INTEGER v3 (03)
 26     [1,1,  19]   . . . digestAlgorithms: DigestAlgorithmIdentifiers SET OF
                           [...]
 47     [1,3, 769]   . . . encapContentInfo: EncapsulatedContentInfo SEQUENCE
 51     [1,1,   8]   . . . . eContentType: ContentType OBJECT IDENTIFIER 1.3.6.1.5.5.7.12.2 (id_cct_PKIData)
 65-4   [1,3, 751]   . . . . eContent: [0] EXPLICIT OCTET STRING 751 bytes OPTIONAL

                 TADY JE OBSAH PODPISOVANÉHO SOUBORU O VELIKOSTI 751 BYTE

820     [1,2, 199]   . . . signerInfos: SignerInfos SET OF
823     [1,2, 196]   . . . . 0: SignerInfo SEQUENCE
826     [1,1,   1]   . . . . . version: CMSVersion INTEGER v3 (03)
829     [0,0,  22]   . . . . . sid: SignerIdentifier CHOICE subjectKeyIdentifier
                               [...]
956     [1,1,  64]   . . . . . signature: SignatureValue OCTET STRING 64 bytes
                     . . . . . . C1:B3:88:BA:F8:92:1C:E6:3E:41:9B:E0:D3:E9:AF:D8
                     . . . . . . 47:4A:8A:9D:94:5D:56:6B:F0:C1:20:38:D2:72:22:12
                     . . . . . . 9F:76:46:F6:51:5F:9A:8D:BF:D7:A6:9B:FD:C5:DA:D2
                     . . . . . . F3:6B:00:14:A4:9D:D7:B5:E1:A6:86:44:86:A7:E8:C9
A můžeme získat originální podepsaný soubor s posunem 65 bytů a délkou 751 bytů. Pyasn1 tuto informaci ve svých dekódovaných objektech neuchovává. Byl napsán tzv. TLVSeeker - malá knihovna, která umožňuje dekódovat tagy a délky objektů. V jejím rozhraní jsme zadávali příkazy jako „přejít k dalšímu tagu“, „vstoupit do tagu“ (přejdeme dovnitř objektu SEQUENCE), „přejít k dalšímu tagu“, „oznam svůj offset a délku objektu, kde se nacházíme“. To bylo „ruční“ procházení ASN.1 DER-serializovanými daty. Ale s BER-serializovanými daty to nešlo řešit tímto způsobem, protože například bajtový řetězec OCTET STRING mohl být kódován v několika částech.
Další nevýhodou pro naše úkoly pyasn1 je nemožnost zjistit z dekódovaných objektů, zda dané pole bylo ve SEQUENCE přítomno nebo ne. Například pokud struktura obsahuje pole Field SEQUENCE OF Smth OPTIONAL, může úplně chybět v přijatých datech (OPTIONAL), nebo může být přítomno, ale mít nulovou délku (prázdný seznam). Obecně se to nedalo zjistit. A to je nezbytné pro přísnou kontrolu validity přijatých dat. Představte si, že by nějaký certifikační úřad vydal certifikát s „ne úplně“ validními daty z hlediska ASN.1 schématu! Například certifikační úřad „TÜRKTRUST Elektronik Sertifika Hizmet Sağlayıcısı“ ve svém kořenovém certifikátu překročil povolené hranice délky komponentu subject - není možné jej poctivě dekódovat podle schématu. DER kodek vyžaduje, aby pole, jehož hodnota je rovna DEFAULT, nebylo při přenosu kódováno - v praxi se takové dokumenty objevují a první verze PyDERASN dokonce vědomě povolila takové neplatné (z hlediska DER) chování kvůli zpětné kompatibilitě.
Dalším omezením je nemožnost snadno zjistit, v jakém formátu (BER/DER) byl zakódován daný objekt ve struktuře. Například standard CMS říká, že zpráva je kódována jako BER, ale pole signedAttrs, na němž se vytváří kryptografický podpis, musí být v DER. Pokud dekódujeme DER, dojdeme k problému při zpracování samotného CMS, pokud dekódujeme BER, nebudeme vědět, v jakém formátu byla signedAttrs. Nakonec se budeme muset pomocí TLVSeekeru (což nemá analog v pyasn1) snažit najít umístění každého pole signedAttrs a jednotlivě je dekódovat z jejich serializovaného formátu jako DER.
Velmi žádanou pro nás byla možnost automatického zpracování DEFINED BY polí, která se vyskytují velmi často. Po dekódování struktury ASN.1 může zůstat mnoho ANY polí, které by měly být dále zpracovány podle schématu vybraného na základě OBJECT IDENTIFIER uvedeného ve struktuře. V Python kódu to znamená napsat if a následně zavolat dekodér pro ANY pole.
Vznik PyDERASN
V Atlase pravidelně, když najdeme nějaké problémy nebo upravíme používané volné programy, posíláme patche dál. V pyasn1 jsme několikrát odeslali úpravy, ale kód pyasn1 není nejjednodušší k pochopení a občas se zde děly nekompatibilní změny API, které nám ztěžovaly práci. Navíc jsme si zvykli na psaní testů pomocí generativního testování, což v pyasn1 chybělo.
Jednoho dne jsem se rozhodl, že je třeba to přestat snášet a zkusit napsat vlastní knihovnu se __slot__y, offsety a krásně zobrazenými blob-y! Jen vytvořit ASN.1 kodek by bylo nedostatečné — je potřeba převést všechny naše vzájemně závislé projekty na něj, což představuje stovky tisíc řádků kódu, kde se hodně pracuje se strukturovanými daty ASN.1. To znamená, že jedním z požadavků na něj je lehkost převodu současného kódu pyasn1. Strávil jsem celý svůj dovolenou, napsal tuto knihovnu a všechny projekty na ni převedl. Protože mají téměř 100%-ní pokrytí testy, znamenalo to i plnou funkčnost knihovny.
PyDERASN má obdobně téměř 100%-ní pokrytí testy. Používá se generativní testování s úžasnou knihovnou . Bylo také prováděno -em na 32-jádrových strojích. I když u nás prakticky nezůstal žádný kód v Python2, PyDERASN stále zajišťuje kompatibilitu s ním a kvůli tomu má jedinou závislost. Kromě toho byl testován vůči .
Princip práce s ním je podobný jako u pyasn1 — práce s vysoce úrovňovými objekty Pythonu. Popis schémat ASN.1 je podobný.
class TBSCertificate(Sequence):
    schema = (
        ("version", Version(expl=tag_ctxc(0), default="v1")),
        ("serialNumber", CertificateSerialNumber()),
        ("signature", AlgorithmIdentifier()),
        ("issuer", Name()),
        ("validity", Validity()),
        ("subject", Name()),
        ("subjectPublicKeyInfo", SubjectPublicKeyInfo()),
        ("issuerUniqueID", UniqueIdentifier(impl=tag_ctxp(1), optional=True)),
        ("subjectUniqueID", UniqueIdentifier(impl=tag_ctxp(2), optional=True)),
        ("extensions", Extensions(expl=tag_ctxc(3), optional=True)),
    )
Nicméně, PyDERASN má podobu striktní typizace. V pyasn1, pokud pole mělo typ CMSVersion(INTEGER), bylo možné mu přiřadit int nebo INTEGER. PyDERASN striktně vyžaduje, aby přiřazovaný objekt byl právě CMSVersion. Kromě toho, že píšeme kód v Python3, používáme také , takže v našich funkcích budou jasné argumenty jako def func(serial, contents), místo def func(serial: CertificateSerialNumber, contents: EncapsulatedContentInfo), a PyDERASN pomáhá udržovat takový kód.
Přitom v PyDERASN existují velmi pohodlné úlevy této samotné typizace. pyasn1 nedovoloval v SubjectKeyIdentifier().subtype(implicitTag=Tag(…)) přiřadit pole objektu SubjectKeyIdentifier() (bez požadovaného IMPLICIT TAG-u) a často bylo nutné kopírovat a znovu vytvářet objekty jen kvůli změněným IMPLICIT/EXPLICIT tagům. PyDERASN striktně sleduje pouze základní typ — tagy automaticky doplní z již existujícího schématu struktury ASN.1. To výrazně zjednodušuje kód aplikací.
Pokud dojde k chybě během dekódování, v pyasn1 není snadné pochopit, kde přesně se vyskytla. Například u výše zmíněného tureckého certifikátu dostaneme takovou chybu: UTF8String (tbsCertificate:issuer:rdnSequence:3:0:value:DEFINED BY 2.5.4.10:utf8String) (at 138) unsatisfied bounds: 1 ⇐ 77 ⇐ 64 Při psaní struktur ASN.1 mohou lidé chybovat a to usnadňuje ladění aplikací nebo zjišťování problémů zakódovaných dokumentů opačného subjektu.
V první verzi PyDERASN nebyla podpora pro BER-kódování. Ta se objevila mnohem později a dosud není podporována zpracování UTCTime/GeneralizedTime s časovými pásmy. To přijde v budoucnu, neboť projekt je psán převážně ve volném čase od práce.
Ve verzi 1 také nebyla podpora polí DEFINED BY. Po několika měsících se tato a začala být aktivně používána, což výrazně zkrátilo kód aplikací — jednou dekódovací operací bylo možné získat celou strukturu rozebranou do nejhlubších detailů. K tomu se v schématu určují, která pole co „definují“. Například popis schématu CMS:
class ContentInfo(Sequence):
    schema = (
        ("contentType", ContentType(defines=((("content",), {
            id_authenticatedData: AuthenticatedData(),
            id_digestedData: DigestedData(),
            id_encryptedData: EncryptedData(),
            id_envelopedData: EnvelopedData(),
            id_signedData: SignedData(),
        }),))),
        ("content", Any(expl=tag_ctxc(0))),
    )
znamená, že pokud contentType bude obsahovat OID s hodnotou id_signedData, pak pole content (nacházející se ve stejné SEQUENCE) je třeba dekódovat podle schématu SignedData. Proč tolik závorek? Pole může „definovat“ více polí najednou, jak je to běžné ve strukturách EnvelopedData. Určená pole se identifikují pomocí tzv. decode path — to určuje přesné umístění jakéhokoli prvku ve všech strukturách.
Někdy není možné nebo není chuť tyto defines hned do schématu zahrnout. Může existovat application-specific případ, kdy OID a struktury jsou známy pouze ve třetím projektu. PyDERASN poskytuje možnost zadávat tyto defines přímo v okamžiku dekódování struktury:
ContentInfo().decode(data, ctx={"defines_by_path": ((
    (
        "content", DecodePathDefBy(id_signedData),
        "certificates", any, "certificate", "tbsCertificate",
        "extensions", any, "extnID",
    ),
    ((("extnValue",), {
        id_ce_authorityKeyIdentifier: AuthorityKeyIdentifier(),
        id_ce_basicConstraints: BasicConstraints(),
        [...]
        id_ru_subjectSignTool: SubjectSignTool(),
    }),),
),)})
Zde říkáme, že v CMS SignedData pro všechny přiložené certifikáty dekódovat všechna jejich rozšíření (AuthorityKeyIdentifier, BasicConstraints, SubjectSignTool atd.). Uvádíme skrze decode path, kterému prvku je třeba „podstrčit“ defines, jako by bylo určeno ve schématu.
Nakonec PyDERASN má možnost práce z pro dekódování ASN.1 souborů a má bohaté . Můžete dekódovat libovolný ASN.1, nebo můžete zadat přesně určené schéma a vidět něco podobného:
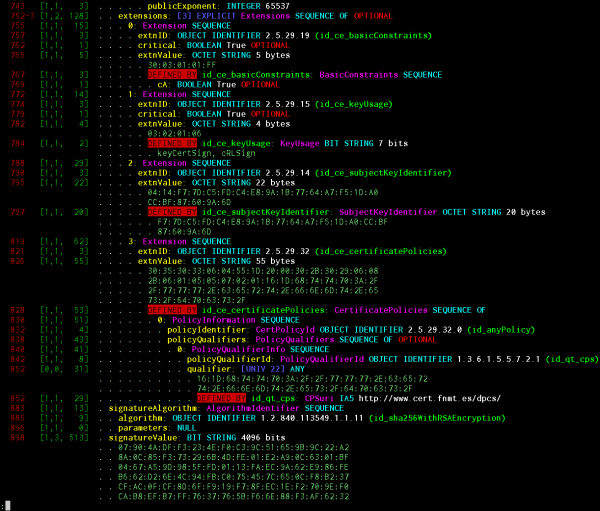
Zobrazované informace: offset objektu, délka tagu, délka obsahu, přítomnost EOC (end-of-octets), indikátor BER kódování, indikátor kódování s neurčitou délkou, délka a offset EXPLICIT tagu (pokud existuje), hloubka vnoření objektu ve strukturách, IMPLICIT/EXPLICIT hodnota tagu, název objektu podle schématu, jeho základní ASN.1 typ, pořadové číslo uvnitř SEQUENCE/SET OF, hodnota CHOICE (pokud existuje), čitelný název INTEGER/ENUMERATED/BIT STRING podle schématu, hodnota jakéhokoli základního typu, DEFAULT/OPTIONAL flag ze schématu, indikátor, že objekt byl automaticky dekódován jako DEFINED BY a za kterým OID to bylo, čitelný OID.
Systém pretty printingu je navržen tak, aby generoval sekvenci PP objektů, které se vizualizují pomocí jednotlivých nástrojů. Na screenshotu je zobrazen renderer v jednoduchém barevném textu. Existují také rendery ve formátu JSON/HTML, aby bylo možné to vidět s podsvícením v prohlížeči ASN.1, jako v projektu.
Další knihovny
To nebylo cílem, ale PyDERASN se ukázal jako podstatně než pyasn1. Například dekódování CRL souborů o velikosti megabajtů může trvat tak dlouho, že budeme muset uvažovat o meziformátech pro rychlé ukládání dat a změnit architekturu aplikací. Pyasn1 dekóduje CRL na mém notebooku více než 20 minut, zatímco PyDERASN trvá pouze 28 sekund! Existuje projekt , zaměřený na rychlou práci s kryptografickými strukturami: dekóduje (úplně, ne líně) tento stejný CRL za 29 sekund, ale při spuštění pod Python3 spotřebovává téměř dvakrát více paměti (983 MiB oproti 498), a 3,5krát více pod Python2 (1677 oproti 488), zatímco pyasn1 spotřebovává ohromující 4,3krát více (2093 oproti 488).
asn1crypto, o kterém jsem mluvil, jsme nezkoumali, protože projekt teprve začínal a neslyšeli jsme o něm. Nyní bychom se na něj také nedívali, protože jsem okamžitě zjistil, že stejný GeneralizedTime nepřijímá libovolný formát, a při serializaci tiše odstraní zlomky sekund. To je přípustné pro práci s X.509 certifikáty, ale obecně to nebude vyhovovat.
V současné době je PyDERASN nejpřísnější z volně dostupných Python/Go DER dekodérů, které znám. V encoding/asn1 knihovně mé oblíbené Go IDENTIFIKÁTOR OBJEKTU a UTCTime/GeneralizedTime řetězce. Striktnost může někdy překážet (především kvůli zpětné kompatibilitě se starými aplikacemi, které nikdo nebude opravovat), proto lze při dekódování v PyDERASN předat slabší kontroly.
Kód projektu se snaží být co nejjednodušší. Celá knihovna je jeden soubor. Kód je napsán s důrazem na snadné porozumění, bez zbytečných optimalizací výkonu a DRY kódu. Neobsahuje, jak už jsem zmínil, plnou podporu pro BER dekódování UTCTime/GeneralizedTime řetězců, stejně jako REAL, RELATIVE OID, EXTERNAL, INSTANCE OF, EMBEDDED PDV, CHARACTER STRING typy dat. Ve všech ostatních případech osobně nevidím smysl používat v Pythonu jiné knihovny.
Jak všechny moje projekty, typu , , , , PyDERASN je zcela , distribuovaný pod podmínkami , a je dostupný k bezplatnému stažení. Příklady použití jsou a v .
, , člen , Python/Go vývojář, hlavní odborník .
Zdroj: habr.com
