

V Zkoumali jsme clustering RabbitMQ pro zajištění odolnosti a vysoké dostupnosti. Nyní se podíváme důkladněji na Apache Kafka.
Jednotkou replikace je zde partition. Každý topic má jeden nebo více partitionů. Každý partition má leadera s followerem nebo bez něj. Při vytváření topicu se udává počet partitionů a koeficient replikace. Obvyklá hodnota 3 znamená tři repliky: jednoho leadera a dva followery.
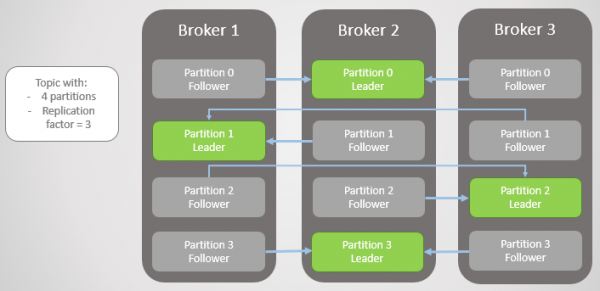
Obr. 1. Čtyři partitiony jsou rozloženy mezi třemi brokery
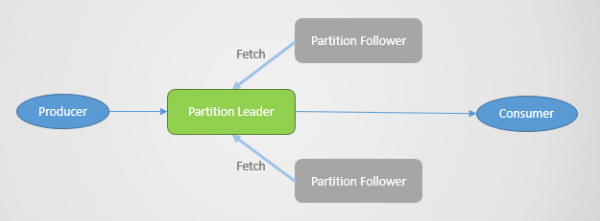
Všechny požadavky na čtení a zápis směřují k leaderovi. Followeři pravidelně posílají leaderovi požadavky na získání posledních zpráv. Spotřebitelé se nikdy neobrací na followery, ti existují pouze pro redundanci a odolnost.
Výpadek partitionu
Když broker vypadne, často selhávají leaderové několika partitionů. V každém z nich se leaderem stává follower z jiného uzlu. Ve skutečnosti to tak není vždy, protože faktory synchronizace hrají roli: existují synchronizovaní followeři, a pokud ne, je povolen přechod na nesynchronizovanou repliku. Ale zatím nebudeme komplikovat.
Z sítě odchází broker 3 — a pro partition 2 je zvolen nový leader na brokeru 2.
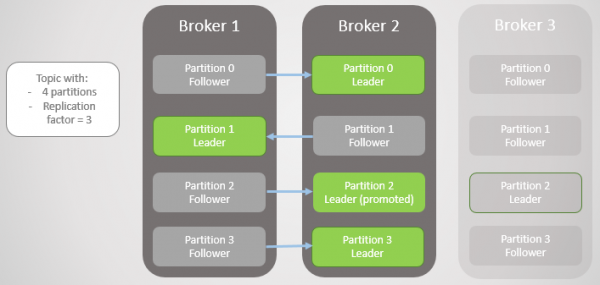
Obr. 2. Broker 3 umírá, a jeho follower na brokeru 2 je zvolen novým leaderem partitionu 2
Pak odchází broker 1 a partition 1 také ztrácí svého leadera, jehož roli přebírá broker 2.
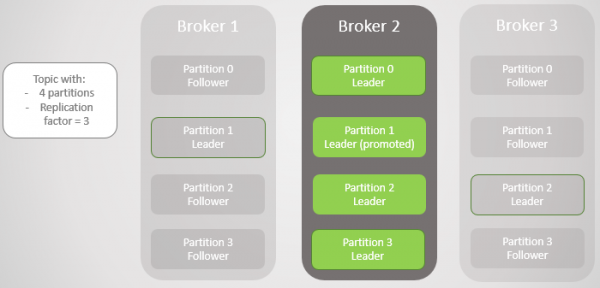
Obr. 3. Zůstal pouze jeden broker. Všichni leaderové jsou na jednom brokeru s nulovou redundancí
Když se broker 1 vrací do sítě, přidává čtyři followery, čímž zajišťuje určitou redundanci každému partitionu. Ale všichni leaderové zůstávají na brokeru 2.
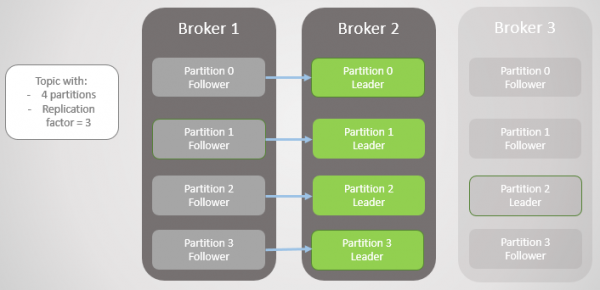
Obr. 4. Leaderové zůstávají na brokeru 2
Když se broker 3 znovu spustí, vracíme se k třem replikám na partitionu. Ale všichni leaderové stále zůstávají na brokeru 2.
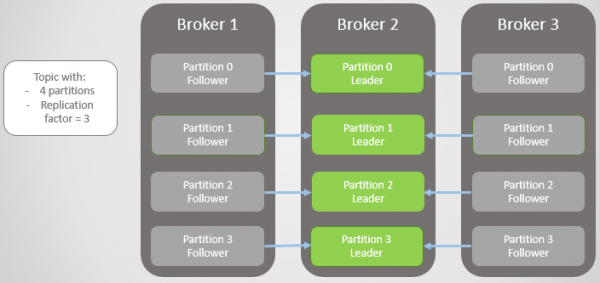
Obr. 5. Nevyvážené umístění leaderů po obnovení brokerů 1 a 3
Kafka má nástroj pro kvalitnější přebalancování leaderů než RabbitMQ. Tam bylo nutné použít externí plugin nebo skript, který měnil politiky pro migraci hlavního uzlu na úkor snížení redundance během migrace. Kromě toho bylo třeba se u velkých front smířit s nedostupností během synchronizace.
V Kafka existuje koncept „preferovaných replik“ pro roli lídra. Když se vytvářejí části tématu, Kafka se snaží rovnoměrně rozdělit lídry mezi uzly a označuje tyto první lídry jako preferované. V průběhu času, kvůli restartu serverů, selháním a poruchám konektivity, se lídři mohou ocitnout na jiných uzlech, jak bylo uvedeno výše v extrémním případě.
Aby to napravila, Kafka nabízí dvě možnosti:
- Volba auto.leader.rebalance.enable=true umožňuje kontrolnímu uzlu automaticky přeřadit lídry zpět na preferované repliky a tím obnovit rovnoměrné rozdělení.
- Správce může spustit skript kafka-preferred-replica-election.sh pro ruční přeřazení.
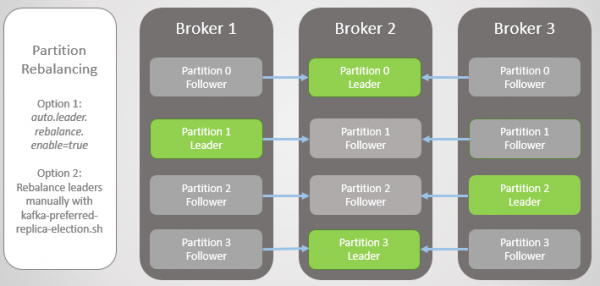
Obrázek 6. Repliky po přebalancování
Jednalo se o zjednodušenou verzi selhání, ale skutečnost je složitější, i když zde není nic příliš komplikovaného. Vše se odvíjí od synchronizovaných replik (In-Sync Replicas, ISR).
Synchronizované repliky (ISR)
ISR je sada replik části, která je považována za „synchronizovanou“ (in-sync). Existuje zde lídr a nemusí být žádní followerové. Follower je považován za synchronizovaného, pokud přesně zkopíroval všechny zprávy lídra před uplynutím intervalu replica.lag.time.max.ms.
Follower je odstraněn ze skupiny ISR, pokud:
- neprovedl požadavek na vytažení během intervalu replica.lag.time.max.ms (považován za mrtvého)
- nestihl se aktualizovat během intervalu replica.lag.time.max.ms (považován za pomalého)
Followerové provádějí požadavky na vytažení během intervalu replica.fetch.wait.max.ms, který má ve výchozím nastavení hodnotu 500 ms.
Abychom jasně vysvětlili účel ISR, musíme se podívat na potvrzení od výrobce (producer) a některé scénáře selhání. Výrobci mohou zvolit, kdy broker odešle potvrzení:
- acks=0, potvrzení se neodesílá
- acks=1, potvrzení se odesílá poté, co lídr zapíše zprávu do svého lokálního logu
- acks=all, potvrzení se odesílá poté, co všechny repliky v ISR zapsaly zprávu do svých lokálních logů
V terminologii Kafka, pokud ISR uchoval zprávu, dojde k jejímu „commitování“. Acks=all je nejbezpečnější možností, ale má i vyšší zpoždění. Zvážíme dva příklady selhání a jak různé možnosti ‘acks’ interagují s konceptem ISR.
Acks=1 a ISR
V tomto příkladu uvidíme, že pokud vůdce nečeká na potvrzení každé zprávy od všech followerů, může při selhání vůdce dojít ke ztrátě dat. Přechod k nesynchronizovanému followerovi může být povolen nebo zakázán nastavením unclean.leader.election.enable.
V tomto příkladu výrobce nastavuje hodnotu acks=1. Rozdělení je rozloženo na všechny tři brokery. Broker 3 zaostává, synchronizoval se s vůdcem před osmi sekundami a nyní zaostává o 7456 zpráv. Broker 1 zaostává pouze o jednu sekundu. Náš výrobce odesílá zprávu a rychle obdrží zpět ack, bez zbytečného zatížení ze strany pomalých nebo mrtvých followerů, na které vůdce nečeká.
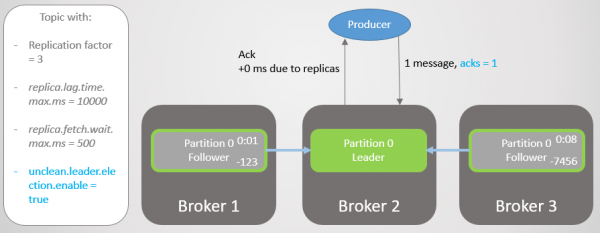
Obr. 7. ISR se třemi replikami
Broker 2 selže a výrobce obdrží chybu připojení. Po přechodu vedení k brokeru 1 ztrácíme 123 zpráv. Follower na brokeru 1 byl v ISR, ale nebyl plně synchronizován s vůdcem, když ten selhal.
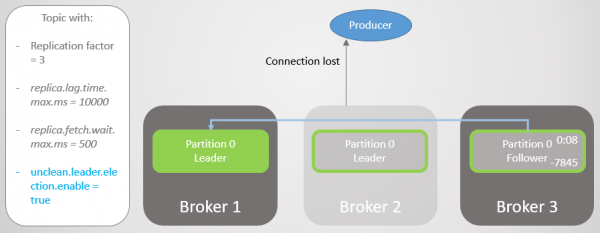
Obr. 8. Při selhání se ztrácejí zprávy
V konfiguraci bootstrap.servers je několik brokerů uvedeno u výrobce, a může se zeptat jiného brokera, kdo se stal novým vůdcem rozdělení. Poté se připojuje k brokeru 1 a pokračuje v odesílání zpráv.
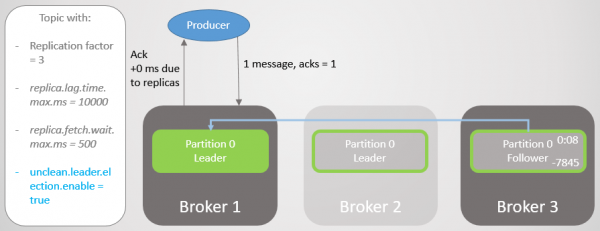
Obr. 9. Odesílání zpráv se obnovuje po krátké pauze
Broker 3 ještě více zaostává. Provádí dotazy na vyžádání, ale nemůže se synchronizovat. To může být způsobeno pomalým síťovým připojením mezi brokery, problémy se skladováním atd. Je odstraněn z ISR. Nyní je ISR složen pouze z jedné repliky — vůdce! Výrobce pokračuje v odesílání zpráv a dostává potvrzení.
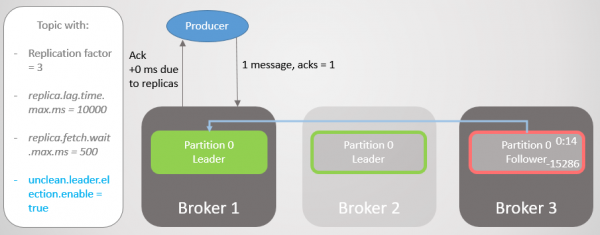
Obr. 10. Follower na brokeru 3 je odstraněn z ISR
Broker 1 selže a role vůdce přechází na broker 3 se ztrátou 15286 zpráv! Výrobce obdrží zprávu o chybě připojení. Přechod k vůdci mimo ISR byl možný pouze díky nastavení unclean.leader.election.enable=true. Pokud je nastavena na false, k přechodu by nedošlo a všechny požadavky na čtení a zápis by byly odmítnuty. V tomto případě čekáme na návrat brokera 1 s jeho nedotčenými daty v replikaci, která opět převezme vedení.
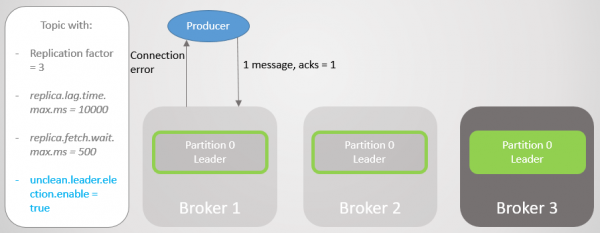
Obr. 11. Broker 1 selhává. Při selhání dochází k velké ztrátě zpráv.
Výrobce se připojuje k poslednímu brokerovi a vidí, že ten je nyní lídrem sekce. Začíná posílat zprávy brokerovi 3.
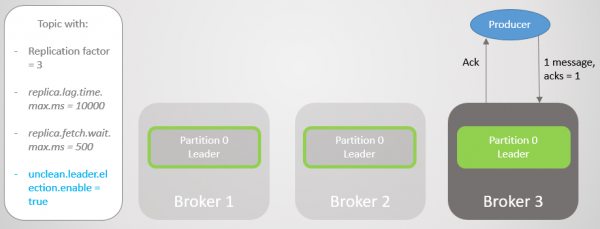
Obr. 12. Po krátké pauze se zprávy znovu posílají do sekce 0
Viděli jsme, že kromě krátkých přerušení pro nastavování nových připojení a hledání nového lídra výrobce neustále posílal zprávy. Tato konfigurace zajišťuje dostupnost na úkor konzistence (bezpečnosti dat). Kafka ztratila tisíce zpráv, ale pokračovala v přijímání nových záznamů.
Acks=all a ISR
Pojďme si tento scénář zopakovat ještě jednou, ale s acks=all. Zpoždění brokeru 3 je v průměru čtyři sekundy. Výrobce posílá zprávu s acks=all, a nyní nedostává rychlou odpověď. Lídrovi trvá, než počká, až zprávu uloží všechny repliky v ISR.
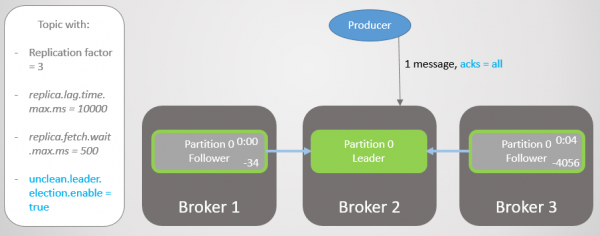
Obr. 13. ISR se třemi replikami. Jedna pracuje pomalu, což vede ke zpoždění zápisu
Po čtyřech sekundách dodatečného zpoždění broker 2 odešle ack. Všechny repliky jsou nyní plně aktualizovány.
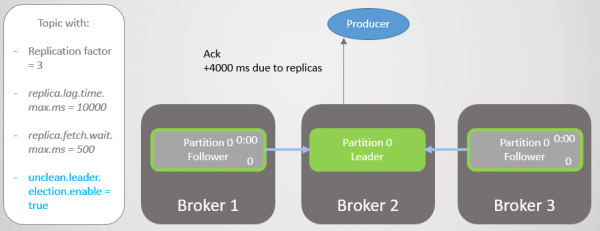
Obr. 14. Všechny repliky uchovávají zprávy a posílají ack
Broker 3 nyní zůstává pozadu ještě více a je odstraněn z ISR. Zpoždění se výrazně snižuje, protože v ISR již nezůstaly pomalé repliky. Broker 2 nyní čeká pouze na brokera 1, jehož průměrné zpoždění je 500 ms.
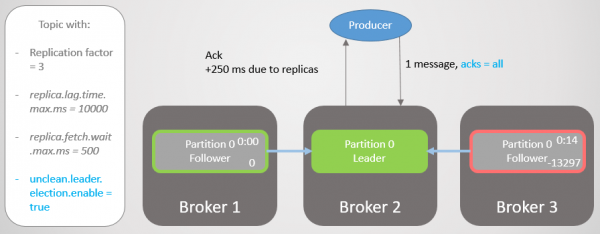
Obr. 15. Replika na brokeru 3 je odstraněna z ISR
Poté dojde k pádu brokera 2, a vedení přechází k brokeru 1 bez ztráty zpráv.
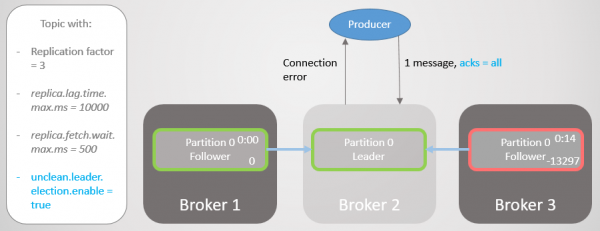
Obr. 16. Broker 2 selhává
Výrobce najde nového lídra a začne mu posílat zprávy. Zpoždění se dále snižuje, protože nyní se ISR skládá z jedné repliky! Proto možnost acks=all nepřidává redundanci.
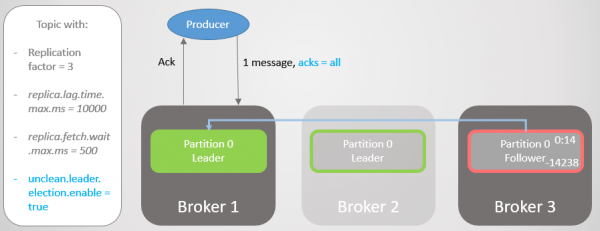
Obr. 17. Replika na brokeru 1 přebírá vedení bez ztráty zpráv
Následně dojde k pádu brokera 1 a vedení přechází k brokeru 3 se ztrátou 14238 zpráv!
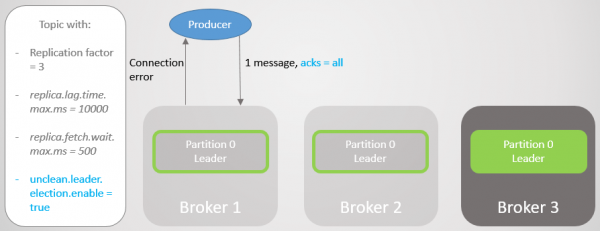
Obr. 18. Broker 1 umírá, a přechod vedení s nastavením unclean vede k rozsáhlé ztrátě dat
Mohli bychom nenastavovat možnost unclean.leader.election.enable na hodnotu true. Ve výchozím nastavení je nastavena na false. Nastavení acks=all s unclean.leader.election.enable=true zajišťuje dostupnost s určitou dodatečnou bezpečností dat. Jak vidíte, stále však můžeme ztratit zprávy.
Ale co když chceme zvýšit bezpečnost dat? Můžeme nastavit unclean.leader.election.enable = false, ale to nemusí zabránit ztrátě dat. Pokud vůdce tvrdě padne a s sebou si vezme data, zprávy jsou stejně ztraceny, plus dostupnost je ztracena, dokud administrátor situaci neobnoví.
Je lepší zajistit redundantnost všech zpráv, nebo jinak se záznamu vzdát. Pak je z hlediska brokera ztráta dat možná pouze při dvou nebo více současných selháních.
Acks=all, min.insync.replicas a ISR
S konfigurací tématu min.insync.replicas zvyšujeme úroveň zabezpečení dat. Pojďme se znovu podívat na poslední část minulého scénáře, ale tentokrát s min.insync.replicas=2.
Takže broker 2 má vůdce repliky a sledovač na brokeru 3 byl odstraněn z ISR.
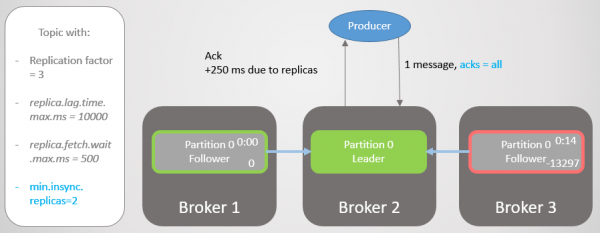
Obr. 19. ISR ze dvou replik
Broker 2 selže a vůdcovství přechází na broker 1 bez ztráty zpráv. Ale nyní ISR se skládá pouze z jedné repliky. To neodpovídá minimálnímu počtu pro záznamy, a proto broker odpovídá na pokus o záznam chybou NotEnoughReplicas.
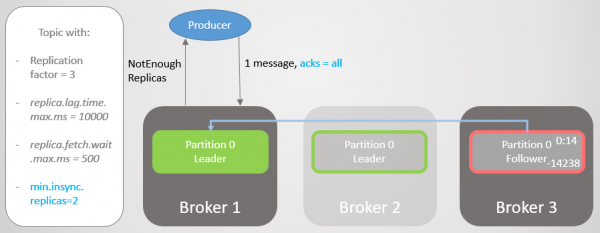
Obr. 20. Počet ISR je o jeden nižší než uvedeno v min.insync.replicas
Tato konfigurace obětuje dostupnost ve prospěch konzistence. Než potvrdíme zprávu, zajišťujeme, že je zapsána alespoň na dvou replikách. To dává výrobci mnohem větší jistotu. Zde je ztráta zpráv možná pouze v případě současného selhání dvou replik během krátkého intervalu, dokud zpráva není replikována dalšímu sledovači, což je nepravděpodobné. Ale pokud jste superparanoik, můžete nastavit poměr replikace na 5 a min.insync.replicas na 3. Najednou musí tři brokery zkolabovat, aby záznam ztratil! Samozřejmě za takovou spolehlivost zaplatíte dodatečnou prodlevou.
Když je dostupnost nezbytná pro bezpečnost dat
Stejně jako v , občas je dostupnost nezbytná pro bezpečnost dat. Musíte přemýšlet o následujícím:
- Může publisher jednoduše vrátit chybu a nadřazená služba nebo uživatel to zkusit znovu později?
- Může publisher uložit zprávu lokálně nebo do databáze, aby to zkusil znovu později?
Pokud je odpověď záporná, zlepšení dostupnosti zvyšuje bezpečnost dat. Ztratíte méně dat, pokud zvolíte dostupnost místo zrušení zápisu. Takže vše spočívá v hledání rovnováhy a rozhodnutí závisí na konkrétní situaci.
Význam ISR
Sada ISR umožňuje zvolit optimální rovnováhu mezi bezpečností dat a latencí. Například zajistit dostupnost v případě selhání většiny replik, přičemž se minimalizuje vliv mrtvých nebo pomalých replik z hlediska latence.
My sami vybíráme hodnotu replica.lag.time.max.ms podle svých potřeb. V podstatě tento parametr znamená, jakou latenci jsme ochotni akceptovat při acks=all. Výchozí hodnota je deset sekund. Pokud je to pro vás příliš dlouho, můžete ji zkrátit. Poté se zvýší frekvence změn v ISR, protože se followeři budou častěji odstraňovat a přidávat.
V RabbitMQ jde pouze o sadu zrcadel, která je třeba replikovat. Pomalá zrcadla přinášejí dodatečnou latenci a na odpověď mrtvých zrcadel můžete čekat až do vypršení doby životnosti paketů, které kontrolují dostupnost každého uzlu (net tick). ISR je zajímavý způsob, jak se vyhnout těmto problémům s výše uvedenou latencí. Riskujeme však ztrátu redundance, protože ISR může být snížena pouze na lídra. Abyste se tomuto riziku vyhnuli, použijte nastavení min.insync.replicas.
Záruka připojení klientů
V nastavení bootstrap.servers výrobce a spotřebitele můžete uvést několik brokerů pro připojení klientů. Myšlenkou je, že pokud dojde k výpadku jednoho uzlu, zůstává několik záložních, se kterými může klient navázat spojení. Nemusí to být nutně lídři oddělení, ale jen základna pro počáteční načtení. Klient se může zeptat, na kterém uzlu je umístěn lídr oddělení pro čtení/zápis.
V RabbitMQ se klienti mohou připojit k libovolnému uzlu a interní směrování odešle požadavek tam, kam je třeba. To znamená, že můžete nastavit před RabbitMQ vyrovnávač zátěže. Kafka vyžaduje, aby se klienti připojili k uzlu, na kterém je umístěn lídr příslušného oddělení. V takové situaci nelze umístit vyrovnávač zátěže. Seznam bootstrap.servers je kriticky důležitý, aby se klienti mohli obracet na potřebné uzly a najít je po selhání.
Architektura konsensu Kafka
Dosud jsme se nezabývali tím, jak cluster zjistí, že došlo k selhání brokera, a jak je vybrán nový lídr. Abychom pochopili, jak Kafka pracuje s síťovými děleními, musíme nejprve pochopit architekturu konsensu.
Každý cluster Kafka je nasazen spolu s clusterem Zookeeper — to je služba distribuovaného konsensu, která umožňuje systému dosáhnout konsensu o určitém stanoveném stavu s prioritou na konzistenci před dostupností. Pro schválení operací čtení a zápisu je zapotřebí souhlas většiny uzlů Zookeeper.
Zookeeper uchovává stav clusteru:
- Seznam témat, segmentů, konfiguraci, aktuální repliky lídra, preferované repliky.
- Členové clusteru. Každý broker pingá clusteru Zookeeper. Pokud nedostane ping během stanoveného časového období, Zookeeper zaznamená brokera jako nedostupného.
- Výběr hlavních a záložních uzlů pro kontroler.
Kontroler uzlu — je jedním z brokerů Kafka, který je zodpovědný za volbu lídrů replik. Zookeeper posílá kontroleru oznámení o členství v clusteru a změnách témat, a kontroler musí jednat podle těchto změn.
Například vezměte nové téma s deseti segmenty a koeficientem replikace 3. Kontroler musí vybrat lídra každého segmentu s cílem optimálně rozložit lídry mezi brokery.
Pro každý segment kontroler:
- aktualizuje informace v Zookeeper o ISR a lídrovi;
- posílá příkaz LeaderAndISRCommand každému brokerovi, který umisťuje repliku tohoto segmentu, informující brokery o ISR a lídrovi.
Když dojde k pádu brokera s lídrem, Zookeeper posílá oznámení kontroleru, a ten vybírá nového lídra. Opět, kontroler nejprve aktualizuje Zookeeper a poté posílá příkaz každému brokerovi, upozorňující je na změnu vedení.
Každý lídr nese odpovědnost za sadu ISR. Nastavení replica.lag.time.max.ms určuje, kdo do ní vstoupí. Při změně ISR lídr předává Zookeeper nové informace.
Zookeeper je vždy informován o jakýchkoli změnách, aby v případě selhání vedení hladce přešlo k novému lídrovi.
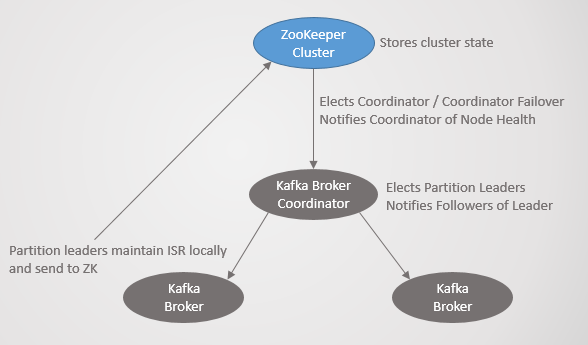
Obr. 21. Konsensus Kafka
Protokol replikace
Pochopení detailů replikace pomáhá lépe chápat potenciální scénáře ztráty dat.
Žádosti o získání, Log End Offset (LEO) a Highwater Mark (HW)
Prozkoumali jsme, že followeři občas posílají vůdci žádosti na načtení (fetch). Výchozí interval je 500 ms. To se liší od RabbitMQ, protože v RabbitMQ replikace není iniciována zrcadlem fronty, ale vůdcem. Vůdce posílá změny na zrcadla.
Vůdce a všichni followeři uchovávají offset konce logu (Log End Offset, LEO) a značku Highwater (HW). Značka LEO uchovává offset poslední zprávy v lokální replikaci, zatímco HW ukládá offset posledního potvrzení. Pamatujte, že pro stav „potvrzeno“ musí být zpráva uložena ve všech replikách ISR. To znamená, že LEO obvykle mírně předbíhá HW.
Když vůdce obdrží zprávu, uloží ji lokálně. Followeři provádějí žádost na načtení, předávajíce svůj LEO. Pak vůdce posílá balíček zpráv počínaje tímto LEO a předává aktuální HW. Když vůdce dostane informace, že všechny repliky uložily zprávu se zadaným offsetem, posune značku HW. Pouze vůdce může posunout HW, a tak se všichni followeři dozvědí aktuální hodnotu v odpovědích na své žádosti. To znamená, že followeři mohou zaostávat za vůdcem, jak ve zprávách, tak co se týče znalosti HW. Spotřebitelé dostávají zprávy pouze do aktuálního HW.
Všimněte si, že „uložený“ (persisted) znamená, že je zapsaný v paměti, nikoli na disk. Pro výkon, Kafka provádí synchronizaci na disk s určitým intervalem. RabbitMQ má také takový interval, ale pošle potvrzení vydavateli až poté, co vůdce a všechna zrcadla zapíší zprávu na disk. Vývojáři Kafky se rozhodli, z důvodu výkonu, posílat ack, jakmile je zpráva uložena v paměti. Kafka se spoléhá na to, že redundantnost kompenzuje riziko krátkodobého uchovávání potvrzených zpráv jen v paměti.
Selhání vůdce
Když vůdce selže, Zookeeper upozorní kontrolera, který vybere novou repliku vůdce. Nový vůdce nastaví novou značku HW podle svého LEO. Poté obdrží folloři informace o novém vůdci. V závislosti na verzi Kafky si follower zvolí jeden ze dvou scénářů:
- Zkrátí lokální log na známý HW a pošle novému vůdci žádost o zprávy po této značce.
- Pošle dotaz vůdci, aby zjistil HW v okamžiku jeho zvolení vůdcem, a poté zkrátí log na toto posunutí. Poté začne provádět periodické dotazy na vzorkování, počínaje tímto posunutím.
Následovník může potřebovat zkrátit log z následujících důvodů:
- Když dojde k selhání vůdce, první následovník z množiny ISR, registrovaný v Zookeeper, vyhrává volby a stává se vůdcem. Všichni následovníci v ISR, ačkoli jsou považováni za "synchronizované", nemuseli od bývalého vůdce obdržet kopie všech zpráv. Je velmi pravděpodobné, že zvolený následovník nemá nejaktuálnější kopii. Kafka zaručuje, že mezi replikami není nesoulad. Aby se tedy předešlo nesouladu, každý následovník musí zkrátit svůj log na hodnotu HW nového vůdce v okamžiku jeho zvolení. To je další důvod, proč je nastavení acks=all tak důležité pro konzistenci.
- Zprávy jsou pravidelně zapisovány na disk. Pokud všechny uzly clusteru selžou současně, na discích zůstanou repliky s různým posunutím. Je zcela možné, že když se brokery znovu připojí k síti, nový vůdce, který bude zvolen, bude pozadu za svými následovníky, protože byl uložen na disk dříve než ostatní.
Znovu připojení k clusteru
Při znovu připojení k clusteru repliky postupují stejně jako při selhání vůdce: kontrolují replikaci vůdce a zkracují svůj log na jeho HW (v okamžiku zvolení). Na rozdíl od toho RabbitMQ považuje znovu připojené uzly za zcela nové. V obou případech broker zahazuje jakýkoli existující stav. Pokud je použita automatická synchronizace, musí master replikovat veškerý aktuální obsah do nového zrcadla způsobem "ať si celý svět počká". Během této operace master nepřijímá žádné operace čtení nebo zápisu. Tento přístup vytváří problémy ve velkých frontách.
Kafka je distribuovaný log a obecně uchovává více zpráv než fronta RabbitMQ, kde se data z fronty odstraňují po přečtení. Aktivní fronty by měly zůstat relativně malé. Ale Kafka je log s vlastní politikou uchovávání, která může stanovit dobu v dnech či týdnech. Přístup s blokováním fronty a plnou synchronizací je zcela nepřijatelný pro distribuovaný log. Místo toho následovníci Kafka jednoduše ořezávají svůj log na HW vůdce (v momentě jeho zvolení), pokud jejich kopie předstihuje vůdce. V pravděpodobnějším případě, kdy je následovník pozadu, jednoduše začíná požadovat vybrání od svého aktuálního LEO.
Noví nebo znovu připojení následovníci začínají mimo ISR a neúčastní se commitů. Jen pracují vedle skupiny a přijímají zprávy co nejrychleji, dokud nedoženou vůdce a nevstoupí do ISR. Neexistuje zde žádné blokování a není třeba vyhazovat všechny své data.
Narušení soudržnosti
Kafka má více komponentů než RabbitMQ, a proto zde existuje složitější soubor chování, když v klastru dochází k narušení soudržnosti. Ale Kafka byla původně navržena pro klastery, takže řešení jsou velmi dobře promyšlená.
Níže jsou uvedeny některé scénáře narušení soudržnosti:
- Scénář 1. Následovník nevidí vůdce, ale stále vidí Zookeeper.
- Scénář 2. Vůdce nevidí žádného následovníka, ale stále vidí Zookeeper.
- Scénář 3. Následovník vidí vůdce, ale nevidí Zookeeper.
- Scénář 4. Vůdce vidí následovníky, ale nevidí Zookeeper.
- Scénář 5. Následovník je zcela odpojen jak od ostatních uzlů Kafka, tak od Zookeeper.
- Scénář 6. Vůdce je zcela odpojen jak od ostatních uzlů Kafka, tak od Zookeeper.
- Scénář 7. Řídící uzel Kafka nevidí jiný uzel Kafka.
- Scénář 8. Řídící uzel Kafka nevidí Zookeeper.
Pro každý scénář je určeno své chování.
Scénář 1. Následovník nevidí vůdce, ale stále vidí Zookeeper
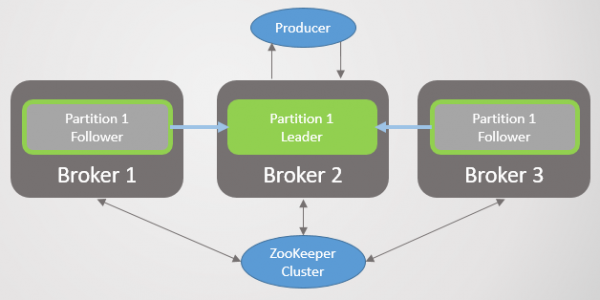
Obrázek 22. Scénář 1. ISR ze tří replik
Narušení soudržnosti odpojuje broker 3 od brokerů 1 a 2, ale ne od Zookeeper. Broker 3 již nemůže odesílat požadavky na vybrání. Po uplynutí doby replica.lag.time.max.ms Odejdou z ISR a neúčastní se commitů. Jakmile je spojení obnoveno, znovu zahájí požadavky na načítání a připojí se k ISR, jakmile dohoní vedoucího. Zookeeper bude nadále přijímat pings a považovat, že broker je živý a zdravý.
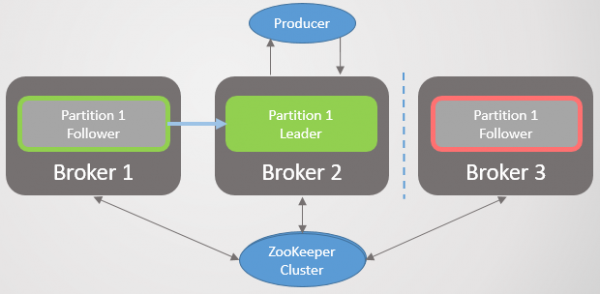
Obr. 23. Scénář 1. Broker je odebrán z ISR, pokud nebyl po určitou dobu požadován na načítání v rámci replica.lag.time.max.ms.
Neexistuje žádné logické rozdělení (split-brain) nebo pozastavení uzlu, jako v RabbitMQ. Místo toho dochází ke snížení redundancy.
Scénář 2. Vedoucí nevidí žádného následovníka, ale stále vidí Zookeepera.
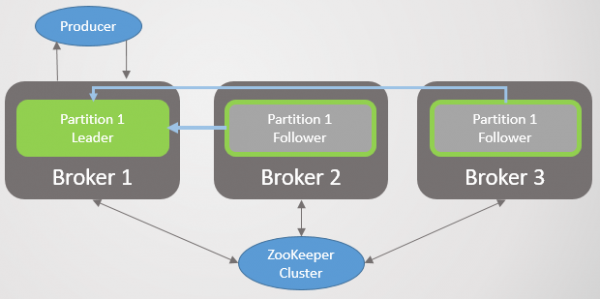
Obr. 24. Scénář 2. Vedoucí a dva následovníci
Přerušení síťového spojení odděluje vedoucího od následovníků, ale broker stále vidí Zookeepera. Stejně jako v prvním scénáři se ISR zmenšuje, ale tentokrát pouze do vedoucího, protože všichni následovníci přestávají posílat požadavky na načítání. Znovu, neexistuje žádné logické rozdělení. Místo toho dochází ke ztrátě redundancy pro nové zprávy, dokud se spojení neobnoví. Zookeeper nepřestává přijímat pings a považuje, že broker je živý a zdravý.
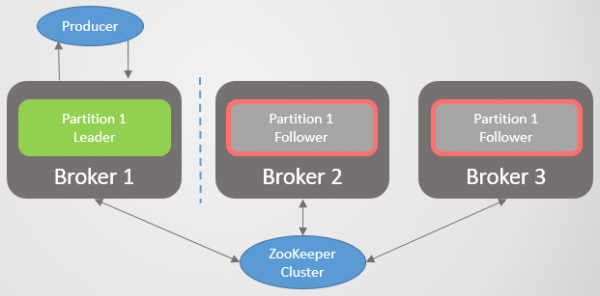
Obr. 25. Scénář 2. ISR se zmenšil pouze na vedoucího.
Scénář 3. Následovník vidí vedoucího, ale nevidí Zookeepera.
Následovník se odděluje od Zookeepera, ale ne od brokera s vedoucím. V důsledku toho následovník pokračuje v provádění požadavků na načítání a zůstává členem ISR. Zookeeper již nepřijímá pings a registruje pád brokera, ale protože to je pouze následovník, po obnovení nejsou žádné následky.
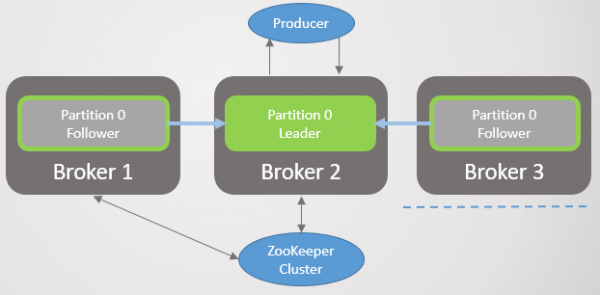
Obr. 26. Scénář 3. Následovník stále posílá vedoucímu požadavky na načítání.
Scénář 4. Vedoucí vidí následovníky, ale nevidí Zookeepera.
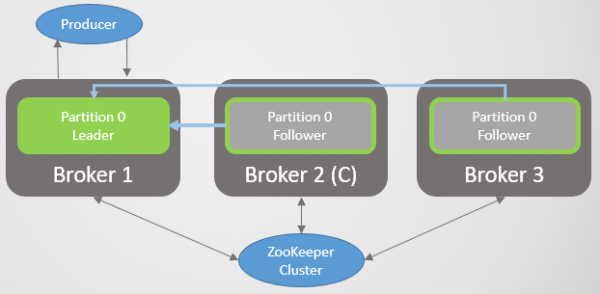
Obr. 27. Scénář 4. Vedoucí a dva následovníci.
Vedoucí je oddělen od Zookeepera, ale ne od brokerů s následovníky.
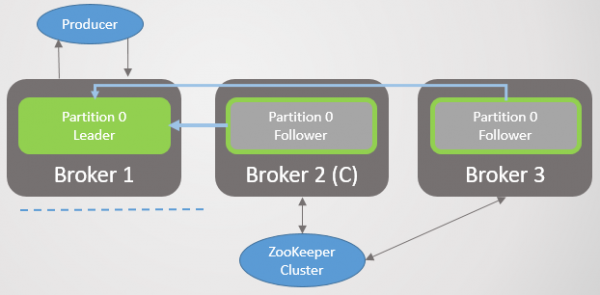
Obr. 28. Scénář 4. Vedoucí izolován od Zookeepera.
Po určité době Zookeeper zaregistruje pád brokera a informuje o tom kontrolní prvek. Ten vybere nového vedoucího mezi následovníky. Přesto původní vedoucí stále považuje, že je vedoucím, a neustále přijímá zápisy s acks=1. Následovníci mu již neposílají požadavky na načítání, a tak je považuje za mrtvé a pokusí se zmenšit ISR na sebe. Ale protože není připojen k Zookeeperovi, nemůže to udělat, a v této chvíli se vzdává dalšího přijímání zápisů.
Zprávy acks=all nedostanou potvrzení, protože ISR nejprve zahrnuje všechny repliky, a než k nim zprávy dorazí. Když se původní líder pokusí je odstranit z ISR, nebude to moci udělat a ve skutečnosti přestane přijímat jakékoli zprávy.
Zákazníci brzy zpozorují změnu vůdce a začnou posílat zápisy na nový server. Jakmile se síť obnoví, původní líder uvidí, že už není vůdcem, a zkrátí svůj log na hodnotu HW, kterou měl nový líder v okamžiku závady, aby se vyhnul nesouladu logů. Pak začne posílat dotazy na vyhledání novému líderovi. Všechny zápisy původního lídra, které nebyly replikovány novému líderovi, se ztratí. To znamená, že budou ztraceny zprávy, které původní líder nepotvrdil v těch několika sekundách, kdy fungovali dva lídři.
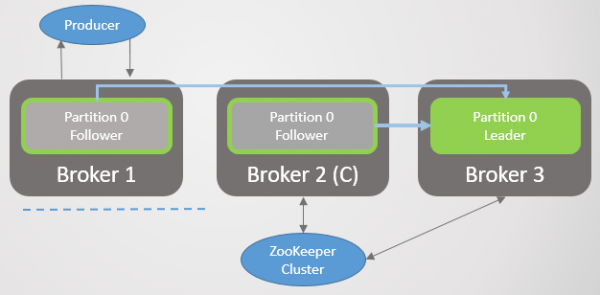
Obr. 29. Scénář 4. Lídr na brokeru 1 se stává followerem po obnovení sítě
Scénář 5. Follower je zcela odpojen jak od ostatních uzlů Kafka, tak od Zookeeperu
Follower je zcela izolován jak od ostatních uzlů Kafka, tak od Zookeeperu. Jednoduše se odstraní z ISR, dokud se síť neobnoví, a pak dožene ostatní.

Obr. 30. Scénář 5. Izolovaný follower se odstraňuje z ISR
Scénář 6. Lídr je zcela odpojen jak od ostatních uzlů Kafka, tak od Zookeeperu
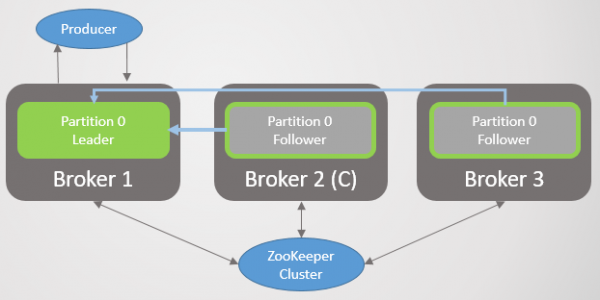
Obr. 31. Scénář 6. Lídr a dva followeři
Lídr je zcela izolován od svých followerů, kontroléru a Zookeeperu. Po krátkou dobu bude stále přijímat zápisy z acks=1.
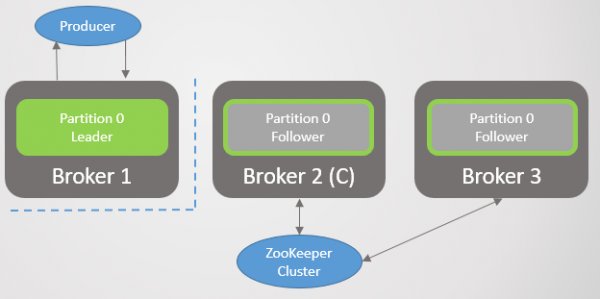
Obr. 32. Scénář 6. Izolace lídra od ostatních uzlů Kafka a Zookeeperu
Nepřijme-li žádné dotazy po uplynutí replica.lag.time.max.ms, pokusí se zkrátit ISR na sebe, ale nebude to moci udělat, protože není spojení se Zookeeperem, a pak přestane přijímat zápisy.
Mezitím Zookeeper označí izolovaného brokera jako mrtvého a kontrolér vybere nového lídra.
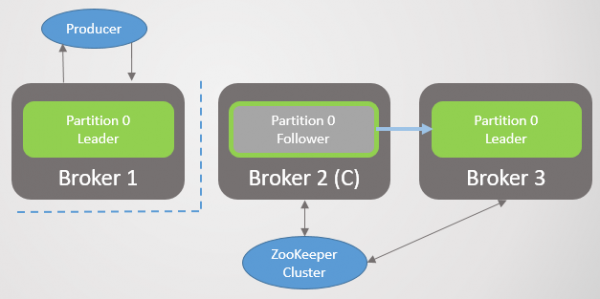
Obr. 33. Scénář 6. Dva lídři
Původní líder může přijímat zápisy po dobu několika sekund, ale poté přestane přijímat jakékoli zprávy. Zákazníci se aktualizují každých 60 sekund s posledními metadata. Budou informováni o změně lídra a začnou posílat zápisy novému líderovi.
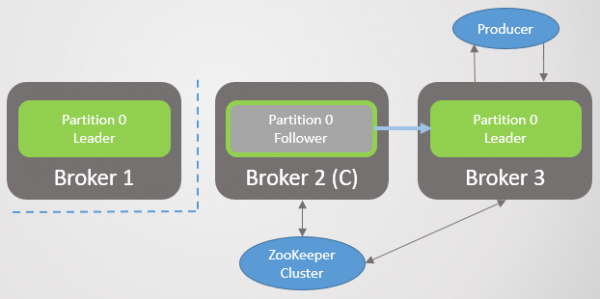
Obr. 34. Scénář 6. Producenti přepínají na nového lídra
Všechny potvrzené záznamy provedené původním lídrem od doby ztráty konektivity budou ztraceny. Jakmile se síť obnoví, původní lídr prostřednictvím Zookeeper zjistí, že už není lídrem. Pak zkrátí svůj log na HW nového lídra v okamžiku jeho zvolení a začne odesílat požadavky jako follower.
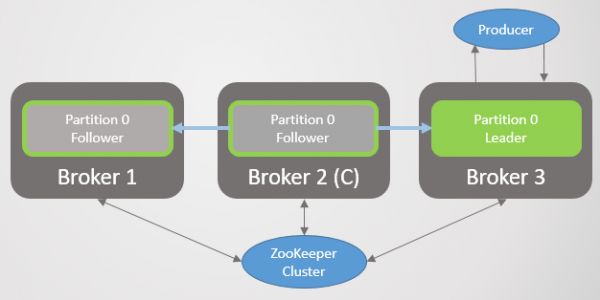
Obr. 35. Scénář 6. Původní lídr se stává followrem po obnovení konektivity sítě
V této situaci může během krátkého období dojít k logickému rozdělení, ale pouze pokud acks=1 a min.insync.replicas také 1. Logické rozdělení se automaticky ukončuje buď po obnovení sítě, kdy původní lídr pochopí, že už není lídrem, nebo kdy všichni klienti pochopí, že lídr se změnil a začnou zapisovat novému lídrovi — v závislosti na tom, co nastane dřív. V každém případě dojde ke ztrátě některých zpráv, ale pouze s acks=1.
Existuje další varianta tohoto scénáře, kdy těsně před rozdělením sítě followři zaostali a lídr zúžil ISR na jednu osobu. Poté se izoluje kvůli ztrátě konektivity. Je zvolen nový lídr, ale původní lídr pokračuje v přijímání záznamů, i když acks=all, protože v ISR kromě něj nikdo jiný není. Tyto záznamy budou ztraceny po obnovení sítě. Jediný způsob, jak se tomuto scénáři vyhnout, je min.insync.replicas = 2.
Scénář 7. Uzlový kontrolér Kafka nevidí další uzel Kafka
Obecně platí, že po ztrátě spojení s uzlem Kafka kontrolér nebude schopen předat žádné informace o změně lídra. V nejhorším případě to povede k krátkodobému logickému rozdělení, jako ve scénáři 6. Většinou broker prostě nebude kandidátem na lídr v případě selhání posledního.
Scénář 8. Kontrolér Kafka nevidí Zookeeper
Od odpojeného kontroléru Zookeeper nedostane ping a vybere nového uzlu Kafka jako kontroléra. Původní kontrolér může nadále představovat sebe jako takového, ale nedostává žádné oznámení od Zookeeper, takže nebude mít žádné úkoly k plnění. Jakmile se síť obnoví, pochopí, že už není kontrolérem, ale stal se běžným uzlem Kafka.
Závěry ze scénářů
Vidíme, že ztráta konektivity followerů nevede k ztrátě zpráv, ale pouze dočasně zmenšuje redundanci, dokud se síť neobnoví. To samozřejmě může vést k ztrátě dat, pokud jsou ztraceny jeden nebo více uzlů.
Pokud se vůdce odpojil od Zookeeperu kvůli ztrátě konektivity, může to vést ke ztrátě zpráv s acks=1. Nedostatek spojení se Zookeeperem způsobuje krátkodobé logické rozdělení se dvěma vůdci. Tento problém řeší parametr acks=all.
Parameter min.insync.replicas s dvěma nebo více replikami poskytuje další záruky, že takové krátkodobé scénáře nevedou ke ztrátě zpráv, jako v scénáři 6.
Shrnutí ztráty zpráv
Vyjmenujme všechny způsoby, jak lze ztratit data v Kafce:
- Jakékoli selhání vůdce, pokud byly zprávy potvrzeny pomocí acks=1
- Jakýkoli nečistý (unclean) přechod vůdcovství, tedy na followery mimo ISR, i s acks=all
- Izolace vůdce od Zookeeperu, pokud byly zprávy potvrzeny pomocí acks=1
- Úplná izolace vůdce, který již zúžil skupinu ISR na sebe. Všechny zprávy budou ztraceny, dokonce i acks=all. To platí pouze v případě, že min.insync.replicas=1.
- Současné selhání všech uzlů partition. Protože zprávy jsou potvrzovány z paměti, některé možná ještě nebyly zapsány na disk. Po restartování serverů může chybět několik zpráv.
Nečistým přechodům vůdcovství se lze vyhnout buď jejich zakázáním, nebo zajištěním redundance alespoň dvou. Nejsilnější konfigurací je kombinace acks=all a min.insync.replicas více než 1.
Přímé srovnání spolehlivosti RabbitMQ a Kafky
Pro zajištění spolehlivosti a vysoké dostupnosti obě platformy implementují systém primární a sekundární replikace. Nicméně RabbitMQ má achilovskou patu. Při znovuspojení po selhání uzly zahazují svá data a synchronizace je blokována. Tento dvojitý úder zpochybňuje trvanlivost velkých front v RabbitMQ. Budete se muset smířit buď se snížením redundance, nebo s dlouhými blokacemi. Snížení redundance zvyšuje riziko hromadné ztráty dat. Pokud jsou však fronty malé, aby se zajistila redundance s krátkými obdobími nedostupnosti (několik sekund), lze se s tím vypořádat pomocí opakovaných pokusů o připojení.
V Kafce takový problém není. Odmítá data pouze z pohledu nesouladu lídra a followera. Všechna společná data jsou uchována. Kromě toho replikace nemění chod systému. Lídr pokračuje v příjmu záznamů, zatímco se nový follower dožene, takže pro DevOps je připojení nebo opětovné připojení k clusteru triviální záležitostí. Samozřejmě i nadále zůstávají problémy, jako je šířka pásma sítě při replikaci. Pokud se zároveň přidá několik followerů, můžete se setkat s limitem šířky pásma.
RabbitMQ převyšuje Kafku v spolehlivosti při současném selhání několika serverů v clusteru. Jak jsme již zmínili, RabbitMQ zasílá publisherovi potvrzení až po zapsání zprávy na disk u hlavního uzlu a všech zrcadlech. To však přidává další zpoždění z dvou důvodů:
- fsync každých několik set milisekund
- Selhání zrcadla lze zaznamenat až po vypršení doby životnosti paketů, které kontrolují dostupnost každého uzlu (net tick). Pokud zrcadlo zpomaluje nebo selže, přidává to zpoždění.
Kafka spoléhá na to, že pokud je zpráva uložena na několika uzlech, lze potvrzovat zprávy, jakmile se dostanou do paměti. Tím se objevuje riziko ztráty zpráv jakéhokoli typu (dokonce acks=all, min.insync.replicy=2) v případě současného selhání.
Celkově Kafka demonstruje vyšší výkonnost a je původně navržena pro clustery. Počet followerů lze zvýšit až na 11, pokud je to potřeba pro spolehlivost. Poměr replikace 5 a minimální počet replik v synchronizovaném stavu min.insync.replicas=3 učiní ztrátu zprávy velmi vzácnou událostí. Pokud vaše infrastruktura dokáže zajistit takový poměr replikace a úroveň redundance, můžete si vybrat tuto možnost.
Klastrování RabbitMQ je dobré pro malé fronty. Ale i malé fronty mohou rychle růst při vysokém zatížení. Jakmile se fronty stanou velkými, budete muset učinit tvrdý výběr mezi dostupností a spolehlivostí. Klastrování RabbitMQ je nejlépe použitelné pro netypické situace, kde výhody flexibility RabbitMQ převyšují jakékoli nevýhody jeho klastrování.
Jedním z protilátek vůči zranitelnosti RabbitMQ v souvislosti s velkými frontami je rozdělit je na mnoho menších. Pokud nepožadujete úplné seřazení celé fronty, ale jen odpovídajících zpráv (například zpráv konkrétního klienta), nebo dokonce nic neřadíte, je tento přístup přijatelný: podívejte se na můj projekt k rozdělení fronty (projekt zatím ve stádiu vývoje).
Nakonec nezapomeňte na řadu chyb v mechanismech clusteringu a replikace jak u RabbitMQ, tak u Kafka. S časem se systémy stávaly zralejšími a stabilnějšími, ale žádná zpráva nikdy nebude na 100% chráněna před ztrátou! Kromě toho se v datových centrech mohou vyskytnout velké havárie!
Pokud jsem něco přehlédl, udělal chybu nebo nesouhlasíte s jakýmkoliv z tvrzení, neváhejte napsat komentář nebo se mnou kontaktovat.
Často se mě ptají: „Co si vybrat, Kafka nebo RabbitMQ?“, „Která platforma je lepší?“. Pravda je taková, že to opravdu závisí na vaší situaci, aktuální zkušenosti atd. Neodvážím se vyjadřovat svůj názor, protože by bylo příliš zjednodušující doporučit nějakou jednu platformu pro všechny případy použití a možné omezení. Napsal jsem tuto sérii článků, abyste si mohli utvořit vlastní názor.
Chci říct, že obě systémy jsou lídry v této oblasti. Možná jsem trochu zaujatý, protože na základě svých zkušeností s projekty více oceňuji takové věci, jako je zaručené pořadí zpráv a spolehlivost.
Vidím jiné technologie, kterým chybí tato spolehlivost a zaručené pořadí, pak se dívám na RabbitMQ a Kafka — a chápu neuvěřitelnou hodnotu obou těchto systémů.
Zdroj: habr.com
