

Překlad článku byl vyhotoven před začátkem kurzu
Distribuované učení na několika vysoce výkonných výpočetních instancích může zkrátit dobu trénování moderních hlubokých neuronových sítí na velkém objemu dat z několika týdnů na hodiny nebo dokonce minuty, což tuto techniku učení činí převládající v otázkách praktického využití hlubokého učení. Uživatelé musí rozumět tomu, jak sdílet a synchronizovat data na několika instancích, což má velký vliv na efektivitu škálování. Kromě toho by uživatelé měli také vědět, jak nasadit tréninkový skript na několika instancích, který funguje na jedné instanci.
V tomto článku se podíváme na rychlý a jednoduchý způsob distribuce učení využívající otevřenou knihovnu pro hluboké učení Apache MXNet a rámec distribuovaného učení Horovod. Jasně ukážeme výhody rámce Horovod v otázkách výkonu a předvedeme, jak napsat tréninkový skript MXNet tak, aby fungoval distribuovaně s Horovod.
Co je Apache MXNet
je otevřený rámec pro hluboké učení, který se používá k vytváření, trénování a nasazení hlubokých neuronových sítí. MXNet abstrahuje složitosti spojené s implementací neuronových sítí, má vysoký výkon a škálovatelnost a také nabízí API pro populární programovací jazyky, jako jsou , , , , , , a další.
Distribuované učení v MXNet se serverem parametrů
používá přístup serveru parametrů (parameter server). Využívá sadu serverů parametrů k shromažďování gradientů od každého pracovníka, provádění agregace a odesílání aktualizovaných gradientů zpět pracovníkům pro další iteraci optimalizace. Stanovení správného poměru serverů k pracovníkům je záznamem efektivního škálování. Pokud je server parametrů pouze jeden, může se stát úzkým hrdlem při provádění výpočtů. A naopak, pokud se používá příliš mnoho serverů, může být spojení „mnozí-k-mnohým“ přetížením všech síťových spojení.
Co je Horovod
– otevřený rámec pro distribuované hluboké učení, vyvinutý společností Uber. Využívá efektivní technologie interakce mezi více GPU a uzly, jako je NVIDIA Collective Communications Library (NCCL) a Message Passing Interface (MPI) pro distribuci a agregaci parametrů modelu mezi pracovními uzly. Optimalizuje využití přenosové šířky sítě a dobře se škáluje při práci s modely hlubokých neuronových sítí. V současnosti podporuje několik populárních rámců strojového učení, a to , Tensorflow, Keras a PyTorch.
Integrace MXNet a Horovod
MXNet se integruje s Horovod prostřednictvím API pro distribuované učení, definovaných v Horovod. V Horovod jsou komunikační API horovod.broadcast(), horovod.allgather() a horovod.allreduce() realizovány pomocí asynchronních zpětných volání rámce MXNet, jako součást jeho úlohy. To umožňuje snadné zpracování datových závislostí mezi komunikací a výpočty, aby se zabránilo ztrátám výkonu způsobeným synchronizací. Objekt distributed optimizer, definovaný v Horovod horovod.DistributedOptimizer rozšiřuje Optimizer v MXNet, tak aby vyžadoval odpovídající API Horovod pro distribuovanou aktualizaci parametrů. Všechny tyto detaily implementace jsou pro koncové uživatele transparentní.
Rychlý start
Můžete rychle začít trénovat malou konvoluční neuronovou síť na datasetu MNIST s pomocí MXNet a Horovod na vašem MacBooku.
Nejprve nainstalujte mxnet a horovod z PyPI:
pip install mxnet
pip install horovod
Poznámka: Pokud se objeví chyba během pip install horovod, možná budete muset přidat proměnnou MACOSX_DEPLOYMENT_TARGET=10.vv, kde vv – to je verze vaší verze MacOS, například, pro MacOSX Sierra budete muset napsat MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Poté nainstalujte OpenMPI .
Na závěr si stáhněte testovací skript mxnet_mnist.py a proveďte následující příkazy v terminálu MacBook ve vašem pracovním adresáři:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyTímto spustíte trénink na dvou jádrech vašeho procesoru. Výstup bude následující:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Ukázka výkonu
Při trénování modelu ResNet50-v1 na datasetu ImageNet na 64 GPU s osmi instancemi p3.16xlarge EC2, z nichž každý obsahuje 8 GPU NVIDIA Tesla V100 na cloudu AWS, jsme dosáhli propustnosti učení 45000 obrázků/sec (tj. počet trénovaných vzorků za sekundu). Učení bylo dokončeno za 44 minut po 90 epochách s nejlepší přesností 75,7%.
Porovnali jsme to s distribuovaným učením MXNet s přístupem využívajícím servery parametrů na 8, 16, 32 a 64 GPU se serverem s jedním parametrem a poměrem serverů k pracovníkům 1:1 a 2:1. Výsledek můžete vidět na Obrázku 1 níže. Na ose y vlevo sloupce odrážejí počet obrázků pro trénink za sekundu, linie odrážejí efektivitu škálování (tj. poměr skutečné propustnosti k ideální) na ose y vpravo. Jak vidíte, výběr počtu serverů ovlivňuje efektivitu škálování. Pokud je server parametrů jeden, efektivita škálování klesá na 38% při 64 GPU. Pro dosažení stejné efektivity škálování jako s Horovod je třeba zdvojnásobit počet serverů vzhledem k počtu pracovníků.
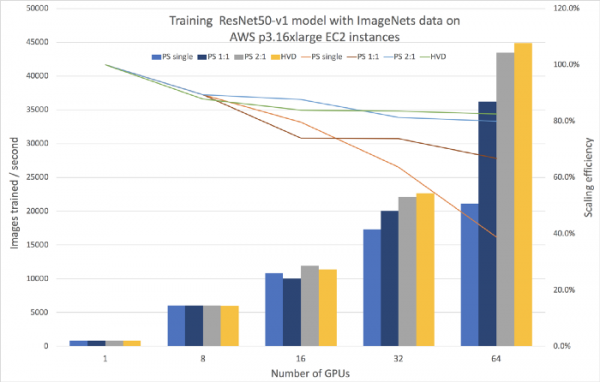
Obrázek 1. Porovnání distribuovaného učení pomocí MXNet s Horovod a se serverem parametrů.
V Tabulce 1 níže jsme porovnali celkové náklady na instanci při provádění experimentů na 64 GPU. Použití MXNet spolu s Horovod zajišťuje nejlepší propustnost při nejnižších nákladech.
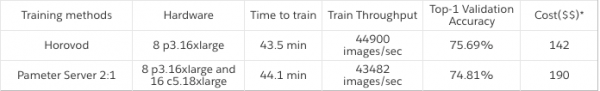
Tabulka 1. Porovnání nákladů mezi Horovod a serverem parametrů s poměrem serverů k pracovníkům 2:1.
Kroky pro reprodukci.
V následujících krocích vám ukážeme, jak reprodukovat výsledky distribuovaného učení pomocí MXNet a Horovod. Chcete-li se dozvědět více o distribuovaném učení s MXNet, přečtěte si .
Krok 1
Vytvořte klastr homogenních instancí s MXNet verze 1.4.0 nebo vyšší a Horovod verze 0.16.0 nebo vyšší, abyste mohli využívat distribuované učení. Budete také potřebovat nainstalovat knihovny pro učení na GPU. Pro naše instance jsme zvolili Ubuntu 16.04 Linux, s ovladačem GPU 396.44, CUDA 9.2, knihovnu cuDNN 7.2.1, komunikační protokol NCCL 2.2.13 a OpenMPI 3.1.1. Můžete také použít , kde jsou tyto knihovny již předinstalovány.
Krok 2
Přidejte do svého tréninkového skriptu MXNet možnost práce s API Horovod. Následující skript založený na MXNet Gluon API můžete použít jako jednoduchou šablonu. Řádky zvýrazněné tučně jsou potřebné, pokud již máte odpovídající tréninkový skript. Zde jsou některé klíčové změny, které je třeba provést pro trénink s Horovod:
- Nastavte kontext podle lokálního ranku Horovod (řádek 8), abyste rozuměli, že trénink probíhá na správném grafickém jádru.
- Předávejte počáteční parametry od jednoho pracovníka ke všem (řádek 18), abyste se ujistili, že všichni pracovníci začínají pracovat se stejnými počátečními parametry.
- Vytvořte Horovod DistributedOptimizer (řádek 25), abyste aktualizovali parametry distribuovaně.
Pro kompletní skript se obraťte na příklady Horovod-MXNet a .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: inicializace Horovod
5  hvd.init()
6
7  # Horovod: přiřaďte GPU k lokálnímu ranku
8  context = mx.gpu(hvd.local_rank())
9
10 # Vytvoření modelu
11 model = ...
12
13 # Inicializace parametrů
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: přenos parametrů
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Vytvoření optimalizátoru
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: obalit optimalizátor s DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Vytvoření trenéra a funkce ztráty
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Trénink modelu
32 for epoch in range(num_epoch):
33    ...
Krok 3
Přihlaste se na jeden z pracovníků pro spuštění distribuovaného trénování pomocí direktivy MPI. V tomto příkladu je distribuované trénování spuštěno na čtyřech instancích se 4 GPU v každé, a celkem 16 GPU v clusteru. Použit bude optimalizátor stochastického gradientního spouštění (SGD) s následujícími hyperparametry:
- mini-batch size: 256
- learning rate: 0.1
- momentum: 0.9
- weight decay: 0.0001
Jak jsme škálovali od jednoho GPU až k 64 GPU, lineárně jsme škálovali rychlost učení podle počtu GPU (od 0,1 pro 1 GPU až po 6,4 pro 64 GPU), přičemž jsme udržovali počet obrázků na jedno GPU na 256 (od batchu s 256 obrázky pro 1 GPU po 16 384 pro 64 GPU). Parametry weight decay a momentum se měnily, jak se zvyšoval počet GPU. Použili jsme smíšenou přesnost učení s datovým typem float16 během dopředného průchodu a float32 pro gradienty, abychom urychlili výpočty float16, podporované GPU NVIDIA Tesla.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Závěr
V tomto článku jsme prozkoumali škálovatelný přístup k distribuovanému učení modelu s použitím Apache MXNet a Horovod. Ukázali jsme efektivitu škálování a ekonomickou efektivnost ve srovnání s přístupem s použitím serveru parametrů na datech ImageNet, na kterých byl model ResNet50-v1 trénován. Také jsme uvedli kroky, pomocí kterých můžete upravit již existující skript pro spuštění učení na více instancích pomocí Horovod.
Pokud s MXNet a hlubokým učením teprve začínáte, přejděte na stránku instalace , abyste nejdříve sestavili MXNet. Také důrazně doporučujeme přečíst si článek , abyste se dostali do obrazu.
Pokud jste již pracovali s MXNet a chcete vyzkoušet distribuované učení s Horovod, podívejte se na , sestavte jej s MXNet a postupujte podle příkladu nebo .
*náklady jsou počítány na základě AWS pro instance EC2
Zjistit více o kurzu
Zdroj: habr.com
