

Ahoj, Habráči. Jak jsme již psali, tento měsíc OTUS spouští hned dva kurzy strojového učení, a to a . V souvislosti s tím pokračujeme v sdílení užitečných materiálů.
Cílem tohoto článku je podělit se o naši první zkušenost s použitím .
Začneme přehledem jeho sledovacího serveru a logujeme všechny iterace výzkumu. Poté se podělíme o zkušenosti s propojením Spark s MLflow pomocí UDF.
Kontext
ITGLOBAL.COM používá strojové učení a umělou inteligenci, aby lidem umožnila starat se o jejich zdraví a pohodu. Proto modely strojového učení leží v základu našich produktů na zpracování dat, a právě proto nás přitáhl MLflow – platforma s otevřeným zdrojem, která pokrývá všechny aspekty životního cyklu strojového učení.
MLflow
Hlavním cílem MLflow je poskytnout dodatečnou vrstvu nad strojovým učením, která by umožnila specialistům na datovou vědu pracovat prakticky s jakoukoli knihovnou strojového učení (, , , , a ), a tím posunout jeho výkon na novou úroveň.
MLflow poskytuje tři komponenty:
- Sledování – záznam a dotazy k experimentům: kód, data, konfigurace a výsledky. Sledujte proces vytváření modelu, je velmi důležité.
- Projekty – formát balení pro nasazení na jakékoli platformě (např. )
- Modely – obecný formát pro odesílání modelů do různých nasazovacích nástrojů.
MLflow (v době psaní tohoto článku ve verzi alpha) je platforma s otevřeným zdrojem, která umožňuje spravovat životní cyklus strojového učení, včetně experimentů, opětovného použití a nasazení.
Nastavení MLflow
Abychom mohli používat MLflow, je nejprve třeba nastavit celé prostředí Python, k tomu využijeme (pro instalaci Pythonu na Mac se podívejte ). Tak budeme moci vytvořit virtuální prostředí, kam nainstalujeme všechny potřebné knihovny pro spuštění.
```
pyenv install 3.7.0
pyenv global 3.7.0 # Použijte Python 3.7
mkvirtualenv mlflow # Vytvořte virtuální prostředí s Pythonem 3.7
workon mlflow
```
Nainstalujeme požadované knihovny.
```
pip install mlflow==0.7.0
            Cython==0.29
            numpy==1.14.5
            pandas==0.23.4
            pyarrow==0.11.0
```
Poznámka: Používáme PyArrow pro spuštění modelů jako UDF. Verze PyArrow a Numpy bylo nutné upravit, protože nejnovější verze si protiřečily.
Spouštíme UI sledování
MLflow Tracking nám umožňuje logovat a dotazovat se na experimenty pomocí Pythonu a API. Kromě toho je možné určit, kde ukládat artefakty modelu (localhost, , , nebo ). V Alpha Health používáme AWS, takže jako úložiště artefaktů bude S3.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow doporučuje používat trvalé souborové úložiště. Souborové úložiště je místo, kde server ukládá metadata běhů a experimentů. Při spuštění serveru se ujistěte, že ukazuje na trvalé souborové úložiště. Zde pro experiment jednoduše využijeme /tmp.
Pamatujte na to, že pokud chceme používat server mlflow k provádění starých experimentů, musí být přítomny v souborovém úložišti. Nicméně i bez toho bychom je mohli použít v UDF, protože potřebujeme pouze cestu k modelu.
Poznámka: Mějte na paměti, že Tracking UI a klient modelu musí mít přístup k umístění artefaktu. To znamená, že nezávisle na tom, že se Tracking UI nachází v instanci EC2, musí mít stroj při místním spuštění MLflow přímý přístup k S3 pro ukládání modelů artefaktů.
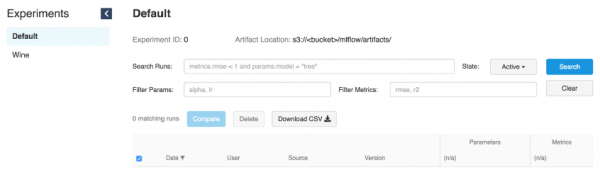
Tracking UI ukládá artefakty do S3 bucketu
Spuštění modelů
Jakmile bude Tracking server v provozu, můžeme začít trénovat modely.
Jako příklad využijeme modifikaci wine z příkladu MLflow v .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ratio 0.5
  --wine_file ./data/winequality-red.csv
Jak jsme již zmínili, MLflow umožňuje logovat parametry, metriky a artefakty modelů, aby bylo možné sledovat, jak se vyvíjejí během iterací. Tato funkce je nesmírně užitečná, protože umožňuje reprodukovat nejlepší model tím, že se obrátíme na Tracking server nebo pochopíme, který kód provedl potřebnou iteraci, s využitím logů git hash commitů.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 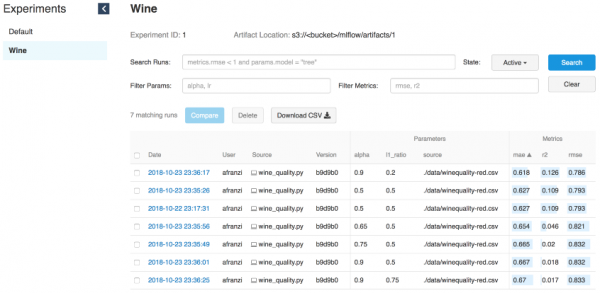
Iterace vína
Serverová část pro model
Sledovací server MLflow spuštěný pomocí příkazu „mlflow server“ má REST API pro sledování běhů a ukládání dat do místního souborového systému. Můžete zadat adresu sledovacího serveru pomocí proměnné prostředí „MLFLOW_TRACKING_URI“ a sledovací API MLflow se automaticky spojí se sledovacím serverem na této adrese, aby vytvořilo/získalo informace o běhu, metrikách logů atd.
Zdroj:
Abychom zajistili model serverem, potřebujeme spuštěný sledovací server (viz rozhraní spuštění) a ID běhu modelu.
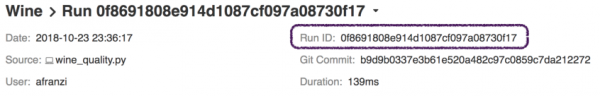
ID běhu
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
Pro spravování modelů pomocí funkce MLflow serve budeme potřebovat přístup k Sledovacímu UI, abychom získali informace o modelu pouhým zadáním --run_id.
Jakmile se model spojí se sledovacím serverem, můžeme získat nový koncový bod modelu.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Spuštění modelů ze Sparku
Ačkoli je sledovací server dostatečně výkonný pro poskytování modelů v reálném čase, jejich trénink a použití funkce serve (zdroj: ), použití Sparku (batch nebo streaming) je ještě výkonnější řešení díky distribuci.
Představte si, že jste právě provedli trénink offline a poté použili výstupní model na všech svých datech. Právě zde se Spark a MLflow ukážou v tom nejlepším světle.
Instalujeme PySpark + Jupyter + Spark
Zdroj:
Abychom ukázali, jak aplikujeme modely MLflow na datové rámce Spark, je třeba nastavit spolupráci mezi Jupyter notebooky a PySpark.
Začněte instalací poslední stabilní verze :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Nainstalujte PySpark a Jupyter do virtuálního prostředí:
pip install pyspark jupyterNastavte proměnné prostředí:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Definováním notebook-dir, můžeme ukládat naše notebooky v požadované složce.
Spouštíme Jupyter z PySpark
Jelikož jsme dokázali nastavit Jupiter jako řidiče PySpark, nyní můžeme spouštět Jupyter notebook v kontextu PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] rozšíření sparkmagic je aktivováno!
[I 19:05:01.573 NotebookApp] Notebooky se servírují z lokálního adresáře: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] Jupyter Notebook běží na:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Použijte Control-C pro zastavení tohoto serveru a vypnutí všech jader (dvakrát pro přeskočení potvrzení).
[C 19:05:01.574 NotebookApp]

    Zkopírujte/vložte tuto adresu URL do prohlížeče, když se poprvé připojíte,
    pro přihlášení s tokenem:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Jak bylo zmíněno výše, MLflow poskytuje funkci pro logování artefaktů modelu do S3. Jakmile máme vybraný model, můžeme jej importovat jako UDF pomocí modulu mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fixed acidity", "volatile acidity", "citric acid",
            "residual sugar", "chlorides", "free sulfur dioxide",
            "total sulfur dioxide", "density", "pH",
            "sulphates", "alcohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 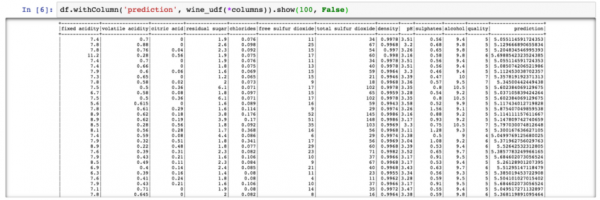
PySpark – Výstup předpovědi kvality vína
Do této doby jsme hovořili o tom, jak použít PySpark s MLflow, spuštěním předpovědi kvality vína na celém datovém souboru wine. Ale co když je potřeba používat moduly Python MLflow ze Scala Spark?
Otestovali jsme to a to tak, že jsme rozdělili kontext Spark mezi Scala a Python. To znamená, že jsme zaregistrovali MLflow UDF v Pythonu a použili jej z Scaly (ano, může to být, ne nejlepší řešení, ale co máme).
Scala Spark + MLflow
Pro tento příklad přidáme do existujícího Jupyteru.
Instalujeme Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Dostupné jádra:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Jak lze vidět z přiloženého notebooku, UDF je používán společně se Spark a PySpark. Doufáme, že tato část bude užitečná pro ty, kteří mají rádi Scalu a chtějí nasadit modely strojového učení do produkce.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf..predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Další kroky
Přestože je MLflow v době psaní tohoto článku v alfa verzi, vypadá velmi slibně. Možnost spouštět různé rámce strojového učení a využívat je z jedné koncové platformy posouvá doporučovací systémy na novou úroveň.
Navíc MLflow přibližuje datové inženýry a odborníky na data science, vytvářející mezi nimi společnou vrstvu.
Po této studii MLflow jsme si jisti, že půjdeme dál a využijeme ji pro naše Spark pipeline a doporučovací systémy.
Bylo by dobré synchronizovat úložiště souborů s databází místo souborového systému. Tak bychom měli získat několik koncových bodů, které mohou používat stejnou úložnou jednotku. Například používat několik instancí a se stejným Glue metastore.
Na závěr bych chtěl poděkovat komunitě MLFlow za to, že děláte naši práci s daty zajímavější.
Pokud si hrajete s MLflow, neváhejte nám napsat a podělit se o to, jak jej používáte, a obzvlášť pokud jej používáte v produkci.
Zjistit více o kurzech:
Číst víc:
Zdroj: habr.com
