

Před několika měsíci — veřejný na PostgreSQL.
Od té doby jste ho již využili více než 6000krát, ale jedna z užitečných funkcí mohla zůstat nepovšimnuta — to jsou strukturní nápovědy, které vypadají přibližně takto:
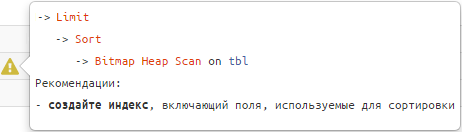
Dbejte na ně, a vaše dotazy „budou plynulé a sametové“. 🙂
A pokud mluvíme vážně, mnoho situací, které činí dotaz pomalým a „žravým“ co do zdrojů, je typických a mohou být rozpoznány na základě struktury a dat plánu.
V takovém případě nemusí každý jednotlivý vývojář hledat možnost optimalizace sám, spoléhajíc se výhradně na svou zkušenost — můžeme mu naznačit, co se děje, v čem může být příčina, a jak k řešení přistoupit. Což jsme také udělali.
Pojďme se podívat podrobněji na tyto třídy případů — jak jsou definovány a k jakým doporučením vedou.
Pro lepší pochopení tématu si nejprve můžete poslechnout příslušný blok z , a pak se přejít k podrobnému rozboru každého příkladu:
#1: индексная «недосортировка»
Když nastane
Zobrazit poslední účet zákazníka „OOO Kolokolchik“.
Jak rozpoznat
-> Limit
   -> Sort
      -> Index [jen] Scan [pozpátku] | Bitmap Heap Scan
Doporučení
Používaný index rozšířit o pole pro třídění.
Příklad:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faktů"
, (random() * 1000)::integer fk_cli; -- 1K různých cizích klíčů

CREATE INDEX ON tbl(fk_cli); -- index pro foreign key

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- výběr podle konkrétní vazby
ORDER BY
  pk DESC -- chceme pouze jeden "poslední" záznam
LIMIT 1; 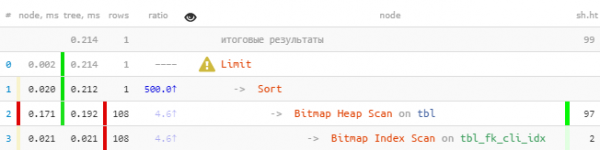
Hned si můžete všimnout, že z indexu bylo přečteno více než 100 záznamů, které se pak všechny třídily, a později zůstal pouze jeden.
Opraveno:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- přidali jsme klíč pro třídění
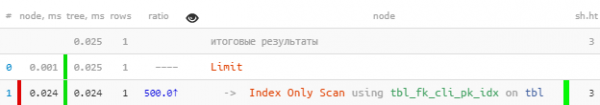
I na tak primitivním výběru — 8,5krát rychleji a 33krát méně čtení. Efekt bude tím názornější, čím více máte „faktů“ pro každou hodnotu fk.
Upozorním, že tento index bude fungovat jako „prefixový“ lépe než ten předchozí i v dalších dotazech s fk, kde třídění podle pk nebylo a není (podrobněji o tom si můžete přečíst ). Včetně toho zajistí i normální podporu explicitního foreign key na tomto poli.
#2: пересечение индексов (BitmapAnd)
Když nastane
Zobrazit všechny smlouvy podle zákazníka „OOO Kolokolchik“, uzavřené jménem „NAO Lyutik“.
Jak rozpoznat
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Doporučení
Vytvořit složený index podle polí z obou zdrojů nebo rozšířit jeden z existujících polí z druhého.
Příklad:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "faktů"
, (random() *  100)::integer fk_org  -- 100 různých externích klíčů
, (random() * 1000)::integer fk_cli; -- 1K různých externích klíčů

CREATE INDEX ON tbl(fk_org); -- index pro cizí klíč
CREATE INDEX ON tbl(fk_cli); -- index pro cizí klíč

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- výběr podle konkrétní dvojice 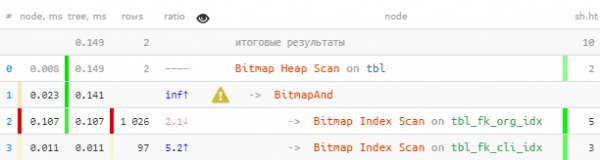
Opraveno:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
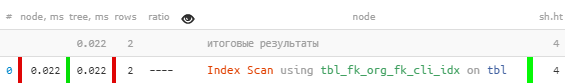
Zde je výhoda menší, jelikož Bitmap Heap Scan je dostatečně efektivní sám o sobě. Nicméně je 7krát rychlejší a 2,5krát méně čtení.
#3: объединение индексов (BitmapOr)
Když nastane
Zobrazit prvních 20 nejstarších „svých“ nebo nenarazných žádostí pro zpracování, přičemž své mají prioritu.
Jak rozpoznat
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Doporučení
Použít UNION [ALL] pro sloučení poddotazů podle každého z OR-bloků podmínek.
Příklad:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faktů"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- s pravděpodobností 1:16 záznam "remíza"
    ELSE (random() * 100)::integer -- 100 různých externích klíčů
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- index s "jakoby vhodným" uspořádáním

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- své
  fk_own IS NULL -- ... nebo "remízy"
ORDER BY
  pk
, (fk_own = 1) DESC -- nejprve "své"
LIMIT 20;
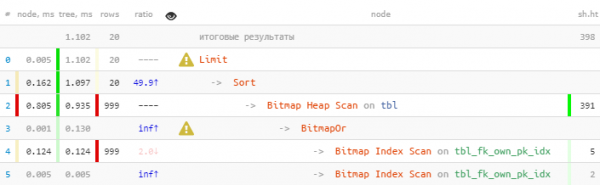
Opraveno:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- nejprve "své" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- poté "remízy" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- ale celkem - 20, více není potřeba 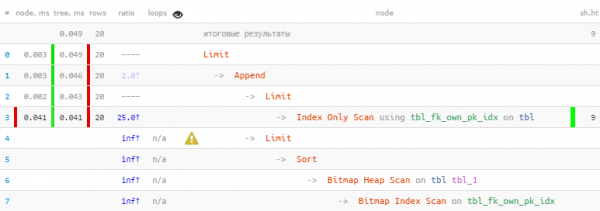
Využili jsme toho, že všech 20 potřebných záznamů bylo získáno už v prvním bloku, proto druhý blok, s dražším Bitmap Heap Scan, ani nebyl prováděn — v konečném důsledku je 22krát rychlejší, 44krát méně čtení!
Podrobnější vyprávění o tomto způsobu optimalizace na konkrétních příkladech si můžete přečíst v článcích a .
Obecná varianta uspořádaného výběru podle několika klíčů (a ne pouze podle dvojice const/NULL) je uvedena v článku .
#4: читаем много лишнего
Když nastane
Obvykle vzniká při snaze "přidat další filtr" k již existujícímu dotazu.
"A nemáte něco podobného, ale s perleťovými knoflíky?» film "Diamantová ruka"
Například, modifikací výše uvedeného úkolu, ukázat prvních 20 nejstarších "kritických" žádostí pro zpracování, bez ohledu na jejich určení.
Jak rozpoznat
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows < RRbF -- filtrovaných >80% přečteného
   && loops × RRbF > 100 -- a přitom více než 100 záznamů celkem
Doporučení
Vytvořit [specializovaný] index s podmínkou WHERE nebo zahrnout další pole do indexu.
Pokud je filtrační podmínka "statická" pro vaše úkoly — tedy nepředpokládá rozšíření seznamu hodnot v budoucnu — je lepší použít WHERE-index. Do této kategorie dobře spadají různé boolean/enum-statusy.
Pokud však podmínka filtrace může přijímat různé hodnoty, je lepší index rozšířit o tato pole — jak je to v situaci s BitmapAnd výše.
Příklad:
VYTVOŘTE TABULKU tbl JAKO
VYBERTE
  generate_series(1, 100000) pk -- 100K "faktů"
, PŘÍPAD
    KDYŽ random() < 1::real/16 POTOM NULL
    JINAK (random() * 100)::integer -- 100 různých cizích klíčů
  KONEC fk_own
, (random() < 1::real/50) critical; -- 1:50, že žádost je "kritická"

VYTVOŘTE INDEX NA tbl(pk);
VYTVOŘTE INDEX NA tbl(fk_own, pk);

VYBERTE
  *
Z
  tbl
KDE
  critical
POŘADÍ PODLE
  pk
OMEZENÍ 20; 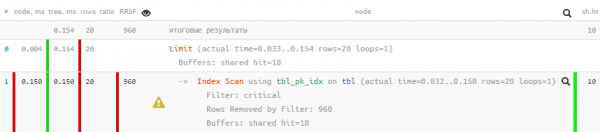
Opraveno:
VYTVOŘTE INDEX NA tbl(pk)
  KDE critical; -- přidali jsme "statickou" podmínku filtrace
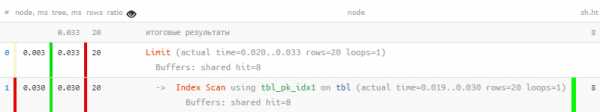
Jak vidíme, filtrace z plánu úplně zmizela a dotaz se stal 5krát rychlejší.
#5: разреженная таблица
Když nastane
Různé pokusy o vytvoření vlastní fronty zpracování úloh, kdy velké množství aktualizací/odstranění záznamů v tabulce vedlo k situaci s vysokým počtem "mrtvých" záznamů.
Jak rozpoznat
-> Sekvenční sken | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && smyčky × (řádky + RRbF) < (sdílené hit + sdílené čtení) × 8
      -- přečteno více než 1KB na každý záznam
   && sdílené hit + sdílené čtení > 64
Doporučení
Pravidelně provádět ručně VACUUM [FULL] nebo dosáhnout adekvátní frekvence provádění pomocí jemného nastavení jeho parametrů, včetně .
Ve většině případů jsou podobné problémy způsobeny špatnou strukturou dotazů při volání s business logikou, jako byly ty, které byly projednány v .
Ale je třeba pochopit, že i VACUUM FULL nemusí vždy pomoci. Pro takové případy stojí za to se seznámit s algoritmem z článku .
#6: чтение с «середины» индекса
Když nastane
Zdálo se, že jsme přečetli málo, vše podle indexu a nikoho navíc nefiltrujeme — a přesto bylo přečteno podstatně více stránek, než bychom chtěli.
Jak rozpoznat
-> Index [Only] Scan [Backward]
   && smyčky × (řádky + RRbF) < (sdílené hit + sdílené čtení) × 8
      -- přečteno více než 1KB na každý záznam
   && sdílené hit + sdílené čtení > 64
Doporučení
Důkladně se podívat na strukturu použitého indexu a klíčová pole uvedená v dotazu — pravděpodobně část indexu není určena. Pravděpodobně budete muset vytvořit podobný index, ale bez prefixových polí nebo .
Příklad:
VYTVÁŘEJTE TABULKU tbl AS
VYBERTE
  generate_series(1, 100000) pk      -- 100K "faktů"
, (random() *  100)::integer fk_org  -- 100 různých externích klíčů
, (random() * 1000)::integer fk_cli; -- 1K různých externích klíčů

VYTVÁŘEJTE INDEX NA tbl(fk_org, fk_cli); -- vše skoro jako v #2
-- pouze samostatný index na fk_cli jsme už považovali za nadbytečný a odstranili ho

VYBERTE
  *
Z
  tbl
KDE
  fk_cli = 999 -- ale fk_org není zadáno, přesto je dříve v indexu
LIMIT 20; 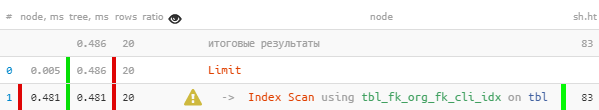
Vypadá to, že všechno je v pořádku, dokonce i s indexem, ale je to nějak podezřelé — na každou ze 20 přečtených záznamů bylo třeba projít 4 stránky dat, 32KB na záznam — není to příliš? A také název indexu tbl_fk_org_fk_cli_idx vyvolává zamyšlení.
Opraveno:
VYTVÁŘEJTE INDEX NA tbl(fk_cli); 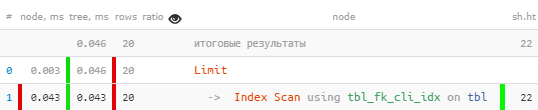
Náhle — 10krát rychleji a 4krát méně číst!
Další příklady neefektivního používání indexů lze najít v článku .
#7: CTE × CTE
Když nastane
V dotazu jsme napsali „velké“ CTE z různých tabulek, a pak jsme se rozhodli udělat mezi nimi JOIN.
Případ je aktuální pro verze nižší než v12 nebo dotazy s S MATERIALIZOVANÝM.
Jak rozpoznat
-> CTE Scan
   && smyčky > 10
   && smyčky × (řádky + RRbF) > 10000
      -- příliš velký karteziánský produkt CTE
Doporučení
Pečlivě analyzujte dotaz — zda ? Если все-таки да, то aplikujte „oslovování“ v hstore/json podle modelu popsaného v .
#8: swap на диск (temp written)
Když nastane
Jednorázové zpracování (setřídění nebo unikální) velkého množství záznamů se nevejde do vyhrazené paměti.
Jak rozpoznat
-> *
   && temp napsáno > 0
Doporučení
Pokud množství paměti použité operací výrazně nepřesahuje nastavenou hodnotu parametru , je dobré ji upravit. Můžete to udělat hned v konfiguraci pro všechny, nebo prostřednictvím SET [LOCAL] pro konkrétní dotaz/transakci.
Příklad:
SHOW work_mem;
-- "16MB"

VYBERTE
  random()
Z
  generate_series(1, 1000000)
POŘADÍ
1; 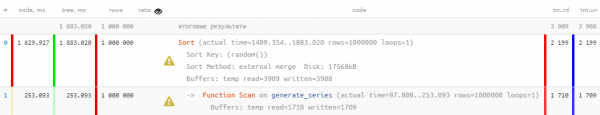
Opraveno:
SET work_mem = '128MB'; -- před provedením dotazu 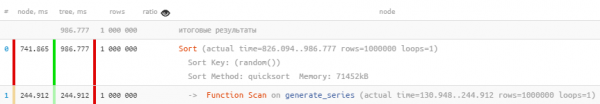
Z jasných důvodů, pokud se používá pouze paměť a nikoli disk, pak se dotaz provádí mnohem rychleji. Tím se také částečně odstraňuje zátěž z HDD.
Ale je třeba chápat, že vyčlenit hodně paměti také nebude vždy možné — prostě ji nebude dost na všechny.
#9: неактуальная статистика
Když nastane
Do databáze bylo nahráno najednou hodně, ale nestihli jsme to projít ANALYZE.
Jak rozpoznat
-> Sekvenční sken | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && poměr >> 10
Doporučení
Proveďte přesto ANALYZE.
Podrobněji je tato situace popsána v .
#10: «что-то пошло не так»
Když nastane
Došlo k čekání na zámek uvalený konkurenčním dotazem, nebo nebyly dostatečné hardwarové prostředky CPU/hypervisoru.
Jak rozpoznat
-> *
   && (sdílený hit / 8K) + (sdílené čtení / 1K) < čas / 1000
      -- RAM hit = 64MB/s, HDD čtení = 8MB/s
   && čas > 100ms -- četli málo, ale příliš dlouho
Doporučení
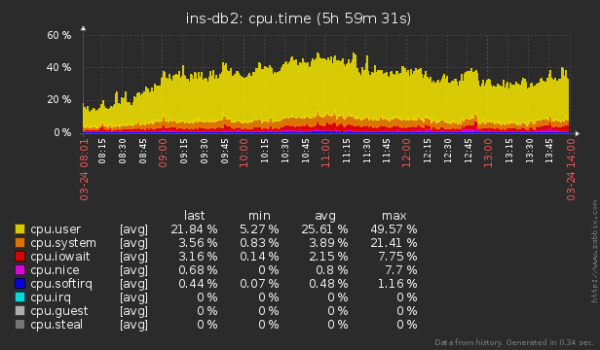
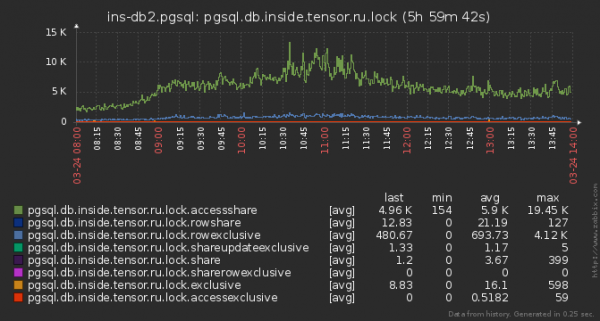
Použijte externí systém pro monitorování serverů z hlediska blokací nebo abnormálního využívání zdrojů. O naší organizaci tohoto procesu pro stovky serverů jsme již informovali a .
Zdroj: habr.com
