

Na začátku tohoto měsíce, 3. května, byl oznámen velký release „systému pro správu distribuovaných úložišť dat v Kubernetes“ — . Před více než rokem jsme již obecný přehled Rook. Tehdy jsme byli požádáni o sdílení zkušeností s jeho používáním v praxi — a právě k této významné meze v historii projektu jsme rádi, že se můžeme podělit o nasbírané dojmy.
Stručně řečeno, Rook je soubor pro Kubernetes, který plně ovládá nasazení, správu, automatické obnovení takových řešení pro ukládání dat, jako jsou Ceph, EdgeFS, Minio, Cassandra, CockroachDB.
V současné době je nejrozvinutějším (a v stabilním řešením ve stádiu) řešení .
Poznámka: mezi významnými změnami v release Rook 1.0.0 souvisejícími s Ceph je možné zmínit podporu Ceph Nautilus a možnost použití NFS pro CephFS- nebo RGW-bucket. Z dalších se vyznačuje „zrání“ podpory EdgeFS na úroveň beta.
Takže v tomto článku se:
- vyjadříme, jaké výhody vidíme v používání Rook pro nasazení Ceph v clusteru Kubernetes;
- podělíme se o zkušenosti a dojmy z používání Rook v produkčním prostředí;
- řekneme, proč říkáme Rooku „Ano!“, a o svých plánech s ním.
Začneme s obecnými koncepty a teorií.
„Mám výhodu o jednu figurku!“ (neznámý šachista)
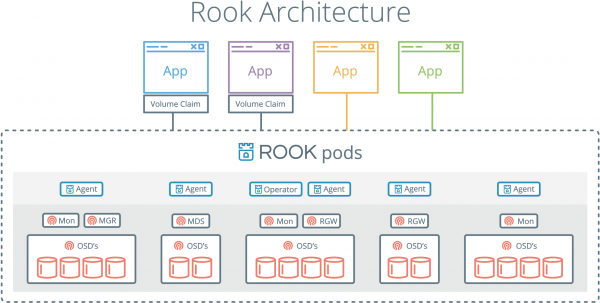
Jednou z hlavních výhod Rook je, že interakce se skladovými daty se provádí přes mechanismy Kubernetes. To znamená, že už není potřeba kopírovat příkazy pro konfiguraci Ceph z papíru do konzole.
— Chceš nasadit v clusteru CephFS? Prostě napiš YAML soubor!
— Co? Chceš nasadit ještě objektový sklad s S3 API? Prostě napiš druhý YAML soubor!
Rook je navržen podle pravidel typického operátora. Interakce s ním probíhá pomocí , ve kterých popisujeme potřebné vlastnosti entit Ceph (jelikož je to jediné stabilní řešení, výchozí předpoklad v článku bude o Ceph, pokud není výslovně uvedeno jinak). Podle zadaných parametrů operátor automaticky provede potřebné příkazy pro konfiguraci.
Konkrétně se podívejme na příklad vytvoření objektového skladu, a to konkrétně — CephObjectStoreUser.
apiVersion: ceph.rook.io/v1
kind: CephObjectStore
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  metadataPool:
    failureDomain: host
    replicated:
      size: 3
  dataPool:
    failureDomain: host
    erasureCoded:
      dataChunks: 2
      codingChunks: 1
  gateway:
    type: s3
    sslCertificateRef:
    port: 80
    securePort:
    instances: 1
    allNodes: false
---
apiVersion: ceph.rook.io/v1
kind: CephObjectStoreUser
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  store: {{ .Values.s3.crdName }}
  displayName: {{ .Values.s3.username }}
Parametry uvedené v seznamu jsou dost standardní a pravděpodobně nevyžadují komentáře, nicméně stojí za to věnovat zvláštní pozornost těm, které jsou zvýrazněny v šablonových proměnných.
Celková schéma fungování spočívá v tom, že prostřednictvím YAML souboru „objednáváme“ zdroje, pro které operátor provede potřebné příkazy a vrátí nám „ne úplně pravý“ tajný klíč, se kterým můžeme dále pracovat. (viz níže). A z proměnných, které jsou uvedeny výše, bude složen příkaz a název tajného klíče.
Jaký příkaz se tedy jedná? Při vytváření uživatele pro objektové úložiště vykoná Rook operátor uvnitř podu následující:
radosgw-admin user create --uid="rook-user" --display-name="{{ .Values.s3.username }}"Výsledkem provedení tohoto příkazu bude JSON struktura:
{
    "user_id": "rook-user",
    "display_name": "{{ .Values.s3.username }}",
    "keys": [
        {
           "user": "rook-user",
           "access_key": "NRWGT19TWMYOB1YDBV1Y",
           "secret_key": "gr1VEGIV7rxcP3xvXDFCo4UDwwl2YoNrmtRlIAty"
        }
    ],
    ...
}
Klíče — to, co bude zapotřebí v budoucnu aplikacím pro přístup k objektovému úložišti prostřednictvím S3 API. Rook operátor je s potěšením vybere a uloží do svého namespace ve formě tajného klíče s názvem rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}.
Pro použití dat z tohoto tajného klíče stačí přidat je do kontejneru jako proměnné prostředí. Jako příklad uvedu šablonu pro Job, ve které automaticky vytváříme bucket'y pro každé uživatelské prostředí:
{{- range $bucket := $.Values.s3.bucketNames }}
apiVersion: batch/v1
kind: Job
metadata:
  name: create-{{ $bucket }}-bucket-job
  annotations:
    "helm.sh/hook": post-install
    "helm.sh/hook-weight": "2"
spec:
  template:
    metadata:
      name: create-{{ $bucket }}-bucket-job
    spec:
      restartPolicy: Never
      initContainers:
      - name: waitdns
        image: alpine:3.6
        command: ["/bin/sh", "-c", "while ! getent ahostsv4 rook-ceph-rgw-{{ $.Values.s3.crdName }}; do sleep 1; done" ]
      - name: config
        image: rook/ceph:v1.0.0
        command: ["/bin/sh", "-c"]
        args: ["s3cmd --configure --access_key=$(ACCESS-KEY) --secret_key=$(SECRET-KEY) -s --no-ssl --dump-config | tee /config/.s3cfg"]
        volumeMounts:
        - name: config
          mountPath: /config
        env:
        - name: ACCESS-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: AccessKey
        - name: SECRET-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: SecretKey
      containers:
      - name: create-bucket
        image: rook/ceph:v1.0.0
        command:
        - "s3cmd"
        - "mb"
        - "--host=rook-ceph-rgw-{{ $.Values.s3.crdName }}"
        - "--host-bucket= "
        - "s3://{{ $bucket }}"
        ports:
        - name: s3-no-sll
          containerPort: 80
        volumeMounts:
        - name: config
          mountPath: /root
      volumes:
      - name: config
        emptyDir: {}
---
{{- end }}
Všechny akce uvedené v tomto Jobu proběhly v rámci Kubernetes. Struktury popsané v YAML souborech byly uloženy do Git repozitáře a byly opakovaně znovu použity. To je obrovská výhoda pro DevOps inženýry a proces CI/CD jako celek.
S Rook a Rados je to radost.
Použití kombinace Ceph + RBD ukládá určité omezení na připojení objemů k podům.
Speciálně musí v namespace existovat tajný klíč pro přístup k Ceph, aby stateful aplikace mohly fungovat. Je v pořádku mít 2-3 prostředí ve svých jmenných prostorách: můžete jít a zkopírovat tajný klíč ručně. Ale co dělat, pokud se pro každou funkci vytváří jednotlivé prostředí se svým namespace?
Vyřešili jsme tento problém pomocí , který automaticky kopíroval tajné klíče do nových namespaců (příklady takového hooku jsou uvedeny v ).
#! /bin/bash

if [[ $1 == “--config” ]]; then
   cat <<EOF
{"onKubernetesEvent":[
 {"name": "OnNewNamespace",
  "kind": "namespace",
  "event": ["add"]
  }
]}
EOF
else
    NAMESPACE=$(kubectl get namespace -o json | jq '.items | max_by( .metadata.creationTimestamp ) | .metadata.name')
    kubectl -n ${CEPH_SECRET_NAMESPACE} get secret ${CEPH_SECRET_NAME} -o json | jq ".metadata.namespace="${NAMESPACE}"" | kubectl apply -f -
fi
Nicméně použití Rook tento problém prostě eliminuje. Proces připojení probíhá pomocí vlastních ovladačů na bázi nebo (zatím v beta fázi) a proto nevyžaduje tajné klíče.
Rook automaticky řeší mnoho problémů, což nás motivuje jej používat v nových projektech.
Obléhání Rook
Zakončíme praktickou část nasazením Rook a Ceph, abychom měli možnost provádět vlastní experimenty. Aby bylo snazší dobýt tuto nedobytnou věž, vývojáři připravili Helm balíček. Pojďme si ho stáhnout:
$ helm fetch rook-master/rook-ceph --untar --version 1.0.0 V souboru rook-ceph/values.yaml můžeme najít spoustu různých nastavení. Nejpodstatnější je uvést tolerace pro agenty a vyhledávání. O tom, k čemu lze použít mechanismus taints/tolerations, jsme podrobně hovořili v .
Pokud to shrneme, nechceme, aby pod'y s klientskou aplikací běžely na stejných uzlech, kde jsou umístěny disky pro ukládání dat. Důvod je jednoduchý: tak nebude činnost agentů Rook ovlivňovat samotnou aplikaci.
Takže otevřeme soubor rook-ceph/values.yaml oblíbeným editorem a na konec přidáme následující blok:
discover:
  toleration: NoExecute
  tolerationKey: node-role/storage
agent:
  toleration: NoExecute
  tolerationKey: node-role/storage
  mountSecurityMode: Any
Na každý uzel vyhrazený pro ukládání dat přidáme příslušný taint:
$ kubectl taint node ${NODE_NAME} node-role/storage="":NoExecutePo čemž nainstalujeme Helm chart příkazem:
$ helm install --namespace ${ROOK_NAMESPACE} ./rook-cephNyní je třeba vytvořit clustera uvést umístění :
apiVersion: ceph.rook.io/v1
kind: CephCluster
metadata:
  clusterName: "ceph"
  finalizers:
  - cephcluster.ceph.rook.io
  generation: 1
  name: rook-ceph
spec:
  cephVersion:
    image: ceph/ceph:v13
  dashboard:
    enabled: true
  dataDirHostPath: /var/lib/rook/osd
  mon:
    allowMultiplePerNode: false
    count: 3
  network:
    hostNetwork: true
  rbdMirroring:
    workers: 1
  placement:
    all:
      tolerations:
      - key: node-role/storage
        operator: Exists
  storage:
    useAllNodes: false
    useAllDevices: false
    config:
      osdsPerDevice: "1"
      storeType: filestore
    resources:
      limits:
        memory: "1024Mi"
      requests:
        memory: "1024Mi"
    nodes:
    - name: host-1
      directories:
      - path: "/mnt/osd"
    - name: host-2
      directories:
      - path: "/mnt/osd"
    - name: host-3
      directories:
      - path: "/mnt/osd"
Kontrolujeme stav Ceph – očekáváme, že uvidíme HEALTH_OK:
$ kubectl -n ${ROOK_NAMESPACE} exec $(kubectl -n ${ROOK_NAMESPACE} get pod -l app=rook-ceph-operator -o name -o jsonpath='{.items[0].metadata.name}') -- ceph -sZa chvíli zkontrolujeme, že pod'y s klientskou aplikací nekončí na uzlech vyhrazených pro Ceph:
$ kubectl -n ${APPLICATION_NAMESPACE} get pods -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeNameDále podle potřeby nastavíme další komponenty. Podrobnosti o nich jsou uvedeny v . Pro administraci důrazně doporučujeme nainstalovat dashboard a toolbox.
Rookové krůčky: stačí Rook na všechno?
Jak je vidět, vývoj Rook pokračuje naplno. Nicméně stále existují problémy, které nám neumožňují zcela se vzdát ruční konfigurace Ceph:
- Žádný ovladač Rook exportovat metriky využití připojených bloků, což nás zbavuje monitorování.
- Flexvolume a CSI neumožňují měnit velikost svazků (na rozdíl od RBD), takže Rook přichází o užitečný (a někdy dokonce kriticky potřebný!) nástroj.
- Rook stále není tak flexibilní jako běžný Ceph. Pokud bychom chtěli nastavit, aby zásobník pro metadata CephFS byl uložen na SSD a samotná data na HDD, bude nutné ručně zapisovat jednotlivé skupiny zařízení do CRUSH map.
- I když je rook-ceph-operator považován za stabilní, v současnosti existují určité problémy při aktualizaci Ceph z verze 13 na 14.
Závěry
„V současnosti je Rook uzavřen před vnějším světem pěšci, ale věříme, že jednou se stane rozhodujícím faktorem v partii!“ (citát byl specificky vymyšlen pro tento článek)
Projekt Rook bezpochyby získal naše srdce — věříme, že [se všemi svými klady a zápory] si zaslouží také vaši pozornost.
Naše další plány se týkají toho, že chceme udělat rook-ceph modulem pro , což usnadní jeho používání v našich mnoha Kubernetes clusterech ještě více.
P.S.
Přečtěte si také náš blog:
- «»;
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
