

Filozofické úvodní slovo
Jak je známo, existují pouze dvě metody pro řešení úloh:
- Metoda analýzy nebo dedukce, tedy od obecného k specifickému.
- Metoda syntézy nebo indukce, tedy od specifického k obecnému.
Pro řešení problému "zlepšit výkon databáze" to může vypadat následovně.
Analýza — rozkládáme problém na jednotlivé části a jejich řešením se snažíme celkově zlepšit výkon databáze.
V praxi analýza vypadá přibližně takto:
- Objevuje se problém (incident výkonu)
- Shromažďujeme statistické informace o stavu databáze
- Hledáme úzká místa (bottlenecks)
- Řešíme problémy s úzkými místy
Úzká místa databáze — infrastruktura (CPU, paměť, disky, síť, OS), nastavení (postgresql.conf), dotazy:
Infrastruktura: možnosti vlivu a změn pro inženýra — téměř nulové.
Nastavení databáze: možnosti pro změny jsou o něco větší než v předchozím případě, ale zpravidla stále velmi obtížné, zejména v cloudech.
Požadavky k databázi: jediná oblast pro manévry.
Syntéza — zlepšujeme výkon jednotlivých částí, očekávajíc, že celkový výkon databáze se zlepší.
Literární úvod nebo k čemu je to všechno dobré
Jak probíhá proces řešení incidentů výkonu, pokud výkon databáze není monitorován:
Zákazník - "Máme to špatné, vše trvá dlouho, udělejte nám to dobré"
Inženýr - "Jak špatné?"
Zákazník - "Takto to je teď (před hodinou, včera, to bylo), pomalu"
Inženýr - "A kdy to bylo dobré?"
Zákazník - "Před týdnem (dvěma týdny) to bylo celkem v pořádku." (Měli jsme štěstí)
Zákazník - "A já si nepamatuji, kdy bylo dobře, ale teď je to špatné" (Běžná odpověď)
Výsledkem je klasický obraz:
Kdo je viníkem a co dělat?
Na první část otázky je nejjednodušší odpovědět — vždy je vinen inženýr DBA.
Na druhou část odpovědět také není příliš složité — je třeba zavést systém monitorování výkonu databáze.
Objevuje se první otázka — co monitorovat?
Cesta 1. Budeme monitorovat VŠECHNO
Zatížení CPU, počet diskových čtecích/zapisovacích operací, velikost přidělené paměti a další megatuny různých čítačů, které jakýkoli alespoň trochu funkční monitorovací systém může poskytnout.
Výsledkem je spousta grafů, souhrnných tabulek a nepřetržité upozornění na e-mail a 100% vytížení inženýra, který řeší množství stejných tiketů, často se standardním označením – „Dočasný problém. Není potřeba žádná akce“. Ale všichni jsou zaměstnaní a vždy mají co ukázat zákazníkovi – práce vře.
Cesta 2. Monitorovat pouze to, co je potřeba, a to, co není potřeba, nemusíte monitorovat.
Můžete monitorovat, o něco jinak – pouze entity a události:
- Na které může inženýr DBA mít vliv.
- Pro které existuje algoritmus akcí při výskytu události nebo změny entity.
Z tohoto předpokladu, a vzpomínajíc na „Filozofické úvodní slovo“ s cílem vyhnout se pravidelnému opakování „Literární úvod nebo k čemu je to všechno dobré“ by bylo rozumné monitorovat výkon jednotlivých dotazů, pro optimalizaci a analýzu, což by mělo nakonec vést ke zlepšení celkové rychlosti databáze.
Ale pro zlepšení těžkého dotazu, který ovlivňuje celkový výkon databáze, musíte nejprve najít.
Tak se objevují dvě vzájemně provázané otázky:
- jaký dotaz se považuje za těžký.
- jak hledat těžké dotazy.
Je jasné, že těžký dotaz je dotaz, který využívá hodně prostředků OS k získání výsledku.
Přejdeme k druhé otázce – jak hledat a poté monitorovat těžké dotazy?
Jaké možnosti monitorování dotazů existují v PostgreSQL?
Ve srovnání s Oracle je možností málo, ale přesto je možné něco udělat.
PG_STAT_STATEMENTS
Pro vyhledávání a monitorování těžkých dotazů v PostgreSQL je určeno standardní rozšíření pg_stat_statements.
Po instalaci rozšíření se v cílové databázi objeví shodný pohled, který je třeba použít pro účely monitorování.
Cílové sloupce pg_stat_statements pro vytvoření monitorovacího systému:
- queryid Vnitřní hash kód vypočítaný podle stromu rozkladu operátoru.
- max_time Maximální čas strávený na operátoru v milisekundách.
S hromaděním a využitím statistik z těchto dvou sloupců je možné vytvořit monitorovací systém.
Jak se pg_stat_statements používá pro monitorování výkonu PostgreSQL.
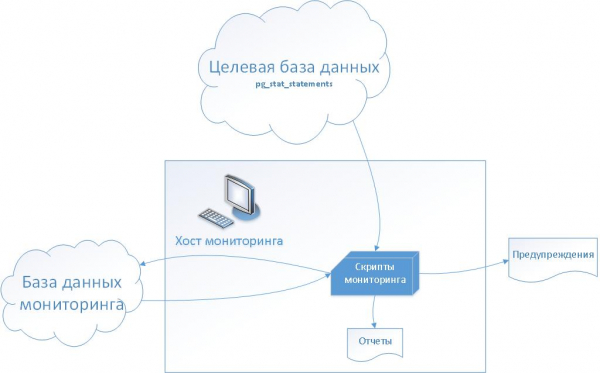
Pro monitorování výkonu dotazů se používá:
Na straně cílové databáze – pohled pg_stat_statements.
Na straně serveru a databáze monitorování – soubor bash skriptů a servisních tabulek.
1. krok — shromáždění statistických údajů
Na hostingu monitorování se pravidelně spouští skript, který kopíruje obsah zobrazení pg_stat_statements z cílové databáze do tabulky pg_stat_history v databázi monitorování.
Takto se vytváří historie vykonání jednotlivých dotazů, kterou lze využít k vytváření zpráv o výkonu a nastavení metrik.
2. krok — nastavení metrik výkonu
Na základě shromážděných dat vybíráme dotazy, jejichž vykonání je pro klienta (aplikaci) nejkritičtější/nejdůležitější. Po dohodě se zákazníkem nastavujeme hodnoty metrik výkonu pomocí polí queryid a max_time.
Výsledek — zahájení monitorování výkonu
- Monitorovací skript při spuštění kontroluje nakonfigurované metriky výkonu, porovnávající hodnotu max_time metriky s hodnotou zobrazení pg_stat_statements v cílové databázi.
- Pokud hodnota v cílové databázi překročí hodnotu metriky – vytvoří se upozornění (incident v ticketovém systému)
Další možnost 1
Historie plánů vykonání dotazů
Pro následné řešení incidentů výkonu je velmi prospěšné mít historii změn plánů vykonání dotazů.
Pro uchovávání historie se používá servisní tabulka log_query. Tabulka se plní při analýze nahraného log souboru PostgreSQL. Protože do log souboru, na rozdíl od zobrazení pg_stat_statements, vchází celý text s hodnotami parametrů vykonání, a ne normalizovaný text, je možné uchovávat záznamy nejen o čase a délce dotazů, ale také skladovat plány vykonání k aktuálnímu okamžiku.
Další možnost 2
Nepřetržitý proces zlepšování výkonu
Monitorování jednotlivých dotazů obecně není určeno k řešení úlohy nepřetržitého zlepšování výkonu databáze jako celku, neboť kontroluje a řeší výkon pouze pro jednotlivé dotazy. Je však možné metodu rozšířit a nastavit monitorování dotazů pro všechny databáze.
K tomu je nutné zavést další metriky výkonu:
- Za poslední dny
- Za základní období
Skript vybírá dotazy z pohledu pg_stat_statements ve vybrané databázi a srovnává hodnotu max_time s průměrnou hodnotou max_time, v prvním případě za poslední dny nebo za vybrané časové období (baseline), v druhém případě.
Takže v případě degradace výkonu jakéhokoli dotazu bude varování automaticky vygenerováno bez ruční analýzy zpráv.
A co má společného syntéza?
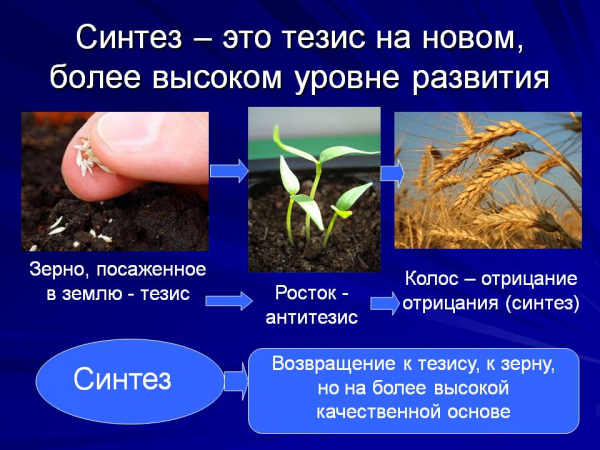
V popsaném přístupu, jak naznačuje metoda syntézy — zlepšováním jednotlivých částí systému zlepšujeme systém jako celek.
- Dotaz prováděný databází – teze
- Změněný dotaz – antiteze
- Změna stavu systému — syntéza
Rozvoj systému
- Rozšíření shromažďovaných statistik přidáním historie pro systémový pohled pg_stat_activity
- Rozšíření shromažďovaných statistik přidáním historie pro statistiku jednotlivých tabulek účastnících se dotazů
- Integrace se systémem monitorování v cloudu AWS
- A ještě, něco dalšího lze vymyslet…
Zdroj: habr.com
