

Strukturování nestrukturovaných dat pomocí GROK
Pokud používáte Elastic Stack (ELK) a máte zájem o mapování vlastních protokolů Logstash na Elasticsearch, pak je tento příspěvek pro vás.
ELK Stack je zkratka pro tři projekty s otevřeným zdrojovým kódem: Elasticsearch, Logstash a Kibana. Tyto tři dohromady tvoří platformu pro správu protokolů.
- Elasticsearch – je vyhledávací a analytický systém.
- Logstash – to je serverový konvektor pro zpracování dat, který přijímá data z více zdrojů současně, transformuje je a poté je odesílá do „úložiště“, například Elasticsearch.
- Kibana umožňuje uživatelům vizualizovat data pomocí diagramů a grafů v Elasticsearch.
Beats se objevil později a je lehkým odesílatelem dat. Zavedení Beats transformovalo Elk Stack na Elastic Stack, ale to není hlavní.
Tento článek se věnuje Groku, což je funkce v Logstash, která může transformovat vaše protokoly, než budou odeslány do úložiště. Pro naše účely budu mluvit pouze o zpracování dat z Logstash do Elasticsearch.
Grok je filtr uvnitř Logstash, který se používá k rozboru nestrukturovaných dat na něco strukturovaného a vyhledatelného. Leží nad regulárními výrazy (regex) a používá textové vzory k párování řetězců v protokolech.
Jak uvidíme v následujících sekcích, používání Groku je velmi důležité pro efektivní správu protokolů.
Bez Groku jsou vaše protokoly nestrukturované
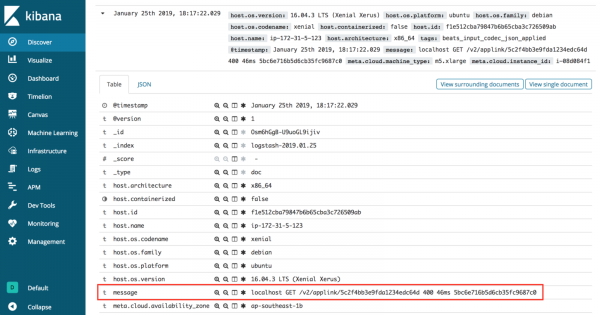
Bez Groku, když jsou protokoly odesílány z Logstash do Elasticsearch a vizualizovány v Kibana, se objevují pouze ve zprávě.
Žádost o smysluplné informace je v této situaci obtížná, protože všechna protokolar jsou uchovávána pod jedním klíčem. Bylo by lepší, kdyby byly zprávy z protokolů lépe organizovány.
Nestrukturovaná data z protokolů
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Pokud se pozorně podíváte na neupravená data, uvidíte, že se ve skutečnosti skládají z různých částí, z nichž každá je oddělena mezerou.
Pro zkušenější vývojáře si pravděpodobně dokážete odvodit, co která část znamená, a že se jedná o zprávu z API. Každá položka je níže uvedena.
Strukturovaný pohled na naše data
- localhost == prostředí
- GET == metoda
- /v2/applink/5c2f4bb3e9fda1234edc64d == url
- 400 == stav_odpovědi
- 46ms == čas_odpovědi
- 5bc6e716b5d6cb35fc9687c0 == uživatelské_id
Jak vidíme ve strukturovaných datech, existuje pořadí pro nestrukturované protokoly. Dalším krokem je programové zpracování surových dat. Zde se Grok vyznačuje.
Grok šablony
Integrované šablony Grok
Logstash přichází s více než 100 integrovanými šablonami pro strukturování nestrukturovaných dat. Určitě byste toho měli využít, když je to možné pro běžné systémové protokoly, jako jsou apache, linux, haproxy, aws a tak dále.
Ale co se stane, když máte vlastní protokoly, jako v příkladu výše? Musíte si vytvořit vlastní šablonu Grok.
Vlastní šablony Grok
Je potřeba experimentovat, abyste vytvořili vlastní šablonu Grok. Používal jsem a .
Všimněte si, že syntaxe šablon Grok vypadá následovně: %{SYNTAX:SEMANTIC}
První věc, kterou jsem se pokusil udělat, bylo přejít na záložku Objev v Grok debuggeru. Myslel jsem, že by bylo skvělé, kdyby tento nástroj mohl automaticky generovat šablonu Grok, ale nebylo to příliš užitečné, protože našel pouze dvě shody.
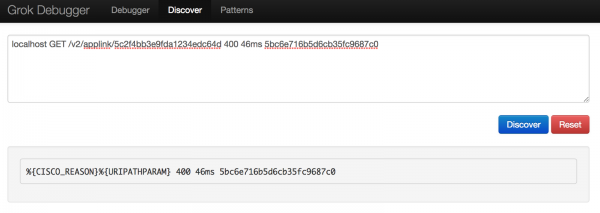
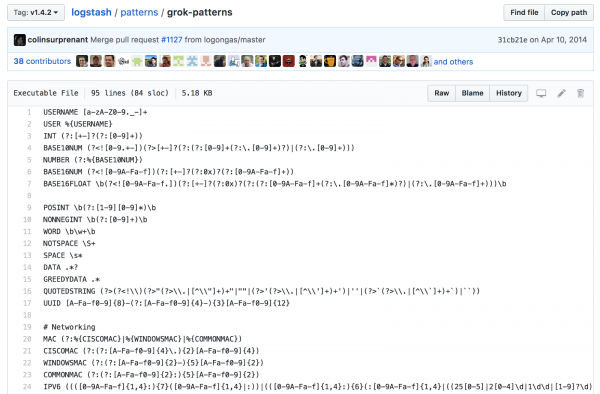
Využitím tohoto objevu jsem začal vytvářet svou vlastní šablonu v Grok debuggeru, používající syntaxi nalezenou na stránce Github Elastic.
Hraním si s různými syntaxy jsem nakonec dokázal strukturovat data protokolu tak, jak jsem chtěl.
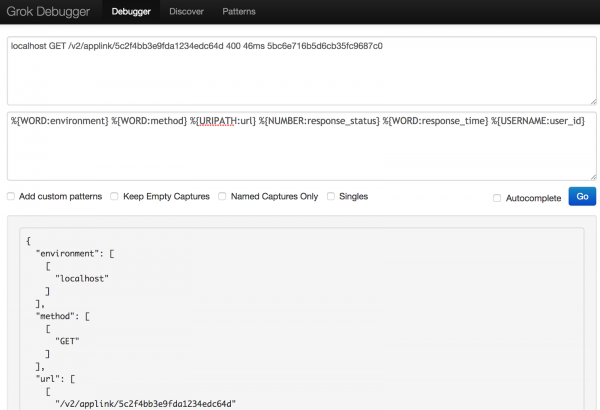
Odkaz na Grok debugger
Zdrojový text:
localhost GET /v2/applink/5c2f4bb3e9fda1234edc64d 400 46ms 5bc6e716b5d6cb35fc9687c0Vzorek:
%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}To, co se nakonec podařilo
{
  "environment": [
    [
      "localhost"
    ]
  ],
  "method": [
    [
      "GET"
    ]
  ],
  "url": [
    [
      "/v2/applink/5c2f4bb3e9fda1234edc64d"
    ]
  ],
  "response_status": [
    [
      "400"
    ]
  ],
  "BASE10NUM": [
    [
      "400"
    ]
  ],
  "response_time": [
    [
      "46ms"
    ]
  ],
  "user_id": [
    [
      "5bc6e716b5d6cb35fc9687c0"
    ]
  ]
}
Mít v rukou šablonu Grok a odpovídající data, poslední krok je přidat ji do Logstash.
Aktualizace souboru konfigurace Logstash.conf
Na serveru, na kterém jste nainstalovali stack ELK, přejděte do konfigurace Logstash:
sudo vi /etc/logstash/conf.d/logstash.confVložte změny.
input {
  file {
    path => "/your_logs/*.log"
  }
}
filter{
  grok {
    match => { "message" => "%{WORD:environment} %{WORD:method} %{URIPATH:url} %{NUMBER:response_status} %{WORD:response_time} %{USERNAME:user_id}"}
  }
}
output {
  elasticsearch {
    hosts => [ "localhost:9200" ]
  }
}
Po uložení změn restartujte Logstash a zkontrolujte jeho stav, abyste se ujistili, že stále funguje.
sudo service logstash restart
sudo service logstash status
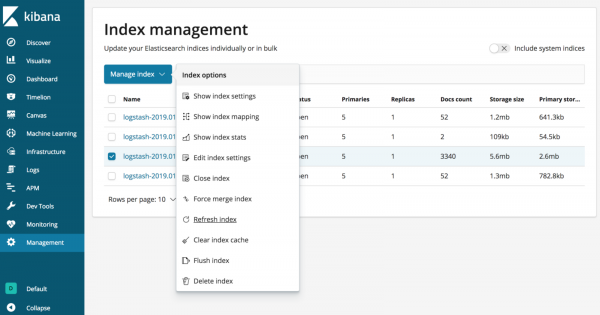
Nakonec, abyste se ujistili, že změny nabyly účinnosti, nezapomeňte aktualizovat index Elasticsearch pro Logstash v Kibana!
S Grok jsou vaše data z logů strukturována!
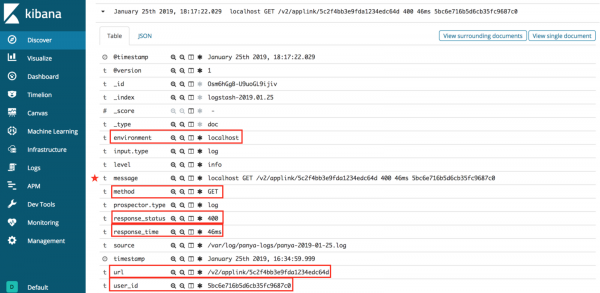
Jak vidíme na výše uvedeném obrázku, Grok dokáže automaticky mapovat data z logů do Elasticsearch. To usnadňuje správu logů a rychlé vyhledávání informací. Místo toho, abyste procházeli soubory logů pro ladění, můžete jednoduše filtrovat to, co hledáte, jako je prostředí nebo url.
Zkuste dát Grok expression šanci! Pokud máte jiný způsob, jak to udělat, nebo pokud máte nějaké problémy s výše uvedenými příklady, neváhejte napsat komentář níže a dejte mi vědět.
Děkuji za přečtení — a prosím, sledujte mě zde na Medium pro další zajímavé články o softwarovém inženýrství!
Zdroje
P.S
Telegram kanál o
Zdroj: habr.com
