

Ahoj všichni. Přátelé, sdílíme s vámi překlad článku, který byl speciálně připraven pro studenty kurzu . Jdeme na to!
Apache Beam a DataFlow pro real-time toky
Dnešní příspěvek se zakládá na úkolu, kterému jsem se nedávno věnoval v práci. Opravdu mě potěšilo realizovat ho a popsat vykonanou práci formou blogového příspěvku, protože mi to dalo příležitost zabývat se data engineeringem a také vytvořit něco, co by bylo velmi užitečné pro můj tým. Nedávno jsem zjistil, že v našich systémech je uložena poměrně velká uživatelská log, související s jedním z našich produktů pro práci s daty. Ukázalo se, že nikdo tato data nevyužíval, a proto mě okamžitě zajímalo, co bychom mohli zjistit, kdybychom je začali pravidelně analyzovat. Na cestě však bylo několik problémů. První problém byl v tom, že data byla uložena v mnoha různých textových souborech, které nebyly dostupné pro okamžitou analýzu. Druhý problém spočíval v tom, že byla uložena v uzavřeném systému, takže jsem nemohl použít žádný z mých oblíbených nástrojů pro analýzu dat.
Musel jsem vyřešit, jak pro nás usnadnit přístup a přinést nějakou hodnotu tím, že tento zdroj dat začlením do některých našich řešení pro interakci s uživateli. Po chvíli přemýšlení jsem se rozhodl navrhnout potrubí pro přenos těchto dat do cloudové databáze, aby k nim měl já a tým přístup a mohli začít generovat nějaké závěry. Poté, co jsem před nějakým časem dokončil specializaci Data Engineering na Coursera, měl jsem chuť použít v projektu některé nástroje z kurzu.
Umístění dat do cloudové databáze se tedy jevilo jako rozumný způsob, jak vyřešit můj první problém, ale co s problémem číslo 2? Naštěstí existoval způsob, jak tato data přenést do prostředí, kde jsem mohl mít přístup k nástrojům jako Python a Google Cloud Platform (GCP). Bylo to však dlouhé, a tak jsem musel udělat něco, co by mi umožnilo pokračovat ve vývoji, zatímco jsem čekal na dokončení přenosu dat. Řešení, ke kterému jsem došel, spočívalo ve vytvoření fiktivních dat pomocí knihovny Faker v Pythonu. Nikdy jsem tu knihovnu předtím nepoužíval, ale rychle jsem pochopil, jak užitečná je. Použití tohoto přístupu mi umožnilo začít psát kód a testovat potrubí bez skutečných dat.
S ohledem na již zmíněné, v tomto příspěvku popíšu, jak jsem vytvořil výše popsané potrubí, pomocí některých technologií dostupných v GCP. Konkrétně budu používat Apache Beam (verzi pro Python), Dataflow, Pub/Sub a BigQuery pro shromažďování uživatelských protokolů, transformaci dat a jejich přenos do databáze pro další analýzu. V mém případě jsem potřeboval pouze dávkovou funkčnost Beamu, protože má data nepřicházela v reálném čase, takže Pub/Sub nebyl nutný. Nicméně se zastavím u streamované verze, protože s tím se můžete setkat v praxi.
Úvod do GCP a Apache Beam
Google Cloud Platform nabízí sadu opravdu užitečných nástrojů pro zpracování velkých dat. Zde jsou některé z nástrojů, které budu používat:
- — to je služba pro výměnu zpráv, která používá vzor Publisher-Subscriber, která nám umožňuje přijímat data v reálném čase.
- — to je služba, která zjednodušuje vytváření datových potrubí a automaticky řeší takové úkoly jako škálování infrastruktury, což znamená, že se můžeme soustředit pouze na psaní kódu pro naše potrubí.
- — to je cloudová databáze. Pokud jste obeznámeni s jinými SQL databázemi, s BigQuery se dlouho rozcházet nebudete.
- A nakonec budeme používat Apache Beam, konkrétně se zaměříme na verzi pro Python pro vytvoření našeho potrubí. Tento nástroj nám umožní vytvořit potrubí pro streamové nebo dávkové zpracování, které se integruje s GCP. Je obzvlášť užitečný pro paralelní zpracování a je vhodný pro úlohy typu extrakce, transformace a načítání (ETL), takže pokud potřebujeme přenášet data z jednoho místa na druhé s prováděním transformací nebo výpočtů, Beam je dobrá volba.
Na GCP je k dispozici široká škála nástrojů, takže může být obtížné všechny sledovat a pochopit, k čemu slouží, ale zde je jejich shrnutí pro referenci.
V GCP dostupných velké množství nástrojů, takže může být obtížné pokrýt je všechny, včetně jejich účelu, nicméně Shrnutí pro reference.
Vizualizace našeho pipeline
Pojďme vizualizovat komponenty našeho pipeline na obrázku 1. Na vysoké úrovni chceme shromažďovat uživatelská data v reálném čase, zpracovávat je a předávat do BigQuery. Logy se vytvářejí, když uživatelé interagují s produktem, posílají požadavky na server, které jsou následně logovány. Tato data mohou být zvlášť užitečná pro pochopení, jak uživatelé interagují s naším produktem a zda fungují správně. Celkově bude pipeline obsahovat následující fáze:
Beam tento proces velmi usnadňuje, bez ohledu na to, zda máme streamovaný zdroj dat nebo CSV soubor, a chceme provést dávkové zpracování. Později uvidíte, že v kódu jsou pouze minimální úpravy potřebné k přepnutí mezi nimi. To je jedna z výhod používání Beam.
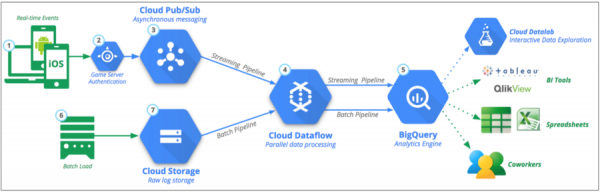
Obrázek 1: Hlavní datový pipeline: Zdroj:
Generování pseudodat pomocí Faker
Jak jsem již zmínil, kvůli omezenému přístupu k datům jsem se rozhodl vytvořit pseudodata ve stejném formátu jako skutečná. Bylo to opravdu užitečné cvičení, protože jsem mohl napsat kód a otestovat pipeline, zatímco jsem čekal na data. Doporučuji se podívat na Faker, pokud chcete vědět, co dalšího tato knihovna může nabídnout. Naše uživatelská data budou celkově podobná níže uvedenému příkladu. Na základě tohoto formátu můžeme řádek po řádku generovat data pro simulaci dat v reálném čase. Tyto logy nám poskytují informace jako datum, typ požadavku, odpověď ze serveru, IP adresu atd.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
Na základě výše uvedeného řetězce chceme vytvořit naši proměnnou ŘÁDEK, používající 7 proměnných ve složených závorkách níže. Také je budeme používat jako názvy proměnných v naší tabulkové schématu o něco později.
ČÁRA = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Kdybychom prováděli dávkové zpracování, kód by byl velmi podobný, i když bychom museli vytvořit sadu vzorků v určitém časovém rozmezí. Pro použití Fakeru jen vytvoříme objekt a zavoláme potřebné metody. Konkrétně mi Faker pomohl při generování IP adres a také webových stránek. Použil jsem následující metody:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "\/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Konec první části.
V příštích dnech se s vámi podělíme o pokračování článku, ale nyní tradičně čekáme na vaše komentáře ;-).
Zdroj: habr.com
