

Kube-scheduler je nedílnou součástí Kubernetes, který odpovídá za plánování podů na uzlech podle zadaných politik. V mnoha případech při provozu Kubernetes klastru nemusíme přemýšlet o tom, podle jakých politik se pod plánují, protože soubor předvolených politik kube-scheduleru vyhovuje většině každodenních úloh. Nicméně se vyskytují situace, kdy je pro nás důležité jemně řídit proces rozdělování podů, a pro splnění tohoto úkolu existují dvě cesty:
- Vytvořit kube-scheduler s vlastním souborem pravidel
- Napsat svůj vlastní scheduler a naučit ho pracovat s požadavky API serveru
V rámci tohoto článku popíšu realizaci právě prvního bodu za účelem řešení problému nerovnoměrného plánování podů na jednom z našich projektů.
Krátký úvod o fungování kube-scheduleru
Je třeba zdůraznit, že kube-scheduler nezodpovídá za přímé plánování podů — odpovídá pouze za určení uzlu, na který má být pod umístěn. Jinými slovy, výsledek práce kube-scheduleru je jméno uzlu, které vrací API serveru na dotaz ohledně plánování, a tím jeho práce končí.
Nejprve kube-scheduler sestaví seznam uzlů, na které může být pod naplánován podle politik predicates. Každý uzel v tomto seznamu následně získává určité množství bodů podle politik priorites. V důsledku toho je vybrán uzel, který získal maximální počet bodů. Pokud existují uzly s totožným maximálním počtem bodů, vybere se náhodně. Seznam a popis politik predicates (filtrace) a priorites (hodnocení) je k dispozici v .
Popis jádra problému
I když máme na starosti velké množství různých Kubernetes klastrů v Nixys, poprvé jsme se s problémem plánování podů setkali až nedávno, když pro jeden z našich projektů vznikla potřeba spustit velké množství periodických úloh (~100 entit CronJob). Abychom co nejvíce zjednodušili popis problému, vezmeme si jako příklad jeden mikroslužbu, v rámci které se každou minutu spouští cron-úloha, která vytváří určitou zátěž na CPU. Pro práci cron-úlohy byly vyčleněny tři úplně identické uzly s charakteristikami (24 vCPU na každém).
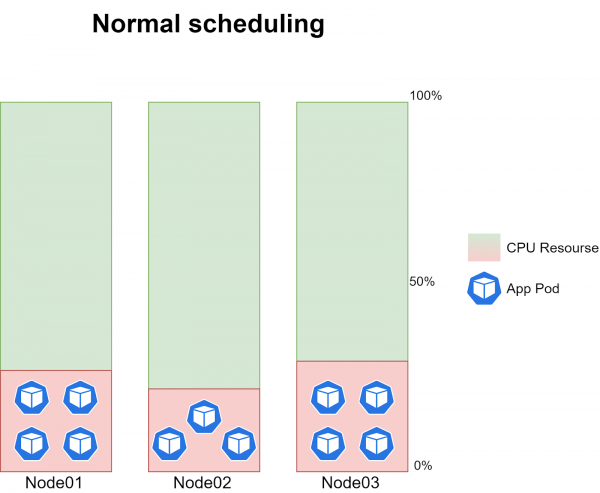
Nelze přesně říct, jak dlouho bude CronJob běžet, protože objem vstupních dat se neustále mění. Průměrně, při normálním fungování kube-scheduleru, běží na každém uzlu 3-4 instance úkolu, které vytvářejí přibližně 20-30% zátěže na CPU každého uzlu:
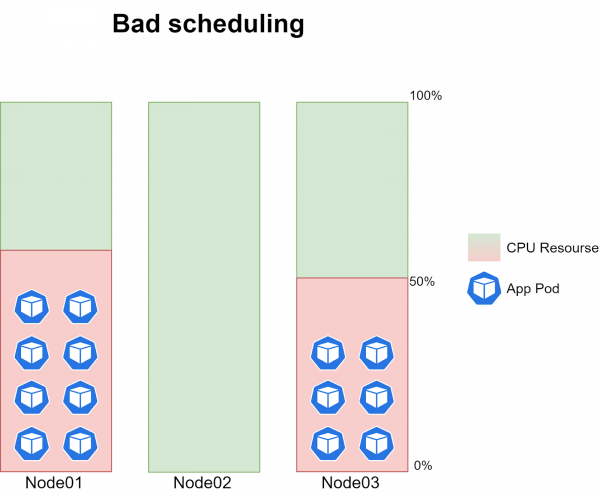
Samotný problém spočívá v tom, že někdy podí cron-úkolu přestávaly být plánovány na jeden ze tří uzlů. To znamená, že v určitém okamžiku nebyl na jednom z uzlů naplánován žádný pod, zatímco na dvou dalších uzlech pracovalo 6-8 instancí úkolu, což vytvářelo přibližně 40-60% zátěže na CPU:
Problém se opakoval s naprosto náhodnou periodicitou a občas se koreloval s okamžikem nasazení nové verze kódu.
Zvýšením úrovně logování kube-scheduleru na úroveň 10 (-v=10) jsme začali zaznamenávat, kolik bodů získává při hodnocení každá z uzlů. Při normálním plánování bylo v logu možné vidět následující informace:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, kapacita 23900 millicores 67167186944 bajtů, celkový požadavek 1387 millicores 4161694720 bajtů, skóre 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, kapacita 23900 millicores 67167186944 bajtů, celkový požadavek 1347 millicores 4444810240 bajtů, skóre 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, kapacita 23900 millicores 67167186944 bajtů, celkový požadavek 1387 millicores 4161694720 bajtů, skóre 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, kapacita 23900 millicores 67167186944 bajtů, celkový požadavek 1687 millicores 4790840320 bajtů, skóre 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, kapacita 23900 millicores 67167186944 bajtů, celkový požadavek 1347 millicores 4444810240 bajtů, skóre 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, kapacita 23900 millicores 67167186944 bajtů, celkový požadavek 1687 millicores 4790840320 bajtů, skóre 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Skóre: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Skóre: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Skóre: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Skóre: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Skóre: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Skóre: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:781] Host Node01 => Skóre 100043
generic_scheduler.go:781] Host Node02 => Skóre 100043
generic_scheduler.go:781] Host Node03 => Skóre 100043
To znamená, že podle informací získaných z logů každá z uzlů získala stejný počet konečných bodů a pro plánování byla vybrána náhodná. V okamžiku problémového plánování logy vypadaly následovně:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, kapacita 23900 milicore 67167186944 paměťových bajtů, celkový požadavek 1587 milicore 4581125120 paměťových bajtů, skóre 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, kapacita 23900 milicore 67167186944 paměťových bajtů, celkový požadavek 1087 milicore 3532549120 paměťových bajtů, skóre 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, kapacita 23900 milicore 67167186944 paměťových bajtů, celkový požadavek 1587 milicore 4581125120 paměťových bajtů, skóre 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, kapacita 23900 milicore 67167186944 paměťových bajtů, celkový požadavek 987 milicore 3322833920 paměťových bajtů, skóre 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, kapacita 23900 milicore 67167186944 paměťových bajtů, celkový požadavek 987 milicore 3322833920 paměťových bajtů, skóre 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, kapacita 23900 milicore 67167186944 paměťových bajtů, celkový požadavek 1087 milicore 3532549120 paměťových bajtů, skóre 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Skóre: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Skóre: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Skóre: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Skóre: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Skóre: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Skóre: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Skóre: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Skóre: (10)
generic_scheduler.go:781] Host Node03 -> Skóre 100041
generic_scheduler.go:781] Host Node02 -> Skóre 100041
generic_scheduler.go:781] Host Node01 -> Skóre 100038
Z čehož je vidět, že jedna z uzlů získala méně bodů než ostatní, a proto bylo plánování prováděno pouze na dvou uzlech, které získaly maximální skóre. Tímto jsme si byli jisti, že problém je opravdu v plánování podů.
Další algoritmus řešení problému nám byl jasný — analyzovat logy, pochopit, na jakém prioritě uzel nezískal body a v případě potřeby upravit politiky výchozího kube-scheduleru. Nicméně jsme se zde setkali s dvěma zásadními obtížemi:
- Na maximální úrovni protokolování (10) se odráží soubor bodů pouze podle některých priorit. V uvedeném výše úryvku logů je možné si všimnout, že podle všech priorit uvedených v logách uzly získávají stejné množství bodů při normálním i problémovém plánování, nicméně finální výsledek v případě problémového plánování se liší. Lze tedy usoudit, že podle některých priorit probíhá počítání bodů "za scénou", a nemáme žádnou možnost zjistit, podle jaké prioritě uzel nezískal body. Tento problém jsme podrobně popsali v repozitoráři Kubernetes na Githubu. V době psaní článku jsme obdrželi odpověď od vývojářů, že podpora protokolování bude přidána v aktualizacích Kubernetes v1.15, 1.16 a 1.17.
- Neexistuje jednoduchý způsob, jak pochopit, s jakým konkrétním souborem politik v současnosti pracuje kube-scheduler. Ano, v tomto seznamu je uvedeno, ale neobsahuje informace o tom, jaké konkrétní váhy byly přiděleny jednotlivým politikám priorit. Vidět váhy nebo upravit politiky výchozího kube-scheduleru lze pouze v .
Je třeba poznamenat, že jednou se nám podařilo zjistit, že uzel nezískal body podle politiky ImageLocalityPriority, která přiděluje body uzlu, pokud na něm již existuje obraz potřebný k spuštění aplikace. Tj. v okamžiku nasazení nové verze aplikace cronúloha stihla spustit na dvou uzlech, načítající na ně nový obraz z docker registry, a tímto způsobem získaly obě uzly větší konečné skóre než třetí.
Jak jsem již zmínil výše, v logách nevidíme informace o hodnocení politiky ImageLocalityPriority, proto abychom ověřili svou domněnku, nasadili jsme obraz s novou verzí aplikace na třetí uzel, po čemž plánování začalo fungovat správně. Problém s plánováním se vyskytoval poměrně zřídka kvůli politice ImageLocalityPriority, častěji to souviselo s něčím jiným. Protože jsme nemohli důkladně debuggovat každou z politik v seznamu priorites výchozího kube-scheduleru, vznikla potřeba flexibilního řízení politik plánování podů.
Formulace úkolu
Chtěli jsme, aby řešení problému bylo co nejvíce cílené, tedy hlavní entity Kubernetes (myšleno výchozí kube-scheduler) by měly zůstat nezměněny. Nechtěli jsme vyřešit problém na jednom místě a vytvořit ho na jiném. Takto jsme dospěli ke dvěma variantám řešení problému, které byly zmíněny v úvodu článku — vytvoření dalšího scheduleru nebo napsání vlastního. Hlavní požadavek na plánování cron-úloh je rovnoměrné rozložení zátěže mezi třemi uzly. Tento požadavek může být splněn již existujícími politikami kube-scheduleru, proto pro řešení našeho úkolu nemá smysl psát vlastní scheduler.
Pokyny k vytvoření a nasazení dalšího kube-scheduleru jsou popsány v . Avšak nám se zdálo, že entity Deployment nejsou dostatečné pro zajištění vysoké dostupnosti tak kritického servisu jako kube-scheduler, a proto jsme se rozhodli nasadit nový kube-scheduler jako Static Pod, o který se bude přímo starat Kubelet. Tímto jsme vytvořili následující požadavky na nový kube-scheduler:
- Služba by měla být nasazena jako Static Pod na všech masterech clusteru
- Měla by být zajištěna vysoká dostupnost pro případ nedostupnosti aktivního podu s kube-schedulerem
- Hlavním prioritním kritériem při plánování by měl být počet dostupných zdrojů na uzlu (LeastRequestedPriority)
Implementace řešení
Je dobré hned poznamenat, že všechny práce budeme provádět v Kubernetes v1.14.7, protože právě tato verze byla použita v projektu. Začneme napsáním manifestu pro náš nový kube-scheduler. Vezmeme za základ manifest výchozího (\/etc\/kubernetes\/manifests\/kube-scheduler.yaml) a přivedeme ho do následující podoby:
kind: Pod
metadata:
  labels:
    component: scheduler
    tier: control-plane
  name: kube-scheduler-cron
  namespace: kube-system
spec:
      containers:
      - command:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        image: gcr.io/google-containers/kube-scheduler:v1.14.7
        imagePullPolicy: IfNotPresent
        livenessProbe:
          failureThreshold: 8
          httpGet:
            host: 127.0.0.1
            path: /healthz
            port: 10151
            scheme: HTTP
          initialDelaySeconds: 15
          timeoutSeconds: 15
        name: kube-scheduler-cron-container
        resources:
          requests:
            cpu: '0.1'
        volumeMounts:
        - mountPath: /etc/kubernetes/scheduler.conf
          name: kube-config
          readOnly: true
        - mountPath: /etc/localtime
          name: localtime
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          name: scheduler-config
          readOnly: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          name: policy-config
          readOnly: true
      hostNetwork: true
      priorityClassName: system-cluster-critical
      volumes:
      - hostPath:
          path: /etc/kubernetes/scheduler.conf
          type: FileOrCreate
        name: kube-config
      - hostPath:
          path: /etc/localtime
        name: localtime
      - hostPath:
          path: /etc/kubernetes/scheduler-custom.conf
          type: FileOrCreate
        name: scheduler-config
      - hostPath:
          path: /etc/kubernetes/scheduler-custom-policy-config.json
          type: FileOrCreate
        name: policy-config
Stručně o hlavních změnách:
- Změnili jsme název podu a kontejneru na kube-scheduler-cron
- Uvedli jsme použití portů 10151 a 10159, neboť je definována možnost
hostNetwork: truea nemůžeme použít stejné porty jako výchozí kube-scheduler (10251 a 10259) - Pomocí parametru —config jsme určili konfigurační soubor, se kterým by měl služba běžet
- Nastavili jsme připojení konfiguračního souboru (scheduler-custom.conf) a souboru plánovacích politik (scheduler-custom-policy-config.json) z hostitele
Nezapomínejme, že našem kube-scheduleru budou potřeba práva, která odpovídají výchozímu. Editujeme jeho clusterovou roli:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Nyní si povíme, co by mělo být obsaženo v konfiguračním souboru a v souboru s plánovacími politikami:
- Konfigurační soubor (scheduler-custom.conf)
Pro získání konfigurace výchozího kube-scheduleru je třeba použít parametr--write-config-toz . Získanou konfiguraci umístíme do souboru /etc/kubernetes/scheduler-custom.conf a převedeme ji do následující podoby:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Stručně o hlavních změnách:
- V parametru schedulerName jsme přiřadili název našeho servisu kube-scheduler-cron.
- V parametru
lockObjectNametaké musíme přiřadit název našeho servisu a ujistit se, že parametrleaderElectje nastaven na hodnotu true (v případě, že máte pouze jeden master node, můžete nastavit hodnotu false). - Specifikovali jsme cestu k souboru s popisem plánovacích politik v parametru
algorithmSource.
Je třeba se podrobněji zaměřit na druhý bod, kde upravujeme parametry pro klíč leaderElection. Pro zajištění odolnosti proti chybám jsme aktivovali (leaderElect) proces volby vůdce (mastera) mezi pody našeho kube-scheduler’u pomocí zdrojového endpointu (resourceLock) s názvem kube-scheduler-cron (lockObjectName) v prostoru názvů kube-system (lockObjectNamespace). O tom, jak je v Kubernetes zajištěna vysoká dostupnost základních komponent (včetně kube-scheduler), se můžete dočíst v .
- Soubor plánovacích politik (scheduler-custom-policy-config.json)
Jak jsem již dříve uvedl — zjistit, s jakými konkrétními politikami pracuje defaultní kube-scheduler, můžeme pouze analýzou jeho kódu. To znamená, že nemůžeme získat soubor s politikami plánování defaultního kube-scheduler’a analogicky k souboru konfigurace. Popíšeme zajímavé nám politiky plánování v souboru /etc/kubernetes/scheduler-custom-policy-config.json následujícím způsobem:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Tímto způsobem kube-scheduler nejprve sestaví seznam uzlů, na které může být naplánován pod podle pravidel GeneralPredicates (která zahrnují soubor pravidel PodFitsResources, PodFitsHostPorts, HostName a MatchNodeSelector). Poté se hodnotí každý uzel podle souboru pravidel v poli priorities. Pro splnění podmínek našeho úkolu jsme dospěli k závěru, že tento soubor pravidel bude optimálním řešením. Připomínám, že soubor pravidel s podrobným popisem je k dispozici v . Pro splnění svého úkolu můžete jednoduše změnit sadu použitých pravidel a přiřadit jim odpovídající váhy.
Manifest nového kube-scheduler, který jsme vytvořili na začátku kapitoly, pojmenujeme kube-scheduler-custom.yaml a umístíme na následující cestu /etc/kubernetes/manifests na třech master uzlech. Pokud vše proběhne správně, Kubelet na každém uzlu spustí pod a v logách našeho nového kube-scheduler uvidíme informace o tom, že náš soubor s pravidly byl úspěšně použit:
Vytváření plánovače z konfigurace: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Registrace predikátu: GeneralPredicates
Typ predikátu GeneralPredicates již registrován, používá se znovu.
Registrace priority: ServiceSpreadingPriority
Typ priority ServiceSpreadingPriority již registrován, používá se znovu.
Registrace priority: EqualPriority
Typ priority EqualPriority již registrován, používá se znovu.
Registrace priority: LeastRequestedPriority
Typ priority LeastRequestedPriority již registrován, používá se znovu.
Registrace priority: NodePreferAvoidPodsPriority
Typ priority NodePreferAvoidPodsPriority již registrován, používá se znovu.
Registrace priority: NodeAffinityPriority
Typ priority NodeAffinityPriority již registrován, používá se znovu.
Vytváření plánovače s vhodnými predikáty 'map[GeneralPredicates:{}]' a funkcemi priority 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Nyní zbývá pouze uvést v spec naší CronJob, že všechny požadavky na plánování jejích podů by měl zpracovávat náš nový kube-scheduler:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Závěr
Nakonec jsme získali další kube-scheduler s unikátní sadou pravidel plánování, o jehož činnost dohlíží přímo kubelet. Kromě toho jsme nastavili volby nového lídra mezi pody našeho kube-scheduler v případě, že by starý lídr z nějakého důvodu nebyl dostupný.
Běžné aplikace a služby se nadále plánují pomocí výchozího kube-scheduleru, zatímco všechny cron úlohy byly zcela převedeny na nový. Zátěž vytvářená cron úlohami je nyní rovnoměrně rozložena mezi všechny nody. Vzhledem k tomu, že většina cron úloh se provádí na stejných nodech jako hlavní aplikace projektu, podařilo se výrazně snížit riziko přesunu podů kvůli nedostatku zdrojů. Po zavedení dalšího kube-scheduleru již nevznikly problémy s nerovnoměrným plánováním cron úloh.
Také si přečtěte další články na našem blogu:
Zdroj: habr.com
