

Ahoj všichni! Jmenuji se Kirill, jsem CTO ve společnosti Adapty. Většina naší architektury běží na AWS, a dnes vám povím, jak jsme snížili náklady na servery třikrát díky použití spot instancí v produkčním prostředí, a také jak je nastavit pro automatické škálování. Nejprve bude přehled toho, jak to funguje, a poté podrobný návod na spuštění.
Co jsou to spot instance?
instance jsou servery od jiných uživatelů AWS, které v tuto chvíli nepracují, a ti je prodávají s velkou slevou (Amazon uvádí až 90%, z naší zkušenosti ~3x, mění se v závislosti na regionu, AZ a typu instance). Hlavní rozdíl oproti běžným je, že se mohou kdykoliv vypnout. Proto jsme dlouho považovali, že je správné je používat pro vývojová prostředí, nebo pro úlohy, které něco počítají, s ukládáním meziproduktů na S3 nebo do databáze, ale ne pro produkci. Existují třetí strany, které umožňují používat spoty v produkci, ale v našem případě tam bylo mnoho workaroundů, takže jsme je neimplementovali. Přístup popsaný v článku funguje úplně v rámci standardního funkčního rozsahu AWS, bez dodatečných skriptů, cronů atd.
Následující uvádím několik screenshotů, které ukazují historii cen spot instancí.
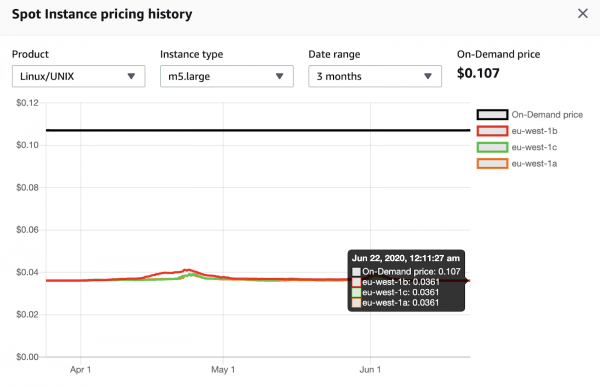
m5.large v regionu eu-west-1 (Irsko). Cena je převážně stabilní po dobu 3 měsíců, aktuálně úspora 2.9x.
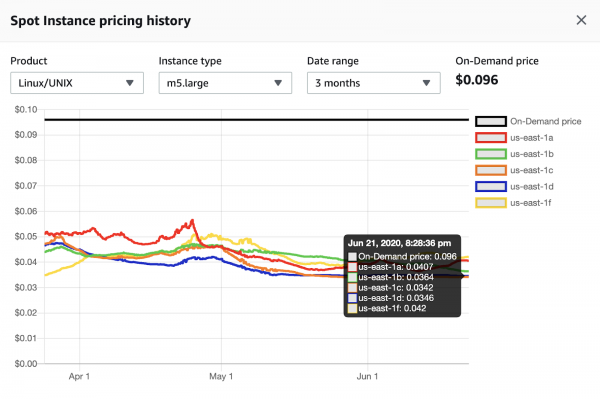
m5.large v regionu us-east-1 (Severní Virginie). Cena se neustále mění po dobu 3 měsíců, aktuálně úspora od 2.3x do 2.8x v závislosti na dostupnostní zóně.
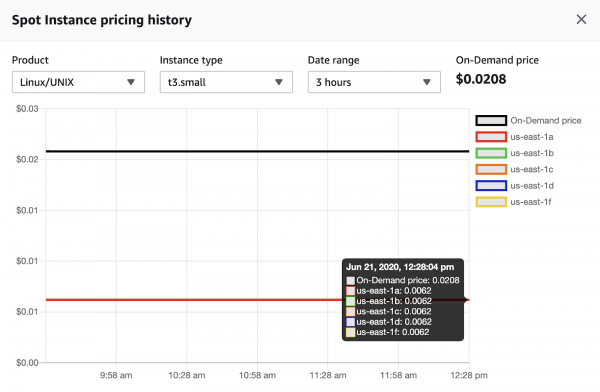
t3.small v regionu us-east-1 (Severní Virginie). Cena je stabilní po dobu 3 měsíců, aktuálně úspora 3.4x.
Architektura služby
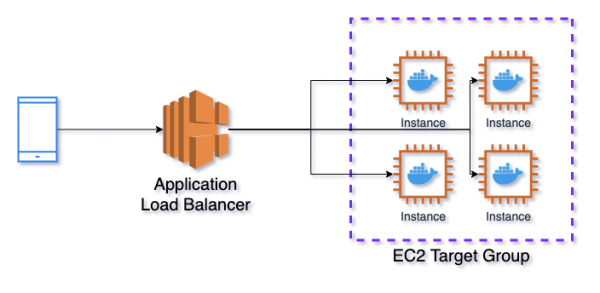
Základní architektura služby, o které se budeme bavit v rámci tohoto článku, je znázorněna na diagramu níže.
Application Load Balancer → EC2 Target Group → Elastic Container Service
Jako vyvažovač se používá Application Load Balancer (ALB), který směruje požadavky do EC2 Target Group (TG). TG zajišťuje, že otevře na instancích porty pro ALB a propojí je s porty kontejnerů Elastic Container Service (ECS). ECS je obdobou Kubernetes v AWS, který se zabývá správou Docker kontejnerů.
Na jednom instance může být několik běžících kontejnerů se stejnými porty, a proto je není možné pevně nastavit. ECS informuje TG, že spouští novou úlohu (v terminologii Kubernetes se tomu říká pod), provádí kontrolu volných portů na instanci a přiřadí jeden z nich pro spuštěnou úlohu. TG také pravidelně kontroluje, zda instance a API na ní fungují pomocí health checku, a pokud zjistí nějaké problémy, přestane na ně odesílat požadavky.
EC2 Auto Scaling Groups + ECS Capacity Providers
Na výše uvedeném diagramu není zobrazen služba EC2 Auto Scaling Groups (ASG). Z názvu je jasné, že zodpovídá za škálování instancí. Do nedávna však AWS nemělo vestavěnou možnost řídit počet běžících strojů z ECS. ECS umožňovalo škálovat počet úloh, například podle využití CPU, RAM nebo počtu požadavků. Ale pokud úlohy zabraly všechny volné instance, nové stroje se automaticky nezvedaly.
To se změnilo s příchodem ECS Capacity Providers (ECS CP). Nyní lze každý servis v ECS propojit s ASG, a pokud se úlohy nevejdou na běžící instance, nová instance se zvednou (ale v rámci stanovených limitů ASG). To funguje i naopak; pokud ECS CP vidí nevyužívané instance bez úloh, vydá příkaz ASG, aby je vypnula. ECS CP má možnost nastavit cílové procento vytížení instancí, aby bylo vždy k dispozici určité množství strojů pro rychlé škálování úloh, o tom budu mluvit později.
EC2 Launch Templates
Poslední služba, o které budu hovořit, než se přejde k podrobnému popisu vytváření této infrastruktury, je EC2 Launch Templates. Umožňuje vytvořit šablonu, podle které budou všechny stroje spouštěny, abychom nemuseli každý krok opakovat od začátku. Zde lze vybrat typ spouštěného stroje, bezpečnostní skupinu, obraz disku a mnoho dalších parametrů. Také je možné zadat uživatelská data, která budou nahrána na všechny spuštěné instance. V uživatelských datech lze spouštět skripty, například lze upravit obsah souboru .
Jedním z nejdůležitějších parametrů konfigurace v rámci tohoto článku je =true. Pokud je tento parametr povolen, jakmile ECS obdrží signál, že je prostorový instance odebrán, převede všechny úkoly běžící na něm do stavu Draining. Žádné nové úkoly nebudou na tuto instanci přiřazeny, pokud jsou úkoly, které se právě chtějí na něj rozvinout, zrušeny. Požadavky z vyrovnávače zatížení také přestávají přicházet. Notifikace o odstranění instance přichází 2 minuty před skutečným událostí. Pokud tedy váš servis neprovádí úkoly déle než 2 minuty a nic neuchovává na disku, můžete použít prostorové instance bez ztráty dat.
Pokud jde o disk — AWS nedávno použití Elastic File System (EFS) spolu s ECS, s touto schémou ani disk není překážkou, ale my jsme to nezkoušeli, protože v zásadě disk nepotřebujeme pro ukládání stavu. Ve výchozím nastavení po obdržení SIGINT (odesílá se v momentě přechodu úkolu do stavu Draining) budou všechny běžící úkoly zastaveny během 30 sekund, i když se jim nepodařilo dokončit, tuto dobu lze změnit pomocí parametru . Hlavně ho nedávejte delší než 2 minuty pro prostorové stroje.
Vytvoření služby
Přejdeme přímo k vytvoření popsané služby. V průběhu popíšu několik dalších užitečných bodů, které nebyly zmíněny výše. Celkově se jedná o krokový návod, ale základní nebo naopak velmi specifické případy nebudu zvažovat. Všechny akce se provádějí ve vizuální konzoli AWS, ale lze je replikovat programově pomocí CloudFormation nebo Terraform. V Adapty používáme Terraform.
Šablona spuštění EC2
V této službě se vytváří konfigurace strojů, které budou používány. Správa šablon probíhá v sekci EC2 -> Instance -> Šablony spuštění.
Obrázek Amazon machine (AMI) — uvádíme obraz disku, s kterým budou spuštěny všechny instance. Pro ECS většinou doporučujeme používat optimalizovaný obraz od Amazonu. Ten je pravidelně aktualizován a obsahuje vše potřebné pro práci ECS. Pro zjištění aktuálního ID obrazu přejděte na stránku , vyberte používaný region a zkopírujte ID AMI pro něj. Například pro region us-east-1 je aktuální k momentu psaní článku ID — ami-00c7c1cf5bdc913ed. Toto ID je třeba vložit do položky Určit vlastní hodnotu.
Typ instance — vyberte typ instance. Zvolte ten, který nejlépe vyhovuje vašemu úkolu.
Klíčový pár (přihlášení) — určujeme certifikát, pomocí kterého se lze připojit k instanci přes SSH, pokud je to potřeba.
Nastavení sítě — specifikujte parametry sítě. Síťová platforma ve většině případů by měla být Virtual Private Cloud (VPC). Bezpečnostní skupiny — bezpečnostní skupiny pro vaše instance. Protože budeme používat vyvažovač zátěže před instancemi, doporučuji zde uvést skupinu, která povoluje příchozí připojení pouze z vyvažovače. To znamená, že budete mít 2 bezpečnostní skupiny, jednu pro vyvažovač, která povoluje příchozí spojení odkudkoliv na porty 80 (http) a 443 (https), a druhou pro stroje, která povoluje příchozí spojení na jakékoliv porty ze skupiny vyvažovače. Odchozí spojení v obou skupinách by mělo být otevřeno podle protokolu TCP na všechny porty na všechny adresy. Můžete omezit porty a adresy pro odchozí spojení, ale pak je třeba neustále sledovat, abyste se pokusili připojit někam na uzavřený port.
Úložiště (objemy) — specifikujte parametry disků pro stroje. Velikost disku nemůže být menší než ta, která je uvedena v AMI, pro ECS Optimized — 30 GiB.
Pokročilé detaily — určujeme další parametry.
Možnost nákupu — chceme kupovat spottové instance. Chceme, ale zde tuto možnost neoznačíme, nastavíme to ve skupině auto scaling, tam je více voleb.
IAM profil instance — uvádíme roli, s níž budou instance spuštěny. Aby instance fungovaly v ECS, potřebují oprávnění, která obvykle patří k roli ecsInstanceRole. V některých případech může být vytvořena, pokud ne, zde o tom, jak to udělat. Po vytvoření ji uvedeme v šabloně.
Dále následuje mnoho parametrů, většinou je možné ponechat výchozí hodnoty, ale každá z nich má jasný popis. Vždy zahrnuji parametry EBS-optimized instance a T2/T3 Unlimited, pokud se používají instance.
Uživatelská data — uvádíme uživatelská data. Budeme měnit soubor /etc/ecs/ecs.config, ve kterém leží konfigurace agenta ECS.
Příklad toho, jak může vypadat uživatelská data:
#!/bin/bash
echo ECS_CLUSTER=DemoApiClusterProd >> /etc/ecs/ecs.config
echo ECS_ENABLE_SPOT_INSTANCE_DRAINING=true >> /etc/ecs/ecs.config
echo ECS_CONTAINER_STOP_TIMEOUT=1m >> /etc/ecs/ecs.config
echo ECS_ENGINE_AUTH_TYPE=docker >> /etc/ecs/ecs.config
echo "ECS_ENGINE_AUTH_DATA={"registry.gitlab.com":{"username":"username","password":"password"}}" >> /etc/ecs/ecs.config
ECS_CLUSTER=DemoApiClusterProd — parametr určuje, že instance patří do clustera se zadaným názvem, což znamená, že tento cluster může na tomto serveru umísťovat své úkoly. Zatím jsme nevytvořili cluster, ale při jeho vytváření budeme používat toto jméno.
ECS_ENABLE_SPOT_INSTANCE_DRAINING=true — parametr určuje, že při obdržení signálu o vypnutí spotové instance, všechny úkoly na ní musí být převedeny do stavu Draining.
ECS_CONTAINER_STOP_TIMEOUT=1m — parametr určuje, že po obdržení signálu SIGINT mají všechny úkoly 1 minutu, než budou zabity.
ECS_ENGINE_AUTH_TYPE=docker — parametr určuje, že jako mechanismus autorizace se používá docker schéma.
ECS_ENGINE_AUTH_DATA=... — parametry připojení k soukromému kontejnerovému registru, kde jsou uloženy vaše Docker obrazy. Pokud je veřejný, není potřeba nic uvádět.
V rámci tohoto článku budu používat veřejný obraz z Docker Hub, proto nebude potřeba uvádět parametry ECS_ENGINE_AUTH_TYPE a ECS_ENGINE_AUTH_DATA není nutné.
Užitečné vědět: doporučuje se pravidelně aktualizovat AMI, protože v nových verzích se aktualizují verze Dockeru, Linuxu, ECS agenta a dalších. Abychom na to nezapomněli, můžeme o vydání nových verzí. Můžete dostávat upozornění na email a aktualizovat ručně, nebo můžete napsat Lambda funkci, která automaticky vytvoří novou verzi Launch Template s aktualizovaným AMI.
EC2 Auto Scaling Group
Auto Scaling Group je zodpovědná za spuštění a škálování instancí. Správa skupin se provádí v části EC2 -> Auto Scaling -> Auto Scaling Groups.
Šablona pro spuštění — vybíráme vytvořenou v předchozím kroku šablonu. Verzi ponecháme výchozí.
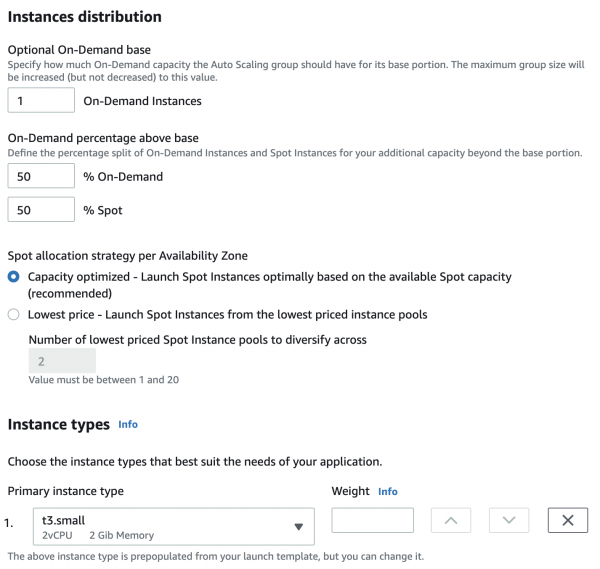
Možnosti nákupu a typy instancí — uvádíme typy instancí pro cluster. Adhere to launch template používá typ instance ze šablony. Combine purchase options and instance types umožňuje flexibilně nastavit typy instancí. Použijeme jej.
Volitelný základ On-Demand — počet běžných, ne spotových instancí, které budou vždy aktivní.
Procento nad základním On-Demand — procentuální poměr běžných a spotových instancí, 50-50 bude rozděleno rovnoměrně, 20-80 znamená, že k každé běžné instanci budou přidány 4 spotové. V rámci tohoto příkladu uvedu 50-50, ale ve skutečnosti nejčastěji děláme 20-80, v některých případech 0-100.
Typy instancí — zde můžete uvést další typy instancí, které budou použity ve clusterech. Nikdy jsme to nepoužívali, protože tomu příliš nerozumím. Možná se to týká limitů na konkrétní typy instancí, ale ty se snadno zvyšují prostřednictvím podpory. Pokud znáte využití, rád si přečtu v komentářích)
Síť — nastavení sítě, vybíráte VPC a subnety pro stroje, v drtivé většině případů byste měli zvolit všechny dostupné subnety.
Zátěžové vyvažování — nastavení vyrovnávače zátěže, ale to uděláme zvlášť, tady nic neměníme. Kontroly stavu budou také nastaveny později.
Velikost skupiny — uvádíme limity na počet strojů v clusterech a požadovaný počet strojů při spuštění. Počet strojů v clusterech nikdy nebude menší než minimálně uvedený a větší než maximální, i když podle metrik by mělo dojít k škálování.
Politiky škálování — parametry škálování, ale budeme škálovat na základě spuštěných ECS úloh, proto nastavíme škálování později.
Ochrana proti škálování instancí — ochrana instancí před odstraněním při škálování dolů. Zapneme, aby ASG neodstranila stroj, na kterém jsou aktivní úlohy. Ochranu vypneme pro instance, na kterých nejsou úlohy, to bude ECS Capacity Provider.
Přidat štítky — můžete uvést štítky pro instance (pro to musí být zaškrtnuta volba Tag new instances). Doporučuji uvést štítek Name, pak budou všechny instance, které se spouští v rámci skupiny, mít stejné jméno, což bude pohodlné při sledování v konzoli.
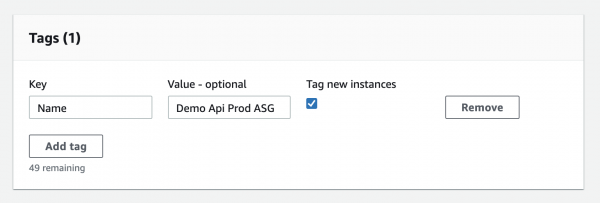
Po vytvoření skupiny ji otevřete a přejděte do sekce Advanced configurations, proč nejsou při vytváření v konzoli vidět všechny možnosti.
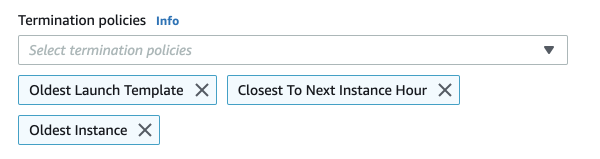
Politiky ukončení — pravidla, která se zohledňují při odstraňování instancí. Aplikují se v pořadí. Obvykle používáme takové, jako jsou na obrázku níže. Nejprve se odstraňují instance s nejstarším Launch Template (například pokud jsme aktualizovali AMI, vytvořila se nám nová verze, ale všechny instance na ni stihly přejít). Pak se vybírají instance, které jsou nejblíže k následujícímu vypočítanému hodině pro billing. A dále se vybírají nejstarší podle data spuštění.
Užitečné vědět: pro aktualizaci všech strojů v clusterech, pohodlně použijte . Pokud to zkombinujete s Lambda funkcí z předchozího kroku, budete mít plně automatizovaný systém aktualizace instancí. Před aktualizací všech strojů je nutné vypnout ochranu proti zmenšení instance pro všechny instance ve skupině. Ne nastavení ve skupině, ale právě ochrana na samotných strojích, to se provádí na záložce Správa instancí.
Application Load Balancer a EC2 Target Group
Vyvažovač se vytváří v sekci EC2 → Vyvažování zátěže → Vyvažovače. Budeme používat Application Load Balancer, srovnání různých typů vyvažovačů si můžete přečíst na .
Posluchači — má smysl nastavit porty 80 a 443 a provést přesměrování z 80 na 443 později pomocí pravidel vyvažovače.
Zóny dostupnosti — v mnoha případech vybíráme všechny zóny dostupnosti.
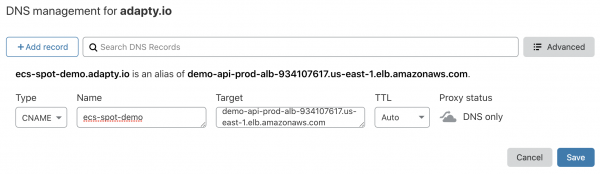
Nastavit bezpečnostní nastavení — zde se uvádí SSL certifikát pro vyvažovač, nejvhodnější variantou je v ACM. O rozdílech Bezpečnostní politika si můžete přečíst na , můžete nechat výchozí vybraný ELBSecurityPolicy-2016-08. Po vytvoření vyvažovače uvidíte jeho DNS název, na který je třeba nastavit CNAME pro vaši doménu. Například, takto to vypadá v Cloudflare.
Skupina zabezpečení — vytváříme nebo vybíráme skupinu zabezpečení pro vyvažovač, podrobnosti o tom jsem psal o něco výše v sekci EC2 Launch Template → Síťová nastavení.
Cílová skupina — vytváříme skupinu, která odpovídá za směrování požadavků z vyvažovače na stroje a kontroluje jejich dostupnost, aby je nahradila v případě problémů. Typ cíle musí být Instance, Protokol a Port jakékoli, pokud používáte HTTPS pro komunikaci mezi vyvažovačem a instancemi, je potřeba na ně nahrát certifikát. V rámci tohoto příkladu to dělat nebudeme, jednoduše necháme port 80.
Kontroly stavu — parametry kontroly funkčnosti služby. Ve skutečné službě by to měl být samostatný požadavek, který realizuje důležité části obchodní logiky, v rámci tohoto příkladu bych ponechal nastavení podle výchozího stavu. Dále můžete vybrat interval požadavků, časový limit, kódy úspěšných odpovědí atd. V našem příkladu uvedeme kódy úspěchu 200-399, protože Docker obraz, který bude použit, vrací kód 304.
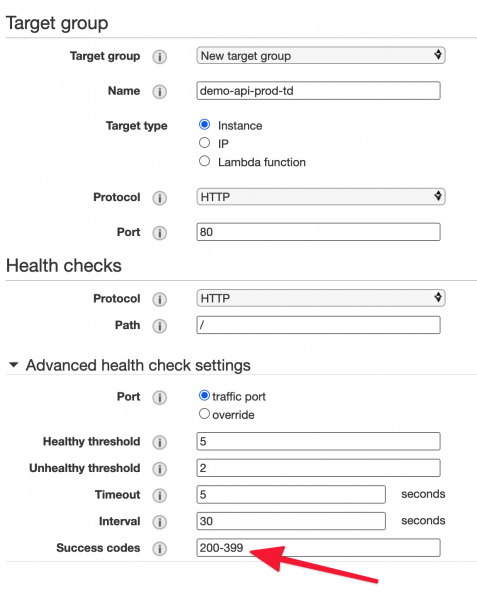
Registrovat cíle — zde se vybírají stroje pro skupinu, ale v našem případě se tím zabývá ECS, takže tento krok jednoduše přeskočíme.
Užitečné vědět: na úrovni vyvažovače můžete zapnout protokoly, které se budou ukládat do S3 na určeném místě . Odtud je možné je exportovat do externích služeb pro analýzu, nebo provádět SQL dotazy přímo na datech v S3 pomocí . To je pohodlné a funguje to bez nějakého dalšího kódu. Také doporučuji nastavit odstraňování logů z bucketu S3 po uplynutí stanoveného časového období.
ECS Task Definition
Na předchozích krocích jsme vytvořili vše, co se týká infrastruktury služby, nyní přecházíme k popisu kontejnerů, které budeme spouštět. To se provádí v sekci ECS → Task Definitions.
Typ kompatibility spuštění — vybíráme EC2.
IAM role pro provádění úloh — vybíráme ecsTaskExecutionRole. Pomocí ní se zapisují logy, poskytuje se přístup k tajným proměnným atd.
V sekci Container Definitions klikneme na Přidat kontejner.
Obrázek — odkaz na obraz s kódem projektu, v rámci tohoto příkladu budu používat veřejný obraz z Docker Hub .
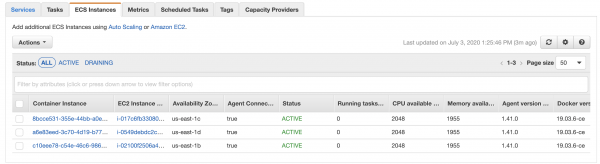
Limity paměti — limity paměti pro kontejner. Tvrdý limit — tvrdý limit, pokud kontejner překročí uvedenou hodnotu, provede se příkaz docker kill, kontejner okamžitě umře. Měkký limit — měkký limit, kontejner může překročit uvedenou hodnotu, ale při umisťování úloh na stroje se tento parametr zohledňuje. Například, pokud má stroj 4 GiB operační paměti a měkký limit kontejneru je 2048 MiB, pak mohou na tomto stroji běžet maximálně 2 úlohy s tímto kontejnerem. Ve skutečnosti je 4 GiB operační paměti o něco méně než 4096 MiB, to lze zjistit na kartě ECS Instances v clustru. Měkký limit nemůže být vyšší než tvrdý limit. Je důležité pochopit, že pokud je v jedné úloze několik kontejnerů, jejich limity se sčítají.
Přesměrování portů — v Hostitelský port uvádíme 0, to znamená, že port bude přidělován dynamicky, jeho sledování zajistí Target Group. Port kontejneru — port, na kterém běží vaše aplikace, často je nastavován v příkazu pro spuštění nebo určen v kódu vaší aplikace, Dockerfile atd. Pro náš příklad použijeme 3000, protože je uveden v používaném obraze.
Kontrola zdraví — parametry kontroly provozuschopnosti kontejneru, neměli byste je zaměňovat s těmi, které jsou nastaveny v Target Group.
Prostředí — nastavení prostředí. CPU jednotky — podobné jako Memory limits, ale jde o procesor. Každé jádro procesoru představuje 1024 jednotek, takže pokud má server dvoujádrový procesor a kontejner má nastavenou hodnotu 512, pak je možné na jednom serveru spustit 4 úlohy s tímto kontejnerem. Jednotky CPU vždy odpovídají počtu jader, nemohou být o něco menší, jak je tomu u paměti.
Příkaz — příkaz pro spuštění služby uvnitř kontejneru, všechny parametry jsou uvedeny čárkou. Může to být gunicorn, npm atd. Pokud není uvedeno, použije se hodnota direktivy CMD z Dockerfile. Uvádíme npm,start.
Proměnné prostředí — proměnné prostředí kontejneru. Mohou to být buď jednoduché textové údaje, nebo tajné proměnné z nebo .
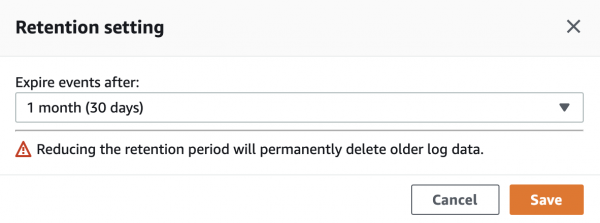
Úložiště a protokolování — zde nastavíme protokolování v CloudWatch Logs (služba pro logy od AWS). Stačí zaškrtnout políčko Auto-configure CloudWatch Logs. Po vytvoření Task Definition se automaticky vytvoří skupina logů v CloudWatch. Ve výchozím nastavení jsou logy v ní uchovávány neomezeně, doporučuji změnit Retention period z Never Expire na požadovanou dobu. To se provádí v CloudWatch Log groups, je třeba kliknout na aktuální období a vybrat nové.
ECS Cluster a ECS Capacity Provider
Přejdeme do sekce ECS → Clusters, abychom vytvořili cluster. Jako šablonu vybereme EC2 Linux + Networking.
Název clusteru — velmi důležité, dáme zde stejné jméno, jako je uvedeno v Launch Template v parametru ECS_CLUSTER, v našem případě — DemoApiClusterProd. Zaškrtněte políčko Create an empty cluster. Volitelně můžete zapnout Container Insights, abyste mohli sledovat metriky podle služeb v CloudWatch. Pokud jste všechno udělali správně, v sekci ECS Instances uvidíte stroje, které byly vytvořeny ve skupině Auto Scaling.
Přejdeme na záložku Capacity Providers a vytvoříme nový. Připomínám, že je potřeba pro řízení vytváření a vypínání strojů v závislosti na počtu běžících úloh ECS. Je důležité poznamenat, že poskytovatel může být vázán pouze na jednu skupinu.
Auto Scaling group — vybíráme dříve vytvořenou skupinu.
Managed scaling — zapneme, aby poskytovatel mohl škálovat službu.
Cílová kapacita % — jaký procento zatížení strojů úkoly potřebujeme. Pokud nastavíme 100 %, všechny stroje budou vždy obsazené pracovními úkoly. Pokud nastavíme 50 %, polovina strojů bude vždy volná. V takovém případě, pokud dojde k náhlému nárůstu zátěže, nové úkoly se okamžitě dostanou na volné stroje, aniž bychom museli čekat na nasazení instancí.
Ochrana řízeného ukončení — zapnuto, tento parametr umožňuje poskytovateli odstranit ochranu instancí proti smazání. K tomu dochází, když na stroji nejsou aktivní úkoly a umožňuje Target capacity %.
Služba ECS a nastavení škálování
Poslední krok :) Abyste vytvořili službu, musíte přejít do dříve vytvořeného clusteru na záložku Služby.
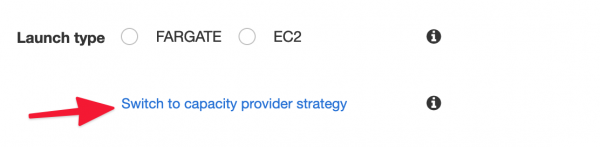
Typ spuštění — je třeba kliknout na Přepnout na strategii poskytovatele kapacity a vybrat dříve vytvořeného poskytovatele.
Definice úkolu — vybíráme dříve vytvořenou definici úkolu a její revizi.
Název služby — abychom se neztratili, vždy uvádíme stejný jako definici úkolu.
Typ služby — vždy Replica.
Počet úkolů — požadovaný počet aktivních úkolů ve službě. Tento parametr je řízen škálováním, ale stejně ho musíme uvést.
Minimální zdravý procento a Maximální procento — určují chování úkolů při nasazení. Výchozí hodnoty 100 a 200 naznačují, že během nasazení se počet úkolů zdvojnásobí a poté se vrátí na požadovaný. Pokud máte 1 úkol, min=0 a max=100, pak během nasazení bude zrušen a poté bude spuštěn nový, což znamená výpadek. Pokud pracuje 1 úkol, min=50, max=150, pak nasazení vůbec nenastane, protože 1 úkol nelze rozdělit na polovinu nebo zvýšit na polovinu.
Typ nasazení — ponecháváme Rolling update.
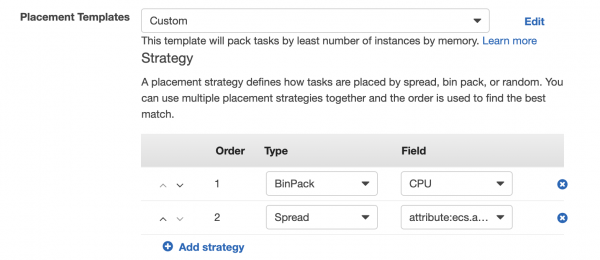
Šablony umístění — pravidla umístění úkolů na strojích. Výchozí nastavení je AZ Balanced Spread — to znamená, že každý nový úkol bude umístěn na novou instanci, dokud se nezvýší stroje ve všech dostupnostních zónách. Obvykle děláme BinPack — CPU a Spread — AZ, s touto politikou se úkoly umísťují co nejhustěji na jeden stroj podle CPU. Při potřebě vytvoření nového stroje se vytvoří v nové dostupnostní zóně.
Typ vyvážení zatížení — vybíráme Application Load Balancer.
IAM role služby — vybíráme ecsServiceRole.
Název vyvážení zatížení — vybíráme dříve vytvořený vyvažovač.
Doba grace pro kontrolu zdraví — pauza před provedením kontrol zdraví po nasazení nového úkolu, obvykle nastavujeme 60 sekund.
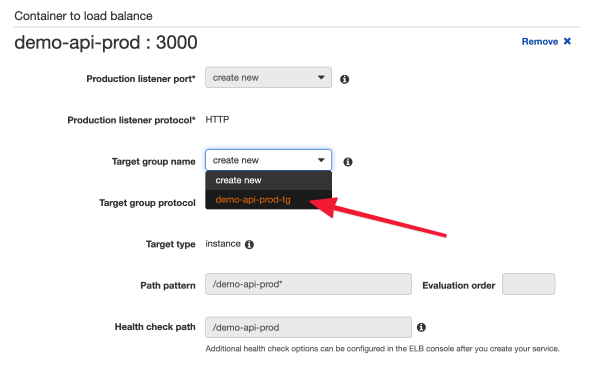
Kontejner pro vyvažování zatížení — v položce Název cílové skupiny vybereme dříve vytvořenou skupinu a vše se automaticky vyplní.
Auto škálování služby — parametry škálování služby. Vybereme Konfigurovat automatické škálování služby pro úpravu požadovaného počtu vaší služby. Nastavíme minimální a maximální počet úloh při škálování.
IAM role pro automatické škálování služby — vybíráme AWSServiceRoleForApplicationAutoScaling_ECSService.
Automatické politiky škálování úloh — pravidla pro škálování. Existují 2 typy:
- Sledování cíle — sledování cílové metriky (využití CPU/RAM nebo počet požadavků na každou úlohu). Například chceme, aby průměrné zatížení procesoru bylo 85 %, a když vzroste nad tuto hodnotu, nové úlohy se budou přidávat, dokud nedosáhnou cílové hodnoty. Pokud je zatížení nižší, úlohy se naopak odeberou, pokud není aktivována ochrana proti zmenšování škálování (Deaktivovat zmenšení škálování).
- Krokové škálování — reakce na náhodnou událost. Zde lze nastavit reakci na jakoukoli událost (CloudWatch Alarm), kdy se událost stane, můžeme přidat nebo odebrat stanovený počet úloh, nebo určit přesný počet úloh.
Služba může mít několik pravidel škálování, to může být užitečné, hlavně je sledovat, aby si navzájem neodporovala.
Závěr
Pokud jste postupovali podle pokynů a použili stejný Docker image, vaše služba by měla vrátit tuto stránku.

- Vytvořili jsme šablonu, podle které se spouštějí všechny instance v službě. Také jsme se naučili aktualizovat instance při změně šablony.
- Nastavili jsme zpracování signálu pro zastavení spottového instance, takže během jedné minuty po jeho přijetí jsou všechny běžící úlohy odstraněny z instance, tímto způsobem se nic neztrácí a nepřerušuje.
- Zvedli jsme vyrovnávač zatížení, abychom rovnoměrně rozložili zátěž mezi instance.
- Vytvořili jsme službu, která pracuje na spottových instancích, díky čemuž se náklady na instance sníží přibližně na třetinu.
- Nastavili jsme automatické škálování oběma směry, abychom zvládli nárůst zátěže, ale zároveň za nečinnost neplatili.
- Používáme Capacity Provider, aby aplikace spravovala infrastrukturu (instance), a ne naopak.
- Jsme skvělí.
Pokud máte předvídatelné výkyvy zátěže, například pokud se inzerujete v rozsáhlém emailovém zasílání, můžete nastavit škálování podle .
Také je možné provádět škálování na základě dat z různých částí vašeho systému. Například máme funkci uživatelům mobilní aplikace. Někdy je kampaň rozesílána na více než 1M lidí. Po takovém rozesílání je vždy zaznamenán velký nárůst dotazů na API, protože mnoho uživatelů se současně přihlašuje do aplikace. Pokud tedy vidíme, že v čekací frontě na odeslání propagačních push notifikací je výrazně více, než jsou standardní hodnoty, můžeme okamžitě spustit několik dalších strojů a úloh, abychom byli připraveni na zatížení.
Budu potěšen, pokud v komentářích sdílíte zajímavé případy použití spotových instancí a ECS, nebo něco ohledně škálování.
Brzy budou články o tom, jak zpracováváme tisíce analytických událostí za sekundu na převážně bezserverovém stacku (za peníze) a jak je zajištěno nasazení služeb pomocí GitLab CI a Terraform Cloud.
Sledujte nás, bude to zajímavé!
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
Používáte spotové instance na produkci?
22,2%Ano6
66,7%Ne18
11,1%O těchto instancích jsem se dozvěděl z článku, plánuju je použít.
Hlasovalo 27 uživatelů. Zdrželi se 5 uživatelů.
Zdroj: habr.com
