

Občas se vyskytne úkol pro vyhledání souvisejících dat podle sady klíčů, dokud nenajdeme požadovaný souhrnný počet záznamů..
Nejživější příklad — vypsat 20 nejstarších úloh, které jsou na seznamu zaměstnanců (například v rámci jednoho oddělení). Pro různé manažerské „dashbordy“ se stručnými přehledy o pracovních oblastech je podobné téma poměrně často potřeba.
V článku se zaměříme na realizaci v PostgreSQL „naivního“ variantu řešení takového úkolu, „inteligentnější“ a úplně složitý algoritmus „cyklu“ v SQL s podmínkou ukončení na základě nalezených dat, který může být užitečný jak pro obecný rozvoj, tak pro použití v dalších podobných případech.
Vezmeme testovací sadu dat z . Aby se vypsané záznamy „neskákaly“ od případu k případu při shodě tříděných hodnot, rozšíříme předmětový index přidáním primárního klíče. Tímto mu také okamžitě dodáme unikátnost a zajistíme jednoznačnost pořadí třídění:
CREATE INDEX ON task(owner_id, task_date, id);
-- a starý - odstraníme
DROP INDEX task_owner_id_task_date_idx;
Jak se slyší, tak se píše
Nejprve načrtneme nejjednodušší variantu dotazu, předáváme ID zpracovatelů :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 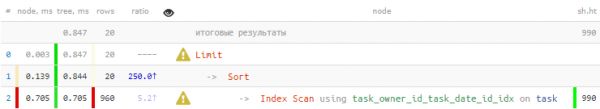
Trochu smutné — objednali jsme pouze 20 záznamů, ale Index Scan nám vrátil 960 řádků, které jsme pak ještě museli třídit... A co kdybychom zkusili číst méně.
unnest + ARRAY
První myšlenka, která nám pomůže — pokud potřebujeme pouze 20 seřazených záznamů, stačí číst ne více než 20 seřazených ve stejném pořadí pro každý klíč. Naštěstí máme vhodný index (owner_id, task_date, id).
Využijeme stejný mechanismus pro extrakci a „obrat v sloupce“ celistvého záznamu tabulky, jaký byl v . A také použijeme zabalování do pole pomocí funkce ARRAY():
WITH T AS (
  SELECT
    unnest(ARRAY(
      SELECT
        t
      FROM
        task t
      WHERE
        owner_id = unnest
      ORDER BY
        task_date, id
      LIMIT 20 -- tady omezujeme...
    )) r
  FROM
    unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
)
SELECT
  (r).*
FROM
  T
ORDER BY
  (r).task_date, (r).id
LIMIT 20; -- ... a tady - také 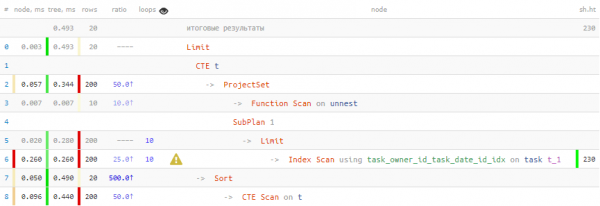
O, už to je mnohem lepší! O 40% rychleji, a 4,5krát méně dat bylo nutné přečíst.
Materializace záznamů tabulek přes CTERád bych upozornil, že v některých případech pokusy o okamžitou práci s poli záznamu po jeho vyhledání v poddotazu, bez „obalení“ do CTE, mohou vést k „násobení“ InitPlanu proporcionálně k počtu těchto polí:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Výsledek (náklady=4.77..4.78 řádků=1 šířka=16) (skutečný čas=0.063..0.063 řádků=1 cykly=1)
Buffery: sdílený zásah=16
InitPlan 1 (vrací $0)
-> Limit (náklady=0.42..1.19 řádků=1 šířka=48) (skutečný čas=0.031..0.032 řádků=1 cykly=1)
Buffery: sdílený zásah=4
-> Index Scan pomocí task_owner_id_task_date_id_idx na task t (náklady=0.42..387.57 řádků=500 šířka=48) (skutečný čas=0.030..0.030 řádků=1 cykly=1)
Index Podmínka: (owner_id = 1)
Buffery: sdílený zásah=4
InitPlan 2 (vrací $1)
-> Limit (náklady=0.42..1.19 řádků=1 šířka=48) (skutečný čas=0.008..0.009 řádků=1 cykly=1)
Buffery: sdílený zásah=4
-> Index Scan pomocí task_owner_id_task_date_id_idx na task t_1 (náklady=0.42..387.57 řádků=500 šířka=48) (skutečný čas=0.008..0.008 řádků=1 cykly=1)
Index Podmínka: (owner_id = 1)
Buffery: sdílený zásah=4
InitPlan 3 (vrací $2)
-> Limit (náklady=0.42..1.19 řádků=1 šířka=48) (skutečný čas=0.008..0.008 řádků=1 cykly=1)
Buffery: sdílený zásah=4
-> Index Scan pomocí task_owner_id_task_date_id_idx na task t_2 (náklady=0.42..387.57 řádků=500 šířka=48) (skutečný čas=0.008..0.008 řádků=1 cykly=1)
Index Podmínka: (owner_id = 1)
Buffery: sdílený zásah=4"
InitPlan 4 (vrací $3)
-> Limit (náklady=0.42..1.19 řádků=1 šířka=48) (skutečný čas=0.009..0.009 řádků=1 cykly=1)
Buffery: sdílený zásah=4
-> Index Scan pomocí task_owner_id_task_date_id_idx na task t_3 (náklady=0.42..387.57 řádků=500 šířka=48) (skutečný čas=0.009..0.009 řádků=1 cykly=1)
Index Podmínka: (owner_id = 1)
Buffery: sdílený zásah=4
Tentýž záznam byl „vyhledán“ 4krát... Až do PostgreSQL 11 se toto chování pravidelně objevuje, a řešením je „obalení“ do CTE, což znamená neochvějnou hranici pro optimalizátor v těchto verzích.
Rekurzivní akumulátor
V předchozí variantě jsme celkově přečetli 200 řádků pro potřebu 20. Už to není 960, ale stále méně — je to možné?
Zkusme využít znalosti, že potřebujeme celkem 20 záznamů. To znamená, že budeme iterovat načítání dat pouze do dosažení požadovaného množství.
Krok 1: počáteční seznam
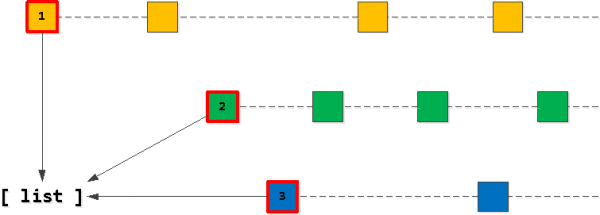
Je zřejmé, že náš „cílový“ seznam 20 záznamů by měl začínat „prvými“ záznamy podle jednoho z našich owner_id klíčů. Proto nejprve najdeme takové „nejprvnější“ pro každý z klíčů a přidáme do seznamu, seřazené podle pořadí, které chceme — (task_date, id).
Krok 2: hledáme „následující“ záznamy
Nyní, pokud vezmeme první záznam z našeho seznamu a začneme „pokračovat“ dále podle indexu s uchováním owner_id klíče, všechny nalezené záznamy budou právě těmi následujícími v výsledném výběru. Samozřejmě, pouze dokud nepřekročíme aplikační klíč druhý záznam v seznamu.
Pokud se stalo, že jsme druhý záznam "překročili", pak poslední přečtený záznam by měl být přidán do seznamu namísto prvního (se stejným owner_id), po čemž se seznam znovu seřadí.
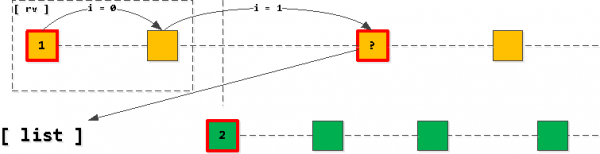
To znamená, že máme stále maximálně jeden záznam pro každý z klíčů (pokud záznamy došly a my jsme "nepřekročili", pak první záznam ze seznamu jednoduše zmizí a nic nového se nepřidá), přičemž jsou vždy seřazeny v pořadí vzestupně podle aplikačního klíče (task_date, id).
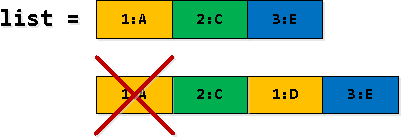
Krok 3: filtrujeme a "rozbalujeme" záznamy
V některých řádcích našeho rekurzivního výběru se některé záznamy rv duplicitně — nejprve najdeme ty, které "překračují hranici 2. záznamu seznamu", a pak je použijeme jako 1. v seznamu. Takže první výskyt je třeba filtrovat.
Hrozný konečný dotaz
S REKURZÍ T JAKO (
  -- #1 : vložíme do seznamu "první" záznamy podle každého z klíčů souboru
  S wrapperem JAKO ( -- "materializujeme" záznamy, abychom se vyhnuli násobení InitPlan/SubPlan
    S T JAKO (
      VYBERTE
        (
          VYBERTE
            r
          Z
            úkol r
          KDE
            owner_id = unnest
          OBJEDNAT PODLE
            task_date, id
          LIMIT 1
        ) r
      Z
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    VYBERTE
      array_agg(r OBJEDNAT PODLE (r).task_date, (r).id) list -- seřadíme seznam v požadovaném pořadí
    Z
      T
  )
  VYBERTE
    list
  , list[1] rv
  , FALSE not_cross
  , 0 size
  Z
    wrap
UNION ALL
  -- #2 : vyčteme záznamy 1. podle pořadí klíče, dokud neprojdeme přes záznam 2.
  VYBERTE
    PŘÍPAD
      -- pokud nic nebylo nalezeno pro klíč 1. záznamu
      KDYŽ X._r NENÍ DISTINCT OD NULL POTOM
        T.list[2:] -- odstraníme ho ze seznamu
      -- pokud jsme NEPŘEKROČILI aplikovaný klíč 2. záznamu
      KDYŽ X.not_cross POTOM
        T.list -- prostě prodloužíme stejný seznam bez modifikací
      -- pokud v seznamu již není 2. záznam
      KDYŽ T.list[2] JE NULL POTOM
        -- prostě vrátíme prázdný seznam
        '{}'
      -- přeřadíme slovník, odstraníme 1. záznam a přidáme poslední nalezený
      JINAK (
        VYBERTE
          coalesce(T.list[2] || array_agg(r OBJEDNAT PODLE (r).task_date, (r).id), '{}')
        Z
          unnest(T.list[3:] || X._r) r
      )
    KONEC
  , X._r
  , X.not_cross
  , T.size + X.not_cross::integer
  Z
    T
  , LATERAL(
      S wrapperem JAKO ( -- "materializujeme" záznam
        VYBERTE
          PŘÍPAD
            -- pokud jsme přece jen "překročili" 2. záznam
            KDYŽ NE T.not_cross
              -- tak potřebný záznam - první ze seznamu
              POTOM T.list[1]
            JINAK ( -- pokud jsme nepřekročili, klíč zůstal jako v předchozím záznamu - od tohoto se odvíjíme
              VYBERTE
                _r
              Z
                úkol _r
              KDE
                owner_id = (rv).owner_id A
                (task_date, id) > ((rv).task_date, (rv).id)
              OBJEDNAT PODLE
                task_date, id
              LIMIT 1
            )
          KONEC _r
      )
      VYBERTE
        _r
      , PŘÍPAD
          -- pokud 2. záznam již není v seznamu, ale něco jsme našli
          KDYŽ list[2] JE NULL A _r NENÍ DISTINCT OD NULL POTOM
            PRAVDA
          JINAK -- nic jsme nenašli nebo "překročili"
            coalesce(((_r).task_date, (_r).id) < ((list[2]).task_date, (list[2]).id), FALSE)
        KONEC not_cross
      Z
        wrapper
    ) X
  KDE
    T.size < 20 A -- zde omezujeme množství
    T.list NENÍ DISTINCT OD '{}' -- nebo dokud seznam neskončí
)
-- #3 : "rozbalujeme" záznamy - pořadí je zaručeno konstrukcí
VYBERTE
  (rv).*
Z
  T
KDE
not_cross; -- bereme pouze "nepřekračující" záznamy 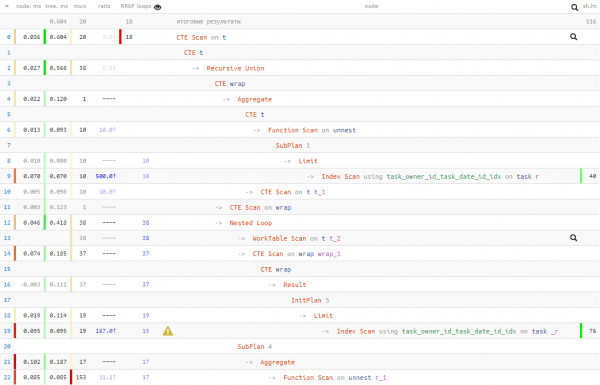
Takže jsme vyměnili 50% čtení dat za 20% doby trváníTo znamená, že pokud máte důvody se domnívat, že čtení může být dlouhé (například, data často nejsou v cache a musíte pro ně jít na disk), takto se můžete méně spoléhat na čtení.
Každopádně, doba běhu byla lepší než v ‚naivní‘ první variantě. Kterou z těchto 3 variant použít — záleží na vás.
Zdroj: habr.com
