

Ahoj! Chci jednoduše vysvětlit mechaniku vzniku steal uvnitř virtuálních strojů a některé neviditelné artefakty, které jsme zjistili během jeho výzkumu, do kterého jsem se musel ponořit jako technický ředitel cloudové platformy. . Platforma funguje na KVM.
CPU steal time je čas, během kterého virtuální stroj nedostává zdroje procesoru ke svému vykonání. Tento čas se počítá pouze v hostitelských operačních systémech ve virtualizačních prostředích. Důvody, kam zmizí tyto přidělené zdroje, jsou, jak je tomu v životě, dosti nejasné. Ale rozhodli jsme se to zjistit, dokonce jsme provedli celou řadu experimentů. Ne že bychom nyní všechno věděli o steal, ale nějaké zajímavé informace vám teď povíme.
1. Co je steal
Takže steal je metrika, která naznačuje nedostatek procesorového času pro procesy uvnitř virtuálního stroje. Jak je popsáno , steal je čas, během kterého hypervizor vykonává jiné procesy na hostitelském operačním systému, i když zařadil proces virtuálního stroje do fronty na vykonání. Jinými slovy, steal se počítá jako rozdíl mezi časem, kdy je proces připraven k vykonání, a časem, kdy je procesům přidělen čas procesoru.
Metriku steal jádro virtuálního stroje získává od hypervizoru. Hypervizor přitom neuvádí, jaké konkrétní jiné procesy vykonává, prostě "dokud jsem zaneprázdněn, nemohu ti věnovat čas". Na KVM byla podpora pro počítání steal přidána v Dva klíčové body zde jsou:
- Virtuální stroj se o steal dozvídá od hypervizoru. To znamená, že z hlediska ztrát, pro procesy na samotné virtuálce je to nepřímé měření, které může být vystaveno různým zkreslením.
- Hypervizor se s virtuálkou nedělí informacemi o tom, čím jiným je zaneprázdněn — hlavní je, že jí nevěnuje čas. Z toho důvodu sama virtuálka nemůže zjistit zkreslení v hodnotě steal, která by mohla být posouzena podle charakteru konkurenčních procesů.
2. Co ovlivňuje steal
2.1. Výpočet steal
V zásadě se steal počítá přibližně stejně, jako obyčejný čas využití procesoru. Informací o tom, jak se počítá využití, není mnoho. Možná proto, že většina považuje tuto otázku za zřejmou. Ale i zde mohou být skryté úskalí. Pro seznámení s tímto procesem si můžete přečíst. : dozvíte se spoustu detailů při počítání využití a o situacích, kdy bude toto počítání chybné z následujících důvodů:
- Přehřátí procesoru, při kterém dochází k přeskočení taktů.
- Zapnutí/vypnutí turbo Boost, což mění taktovací frekvenci procesoru.
- Změna doby kvanta času, která nastává při použití technologií úspory energie procesoru, jako je SpeedStep.
- Problém s průměrováním: odhad využití na úrovni 80 % po dobu jedné minuty může skrývat krátkodobý výbuch na 100 %.
- Cyklická blokace (spin lock) způsobuje, že je procesor využit, ale uživatelský proces nevidí pokrok ve svém provedení. Výsledkem bude, že vypočítaná využitelnost procesoru procesem bude stoprocentní, přestože fyzický čas procesor nepoužívá.
Nenašel jsem článek, který by popisoval podobné počítání pro steal (pokud víte — podělte se v komentářích). Ale podle zdrojových kódů je mechanismus počítání stejný jako pro využití. Jen do jádra se přidává další čítač, přímo pro proces KVM (proces virtuálního stroje), který počítá dobu, po kterou byl proces KVM ve stavu čekání na čas procesoru. Čítač čerpá informace o procesoru z jeho specifikace a kontroluje, zda všechny jeho tikty byly využity procesem virtuálního stroje. Pokud ano, říkáme, že procesor pracoval pouze na procesu virtuálního stroje. Jinak informujeme, že procesor se zabýval něčím jiným, došlo k steal.
Proces počítání steal podléhá stejným problémům jako běžné počítání využití. Není to tak, že by se tyto problémy vyskytovaly často, ale vypadají znepokojující.
2.2. Typy virtualizace na KVM
Obecně existují tři typy virtualizace a všechny jsou podporovány KVM. Typ virtualizace může ovlivnit mechanismus vzniku steal.
Vysílání. V takovém případě funguje operační systém virtuálního stroje s fyzickými zařízeními hypervizora přibližně takto:
- Hostitelský operační systém posílá svému hostujícímu zařízení příkaz.
- Ovladač hostitelského zařízení přijímá příkaz, vytváří požadavek pro BIOS zařízení a posílá ho do hypervizora.
- Proces hypervizora provádí překlad příkazů na příkazy pro fyzické zařízení, což zajišťuje, že jsou také bezpečnější.
- Ovladač fyzického zařízení přijímá modifikovaný příkaz a odesílá jej přímo do fyzického zařízení.
- Výsledky vykonání příkazů se vracejí stejnou cestou.
Výhodou překladu je, že umožňuje emulovat jakékoli zařízení a nevyžaduje speciální úpravy jádra operačního systému. Za to se ale platí především výkonem.
Hardwarová virtualizace. V tomto případě fyzické zařízení na hardwarové úrovni rozumí příkazům z operačního systému. To je nejrychlejší a nejlepší způsob. Bohužel však není podporován všemi fyzickými zařízeními, hypervizory a hostitelskými operačními systémy. V současné době jsou hlavními zařízeními, která podporují hardwarovou virtualizaci, procesory.
Paravirtualizace (paravirtualization). Nejrozšířenější varianta virtualizace zařízení na KVM a vůbec nejrozšířenější režim virtualizace pro hostitelské operační systémy. Její zvláštností je, že práce s některými subsystémy hypervizora (například síťovým nebo diskovým zásobníkem) nebo přidělování paměťových stránek probíhá s využitím API hypervizora, bez překladu nízkoúrovňových příkazů. Nevýhodou tohoto způsobu virtualizace je nutnost modifikace jádra hostitelského operačního systému, aby mohlo interagovat s hypervizorem pomocí tohoto API. Obvykle se to však řeší instalací speciálních ovladačů na hostitelský operační systém. V KVM se toto API nazývá .
Při paravirtualizaci, ve srovnání s překladem, je cesta k fyzickému zařízení značně zkrácena díky odesílání příkazů přímo z virtuálního stroje do procesu hypervizora na hostiteli. To umožňuje urychlit vykonávání všech instrukcí uvnitř virtuálního stroje. V KVM za to odpovídá virtio API, které funguje pouze pro určité zařízení, jako je síťový nebo diskový adaptér. Právě proto se dovnitř virtuálních strojů instalují ovladače virtio.
Nehodlý důsledek takového zrychlení je, že ne všechny procesy prováděné uvnitř virtuálního stroje zůstávají uvnitř něj. To vytváří určité speciální efekty, které mohou vést k problémům. Doporučuji začít podrobně studovat tuto otázku s .
2.3. „Spravedlivé“ plánování
Virtuální stroj na hypervisoru je de facto běžným procesem, který podléhá zákonům plánování (rozdělování zdrojů mezi procesy) v jádře Linuxu, takže se na něj podíváme podrobněji.
V Linuxu se používá takzvaný CFS, Completely Fair Scheduler, který se od jádra 2.6.23 stal správcem zdrojů výchozím. Abychom pochopili tento algoritmus, můžeme si přečíst Linux Kernel Architecture nebo zdrojové kódy. Podstatou CFS je rozdělení procesorového času mezi procesy na základě doby jejich vykonávání. Čím více procesorového času proces potřebuje, tím méně ho dostává. To zaručuje „spravedlivé“ provádění všech procesů — aby jeden proces neobsadil všechny procesory trvale a ostatní procesy měly možnost také se vykonávat.
Někdy tato paradigma vede k zajímavým artefaktům. Dlouhodobí uživatelé Linuxu si jistě pamatují zamrzání běžného textového editoru na desktopu během spuštění náročných aplikací, jako jsou kompilátory. Stávalo se to, protože nerostrové úkoly desktopových aplikací soutěžily s úkoly, které aktivně spotřebovaly zdroje, jako například kompilátor. CFS považuje tuto situaci za nespravedlivou, proto příležitostně zastaví textový editor a umožní procesoru zpracovat úkoly kompilátoru. To bylo opraveno pomocí mechanismu , ale zůstalo mnoho dalších zvláštností rozdělování procesorového času mezi úkoly. Vlastně, toto vyprávění není o tom, jak je CFS špatný, ale o pokusu upozornit na to, že „spravedlivé“ rozdělení procesorového času není tak triviální úkol.
Ještě jeden důležitý aspekt plánovače — preemption. To je potřeba, aby se zbavil rozmazleného procesu na procesoru a dal práci dalším. Proces vyhazování se nazývá přepínání kontextu, přepínání kontextu procesoru. Přitom se udržuje celý kontext úlohy: stav zásobníku, registry a další, po čemž je proces poslán čekat, a na jeho místo nastoupí jiný. To je pro OS nákladná operace a používá se jen zřídka, ale v zásadě na ní není nic špatného. Časté přepínání kontextu může naznačovat problém v OS, ale obvykle probíhá nepřetržitě a na nic zvláštního neukazuje.
Takový dlouhý příběh je potřebný pro vysvětlení jedné skutečnosti: čím více zdrojů procesoru se snaží získat proces v čestném plánovači Linuxu, tím rychleji bude zastaven, aby mohly pracovat i jiné procesy. Zda je to správně nebo ne — je složitá otázka, která se podle různých zátěží řeší různě. V systému Windows byl plánovač do nedávna orientován na prioritní zpracování desktopových aplikací, což mělo za následek visením na pozadí procesů. V Sun Solaris bylo pět různých tříd plánovačů. Když byla spuštěna virtualizace, přidali šestý, , protože předchozích pět pracovalo s virtualizací Solaris Zones nedostatečně. Podrobné studium této otázky doporučuji začít s knihami jako nebo .
2.4. Jak monitorovat steal?
Monitorování steal uvnitř virtuálního stroje, jakož i jakoukoli jinou metriky procesoru, je snadné: můžete použít jakýkoli nástroj pro sběr metrik procesoru. Hlavní je, aby virtuální stroj běžel na Linuxu. Windows z nějakého důvodu tuto informaci svým uživatelům neposkytuje. 🙁
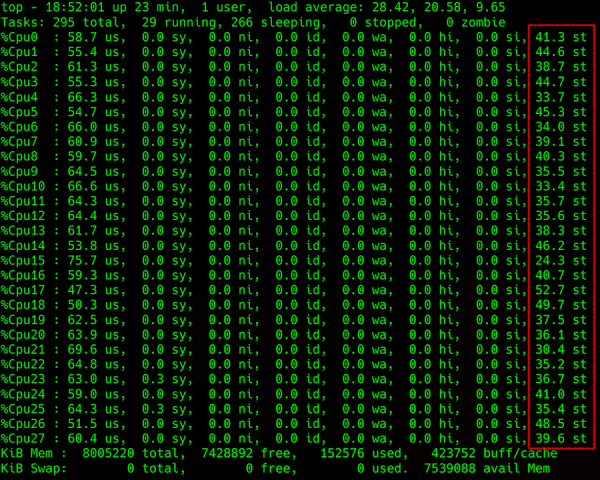
Výstup příkazu top: podrobnosti o zátěži na procesoru, v krajní pravé kolonce — steal
Obtížnost nastává při pokusu získat tyto informace z hypervisoru. Můžete se pokusit předpovědět steal na hostitelské mašině, například podle parametru Load Average (LA) — průměrné hodnoty počtu procesů čekajících v pořadí na vykonání. Metodika výpočtu tohoto parametru není jednoduchá, ale obecně, pokud je normovaný podle počtu vláken procesoru LA větší než 1, to naznačuje, že server s Linuxem je nějakým způsobem přetížen.
Co tedy všechny tyto procesy očekávají? Odpověď je jasná — procesor. Ale odpověď není úplně správná, protože někdy je procesor volný, zatímco LA je vysoká. Vzpomeňte si, Podobně to může být i s diskem a dalšími zařízeními pro vstup/výstup. Ve skutečnosti mohou procesy očekávat ukončení jakékoliv blokace, ať už fyzické, spojené s zařízením pro vstup/výstup, nebo logické, například mutexy. Patří sem také blokace na úrovni hardwaru (stejná odpověď od disku), nebo logiky (takzvané blokovací primitiva, kam patří spousta entit, adaptive mutexy a spin, semafory, podmínkové proměnné, rw zámky, ipc zámky…).
Další zvláštností LA je, že se počítá jako průměrná hodnota v operačním systému. Například 100 procesů soutěží o jeden soubor, a v tom případě LA=50. Taková vysoká hodnota by teoreticky naznačovala, že operační systém má problémy. Ale pro jinak špatně napsaný kód to může být normální stav, přičemž špatně je pouze jemu, zatímco ostatní procesy v operačním systému netrpí.
Kvůli tomuto průměrování (a to minimálně za minutu) je určení něčeho podle ukazatele LA — nevděčné zaměstnání, s velmi nejasnými výsledky v konkrétních případech. Pokud se pokusíte to pochopit, zjistíte, že v článcích na Wikipedii a dalších dostupných zdrojích jsou popsány pouze ty nejjednodušší případy, bez hlubokého vysvětlení procesu. Všechny zájemce posílám, opět, — dále podle odkazů. Kdo se nechtějí dít na angličtině — .
3. Speciální efekty
Nyní se zastavíme nad hlavními případy výskytu steal, se kterými jsme se setkali. Povědím vám, jak vznikají z výše uvedeného a jak se vztahují k ukazatelům na hypervizoru.
Přeplnění zdrojů. Nejsnazší a nejčastější: hypervizor je přeplněný. Opravdu, je spuštěno mnoho virtuálních strojů, vysoká spotřeba procesoru uvnitř nich, velká konkurence, uplatnění podle LA více než 1 (v normalizaci na procesní vlákna). Uvnitř všech virtuálních strojů vše zpomaluje. Steal, přenášený z hypervizoru, také roste, je třeba přerozdělit zátěž nebo někoho vypnout. V podstatě, je to logické a jasné.
Paravirtualizace versus izolované instance. Na hypervizoru je jedna jediná virtuální stroj, který zabírá malou část jeho zdrojů, ale vytváří vysokou zátěž na vstupu/výstupu, například na disku. A z ničeho nic se v něm objevuje malý steal, až 10 % (jak ukázalo několik provedených experimentů).
Zajímavý případ. Steal se zde objevuje právě kvůli zablokování na úrovni paravirtualizovaných ovladačů. Uvnitř virtuálního stroje se vytváří přerušení, které zpracovává ovladač a posílá ho do hypervizoru. Kvůli zpracování přerušení na hypervizoru to vypadá pro virtuální stroj jako odeslaný požadavek, je připraven k vykonání a čeká na procesor, ale procesorový čas mu není poskytnut. Virtuální stroj si myslí, že tento čas byl ukraden.
To se stává v okamžiku odeslání bufferu, který odchází do kernel space hypervizoru, a začínáme na něj čekat. I když z pohledu virtuálního stroje by se měl okamžitě vrátit. Podle algoritmu pro výpočet steal se tento čas považuje za ukradený. Je pravděpodobné, že v této situaci mohou existovat i jiné mechanismy (například zpracování dalších sys call), ale neměly by se výrazně lišit.
Scheduler proti vysoko zatíženým virtuálním strojům. Když jedna virtuální stroj trpí více steal než ostatní, je to přímo spojeno se schedulern. Čím více proces zatěžuje procesor, tím rychleji jej scheduler vykopne, aby ostatní také mohli pracovat. Pokud virtuální stroj zabírá málo, téměř neuvidí steal: jeho proces poctivě seděl a čekal, je třeba mu poskytnout více času. Pokud virtuální stroj vytváří maximální zátěž na všech svých jádrech, častěji je vyhazován z procesoru a snaží se mu nedávat mnoho času.
Ještě horší je, když procesy uvnitř virtuálního stroje se snaží získat více procesorového času, protože nezvládají zpracování dat. Tehdy operační systém na hypervizoru, díky poctivé optimalizaci, začne dávat stále méně procesorového času. Tento proces probíhá lavinovitě, a steal vyletí do nebes, i když ostatní virtuální stroje si toho téměř nevšímají. A čím více jader, tím hůře postižené virtuálním stroji. Jinými slovy, nejvíce trpí vysoko zatížené virtuální stroje s mnoha jádry.
Nízký LA, ale je zde steal. Pokud je LA přibližně 0,7 (to znamená, že hypervizor se zdá být málo zatížen), ale uvnitř jednotlivých virtuálních strojů se pozoruje steal:
- Už popsaná varianta s paravirtualizací. Virtuální stroj může získávat metriky ukazující na steal, i když hypervizor funguje bez problémů. Na základě našich experimentů tento typ steal nepřesahuje 10 % a neměl by mít zásadní vliv na výkon aplikací uvnitř virtuálního stroje.
- Parametr LA se považuje za nesprávný. Přesněji, v každém konkrétním okamžiku je počítán správně, ale při průměrování přes jednu minutu vychází sníženě. Například, pokud jeden virtuální stroj na třetinu hypervizoru spotřebovává všechny své procesory přesně půl minuty, pak bude LA za minutu na hypervizoru 0,15; čtyři takové virtuální stroje běžící současně dají 0,6. Ale to, že půl minuty každý z nich měl extrémní steal kolem 25 % podle ukazatele LA, se již nedá vytáhnout.
- Opět kvůli scheduleru, který se rozhodl, že někdo spotřebovává příliš mnoho prostředků a měl by počkat. A já zatím přepnu kontext, zpracovávám přerušení a zabývám se dalšími důležitými systémovými věcmi. V důsledku toho jedny virtuální stroje nevidí žádné problémy, zatímco jiné zažívají vážnou degradaci výkonu.
4. Další zkreslení
Existuje ještě milion důvodů pro zkreslení spravedlivého rozdělení procesorového času na virtuálním stroji. Například komplikace v výpočtech přináší hyper-threading a NUMA. Tyto faktory konečně zamotávají výběr jádra pro provádění procesu, protože scheduler používá koeficienty – váhy, které během přepínání kontextu situaci ještě komplikují.
Zkreslení mohou nastat také z technologií jako turbo boost nebo naopak režimu úspory energie, které při výpočtu využití mohou uměle zvyšovat nebo snižovat frekvenci nebo dokonce časový kvant na serveru. Aktivace turbo boost snižuje výkon jednoho procesorového vlákna kvůli zvýšení výkonu jiného. V tu chvíli informace o aktuální frekvenci procesoru není virtuálnímu stroji předávána a on si myslí, že mu jeho čas někdo krade (například požadoval 2 GHz, ale dostal dvakrát méně).
Obecně může být příčin zkreslení mnoho. V konkrétním systému můžete objevit něco dalšího. Nejlépe začít s knihami, na které jsem dal odkazy výše, a se sběrem statistik z hypervizoru pomocí nástrojů jako perf, sysdig, systemtap, jichž .
5. Závěry
- Nějaké množství steal může vznikat z důvodu paravirtualizace a lze to považovat za normální. Na internetu se píše, že tato hodnota může být 5-10 %. Závisí na aplikacích uvnitř virtuálního stroje a na tom, jakou zátěž představují pro své fyzické zařízení. Je důležité sledovat, jak si aplikace vedou uvnitř virtuálních strojů.
- Poměr zátěže na hypervizoru a steal uvnitř virtuálního stroje není vždy jednoznačně vzájemně propojen, obě odhady steal mohou být chybné v konkrétních situacích při různých zátěžích.
- Scheduler se špatně chová k procesům, které hodně žádají. Snaží se dávat méně těm, kteří žádají více. Velké virtuální stroje jsou zlo.
- Malý steal může být normou i bez paravirtualizace (s ohledem na zátěž uvnitř virtuálního stroje, zvláštnosti zátěže sousedů, rozdělení zátěže mezi vlákna a další faktory).
- Pokud chcete zjistit steal v konkrétním systému, musíte zkoumat různé varianty, shromažďovat metriky, pečlivě je analyzovat a promýšlet, jak rovnoměrně rozložit zátěž. Od jakýchkoliv případů mohou odchylky, které je třeba potvrdit experimentálně nebo sledovat v debuggeru jádra.
Zdroj: habr.com
