

Oznámení
Kolegyně, uprostřed léta plánuji vydat další cyklus článků o návrhu systémů hromadného obsluhování: „Experiment VTrade“ — pokus o napsání frameworku pro obchodní systémy. V cyklu bude rozebrána teorie a praxe budování burzy, aukce a obchodu. Na konci článku navrhuji hlasovat o nejzajímavějších tématech pro vás.
Toto je závěrečný článek cyklu o distribuovaných reaktivních aplikacích v Erlangu/Elixiru. V lze najít teoretické základy reaktivní architektury. ilustruje hlavní vzory a mechanizmy budování takových systémů.
Dnes se zabýváme otázkami rozvoje kódové základny a projektů jako celku.
Organizace služeb
Ve skutečném životě při vývoji služby často musíme spojit několik vzorů interakce v jednom kontroléru. Například služba users, která řeší úkoly správy profilů uživatelů projektu, by měla reagovat na požadavky req-resp a informovat o aktualizacích profilů prostřednictvím pub-sub. Tato situace je docela jednoduchá: za messagingem stojí jeden kontrolér, který realizuje logiku služby a publikuje aktualizace.
Situace se komplikuje, když potřebujeme realizovat odolnou distribuovanou službu. Představme si, že požadavky na users se změnily:
- nyní by služba měla zpracovávat požadavky na 5 uzlech clusteru,
- mít možnost vykonávat úkoly na pozadí,
- a také umět dynamicky řídit seznamy předplatitelů pro aktualizace profilů.
Poznámka: Otázku konzistentního uložení a replikace dat zde neřešíme. Předpokládejme, že tyto otázky byly vyřešeny dříve a v systému již existuje spolehlivá a škálovatelná vrstva ukládání, a zpracovatelé mají mechanismy interakce s ní.
Formální popis služby users se zkomplikoval. Z pohledu programátora díky použití messagingu jsou změny minimální. Abychom splnili první požadavek, musíme nastavit vyvažování na bodě výměny req-resp.
Požadavek na zpracování pozadí se často objevuje. V uživatelských účtech to mohou být kontroly uživatelských dokumentů, zpracování nahraných multimediálních souborů nebo synchronizace dat se sociálními sítěmi. Tyto úkoly je potřeba nějak rozdělit v rámci clusteru a sledovat jejich průběh. Proto máme dvě možnosti řešení: buď použít šablonu rozdělování úloh z předchozího článku, nebo, pokud ta nevyhovuje, napsat vlastní plánovač úloh, který bude řídit pool zpracovatelů podle našich potřeb.
Bod 3 vyžaduje rozšíření šablony pub-sub. A pro implementaci, po vytvoření bodu výměny pub-sub, musíme navíc spustit kontroler tohoto bodu v rámci našeho servisu. Tímto způsobem jako bychom přenesli logiku zpracování přihlášení a odhlášení z vrstvy messaging do implementace uživatelů.
Výsledkem dekompozice úkolu bylo, že pro splnění požadavků potřebujeme spustit na různých uzlech 5 instancí služby a vytvořit další entitu – kontroler pub-sub, zodpovědný za přihlášení.
Pro spuštění 5 zpracovatelů není potřeba měnit kód služby. Jediná dodatečná akce – nastavení pravidel vyvažování na bodě výměny, o čemž si promluvíme později.
Také se objevila další složitost: kontroler pub-sub a vlastní plánovač úloh musí fungovat v jediné instanci. Opět, služba messaging, jako základní, by měla poskytovat mechanismus výběru lídra.
Výběr lídra
V distribuovaných systémech je výběr lídra postup určení jediné instance, která je odpovědná za plánování distribuovaného zpracování nějakého zatížení.
V systémech, které nejsou náchylné k centralizaci, se používají univerzální algoritmy a algoritmy založené na konsensu, například paxos nebo raft.
Protože messaging je broker a centrální prvek, ví o všech kontrolerech služby – kandidátech na lídra. Messaging může jmenovat lídra bez provádění hlasování.
Všechny služby po spuštění a připojení k bodu výměny obdrží systémovou zprávu #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. V případě, že LeaderPid souhlasí s pid aktuálním procesem, je jmenován lídrem a seznam Servers obsahuje všechny uzly a jejich parametry.
Při vzniku nového a odpojení fungujícího uzlu clustera obdrží všechny řídicí prvky služby #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} a #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} odpovídajícím způsobem.
Tak mají všechny komponenty přehled o všech změnách a v clusteru je v každém okamžiku zaručeně jeden lídr.
Zprostředkovatelé
Pro realizaci složitých distribuovaných procesů zpracování a také pro optimalizaci již existující architektury je pohodlné použít zprostředkovatele.
Abychom nemuseli měnit kód služeb a vypořádali se například s úkoly dodatečného zpracování, směrování nebo logování zpráv, můžeme před službou nasadit proxy zpracovatele, který provede veškerou dodatečnou práci.
Klasickým příkladem optimalizace pub-sub je distribuovaná aplikace s obchodním jádrem, které generuje události aktualizací, například změnu ceny na trhu, a vrstva přístupu — N serverů, které poskytují websocket API pro webové klienty.
Pokud bychom přistoupili k situaci "doslovně", pak obsluha klienta vypadá následovně:
- klient navazuje spojení s platformou. Na straně serveru, který ukončuje provoz, dochází k spuštění procesu, který obsluhuje toto připojení.
- v kontextu obslužného procesu dochází k autorizaci a přihlášení na aktualizace. Proces volá metodu subscribe pro témata.
- po vygenerování události v jádře je doručena procesům, které obsluhují připojení.
Představme si, že máme 50000 odběratelů na téma “news”. Odběratelé jsou rovnoměrně rozloženi na 5 serverech. V důsledku toho bude každá aktualizace, která dorazí na směnu, replikována 50000krát: 10000krát na každý server, podle počtu odběratelů na něm. Není to úplně efektivní schéma, že?
Abychom zlepšili situaci, zavádíme proxy, které má stejné jméno jako směna. Registrar globálních jmen by měl umět vrátit nejbližší proces podle jména, to je důležité.
Spustíme tuto proxy na serverech přístupové vrstvy, a všechny naše procesy, které obsluhují websocket API, se na ni přihlásí, a ne na původní pub-sub směnu v jádře. Proxy se přihlásí k jádru pouze v případě jedinečného přihlášení a replikovaná zpráva se šíří ke všem jejím odběratelům.
Nakonec mezi jádrem a přístupovými servery bude odesláno 5 zpráv místo 50000.
Směrování a vyvažování
Req-Resp
V aktuální implementaci messaging existuje 7 strategií distribuce požadavků:
default. Dotaz je zasílán všem kontrolérům.round-robin. Provede se procházení a cyklické rozdělování dotazů mezi kontroléry.konsenzus. Kontroléry, které obsluhují službu, se dělí na lídra a následovníky. Dotazy jsou předávány pouze lídrovi.konsenzus & round-robin. Ve skupině je lídr, ale dotazy se rozdělují mezi všechny členy.sticky. Vypočítá se hash funkce a přiřadí se k určitému zpracováváči. Následující dotazy s touto značkou přicházejí k tomuto zpracováváči.sticky-fun. Při inicializaci výměny se navíc předává funkce pro výpočet hashe prostickyvyrovnávání.zábava. Analogické ke sticky-fun, ale navíc je možné přesměrovat, odmítnout nebo předzpracovat.
Strategie rozdělování se určuje při inicializaci výměny.
Kromě vyrovnávání messaging umožňuje značkovat entity. Zvažme typy značek v systému:
- Značka připojení. Umožňuje pochopit, skrze jaké připojení přišly události. Používá se, když se proces kontroléru připojuje k jednomu bodu výměny, ale s různými klíči pro směrování.
- Značka služby. Umožňuje pro jednu službu spojovat do skupin zpracovatele a rozšiřovat možnosti směrování a vyrovnávání. Pro vzor req-resp je směrování lineární. Odesíláme dotaz na bod výměny, ten dále předává službě. Pokud však chceme rozdělit zpracovatele do logických skupin, rozdělení se provádí pomocí značek. Při uvedení značky bude dotaz směřován na konkrétní skupinu kontrolérů.
- Značka dotazu. Umožňuje odlišit odpovědi. Protože náš systém je asynchronní, pro zpracování odpovědí služby je potřeba mít možnost uvést RequestTag při odesílání dotazu. Podle něj budeme schopni určit, která odpověď k nám přišla.
Pub-sub
Pro pub-sub je to o něco jednodušší. Máme bod výměny, na který se publikují zprávy. Bod výměny rozděluje zprávy mezi odběrateli, kteří se přihlásili k odpovídajícím klíčům pro směrování (dá se říci, že je to analog témat).
Škálovatelnost a odolnost proti chybám
Škálovatelnost celého systému závisí na míře škálovatelnosti vrstev a komponent systému:
- Služby se škálují přidáním dalších uzlů s obsluhou této služby do clusteru. Během zkušebního provozu lze vybrat optimální strategii vyvažování.
- Samotná služba messaging v rámci samostatného clusteru se obvykle škáluje buď přesunutím zvlášť zatížených výměnných bodů na samostatné uzly clusteru, nebo přidáním procesů proxy do zvlášť zatížených oblastí clusteru.
- Škálovatelnost celého systému jako charakteristika závisí na flexibilitě architektury a možnosti spojení jednotlivých clusterů do společné logické entity.
Úspěšnost projektu často závisí na jednoduchosti a rychlosti škálování. Messaging v aktuálním provedení roste spolu s aplikací. I když nám chybí cluster o 50-60 strojích, můžeme využít federaci. Bohužel, téma federace přesahuje rámec tohoto článku.
Zálohování
Při rozboru vyvažování zátěže jsme již diskutovali o zálohování řídicích prvků služeb. Avšak messaging také musí být zálohován. V případě selhání uzlu nebo stroje se messaging musí automaticky obnovit, a to v co nejkratším čase.
Ve svých projektech používám další uzly, které přebírají zátěž v případě selhání. V Erlangu existuje standardní implementace distribuovaného režimu pro aplikace OTP. Distribuovaný režim právě zajišťuje obnovu v případě selhání tím, že spustí havarovanou aplikaci na jiném předem spuštěném uzlu. Proces je průhledný, po selhání se aplikace automaticky přesune na failover uzel. O tomto funkcionalitě se můžete dozvědět více. .
Výkon
Zkusíme alespoň přibližně porovnat výkon rabbitmq a našeho vlastního messagingu.
Našel jsem testování rabbitmq od týmu openstack.
V bodě 6.14.1.2.1.2.2 originálního dokumentu je uveden výsledek RPC CAST:
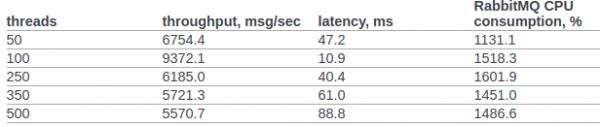
Předem nebudeme provádět žádné další nastavení v jádře OS nebo erlang VM. Podmínky pro testování:
- erl opts: +A1 +sbtu.
- Test v rámci jednoho uzlu erlang běží na notebooku se starým i7 v mobilním provedení.
- Clusterové testy probíhají na serverech s 10G sítí.
- Kód běží v docker kontejnerech. Síť v režimu NAT.
Kód testu:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Scénář 1: Test se spouští na notebooku se starším mobilním i7 procesorem. Test, messaging a služba běží na jednom uzlu v jednom docker kontejneru:
Sekvenční 10000 cyklů za ~0 sekund (26987 cyklů/s)
Sekvenční 20000 cyklů za ~1 sekundu (26915 cyklů/s)
Sekvenční 100000 cyklů za ~4 sekundy (26957 cyklů/s)
Paralelní 2 100000 cyklů za ~2 sekundy (44240 cyklů/s)
Paralelní 4 100000 cyklů za ~2 sekundy (53459 cyklů/s)
Paralelní 10 100000 cyklů za ~2 sekundy (52283 cyklů/s)
Paralelní 100 100000 cyklů za ~3 sekundy (49317 cyklů/s)
Scénář 2: 3 uzly spuštěné na různých strojích pod dockerem (NAT).
Sekvenční 10000 cyklů za ~1 sekundu (8684 cyklů/s)
Sekvenční 20000 cyklů za ~2 sekundy (8424 cyklů/s)
Sekvenční 100000 cyklů za ~12 sekund (8655 cyklů/s)
Paralelní 2 100000 cyklů za ~7 sekund (15160 cyklů/s)
Paralelní 4 100000 cyklů za ~5 sekund (19133 cyklů/s)
Paralelní 10 100000 cyklů za ~4 sekundy (24399 cyklů/s)
Paralelní 100 100000 cyklů za ~3 sekundy (34517 cyklů/s)
Všechny případy CPU nevyužily více než 250%
Závěry
Doufám, že tento cyklus nevypadá jako výdump vědomí a moje zkušenost přinese skutečný prospěch jak výzkumníkům v oblasti distribuovaných systémů, tak praktikům, kteří jsou na začátku budování distribuovaných architektur pro své obchodní systémy a zajímají se o Erlang/Elixir, ale váhají, zda to stojí za to...
Foto
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
Jaká témata bych měl podrobněji rozvést v rámci cyklu "Experiment VTrade"?
Teorie: Trhy, objednávky a doby jejich platnosti: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Kniha objednávek. Teorie a praxe realizace knihy s seskupením
Vizualizace obchodování: Tickery, svíčky, časové rozlišení. Jak ukládat a jak spojovat
Backoffice. Plánování a vývoj. Kontrola zaměstnanců a vyšetřování incidentů
API. Zjistíme, jaké rozhraní potřebujeme a jak je realizovat
Ukládání informací: PostgreSQL, Timescale, Tarantool v obchodních systémech
Reaktivita v obchodních systémech
Jiné. Napíšu v komentářích
Hlasovalo 6 uživatelů. Zdrželi se 4 uživatelé.
Zdroj: habr.com
