

I když jsou dnes informace dostupné téměř všude, analytické databáze jsou stále poměrně exotické. Lidé je špatně znají a ještě hůře je efektivně využívají. Mnozí stále "jí kaktus" s MySQL nebo PostgreSQL, které byly navrženy pro jiné scénáře, trpí s NoSQL nebo přeplácejí za komerční řešení. ClickHouse mění pravidla hry a výrazně snižuje prahovou hodnotu vstupu do světa analytických DBMS.
Prezentace z BackEnd Conf 2018 a byla publikována se souhlasem prezentujícího.
Kdo jsem a proč mluvím o ClickHouse? Jsem ředitel pro vývoj ve společnosti LifeStreet, která používá ClickHouse. Kromě toho jsem zakladatel Altinity. To je partner Yandexu, který propaguje ClickHouse a pomáhá Yandexu udělat ClickHouse úspěšnějším. Také se chci podělit o znalosti o ClickHouse.
A ještě nejsem bratr Peti Zajceva. Na to se mě často ptají. Ne, nejsme bratři.
„Všichni vědí“, že ClickHouse:
- Je velmi rychlý,
- Je velmi pohodlný,
- Používá se v Yandexu.
Trochu méně je známo, v jakých společnostech a jak se používá.
Povím vám, k čemu, kde a jak se ClickHouse používá, kromě Yandexu.
Povím vám, jak konkrétní úkoly jsou řešeny pomocí ClickHouse v různých společnostech, jaké prostředky ClickHouse můžete použít pro své úkoly a jak byly použity v různých firmách.
Vybral jsem tři příklady, které ukazují ClickHouse z různých úhlů. Myslím, že to bude zajímavé.
První otázka: „Proč potřebujeme ClickHouse?“. Na první pohled je otázka dost zřejmá, ale odpovědí na ni je více než jedna.
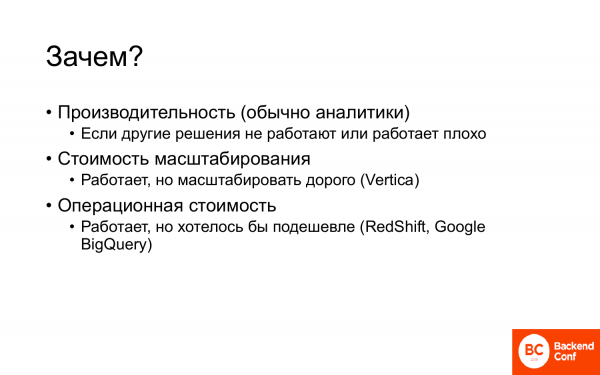
- První odpověď – kvůli výkonu. ClickHouse je velmi rychlý. Analýza na ClickHouse je také velmi rychlá. Může se často používat tam, kde něco jiného funguje velmi pomalu nebo velmi špatně.
- Druhá odpověď – to je cena. A především cena škálování. Například, Vertica je naprosto vynikající databáze. Funguje velmi dobře, pokud máte jen několik terabajtů dat. Ale když se jedná o stovky terabajtů nebo petabajty, cena licence a podpory se vyšplhá na poměrně značnou částku. A to je drahé. A ClickHouse je zdarma.
- Třetí odpovědí jsou provozní náklady. Tento přístup se dívá na problém z trochu jiného úhlu. RedShift je skvělá alternativa. Na RedShift lze velmi rychle vytvořit řešení. Bude dobře fungovat, ale každou hodinu, každý den a každý měsíc budete platit Amazonu poměrně hodně, protože je to značně drahá služba. Google BigQuery také. Kdo ho použil, ví, že lze spustit několik dotazů a náhle dostat účet na stovky dolarů.
V ClickHouse tyto problémy nejsou.
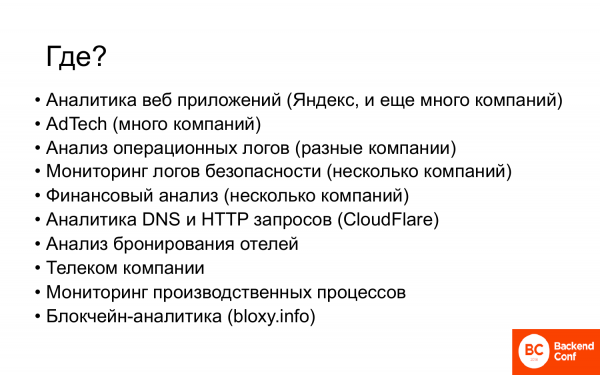
Kde se ClickHouse nyní používá? Kromě Yandextu se ClickHouse používá v mnoha různých podnicích a společnostech.
- Na prvním místě je to analýza webových aplikací, t. j. to je případ použití, který přišel z Yandextu.
- Mnoho společnosti AdTech používá ClickHouse.
- Mnohé firmy, které potřebují analyzovat provozní logy z různých zdrojů.
- Několik firem používá ClickHouse pro sledování bezpečnostních logů. Tyto logy nahrávají do ClickHouse, vytvářejí zprávy a získávají potřebné výsledky.
- Firmy začínají používat ClickHouse i pro finanční analýzy, t. j. postupně se k ClickHouse také přibližuje velký byznys.
- CloudFlare. Kdo sleduje ClickHouse, určitě slyšel název této společnosti. Je to jeden z významných přispěvatelů z komunity. A mají velmi robustní instalaci ClickHouse. Například vytvořili Kafka Engine pro ClickHouse.
- Telekomunikační společnosti začaly používat. Několik firem ClickHouse používá buď jako proof of concept, nebo již v produkčním prostředí.
- Jedna společnost používá ClickHouse pro sledování výrobních procesů. Testují čipy, shromažďují spoustu parametrů, asi 2 000 charakteristik. A poté analyzují, zda je dávka dobrá nebo špatná.
- Blockchainová analytika. Existuje ruská společnost Bloxy.info. To je analýza sítě ethereum. I to udělali na ClickHouse.
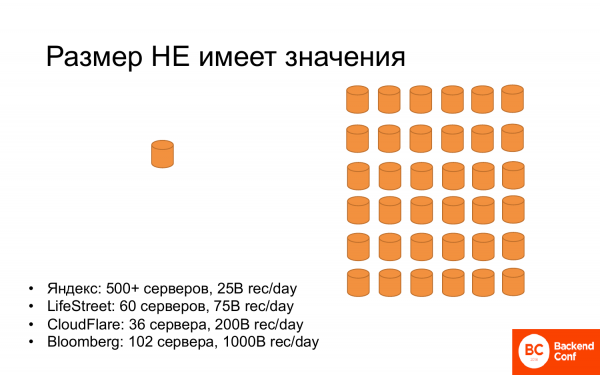
A přitom nezáleží na velikosti. Existuje mnoho společností, které používají jeden malý server. A ten jim umožňuje vyřešit jejich problémy. A ještě více firem používá velké clustery z mnoha servery nebo desítek serverů.
A pokud se podíváme na rekordy, tak:
- Yandex: 500+ serverů, denně tam uchovávají 25 miliard záznamů.
- LifeStreet: 60 serverů, přibližně 75 miliard záznamů denně. Serverů méně, záznamů více než v Yandextu.
- CloudFlare: 36 serverů, 200 miliard záznamů denně uchovávají. Mají ještě méně serverů a ještě více dat, která uchovávají.
- Bloomberg: 102 serveru, přibližně trilion záznamů denně. Rekordman v počtu záznamů.
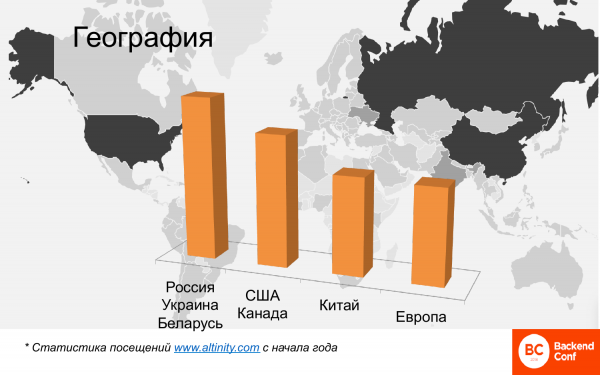
Geograficky je to také hodně. Tato mapa ukazuje heatmapu, kde se ClickHouse používá ve světě. Zde se výrazně vyznačuje Rusko, Čína, Amerika. Evropských zemí je málo. A lze vyčlenit 4 klastry.
Toto je srovnávací analýza, zde není třeba hledat absolutní čísla. Jde o analýzu návštěvníků, kteří čtou anglicky psané materiály na webu Altinity, protože rusky mluvící tam nejsou. A Rusko, Ukrajina, Bělorusko, tedy rusky mluvící část komunity, jsou nejpočetnějšími uživateli. Poté následují USA a Kanada. Čína velmi rychle dohání. Před půl rokem téměř žádná Čína, nyní už Čína předčila Evropu a nadále roste. Starý kontinent také nezůstává pozadu, přičemž lídrem v používání ClickHouse je, jak překvapivé, Francie.
Proč to vše říkám? Abych ukázal, že ClickHouse se stává standardním řešením pro analýzu velkých dat a již se velmi široce používá. Pokud ho používáte, jste v správném trendu. Pokud ho ještě nepoužíváte, nemusíte se obávat, že zůstanete sami a nikdo vám nepomůže, protože už mnoho lidí se tím zabývá.
To jsou příklady skutečného použití ClickHouse v několika společnostech.
- První příklad – reklamní síť: migrace z Vertica na ClickHouse. A znám několik společností, které přešly z Vertica nebo jsou v procesu přechodu.
- Druhý příklad – transakční úložiště na ClickHouse. To je příklad postavený na antipatterny. Vše, co se nedoporučuje dělat v ClickHouse podle rad vývojářů, zde bylo provedeno. A přitom bylo uděláno tak efektivně, že to funguje. A funguje to mnohem lépe než typické transakční řešení.
- Třetí příklad – distribuované výpočty na ClickHouse. Byla otázka, jak lze ClickHouse integrovat do ekosystému Hadoop. Ukážu příklad, jak společnost udělala na ClickHouse něco jako analog map reduce kontejner, sledujíc lokalizaci dat atd., aby spočítala velmi netriviální úlohu.
- LifeStreet – to je Ad Tech společnost, která má všechny technologie potřebné k reklamní síti.
- Zabývá se optimalizací reklam, programmatic bidding.
- Hodně dat: přibližně 10 miliard událostí denně. Přitom se události mohou dělit na několik pod-událostí.
- Hodně klientů těchto dat, a to nejen lidé, ale také různé algoritmy, které se zabývají programatickým nabízením.
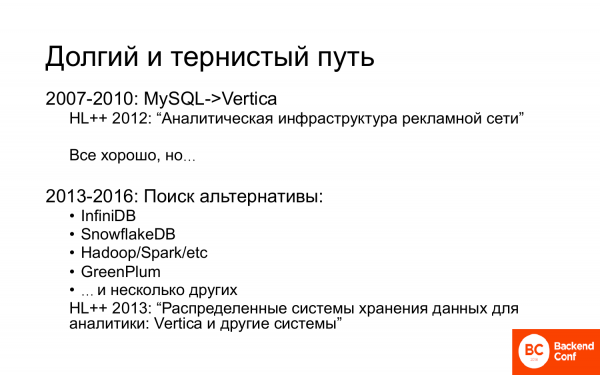
Společnost prošla dlouhou a trnitou cestou. O tom jsem mluvil na HighLoad. Nejprve LifeStreet přešla z MySQL (s krátkou přestávkou na Oracle) na Vertica. A o tom se můžete dočíst.
A všechno bylo velmi dobré, ale brzy se ukázalo, že data rostou a Vertica je drahá. Proto jsme hledali různé alternativy. Některé z nich jsou zde uvedeny. A ve skutečnosti jsme provedli proof of concept nebo někdy performance testing téměř všech databází, které byly na trhu dostupné od roku 2013 do 2016 a které přibližně odpovídaly požadované funkčnosti. A o některých z nich jsem také mluvil na HighLoad.
Bylo třeba migrovat z Vertica, protože data rostla. A rostla exponenciálně několik let. Pak se stabilizovala, ale přesto. A při predikci tohoto růstu, požadavky podnikání na objem dat, na kterých je potřeba provádět nějakou analýzu, bylo jasné, že brzy dojde na petabyty. A za petabyty se už platí velmi draze, takže jsme hledali alternativu, kam přejít.
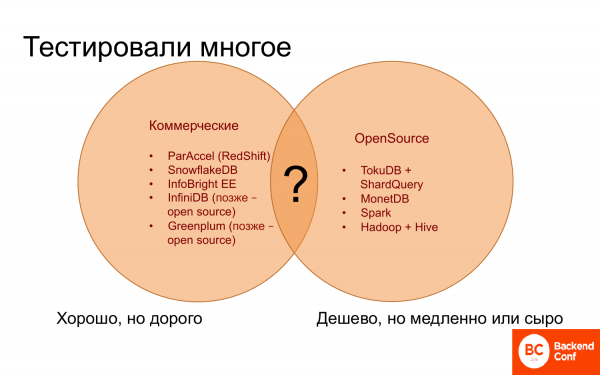
Kam přejít? A dlouho nebylo jasné, kam se vydat, protože na jedné straně existují komerční databáze, které vypadaly, že fungují docela dobře. Některé fungují téměř tak stejně dobře jako Vertica, některé hůře. Ale všechny jsou drahé, nic levnějšího a lepšího jsme nenalezli.
Na druhé straně existují open source řešení, kterých není mnoho, to znamená, že pro analýzu se dají spočítat na prstech jedné ruky. A jsou zdarma nebo levné, ale fungují pomalu. A často jim chybí potřebná a užitečná funkčnost.
A tak, aby se to spojilo, co je dobrého v komerčních databázích a vše to zdarma, co je v open source, — nic takového nebylo.
Nic takového nebylo, dokud náhle Yandex nevytáhl, jako kouzelník králíka z klobouku, ClickHouse. A to bylo nečekané řešení, dodnes se kladou otázky: "Proč?", ale přesto.
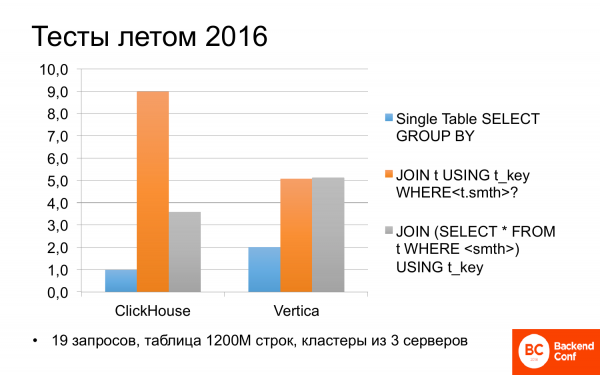
A v létě 2016 jsme začali zkoumat, co to je ClickHouse. A ukázalo se, že někdy může být rychlejší než Vertica. Testovali jsme různé scénáře na různých dotazech. A pokud dotaz využíval pouze jednu tabulku, tedy bez jakýchkoli spojení (join), byl ClickHouse dvakrát rychlejší než Vertica.
Nejprve jsem se podíval na další testy Yandexu, které proběhly nedávno. Tam to bylo stejné: ClickHouse byl dvakrát rychlejší než Vertica, proto o tom často mluví.
Ale pokud jsou v dotazech spojení (join), věci nejsou tak jednoznačné. A ClickHouse může být dvakrát pomalejší než Vertica. Pokud lehce dotaz upravíte a přepíšete, pak jsou přibližně na stejné úrovni. Ne špatné. A zdarma.
A po získání výsledků testů a pohledu na to z různých úhlů se LifeStreet rozhodl pro ClickHouse.
Pamatujte, že je to rok 2016. Bylo to jako v anekdotě o myších, které plakaly a bodaly se, ale stále jedly kaktus. O tom bylo podrobně mluveno, existují o tom videa atd.
Proto o tom nebudu mluvit podrobně, jen se zmíním o výsledcích a několika zajímavých věcech, o kterých jsem tehdy nemluvil.
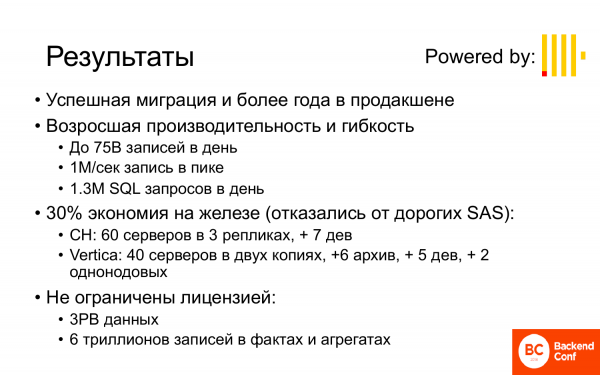
Výsledky jsou následující:
- Úspěšná migrace a systém již více než rok funguje v produkčním prostředí.
- Výkon a flexibilita vzrostly. Z 10 miliard záznamů, které jsme si mohli dovolit uchovávat během dne a to pouze krátkodobě, nyní LifeStreet uchovává 75 miliard záznamů za den a může to dělat po dobu 3 měsíců a více. Pokud počítáme v špičkách, ukládá se až milion událostí za sekundu. Více než milion SQL dotazů denně dorazí do tohoto systému, převážně od různých robotů.
- I když pro ClickHouse začalo být použito více serverů než pro Vertica, úspora na hardware byla, protože ve Vertice byly používány poměrně drahé SAS disky. V ClickHouse byly použity SATA. A proč? Protože ve Vertice je insert synchronní. A synchronizace vyžaduje, aby disky nepomalovaly a také, aby síť nebyla pomalá, tedy celkem drahá operace. A v ClickHouse je insert asynchronní. Navíc, všechno můžete zapisovat lokálně, zde nejsou žádné dodatečné náklady, a proto lze data v ClickHouse vkládat mnohem rychleji než do Vertica, i na ne nejrychlejších discích. Co se týče čtení, to je přibližně stejné. Čtení na SATA, pokud jsou v RAID, je dostatečně rychlé.
- Neomezené licencí, tj. 3 petabajty dat na 60 serverech (20 serverů je jedna replikace) a 6 bilionů záznamů ve faktech a agregátech. Nic takového si na Vertice nemohli dovolit.
Nyní se přesunu k praktickým věcem v tomto příkladu.
- První je efektivní schéma. Od schématu závisí velmi mnoho.
- Druhé je generování efektivního SQL.
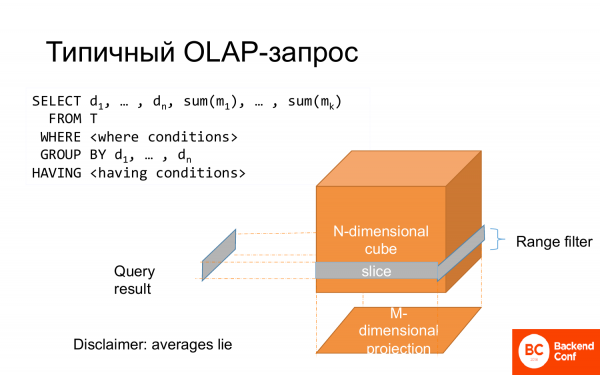
Typický OLAP dotaz je SELECT. Část sloupců jde do GROUP BY, část sloupců jde do agregátních funkcí. Je tam WHERE, které lze představit jako řez kubu. Celý GROUP BY lze představit jako projekci. A proto se tomu říká vícerozměrná analýza dat.
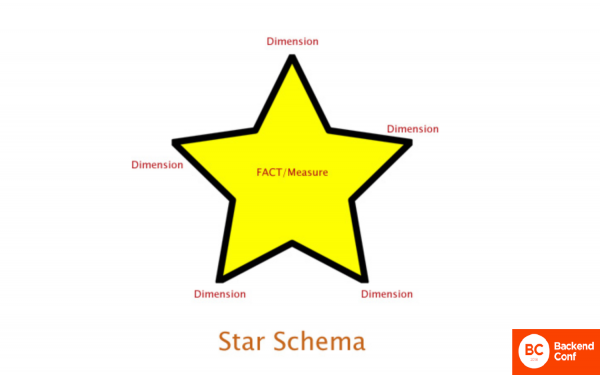
A často je to modelováno ve formě star-schematu, kdy je centrální fakt a charakteristiky tohoto faktu po stranách, po paprscích.
A z pohledu fyzického designu, jak se to převádí na tabulku, se obvykle dělá normalizované zobrazení. Můžete denormalizovat, ale je to drahé v diskovém prostoru a ne příliš efektivní při dotazech. Proto se obvykle dělá normalizované zobrazení, tj. tabulka faktů a mnoho dalších tabulek dimenzí.
Ale v ClickHouse to špatně funguje. Jsou dva důvody:
- První je, že v ClickHouse nejsou příliš dobré JOINy, tj. JOINy existují, ale jsou špatné. Zatím špatné.
- Druhý je, že tabulky se neaktualizují. Obvykle je potřeba v těchto tabulkách kolem star-schematu něco měnit. Například název klienta, název firmy a podobně. A to nefunguje.
A řešení pro to v ClickHouse existuje. dokonce dvě:
- První je použití slovníků. External Dictionaries je něco, co pomáhá vyřešit problém se star-schematem, s aktualizacemi a dalšími problémy na 99 %.
- Druhá je použití polí. Pole také pomáhají zbavit se JOINů a problémů s normalizací.
- Nepotřebujete JOINy.
- Aktualizovatelné. Od března 2018 se objevila nedokumentovaná funkce (v dokumentaci to nenajdete) pro částečné aktualizace slovníků, tj. těch záznamů, které se změnily. Prakticky – je to jako tabulka.
- Vždy v paměti, takže JOINy se slovníkem fungují rychleji, než kdyby to byla tabulka, která leží na disku a ještě není jisté, že je v cache, pravděpodobně ne.
- Také nepotřebujete JOINy.
- Je to kompaktní zobrazení 1 k mnoha.
- A z mého pohledu, pole jsou určená pro geeky. Jsou to lambda funkce a další.
To není jen tak pro slovo. To je velmi silná funkčnost, která umožňuje dělat mnoho věcí velmi jednoduše a elegantně.
Typické příklady, které pomáhají řešit pole. Tyto příklady jsou jednoduché a dostatečně názorné:
- Hledání podle tagů. Pokud tam máte hashtagy a chcete najít nějaké záznamy podle hashtagu.
- Hledání podle párů key-value. Také máte nějaké atributy s hodnotou.
- Ukládání seznamů klíčů, které potřebujete převést na něco jiného.
Všechny tyto úkoly lze vyřešit bez polí. Tagy můžete uložit do jednoho řetězce a vybírat je pomocí regulárního výrazu, nebo do samostatné tabulky, ale pak budete muset provádět spojení (join).
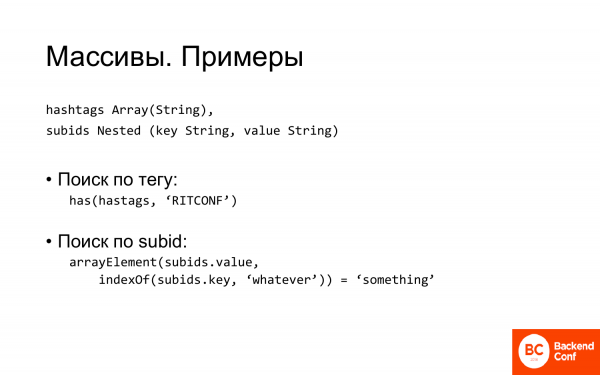
A v ClickHouse není potřeba nic dělat, stačí popsat pole string pro hashtagy nebo vytvořit vnořenou strukturu pro systémy typu key-value.
Vnořená struktura – to možná není to nejlepší pojmenování. Jsou to dvě pole, které mají společnou část v názvu a některé související charakteristiky.
A hledání podle tagu je velmi jednoduché. Existuje funkce has, která kontroluje, zda je v poli prvek. A máme všechna záznamy, které se vztahují k naší konferenci.
Hledání podle subid je o něco složitější. Musíme nejprve najít index klíče a pak vzít prvek s tímto indexem a zkontrolovat, zda má požadovanou hodnotu. Ale i tak je to velmi jednoduché a kompaktní.
Regulární výraz, který byste chtěli napsat, kdybyste to vše uchovávali v jednom řetězci, by byl za prvé zkrpruhlaný. A zadruhé by pracoval mnohem déle než dvě pole.
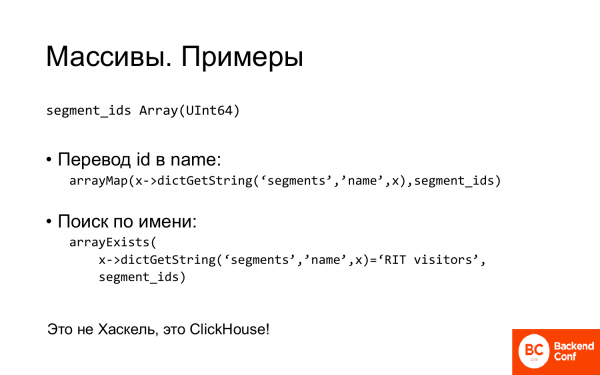
Další příklad. Máte pole, ve kterém uchováváte ID. A můžete je převést na názvy. Funkce arrayMap. To je typická lambda funkce. Předáváte jí lambda výrazy. A ona každému ID ze slovníku vytahuje hodnotu názvu.
Podobným způsobem lze provést i hledání. Předává se funkce predikátu, která kontroluje, čemu odpovídají prvky.
Tyto věci značně zjednodušují schéma a řeší spoustu problémů.
Ale následující problém, se kterým jsme se setkali a o kterém bych chtěl zmínit, jsou efektivní dotazy.
- V ClickHouse není plánovač dotazů. Opravdu není.
- Ale i tak je potřeba plánovat složité dotazy. Kdy?
- Pokud v dotazu existuje několik joinů, které obalujete do poddotazů, pak záleží na pořadí, v jakém jsou vykonávány.
- A za druhé – pokud je dotaz distribuovaný. Protože v distribuovaném dotazu se vykonává pouze nejvnitřnější poddotaz, zatímco vše ostatní se předává na jeden server, ke kterému jste připojeni, a vykonává se tam. Proto pokud máte distribuované dotazy se spoustou joinů, je třeba vybrat pořadí.
A dokonce i v jednodušších případech je někdy dobré vykonat práci plánovače a dotazy mírně přepracovat.
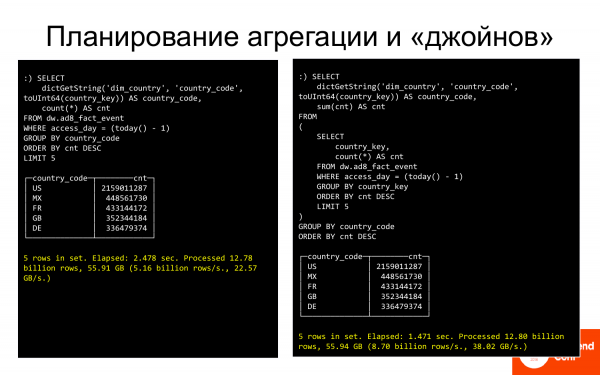
Tady je příklad. Na levé straně dotaz, který ukazuje top 5 zemí. A trvá to 2,5 sekundy, myslím. A na pravé straně je stejný dotaz, ale mírně přepracovaný. Místo toho, abychom seskupovali podle řetězce, jsme začali seskupovat podle klíče (int). A to je rychlejší. A pak jsme připojili slovník k výsledku. Místo 2,5 sekundy dotaz trvá 1,5 sekundy. To je dobré.
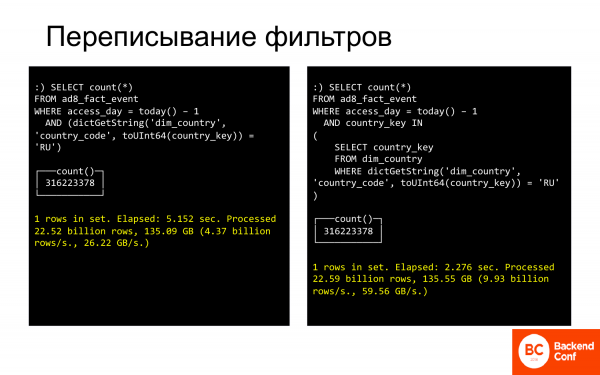
Podobný příklad s přepracováním filtrů. Tady je dotaz na Rusko. Trvá to 5 sekund. Pokud jej přepíšeme tak, že budeme opět porovnávat ne řetězce, ale čísla s nějakou sadou těch klíčů, které se vztahují k Rusku, bude to mnohem rychlejší.
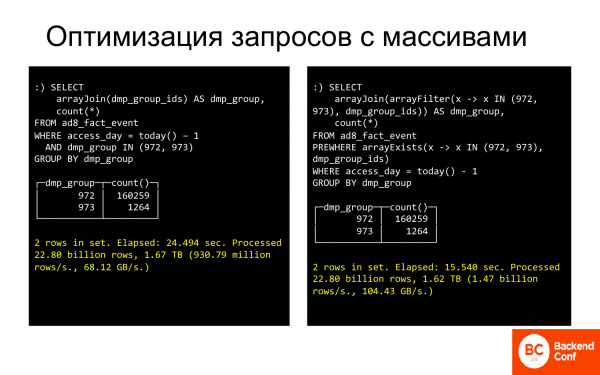
Existuje mnoho těchto triků. A ty umožňují výrazně urychlit dotazy, které si myslíte, že již fungují rychle, nebo naopak fungují pomalu. Mohou být ještě rychlejší.
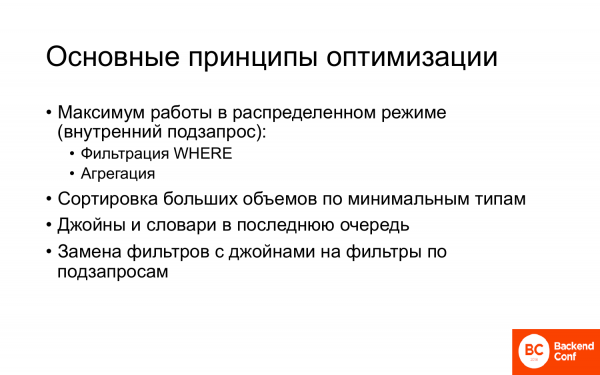
- Maximální práce v distribuovaném režimu.
- Řazení podle minimálních typů, jak jsem to dělal podle int.
- Pokud existují nějaké joiny, slovníky, je lepší je provádět až na samém konci, když máte alespoň částečně seskupená data, pak bude operace joinu nebo volání slovníku vyvolána méněkrát a bude to rychlejší.
- Nahrazení filtrů.
Existují i další techniky, nejen ty, které jsem demonstroval. A všechny umožňují někdy výrazně urychlit vykonávání dotazů.
Přejdeme k dalšímu příkladu. Společnost X z USA. Co dělá?
Byl zde úkol:
- Offline spojování reklamních transakcí.
- Modelování různých modelů spojování.
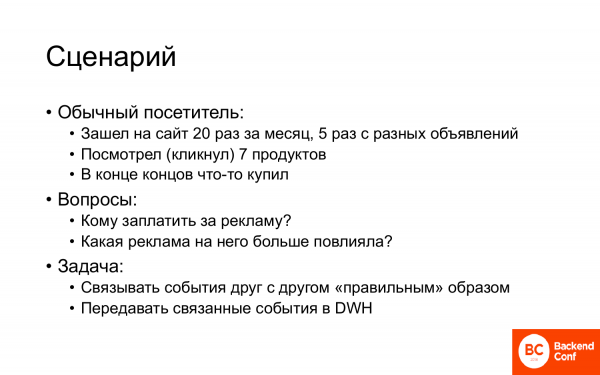
V čem spočívá scénář?
Obvyklý návštěvník navštíví web například 20krát za měsíc z různých reklam nebo občas přichází bez jakýchkoli inzerátů, protože si na tuto stránku vzpomíná. Prohlíží si produkty, dává je do košíku, vytahuje je z košíku. A nakonec něco koupí.
Rozumné otázky: „Komu zaplatit za reklamu, pokud je to potřeba?“ a „Jaká reklama ho ovlivnila, pokud ho ovlivnila?“. Tedy proč koupil a jak zajistit, aby lidé podobní tomuto člověku také kupovali?
Aby bylo možné tento úkol vyřešit, je třeba správně spojovat události, které se na webu odehrávají, tedy nějakým způsobem vytvářet souvislost mezi nimi. Poté je předat k analýze do DWH. A na základě této analýzy vytvářet modely, komu a jakou reklamu ukázat.
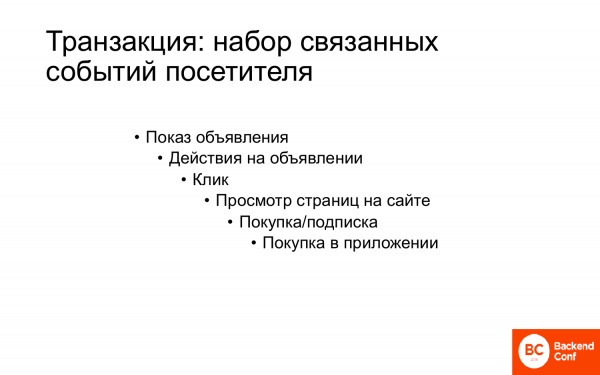
Reklamní transakce je soubor vzájemně souvisejících událostí uživatele, které začínají zobrazením reklamy, poté se něco děje, pak možná nákup a následně mohou být další nákupy. Například pokud se jedná o mobilní aplikaci nebo mobilní hru, obvykle je instalace aplikace zdarma, ale pokud se tam děje něco dalšího, mohly by být potřeba peníze. A čím více člověk utratí v aplikaci, tím je cennější. Ale pro to je potřeba vše spojit.
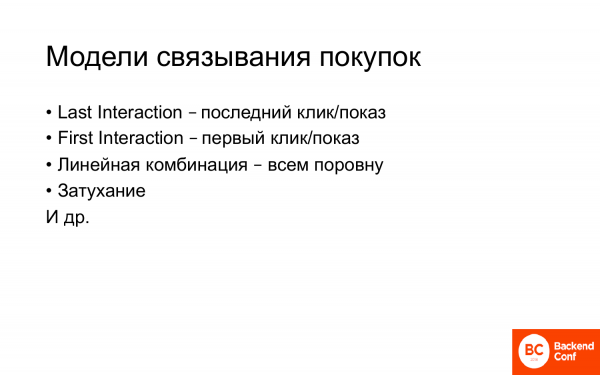
Existuje mnoho modelů spojování.
Nejoblíbenější jsou:
- Last Interaction, kde interaction je buď kliknutí, nebo zobrazení.
- First Interaction, tedy to první, co přivedlo člověka na web.
- Lineární kombinace – všem rovnoměrně.
- Zánik.
- A další.
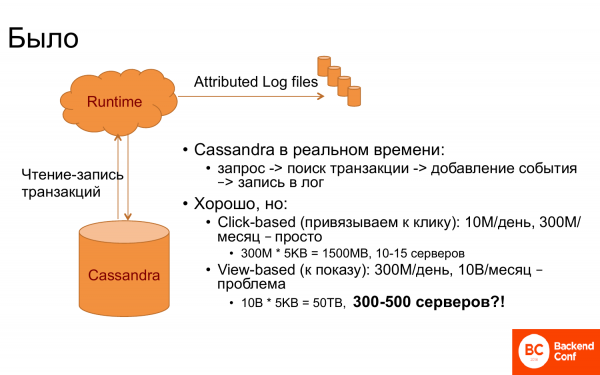
A jak to celé fungovalo původně? Byl Runtime a Cassandra. Cassandra byla používána jako transakční úložiště, tedy v ní byly uchovávány všechny související transakce. A když přišla nějaká událost do Runtime, například zobrazení nějaké stránky nebo něco jiného, provedla se žádost do Cassandry – existuje tento člověk nebo ne. Poté se vytáhly transakce, které se k němu vztahovaly. A provedlo se spojení.
A pokud byl šťastný, že ve dotazu byl transaction id, bylo to snadné. Ale obvykle to štěstí nepřichází. Proto bylo třeba najít poslední transakci nebo transakci s posledním kliknutím atd.
A to všechno fungovalo velmi dobře, dokud byl směrník nastaven na poslední klik. Protože kliknutí, dejme tomu, 10 milionů denně, 300 milionů měsíčně, pokud nastavíme okno na měsíc. A protože v Cassandře musí být všechno v paměti, aby to fungovalo rychle, protože je potřeba, aby Runtime odpovídal rychle, bylo potřeba přibližně 10-15 serverů.
Ale když jsme chtěli přiřazovat transakce k zobrazení, hned to nebylo tak zábavné. Proč? Je jasné, že je třeba uložit 30krát více událostí. A podle toho je potřeba 30krát více serverů. A vypadá to jako astronomické číslo. Mít až 500 serverů na to, abychom dělali vazbu, přičemž v Runtime je serverů výrazně méně, to je nějaké nesprávné číslo. A začali jsme přemýšlet, co dělat.
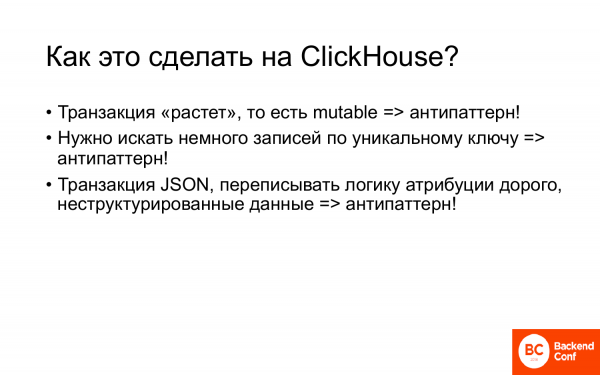
A dostali jsme se k ClickHouse. Jak to udělat na ClickHouse? Na první pohled to vypadá jako soubor antipatternů.
- Transakce rostou, připojujeme k nim stále nové a nové události, tj. jsou měnitelné, a ClickHouse nepracuje příliš dobře s měnitelnými objekty.
- Když k nám přijde návštěvník, musíme získat jeho transakce podle klíče, podle jeho visit id. To je také point query, v ClickHouse se to takhle nedělá. Obvykle se v ClickHouse provádějí velké skeny, a my potřebujeme získat několik záznamů. Také antipattern.
- Navíc byla transakce v JSON, ale přepisovat jsme nechtěli, takže jsme chtěli uchovávat JSON nestrukturovaně, a pokud bylo potřeba, něco z něj vytáhnout. A to je také antipattern.
Tj. soubor antipatternů.
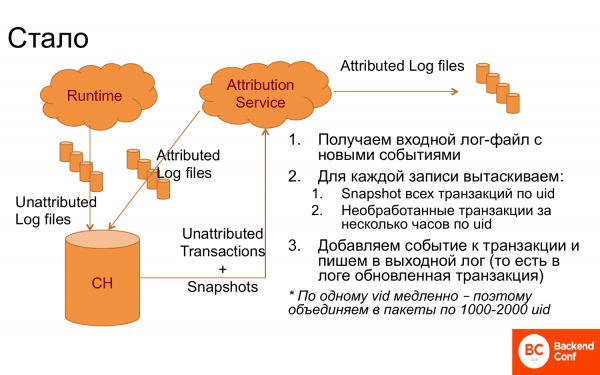
Ale i tak se podařilo vytvořit systém, který fungoval velmi dobře.
Co bylo uděláno? Objevil se ClickHouse, kam se nahrávaly logy rozdělené na záznamy. Objevil se attributed servis, který získával logy z ClickHouse. Poté pro každý záznam podle visit id získával transakce, které mohly být ještě neopravené, plus snapshoty, tj. již spojené transakce, konkrétně výsledek předchozí práce. Z nich byl navržen logiku, vybrána správná transakce, připojeny nové události. Znovu zapsaly do logu. Log se posílal zpět do ClickHouse, tj. to byla neustále cyklická soustava. A kromě toho se odesílal do DWH, aby se tam analyzoval.
Takto to nefungovalo příliš dobře. Aby byl ClickHouse efektivnější při dotazech podle visit ID, seskupovali jsme tyto dotazy do bloků po 1 000–2 000 visit ID a vytahovali jsme pro 1 000–2 000 lidí všechny transakce. A pak to všechno fungovalo.
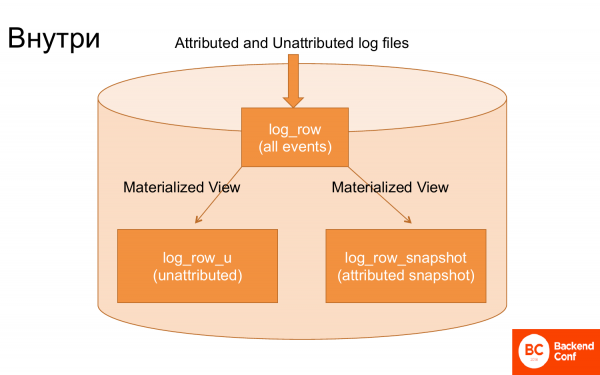
Pokud se podíváte do ClickHouse, zjistíte, že tam jsou pouze 3 hlavní tabulky, které to všechno obsluhují.
První tabulka, do které se ukládají logy, přičemž logy se ukládají prakticky bez dalšího zpracování.
Druhá tabulka. Přes materializovaný pohled se z těchto logů vytahovaly ještě neatribované události, tj. nesouvisející. A prostřednictvím materializovaného pohledu se z těchto logů vytahovaly transakce pro sestavení snapshotu. Tj. speciální materializovaný pohled vytvářel snapshot, konkrétně poslední uložený stav transakce.
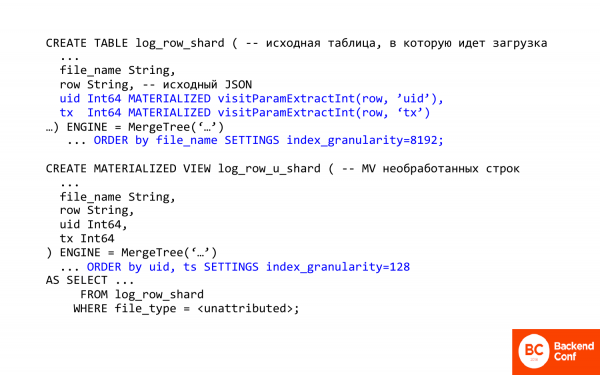
Zde je napsán kód v SQL. Rád bych v něm komentoval několik důležitých věcí.
První důležitá věc je možnost v ClickHouse vybírat sloupce z JSON. Tj. ClickHouse má několik metod pro práci s JSON. Jsou velmi primitivní.
visitParamExtractInt umožňuje vybírat atributy z JSON, tj. první shoda se používá. A tímto způsobem je možné vybrat transaction ID nebo visit ID. To je první věc.
Druhá věc – zde bylo použito mazané materializované pole. Co to znamená? To znamená, že ho nemůžete vložit do tabulky, tj. není vloženo, je vypočítáváno a uchováváno při vkládání. Při vkládání ClickHouse tuto práci udělá za vás. A jakmile se vytahují z JSON ty věci, které později potřebujete.
V tomto případě materializovaný pohled slouží pro neupravené řádky. A přesně se používá první tabulka se téměř syrovými logy. A co dělá? Za prvé, mění pořadí, tj. nyní je pořadí podle visit ID, protože potřebujeme rychle vybírat transakci konkrétní osoby.
Druhá důležitá věc je index_granularity. Pokud jste viděli MergeTree, obvykle je index_granularity ve výchozím nastavení 8 192. Co to znamená? Je to parametr řídkosti indexu. V ClickHouse je index řídký, nikdy neindexuje každou záznam. Dělá to každých 8 192. A to je dobré, když je třeba spočítat velké množství dat, ale špatné, když jen trochu, protože je to velký overhead. A pokud snížíte index granularity, snižujete overhead. Snížit na jedničku není možné, protože může být nedostatek paměti. Index je vždy uchováván v paměti.
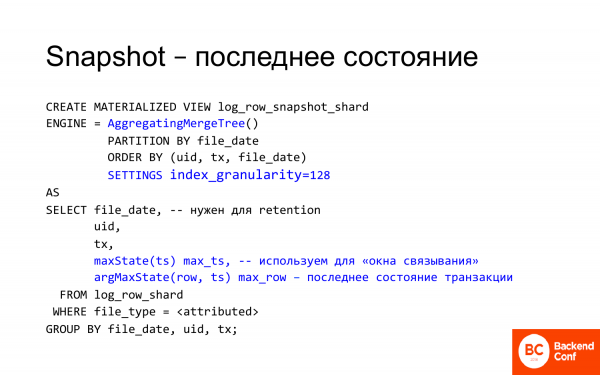
SnapShot využívá také některé zajímavé funkce ClickHouse.
Za prvé, je to AggregatingMergeTree. A v AggregatingMergeTree se ukládá argMax, tj. je to stav transakce odpovídající poslednímu timestampu. Transakce se neustále generují pro tohoto návštěvníka. A do posledního stavu této transakce jsme přidali událost a máme nový stav. Ten opět přistál v ClickHouse. A prostřednictvím argMax v této materializované reprezentaci vždy můžeme získat aktuální stav.
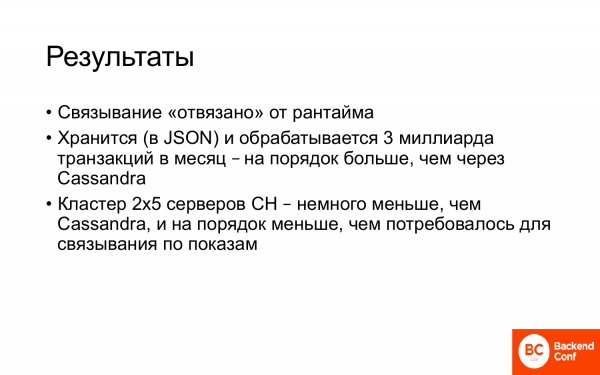
- Vazba je "odpojena" od Runtime.
- Ukládá a zpracovává až 3 miliardy transakcí měsíčně. To je o řád více, než bylo v Cassandře, tj. v typickém transakčním systému.
- Kluster 2x5 serverů ClickHouse. 5 serverů a každý server má replikaci. To je dokonce méně, než bylo v Cassandře, aby se udělala click based atribuce, zde máme atribuci založenou na zobrazení. Tj. místo zvyšování počtu serverů třicetkrát, podařilo se je snížit.
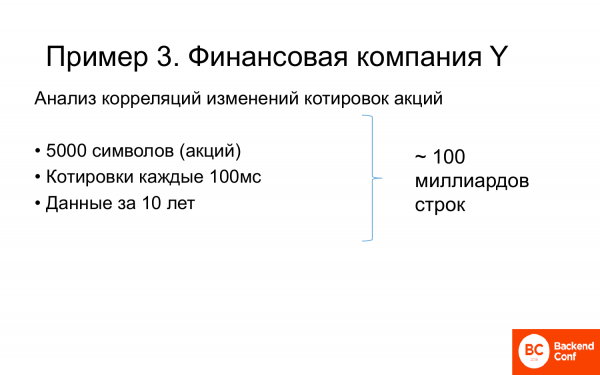
A poslední příklad - to je finanční společnost Y, která analyzovala korelace změn cen akcií.
A úkol byl následující:
- Je přibližně 5 000 akcií.
- Ceny jsou známy každých 100 milisekund.
- Data se hromadila za 10 let. Očividně pro některé společnosti více, pro některé méně.
- Celkem přibližně 100 miliard řádků.
A bylo potřeba spočítat korelaci změn.
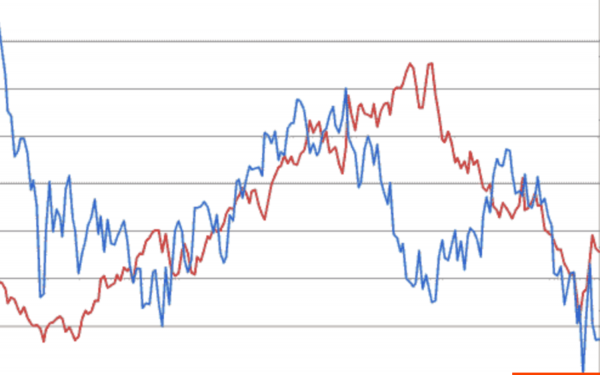
Zde jsou dvě akcie a jejich ceny. Pokud jedna roste a druhá také roste, jde o pozitivní korelaci, tj. jedna roste, a druhá roste. Pokud jedna roste, jako na konci grafu, a druhá klesá, jde o negativní korelaci, tj. když jedna roste, druhá klesá.
Analyzováním těchto vzájemných změn je možné provádět predikce na finančním trhu.
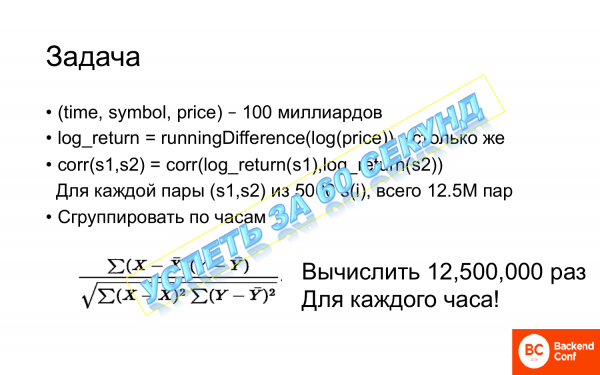
Ale úkol je složitý. Co se k tomu dělá? Máme 100 miliard záznamů, ve kterých je: čas, akcie a cena. Nejprve musíme spočítat 100 miliardkrát runningDifference algoritmu ceny. RunningDifference je funkce v ClickHouse, která postupně počítá rozdíl mezi dvěma řádky.
A poté je třeba spočítat korelaci, přičemž korelaci je třeba spočítat pro každou dvojici. Pro 5 000 akcií je to 12,5 milionu párů. A to je hodně, tj. 12,5krát je třeba vypočítat tuto funkci korelace.
A pokud někdo zapomněl, x a y – to jsou průměrná očekávání podle vzorku. Tedy je potřeba spočítat nejen kořeny a součty, ale také uvnitř těchto součtů další součty. Musíme provést spoustu výpočtů 12,5 milionkrát a ještě to všechno seskupit podle hodin. A hodin máme také hodně. A to vše musíme stihnout za 60 sekund. To je vtip.
Museli jsme to nějak stihnout, protože to celé fungovalo velmi pomalu, než přišel ClickHouse.
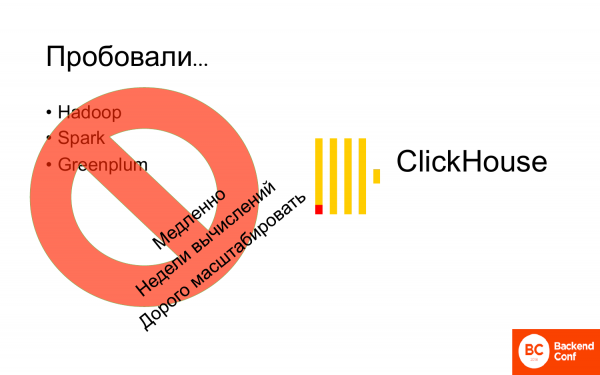
Zkoušeli to vypočítat na Hadoopu, na Sparku, na Greenplum. A všechno to bylo buď velmi pomalé, nebo drahé. Tedy bylo možné něco spočítat, ale pak to bylo náročné.
A pak přišel ClickHouse a všechno se výrazně zlepšilo.
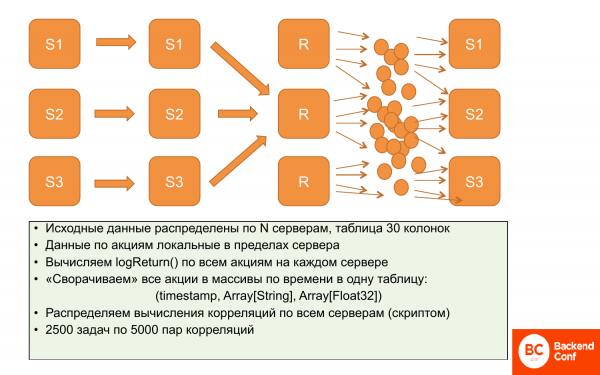
Připomínám, že problém máme s lokalizací dat, protože korelace nelze lokalizovat. Nemůžeme část dat uložit na jeden server, část na jiný a spočítat, všechny data musí být všude.
Co udělali? Původní data jsou lokalizovaná. Na každém ze serverů jsou uložena data o cenové nabídce určitého souboru akcií. A ty se nepřekrývají. Proto je možné paralelně a nezávisle spočítat logReturn, to vše probíhá zatím paralelně a rozloženě.
Dále se rozhodli tato data zmenšit, přičemž neztratili na výrazu. Zmenšit pomocí polí, tedy pro každé časové období vytvořit pole akcií a pole cen. Tímto způsobem zabírají data mnohem méně místa. A s nimi se pracuje poněkud pohodlněji. To jsou téměř paralelní operace, t. j. paralelně částečně počítáme a potom zapisujeme na server.
Poté je možné je replikovat. Písmeno „r“ znamená, že tato data jsme replikovali. Tedy máme na všech třech serverech stejná data – tyto pole.
A dále pomocí speciálního skriptu z tohoto souboru 12,5 milionu korelací, které je třeba spočítat, lze vytvořit balíčky. Tedy 2 500 úloh po 5 000 párech korelací. A tuto úlohu počítat na konkrétním serveru ClickHouse. Všechna data má, protože data jsou stejná a on je může vypočítat postupně.
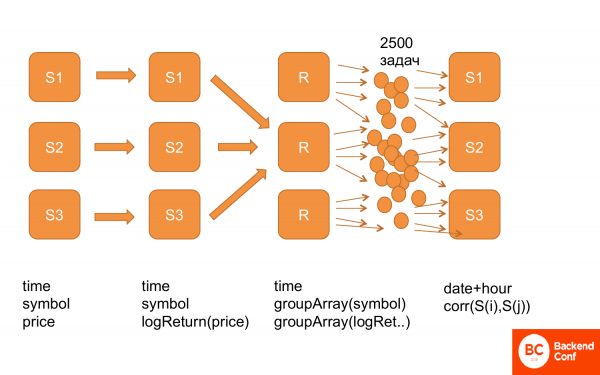
Ještě jednou, jak to vypadá. Nejprve máme všechna data v takové struktuře: čas, akcie, cena. Pak jsme spočítali logReturn, tzn. data ve stejné struktuře, jen místo ceny máme už logReturn. Poté jsme je přepracovali, tzn. máme čas a groupArray podle akcií a podle cen. Zreplikovali jsme. A po tom jsme vygenerovali spoustu úloh a nasadili je do ClickHouse, aby je zpracoval. A to funguje.
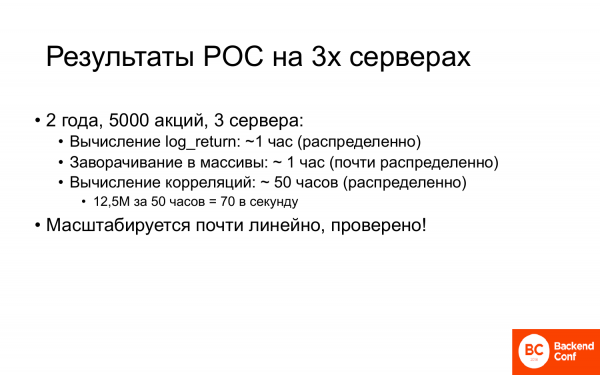
Na proof of concept úkol – to byla podúloha, tzn. vzali jsme méně dat. A celkem na třech serverech.
První tyto dvě fáze: výpočet Log_return a zabalení do polí zabraly přibližně hodinu každá.
Ale výpočet korelace zabral kolem 50 hodin. Ale 50 hodin – to je málo, protože dříve to u nich trvalo týdny. To byl velký úspěch. A pokud to spočítáme, tak 70krát za sekundu na tomto clusteru bylo všechno spočítáno.
Ale nejdůležitější je, že tento systém je prakticky bez úzkých míst, tzn. škáluje se prakticky lineárně. A oni to ověřili. Úspěšně to škálovali.
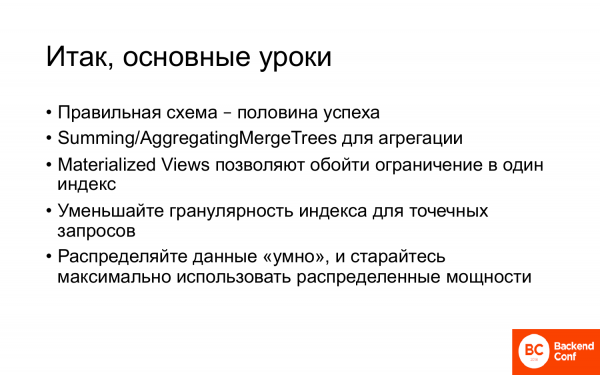
- Správná schéma – polovina úspěchu. A správná schéma – to je použití všech potřebných technologií ClickHouse.
- Summing/AggregatingMergeTrees – to jsou technologie, které umožňují agregovat nebo počítat snapshot stavu jako zvláštní případ. A to významně zjednodušuje mnoho věcí.
- Materializované pohledy umožňují obejít omezení na jeden index. Možná jsem to neřekl úplně jasně, ale když jsme nahrávali logy, tak surové logy byly v tabulce s jedním indexem, zatímco logy atributů byly v jiném tabulce, tzn. stejné data, jen filtrované, ale index byl úplně jiný. Ačkoli byly téměř stejné údaje, měly jinou strukturu. A materializované pohledy umožňují, pokud je to potřeba, obejít toto omezení ClickHouse.
- Snižte granularitu indexu pro dotazy na konkrétní data.
- A inteligentně rozdělujte data, snažte se co nejvíce lokalizovat data uvnitř serveru. A usilujte o to, aby dotazy také využívaly lokalizaci tam, kde je to maximálně možné.
A shrnutí tohoto krátkého vystoupení lze říci, že ClickHouse si nyní pevně zajistil místo jak na poli komerčních databází, tak na poli open source databází, tedy konkrétně pro analytiku. Výborně zapadl do této krajiny. A navíc, pomalu začíná vytlačovat ostatní, protože když máte ClickHouse, nepotřebujete InfiniDB. Vertica může být brzy zbytečná, pokud udělají normální podporu SQL. Používejte ho!
—Děkuji za prezentaci! Bylo to velmi zajímavé! Byly nějaké srovnání s Apache Phoenix?
- Ne, neslyšel jsem, že by někdo dělil srovnání. My a Yandex se snažíme sledovat všechna srovnání ClickHouse s různými databázemi. Protože pokud se náhodou ukáže, že něco je rychlejší než ClickHouse, Alexej Milovidov nespí v noci a začíná ho rychle zrychlovat. O takovém srovnání jsem neslyšel.
(Alexej Milovidov) Apache Phoenix je SQL engine na Hbase. Hbase je převážně určeno pro scénáře práce typu key-value. V každém řádku může být libovolný počet sloupců s libovolnými názvy. To se dá říct o takových systémech, jako jsou Hbase, Cassandra. A na těchto systémech těžké analytické dotazy normálně nebudou fungovat. Nebo si můžete myslet, že fungují normálně, pokud nemáte žádné zkušenosti s ClickHouse.
Děkuji
Dobrý den! Už se touto tématikou poměrně dlouho zajímám, protože mám analytický subsystém. Ale když se podívám na ClickHouse, mám pocit, že ClickHouse je velmi dobře vhodný pro analýzu událostí, které se mění. A pokud potřebuji analyzovat spoustu obchodních dat s velkými tabulkami, pak, pokud jsem správně pochopil, ClickHouse mi příliš nevyhovuje? Zejména pokud se mění. Je to správně, nebo existují příklady, které by to mohly vyvrátit?
To je pravda. A toto platí pro většinu specializovaných analytických databází. Jsou navrženy tak, aby fungovaly s jednou nebo více velkými tabulkami, které jsou měnitelné, a mnoha malými, které se pomalu mění. Tedy ClickHouse neslouží jako Oracle, kde můžete uložit všechno a provádět velmi složité dotazy. Aby bylo možné ClickHouse efektivně používat, je nutné navrhnout schéma tak, aby dobře fungovalo v ClickHouse. Tedy se vyhýbat nadměrné normalizaci, používat slovníky a snažit se mít co nejméně dlouhých vazeb. A pokud se schéma takto navrhne, tak podobné obchodní úkoly v ClickHouse mohou být vyřešeny mnohem efektivněji než v tradiční relační databázi.
Děkuji za prezentaci! Mám otázku k poslednímu finančnímu případu. Měli analytiku. Bylo třeba porovnat, jak se vyvíjí nahoru a dolů. A chápu to správně, že jste systém postavili právě pod tuto analytiku? Pokud by zítra potřebovali nějakou jinou zprávu z těchto dat, musí znovu postavit schéma a načíst data? Tedy provádět nějakou předzpracování, abychom získali dotaz?
Samozřejmě, to je využití ClickHouse pro velmi konkrétní úkol. Ten by tradičně mohl být řešen v rámci Hadoopu. Pro Hadoop je to ideální úkol. Ale v Hadoopu je to velmi pomalé. Mým cílem je demonstrovat, že na ClickHouse lze řešit úkoly, které se obvykle řeší zcela jinými prostředky, ale mnohem efektivněji. Je to specificky zaměřené na konkrétní úkol. Je jasné, že pokud je úkol podobný, můžeme ho řešit podobným způsobem.
Rozumím. Řekl jste, že zpracování trvalo 50 hodin. To začíná od samotného začátku, když jste načetli data nebo dostali výsledky?
Ano, ano.
Dobře, děkuji mnohokrát.
To je na tříserverovém clustru.
Zdravím! Děkuji za prezentaci! Všechno je velmi zajímavé. Neptám se moc na funkce, ale na používání ClickHouse z hlediska stability. Došlo u vás k nějakým problémům, museli jste obnovit? Jak se ClickHouse při tom choval? A stalo se, že vám vypadla i replikace? My jsme se například setkali s problémem, kdy ClickHouse přece jen překročil svůj limit a spadl.
Samozřejmě, neexistují dokonalé systémy. A ClickHouse má také své problémy. Ale slyšeli jste někdy o tom, že by Yandex.Metrica dlouho nefungovala? Pravděpodobně ne. Funguje spolehlivě od roku 2012–2013 na ClickHouse. Můžu také říct něco o své zkušenosti. Nikdy jsme neměli úplné selhání. Nějaké částečné problémy se mohly objevit, ale nikdy nebyly tak kritické, aby vážně ovlivnily podnikání. To se nikdy nestalo. ClickHouse je dost spolehlivý a nespadá náhodně. O to se nemusíte obávat. Není to nic syrového. To bylo prokázáno mnoha firmami.
Dobrý den! Řekl jste, že je potřeba hned dobře promyslet datový model. A co když se to stalo? Data se mi nahrávají. Uběhlo půl roku a já si uvědomuji, že takto žít nemohu, musím data znovu nahrát a něco s nimi udělat.
To samozřejmě závisí na vaší soustavě. Existuje několik způsobů, jak to udělat prakticky bez přerušení. Například můžete vytvořit Materialized View, ve kterém vytvoříte jinou strukturu dat, pokud ji lze jednoznačně mapovat. Tedy pokud to umožňuje mapování pomocí ClickHouse, tj. extrakce některých věcí, změna primárního klíče, změna partišcionování, pak lze vytvořit Materialized View. Tam přepíšete své staré data, nové se budou zapisovat automaticky. A pak se jednoduše přepnete na používání Materialized View, poté přepnete zápis a starou tabulku odstraníte. To je způsob bez zastavení.
Děkuji.
Zdroj: habr.com
