

Dobrý den! Jmenuji se Danil Lipovoj, náš tým ve Sbertechu začal používat HBase jako úložiště provozních dat. Během jeho studia jsme nashromáždili zkušenosti, které jsme chtěli systematizovat a popsat (doufáme, že to bude pro mnohé užitečné). Všechny níže uvedené experimenty byly prováděny s verzemi HBase 1.2.0-cdh5.14.2 a 2.0.0-cdh6.0.0-beta1.
- Obecná architektura
- Zápis dat do HBASE
- Čtení dat z HBASE
- Mezipaměť dat
- Hromadné zpracování dat MultiGet/MultiPut
- Strategie rozdělení tabulek na oblasti (splittování)
- Odolnost vůči chybám, kompakce a lokalita dat
- Nastavení a výkon
- Zátěžové testování
- Závěry
1. Obecná architektura
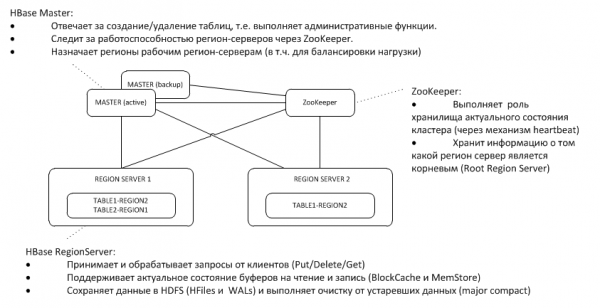
Záložní Master monitoruje heartbeat aktivního na uzlu ZooKeeper a v případě jeho výpadku přebírá funkce Mistra.
2. Zápis dat do HBASE
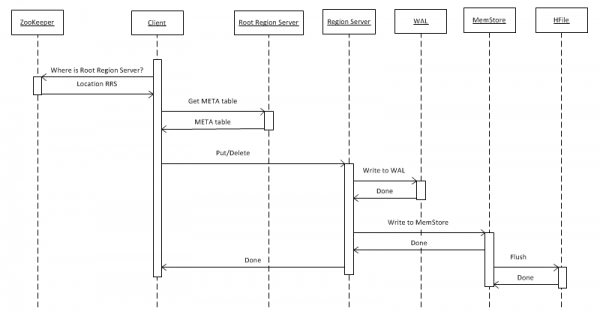
Nejprve se podíváme na nejjednodušší případ – zápis objektu klíč-hodnota do určité tabulky pomocí put(rowkey). Klient nejprve musí zjistit, kde se nachází kořenový region server (Root Region Server — RRS), který uchovává tabulku hbase:meta. Tyto informace získává od ZooKeeper. Poté se obrací na RRS a čte tabulku hbase:meta, ze které získává informace o tom, který RegionServer (RS) odpovídá za uchovávání dat pro zadaný klíč rowkey v zajímavé tabulce. Za účelem dalšího použití je meta-tabulka cachována klientem, a tak jsou následující dotazy rychlejší, přímo k RS.
Poté RS, po přijetí požadavku, nejprve zapíše jeho do WriteAheadLog (WAL), což je nutné pro obnovení v případě pádu. Poté ukládá data do MemStore. To je buffer v paměti, který obsahuje seřazenou sadu klíčů z tohoto regionu. Tabulka může být rozdělena na oblasti (partice), z nichž každá obsahuje nepřekrývající se sadu klíčů. To umožňuje umístit oblasti na různé servery a dosáhnout tak vyšší výkonnosti. I když je tento výrok zřejmý, později uvidíme, že to nefunguje ve všech případech.
Po umístění záznamu do MemStore obdrží klient odpověď, že záznam byl úspěšně uložen. Ve skutečnosti se však ukládá pouze v bufferu a na disk se dostane teprve po uplynutí určitého časového intervalu nebo při naplnění novými daty.
Při provádění operace „Smazat“ nedochází k fyzickému odstranění dat. Ta jsou pouze označena jako smazaná a samotné zničení nastává v okamžiku zavolání funkce major compact, o které je podrobněji pojednáno v bodu 7.
Soubory ve formátu HFile se hromadí v HDFS a čas od času se spouští proces minor compact, který jednoduše spojuje malé soubory do větších, aniž by něco odstraňoval. V průběhu času to přerůstá v problém, který se projevuje pouze při čtení dat (k tomu se vrátíme později).
Kromě výše uvedeného procesu načítání existuje mnohem efektivnější procedura, která představuje asi nejsilnější stránku této databáze – BulkLoad. Ta spočívá v tom, že si sami vytváříme HFiles a ukládáme je na disk, což nám umožňuje vynikající škálovatelnost a dosahovat velmi slušných rychlostí. V podstatě je zde omezením nikoliv HBase, ale možnosti hardwaru. Níže jsou uvedeny výsledky načítání na clusteru složeném z 16 RegionServers a 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 vláken), verze HBase 1.2.0-cdh5.14.2.
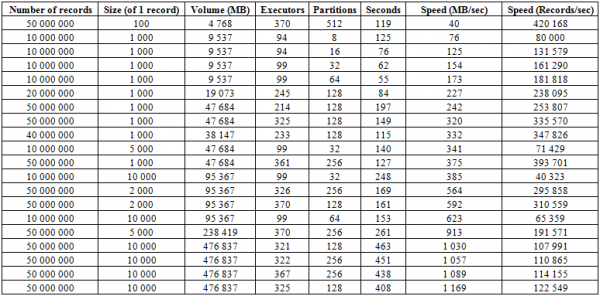
Zde je vidět, že zvyšováním počtu partií (regionů) v tabulce, stejně jako executorů Spark, získáváme nárůst rychlosti načítání. Také rychlost závisí na objemu zápisu. Velké bloky přinášejí nárůst v měření MB/s, malé v počtu vložených záznamů za jednotku času, při jinak stejných podmínkách.
Také můžeme spustit načítání do dvou tabulek současně a získat zdvojení rychlosti. Níže lze vidět, že zápis bloků 10 KB najednou do dvou tabulek probíhá rychlostí kolem 600 MB/s do každé (celkem 1275 MB/s), což odpovídá rychlosti zápisu do jedné tabulky 623 MB/s (viz č. 11 výše).
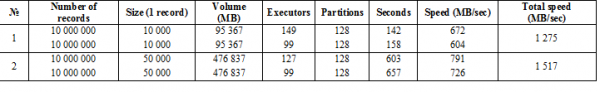
Druhá relace se zápisy o velikosti 50 KB ukazuje, že rychlost načítání již neroste výrazně, což naznačuje blížící se k limitním hodnotám. Je třeba mít na paměti, že na samotném HBASE zde prakticky nevzniká zátěž, vše, co od něj vyžaduje, je nejprve vrátit data z hbase:meta, a poté po vložení HFiles vyprázdnit data BlockCache a uložit buffer MemStore na disk, pokud není prázdný.
3. Čtení dat z HBASE
Pokud předpokládáme, že všechny informace z hbase:meta má klient již k dispozici (viz bod 2), pak dotaz ihned zamíří na ten RS, kde je uložený požadovaný klíč. Nejprve se provádí hledání v MemCache. Bez ohledu na to, zda tam data jsou či nikoliv, je hledání také prováděno v bloku BlockCache a v případě potřeby v HFiles. Pokud jsou data nalezena v souboru, jsou uložena do BlockCache a při dalším dotazu budou vrácena rychleji. Hledání v HFile probíhá díky použití Bloomova filtru relativně rychle, tzn. po načtení malého množství dat okamžitě určí, zda tento soubor obsahuje požadovaný klíč, a pokud ne, přechází na další.
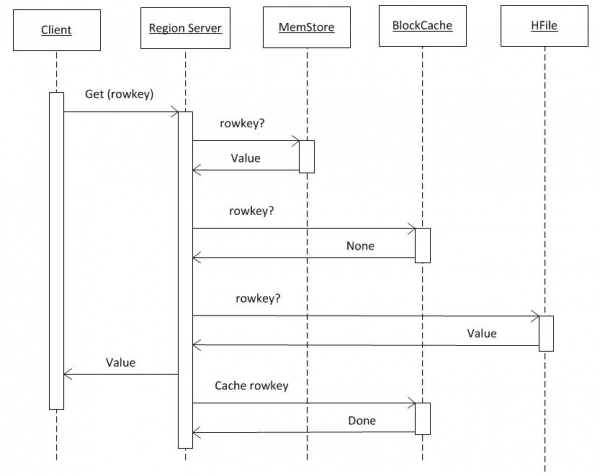
Po získání dat z těchto tří zdrojů RS vytváří odpověď. Může například okamžitě předat několik nalezených verzí objektu, pokud klient požadoval verze.
4. Kešování dat
Paměťové buffery MemStore a BlockCache zabírají až 80 % vyhrazené on-heap paměti RS (zbytek je rezervován pro servisní úkoly RS). Pokud je typické použití takové, že procesy zapisují a okamžitě čtou tato stejná data, má smysl snížit BlockCache a zvýšit MemStore, protože při zápisu data do cache na čtení nepadají, takže používání BlockCache bude méně časté. Buffer BlockCache se skládá ze dvou částí: LruBlockCache (vždy on-heap) a BucketCache (obvykle off-heap nebo na SSD). BucketCache by měl být použit, když je velmi vysoký počet dotazů na čtení a ta se nevejdou do LruBlockCache, což vede k aktivnímu provozu Garbage Collector. Zároveň není reálně možné očekávat radikální nárůst výkonu z používání cache na čtení, nicméně k tomu se ještě vrátíme v bodě 8.
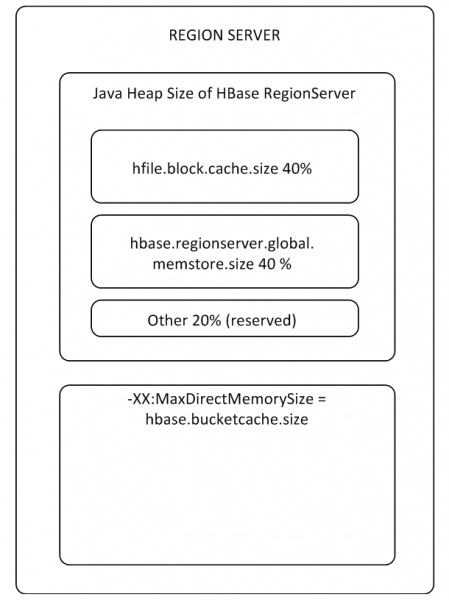
BlockCache je jeden pro celý RS, zatímco MemStore je pro každou tabulku zvláštní (po jednom na každý Column Family).
Jak Teoreticky, při zápisu data do cache nepadají a skutečně jsou takové parametry CACHE_DATA_ON_WRITE pro tabulku a „Cache DATA on Write“ pro RS nastaveny na false. Nicméně v praxi, pokud zapíšeme data do MemStore, poté je vyprázdníme na disk (tímto způsobem), následně odstraníme vzniklý soubor, při vykonávání dotazu get úspěšně získáme data. Navíc, i když zcela vypneme BlockCache a naplníme tabulku novými daty, pak dosáhneme vyprázdnění MemStore na disk, pokud je odstraníme a požádáme z jiné relace, data se stejně nějakým způsobem získají. Takže HBase uchovává nejen data, ale také tajemné záhady.
hbase(main):001:0> create 'ns:magic', 'cf'
Created table ns:magic
Took 1.1533 seconds
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Took 0.2610 seconds
hbase(main):003:0> flush 'ns:magic'
Took 0.6161 seconds
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, value=try_to_delete_me
Parametr „Cache DATA on Read“ je nastaven na false. Pokud máte nějaké nápady, vítáme vaše komentáře.
5. Hromadné zpracování dat MultiGet/MultiPut
Zpracování jednotlivých požadavků (Get/Put/Delete) je poměrně nákladná operace, proto byste je měli co nejvíce sdružovat do seznamu, což umožňuje dosáhnout značného zvýšení výkonu. To platí zejména pro zápis, ale při čtení existuje následující úskalí. Na grafu níže je uveden čas čtení 50 000 záznamů z MemStore. Čtení probíhalo v jednom vláknu a na vodorovné ose je uveden počet klíčů v požadavku. Zde je vidět, že při zvýšení na tisíc klíčů v jednom požadavku klesá doba vykonání, tj. rychlost se zvyšuje. Ovšem při zapnutém výchozím režimu MSLAB po tomto prahu začíná radikální pokles výkonu, přičemž čím větší je objem dat v záznamu, tím více roste doba zpracování.
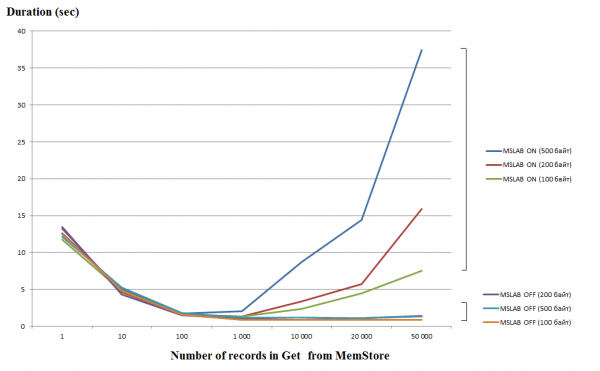
Testy byly prováděny na virtuálním stroji, 8 jader, verze HBase 2.0.0-cdh6.0.0-beta1.
Režim MSLAB slouží ke snížení fragmentace haldy, která vzniká mísením dat nových a starých generací. Jako řešení problému při aktivaci MSLAB se data umisťují do relativně malých buněk (chunk) a zpracovávají se po dávkách. V důsledku toho, když objem požadovaného balíčku dat překročí vyhrazenou velikost, dojde k radikálnímu poklesu výkonu. Na druhou stranu, vypnutí tohoto režimu je také nežádoucí, protože to povede k zástavám kvůli GC v obdobích intenzivní práce s daty. Dobré řešení je zvýšení objemů buněk, když dochází k aktivnímu zápisu přes put současně s čtením. Je třeba poznamenat, že problém nevzniká, pokud po zápisu provedete příkaz flush, který ukládá MemStore na disk, nebo pokud provedete načtení pomocí BulkLoad. V tabulce níže je uvedeno, že dotazy z MemStore s větším objemem dat (a stejným množstvím) vedou k zpomalení. Nicméně zvýšením velikosti chunksize se doba zpracování vrací na normu.
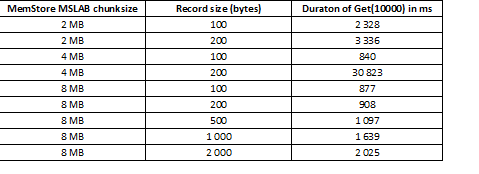
Kromě zvýšení chunksize pomáhá dělení dat podle regionů, tedy rozdělení tabulek. To způsobuje, že na každý region přichází menší počet dotazů a pokud jsou umístěny do buněk, odezva zůstává dobrá.
6. Strategie rozdělení tabulek na regiony (splitting)
Jelikož HBase je úložiště klíč-hodnota a partitioning se provádí podle klíče, je velmi důležité rozdělovat data rovnoměrně mezi všechny regiony. Například rozdělení takové tabulky na tři části povede k tomu, že data budou rozdělena do tří regionů:
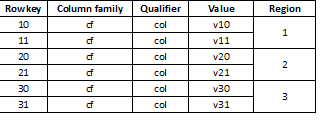
Někdy to vede k výraznému zpomalení, pokud budou později načítané data většinou obsahovat long hodnoty, které začínají stejnou číslicí, například:
1000001
1000002
…
1100003
Jelikož jsou klíče ukládány jako pole bytů, všechna budou začínat stejně a vztahovat se k regionu #1 ukládajícímu tuto oblast klíčů. Existuje několik strategií rozdělení:
HexStringSplit – Převádí klíč na řetězec s hexadecimálním kódováním v rozsahu „00000000“ => „FFFFFFFF“ a vyplňuje zleva nulami.
UniformSplit – Převádí klíč na pole bytů s hexadecimálním kódováním v rozsahu „00“ => „FF“ a vyplňuje zprava nulami.
Kromě toho lze specifikovat libovolný rozsah nebo sadu klíčů pro rozdělení a nastavit automatické dělení. Avšak jedním z nejjednodušších a nejúčinnějších přístupů je UniformSplit a použití koncatenace hashe, například nejvyšší dvojice bytů od spuštění klíče pomocí funkce CRC32(rowkey) a vlastně rowkey:
hash + rowkey
Všechny data budou rovnoměrně rozložena mezi regiony. Při čtení se prvních dva byty jednoduše zahodí a zůstane původní klíč. Také RS kontroluje množství dat a klíčů v regionu a při překročení limitů je automaticky rozdělí na části.
7. Odolnost vůči poruchám a lokalita dat
Jelikož každý soubor klíčů odpovídá pouze jednomu regionu, řešením problémů spojených s pády RS nebo jejich vyřazováním z provozu je ukládání všech potřebných dat do HDFS. Při pádu RS to master zjistí prostřednictvím nedostatku heartbeat na uzlu ZooKeeper. Poté přiřadí obsluhovaný region jinému RS a protože HFiles jsou uloženy v distribuovaném souborovém systému, nový majitel je vyčte a pokračuje v obsluze dat. Nicméně, protože část dat může být v MemStore a nestihla se dostat do HFiles, pro obnovení historie operací se používá WAL, který je také uložen v HDFS. Po aplikaci změn je RS schopen odpovídat na dotazy, nicméně přestěhování vede k tomu, že část dat a procesy, které je obsluhují, se nacházejí na různých uzlech, což znamená, že se snižuje lokalita.
Řešením problému je major compaction – tento proces přesouvá soubory na ty uzly, které jsou za ně zodpovědné (tam, kde se nacházejí jejich regiony), což má za následek prudký nárůst zatížení sítě a disků během této procedury. V budoucnu však bude přístup k datům znatelně urychlen. Kromě toho major_compaction provádí sloučení všech HFiles do jednoho souboru v rámci regionu a také čistí data podle nastavení tabulky. Například lze určit počet verzí objektu, které je třeba uchovávat, nebo jeho životnost, po jejímž uplynutí je objekt fyzicky smazán.
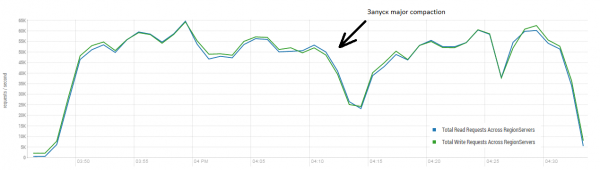
Tento proces může mít velmi pozitivní vliv na výkon HBase. Na obrázku níže je vidět, jak se zhoršila výkonnost v důsledku aktivního zápisu dat. Můžeme vidět, jak do jedné tabulky zapisovalo 40 vláken a 40 vláken současně četlo data. Píšící vlákna generují stále více a více HFiles, které jsou čteny jinými vlákny. V důsledku toho je třeba stále více dat smazat z paměti a nakonec začne fungovat GC, který téměř paralyzuje celou práci. Spuštění major compaction vedlo k vyčištění nahromaděných dat a obnovení výkonu.
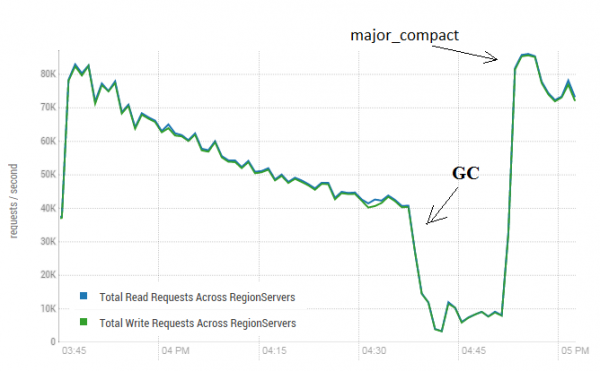
Test byl proveden na 3 DataNode a 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 vláken). Verze HBase 1.2.0-cdh5.14.2
Je třeba poznamenat, že major compaction byla provedena na 'živé' tabulce, do které se aktivně zapisovala a četla data. V síti se objevovalo tvrzení, že to může vést k nesprávným odpovědím při čtení dat. Pro ověření byl spuštěn proces, který generoval nová data a zapisoval je do tabulky. Po čemž se okamžitě četlo a porovnávalo, zda získaná hodnota souhlasí s tím, co bylo zapsáno. Během práce tohoto procesu se major compaction spustil asi 200krát a nebyla zaznamenána žádná selhání. Problematika se pravděpodobně projevuje vzácně a pouze během vysokého zatížení, proto je více bezpečné plánovaně zastavit procesy zápisu a čtení a provést vyčištění, aby se předešlo takovým výpadkům GC.
Také major compaction neovlivňuje stav MemStore, pro jeho vyprázdnění na disk a kompakci je potřeba použít flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Nastavení a výkon
Jak již bylo řečeno, největší úspěch HBase dosahuje tam, kde nemusí nic dělat, při provádění BulkLoad. Nicméně to platí pro většinu systémů a lidí. Tento nástroj je spíše určen pro hromadné ukládání dat ve velkých blocích, zatímco pokud proces vyžaduje provádění mnoha konkurenčních čtecích a zapisovacích požadavků, používají se výše popsané příkazy Get a Put. Pro stanovení optimálních parametrů byly provedeny spuštění při různých kombinacích parametrů tabulek a nastavení:
- Bylo spuštěno 10 vláken současně 3krát za sebou (nazveme to blok vláken).
- Doba práce všech vláken v bloku byla průměrována a představovala výsledný výsledek práce bloku.
- Všechna vlákna pracovala se stejnou tabulkou.
- Před každým spuštěním bloku vláken byla provedena major compaction.
- Každý blok vykonával pouze jednu z následujících operací:
— Put
— Get
— Get+Put
- Každý blok vykonal 50 000 opakování své operace.
- Velikost záznamu v bloku byla 100 bajtů, 1000 bajtů nebo 10000 bajtů (náhodně).
- Bloky byly spouštěny s různým počtem požadovaných klíčů (buď jeden klíč nebo 10).
- Bloky byly spouštěny při různých nastaveních tabulky. Byly změněny parametry:
— BlockCache = zapnuto nebo vypnuto
— BlockSize = 65 kB nebo 16 kB
— Partice = 1, 5 nebo 30
— MSLAB = zapnuto nebo vypnuto
Tak blok vypadá takto:
a. MSLAB režim byl zapnutý/vypnutý.
b. Byla vytvořena tabulka, pro kterou byly nastaveny následující parametry: BlockCache = true/none, BlockSize = 65/16 Kb, Počet partition = 1/5/30.
c. Bylo nastaveno GZ komprese.
d. Byl spuštěn 10 vláken současně provádějících 1/10 operací put/get/get+put v této tabulce se záznamy o velikosti 100/1000/10000 bytů, přičemž bylo provedeno 50 000 dotazů v řadě (klíče byly náhodné).
e. Bod d byl zopakován třikrát.
f. Čas běhu všech vláken byl průměrován.
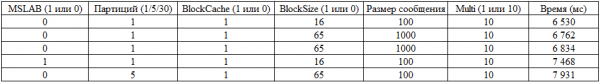
Byly zkontrolovány všechny možné kombinace. Předvídatelně, při zvyšování velikosti záznamu dochází ke zpomalení nebo že vypnutí cache způsobí zpoždění. Nicméně cílem bylo pochopit míru a význam vlivu každého parametru, takže shromážděná data byla předána funkci lineární regrese, což umožňuje posoudit spolehlivost pomocí t-statistiky. Níže jsou uvedeny výsledky práce bloků provádějících operace Put. Celý soubor kombinací 2*2*3*2*3 = 144 variant + 72, protože některé byly provedeny dvakrát. Celkem tedy 216 spuštění:
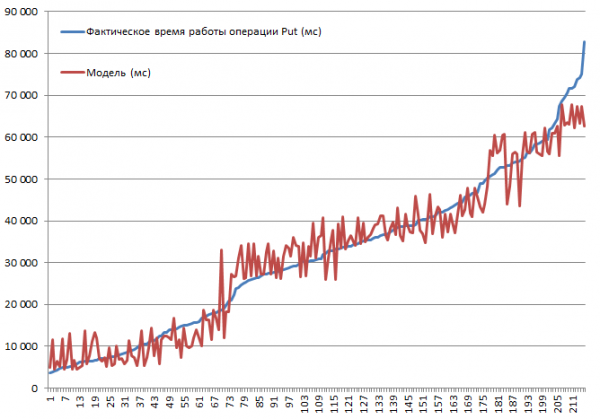
Testování probíhalo na mini-klastri složeném ze 3 DataNode a 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 vláken). Verze HBase 1.2.0-cdh5.14.2.
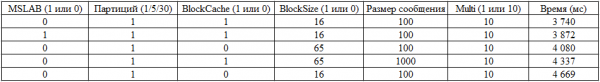
Nejvyšší rychlost vkládání 3.7 sekundy byla dosažena při vypnutém režimu MSLAB, na tabulce s jednou partition, s zapnutým BlockCache, BlockSize = 16, záznamy o velikosti 100 bytů po 10 kusech v balíčku.
Nejnižší rychlost vkládání 82.8 sekundy byla dosažena při zapnutém režimu MSLAB, na tabulce s jednou partition, s zapnutým BlockCache, BlockSize = 16, záznamy o velikosti 10000 bytů po 1 kuse.
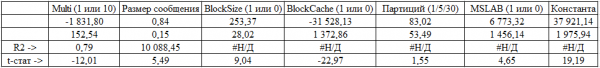
Nyní se podívejme na model. Vidíme dobrou kvalitu modelu podle R2, ale je zcela jasné, že extrapolace je zde kontraindikována. Skutečné chování systému při změně parametrů nebude lineární, tento model není určen pro prognózy, ale pro pochopení, co se stalo v rámci stanovených parametrů. Například zde vidíme podle kritéria Student, že pro operaci Put nemají parametry BlockSize a BlockCache význam (což je celkem předvídatelné):
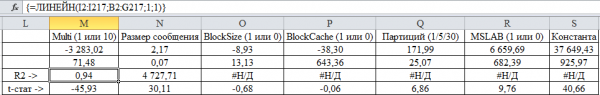
Zvýšení počtu partitionů sice vedlo k poklesu výkonu, což je poměrně překvapivé (už jsme uváděli pozitivní vliv zvýšení počtu partitionů při BulkLoad), přesto je to vysvětlitelné. Za prvé, zpracování musí vytvářet dotazy na 30 regionů místo jednoho, přičemž objem dat není tak velký, aby to přineslo výhodu. Za druhé, celkový čas práce je určen nejpomalejším RS a protože je počet DataNode menší než počet RS, část regionů má nulovou lokalitu. A nyní se podívejme na pětici lídrů:
Nyní zhodnotíme výsledky provedení bloků Get:
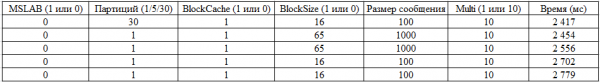
Počet partitionů ztratil význam, což pravděpodobně vysvětluje, že data se dobře ukládají do cache a cache pro čtení je nejvýznamnějším (statisticky) parametrem. Samozřejmě, že zvýšení množství zpráv v dotazu je také velmi užitečné pro výkon. Nejlepší výsledky:
A nakonec se podíváme na model bloku, který nejprve provedl get a poté put:
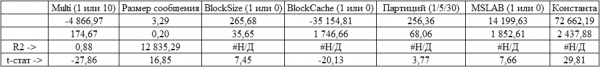
Zde jsou všechny parametry významné. A výsledky lídrů:
9. Zátěžové testování
A nakonec spustíme přiměřenou zátěž, ale vždy je zajímavější, když je s čím srovnávat. Na webu DataStax – klíčového vývojáře Cassandry, je NT několika NoSQL úložišť, včetně HBase verze 0.98.6-1. Nahrávání probíhalo 40 vlákny, velikost dat 100 bytů, disky SSD. Výsledky testování operací Read-Modify-Write ukázaly takové výsledky.
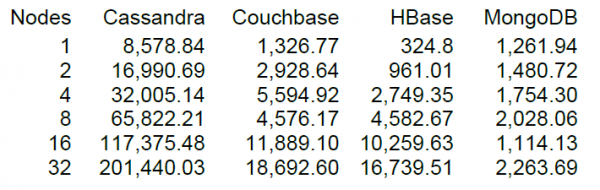
Pokud jsem dobře pochopil, čtení probíhalo po blocích po 100 záznamech a pro 16 uzlů HBase test DataStax ukázal výkon 10 tisíc operací za sekundu.
Je dobře, že v našem clusteru je také 16 uzlů, ale není to příliš „dobré“, že každý má 64 jader (vláken), zatímco v testu DataStax měl každý pouze 4. Na druhou stranu mají SSD disky, zatímco my máme HDD a novější verzi HBase, a vytížení CPU během zátěže se prakticky nezvyšovalo (vizuálně o 5-10 procent). Nicméně se pokusíme spustit na této konfiguraci. Nastavení tabulek je výchozí, čtení je prováděno v rozsahu klíčů od 0 do 50 milionů náhodně (tj. v podstatě pokaždé nové). V tabulce je 50 milionů záznamů, rozdělených na 64 partií. Klíče jsou hašovány pomocí crc32. Nastavení tabulek jsou výchozí, MSLAB je zapnuto. Spustíme 40 vláken, každé vlákno čte sadu 100 náhodných klíčů a okamžitě zapisuje vygenerovaných 100 bytů zpět podle těchto klíčů.
Stánek: 16 DataNode a 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 vláken). Verze HBase 1.2.0-cdh5.14.2.
Průměrný výsledek se blíží 40 tisíc operací za sekundu, což je výrazně lepší než v testu DataStax. V experimentálních podmínkách je však možné několik změn. Je velmi nepravděpodobné, že by veškerá práce probíhala výhradně s jednou tabulkou, stejně jako pouze s unikátními klíči. Předpokládejme, že existuje nějaká „horká“ sada klíčů, která generuje hlavní zátěž. Proto se pokusíme vytvořit zátěž s většími záznamy (10 KB), také po 100, do 4 různých tabulek a omezíme rozsah dotazovaných klíčů na 50 tisíc. Na grafu níže je zobrazeno spuštění 40 vláken, každé vlákno čte sadu 100 klíčů a okamžitě zapisuje náhodné 10 KB podle těchto klíčů zpět.
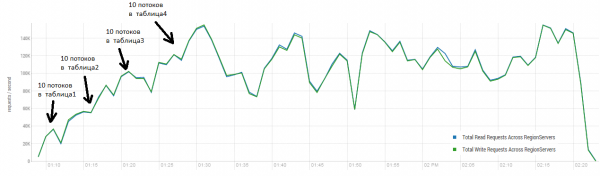
Stánek: 16 DataNode a 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 vláken). Verze HBase 1.2.0-cdh5.14.2.
Během zátěže se několikrát spouštěla major compaction, jak bylo uvedeno výše, bez tohoto postupu by výkon postupně degradoval, avšak během provádění také vzniká dodatečná zátěž. Poklesy jsou způsobeny různými důvody. Někdy vlákna dokončila svou práci a zatímco se restartovala, došlo k prodlevě, někdy externí aplikace vytvářely zátěž na cluster.
Čtení a okamžité zapisování je jedním z nejnáročnějších scénářů pro HBase. Pokud se používají pouze malé PUT požadavky, například o velikosti 100 bytů, a skupinují se do bloků po 10–50 tisících, lze dosáhnout stovek tisíc operací za sekundu a podobně to platí i pro požadavky pouze na čtení. Je třeba zdůraznit, že výsledky jsou radikálně lepší než ty, které získal DataStax, především díky blokovým požadavkům po 50 tisících.
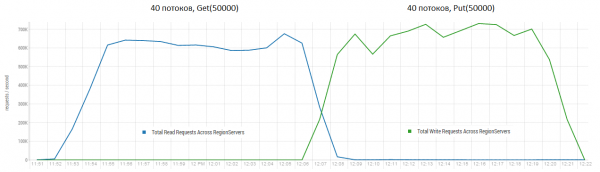
Stánek: 16 DataNode a 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 vláken). Verze HBase 1.2.0-cdh5.14.2.
10. Závěry
Tento systém se dá poměrně flexibilně nastavit, avšak vliv velkého množství parametrů stále zůstává neznámý. Některé z nich byly testovány, ale nebyly zahrnuty do konečné sady testů. Například předběžné experimenty ukázaly malou významnost parametru DATA_BLOCK_ENCODING, který kóduje informace za použití hodnot z okolních buněk, což je celkem logické pro data generovaná náhodně. V případě použití velkého množství opakujících se objektů může být zisk značný. Obecně lze říci, že HBase působí jako velmi seriózní a promyšlená databáze, která může být při operacích s velkými bloky dat dostatečně výkonná. Zvlášť pokud existuje možnost rozložit časové procesy čtení a zápisu.
Pokud máte pocit, že něco není dostatečně podrobně vysvětleno, rád se podělím o více informací. Nabízíme možnost sdílet své zkušenosti nebo diskutovat, pokud nesouhlasíte s něčím.
Zdroj: habr.com
