

Rád bych vám pověděl o novém CLI nástroji, který jsem napsal pro řešení jedné staré problému.
Problém
Terraform se už dávno stal standardem v komunitě DevOps/Cloud/IT. Je to velmi pohodlný a užitečný nástroj pro práci s infrastrukturu jako kódem. Terraform má mnoho výhod, ale také spoustu klacků pod nohama, ostrých nožů a skrytých pastí.
S Terraformem je velmi snadné vytvářet nové věci a poté je spravovat, měnit nebo mazat. Ale co dělat s těmi, kteří mají obrovskou infrastrukturu v cloudu, kterou nevytvořili pomocí Terraformu? Přeprogramovat a znovu vytvořit celé cloudové prostředí je dost drahé a riskantní.
S touto problematikou jsem se setkal na dvou pracovištích. Nejjednodušší příklad je, když chcete, aby všechno bylo ve formátu git jako Terraform soubory, ale máte více než 250 bucketů a psát je ručně pro Terraform je prostě příliš.
Existuje Už od roku 2014 je zde terrafom, který byl uzavřen v roce 2016, s nadějí, že bude implementováno načítání.
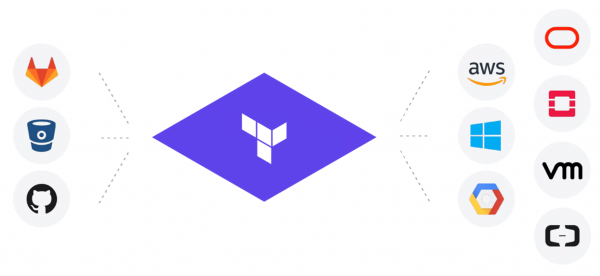
Celkově je to jako na obrázku, jen zprava doleva.
Upozornění: Autor žije polovinu života mimo Rusko a málo píše rusky. Buďte opatrní – mohou být pravopisné chyby.
Řešení.
1. Existují hotová a stará řešení pro AWS. . Když jsem se pokusil pomocí tohoto nástroje získat své 250+ bucketů, uvedomil jsem si, že to je velmi špatné. AWS již dávno přidalo mnoho nových možností, o kterých terraforming neví, a navíc používá Ruby. . Po 2 hodinách jsem poslal , abych přidal více možností, a pochopil jsem, že takové řešení vůbec nevyhovuje.
Jak funguje terraforming? Bere data ze SDK AWS a generuje tf a tfstate pomocí šablony.
Zde jsou 3 problémy:
1. Vždy tam bude zpoždění v aktualizacích.
2. tf soubory někdy vycházejí poškozené.
3. tfstate se vytváří odděleně od tf a ne vždy se shoduje.
Je opravdu obtížné získat výsledek, u kterého 'terraform plan' říká, že nedošlo k žádným změnám.
2. 'terraform import' – vestavěný příkaz v Terraformu. Jak funguje?
Napíšete prázdný TF soubor se jménem a typem zdroje, poté spustíte 'terraform import' a předáte ID zdroje. Terraform se obrací na poskytovatele, získává data a vytváří tfstate soubor.
Zde jsou 3 problémy:
1. Získáváme pouze tfstate soubor, ale tf je prázdný a musíme ho psát ručně nebo konvertovat z tfstate.
2. Může pracovat pouze s jedním zdrojem najednou a nepodporuje všechny zdroje. A co mám znovu dělat s 250+ buckety?
3. Musíte znát ID zdrojů – tedy musíte to obalit do kódu, který získá seznam zdrojů.
Celkově je výsledek částečný a neškáluje se dobře.
Moje řešení
Požadavky:
1. Možnost vytvořit soubory tf a tfstate z prostředků. Například stáhnout všechny bucket/y, security group/ů, load balancer a co `terraform plan` vrací, že nejsou žádné změny
2. Potřebujeme 2 cloudové služby GCP + AWS
3. Globální řešení, které se snadno aktualizuje a nevyžaduje tři dny práce na každý prostředek
4. Udělat open source — problém, který má každý
Jazyk Go — proto ho mám rád, a je v něm knihovna pro vytváření HCL souborů, která se používá v terraformu + spousta kódu v terraformu, který může být užitečný
Cesta
První pokus
Začal jsem s jednoduchou variantou. Volání do cloudu přes SDK pro potřebný prostředek a jeho převod do polí pro terraform. Pokus selhal hned na security group, protože se mi nelíbilo 1,5 dne převádět pouze security group (resursů je hodně). Dlouhé, a pak mohou pole měnit/přidávat
Druhý pokus
Založeno na nápadu, který je popsán . Stačí vzít a převést tfstate na tf. Všechna data tam jsou a pole jsou stejná. Jak získat kompletní tfstate pro mnoho prostředků?? Sem přišla na pomoc příkaz `terraform refresh`. Terraform vezme všechny prostředky v tfstate a podle ID vytáhne data a zapíše vše do tfstate. To znamená vytvořit prázdný tfstate pouze s názvy a ID, spustit `terraform refresh` a dostaneme plné tfstate. Hurá!
Teď se pustíme do rekurzivního psaní převodníku pro tfstate na tf. Pro ty, kteří nikdy nečetli tfstate, to je JSON, ale speciální.
Zde je jeho důležitá část attributes
 "attributes": {
                            "id": "default/backend-logging-load-deployment",
                            "metadata.#": "1",
                            "metadata.0.annotations.%": "0",
                            "metadata.0.generate_name": "",
                            "metadata.0.generation": "24",
                            "metadata.0.labels.%": "1",
                            "metadata.0.labels.app": "backend-logging",
                            "metadata.0.name": "backend-logging-load-deployment",
                            "metadata.0.namespace": "default",
                            "metadata.0.resource_version": "109317427",
                            "metadata.0.self_link": "\/apis\/apps\/v1\/namespaces\/default\/deployments\/backend-logging-load-deployment",
                            "metadata.0.uid": "300ecda1-4138-11e9-9d5d-42010a8400b5",
                            "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
Tady je:
1. id — string
2. metadata — pole velikosti 1 a v něm objekt s poli uvedenými níže
3. spec — hash velikosti 1 a v něm key,value
Zkrátka zábavný formát, všechno může být do hloubky také na několik úrovní
                   "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
                            "spec.0.selector.0.match_expressions.#": "0",
                            "spec.0.selector.0.match_labels.%": "1",
                            "spec.0.selector.0.match_labels.app": "backend-logging-load",
                            "spec.0.strategy.#": "0",
                            "spec.0.template.#": "1",
                            "spec.0.template.0.metadata.#": "1",
                            "spec.0.template.0.metadata.0.annotations.%": "0",
                            "spec.0.template.0.metadata.0.generate_name": "",
                            "spec.0.template.0.metadata.0.generation": "0",
                            "spec.0.template.0.metadata.0.labels.%": "1",
                            "spec.0.template.0.metadata.0.labels.app": "backend-logging-load",
                            "spec.0.template.0.metadata.0.name": "",
                            "spec.0.template.0.metadata.0.namespace": "",
                            "spec.0.template.0.metadata.0.resource_version": "",
                            "spec.0.template.0.metadata.0.self_link": "",
                            "spec.0.template.0.metadata.0.uid": "",
                            "spec.0.template.0.spec.#": "1",
                            "spec.0.template.0.spec.0.active_deadline_seconds": "0",
                            "spec.0.template.0.spec.0.container.#": "1",
                            "spec.0.template.0.spec.0.container.0.args.#": "3",
Pokud chcete úlohu na programování pro pohovor, prostě si nechte napsat parser na tohle 🙂
Po dlouhých pokusech napsat parser bez chyb jsem našel část jeho v kódu terraform, a to nejdůležitější. A vše vypadalo normálně.
PokAttempt tři
Terraform provider je binárka, která obsahuje kód se všemi zdroji a logikou pro práci s API cloudů. Každý cloud má svého poskytovatele a terraform je pouze volá prostřednictvím svého protokolu RPC mezi dvěma procesy.
Teď jsem se rozhodl komunikovat přímo s terraform providery prostřednictvím RPC volání. Dopadlo to hezky a umožnilo to měnit terraform providery na novější verze a získávat nové možnosti, aniž bych musel měnit kód. Také se ukázalo, že ne všechna pole v tfstate musí být v tf, jak to zjistit? Jedině se to zeptat providera. Pak začalo další kolo složitého shánění regulárních výrazů pro hledání polí uvnitř tfstate na všech úrovních.
Na konci mi vyšel užitečný CLI nástroj, který má společnou infrastrukturu pro všechny terraform providery a umožňuje snadno přidávat nové. Také přidání zdrojů zabírá málo kódu. Plus různé vychytávky jako spojení mezi zdroji. Samozřejmě bylo spoustu různých problémů, které se nedají všechny popsat.
Nazval jsem ten nástroj Terrafomer.
Finał
Pomocí Terrafomeru jsme vygenerovali 500-700 tisíc řádků kódu tf + tfstate ve dvou cloudech. Dokázali jsme vzít legacy věci a začít je upravovat pouze prostřednictvím terraformu, jak se to dělá v nejlepších praxích infrastruktury jako kódu. Je to prostě magie, když vezmete obří cloud a získáte ho prostřednictvím příkazu ve formě pracovních terraform souborů. A dál grep/replace/git a tak dále.
Vypočítal jsem a uspořádal, získal povolení. Publikoval jsem to na Githubu pro všechny ve čtvrtek (02.05.19).
Už jsem získal 600 hvězd, 2 pull requesty k přidání podpory pro OpenStack a Kubernetes. Dobré recenze. Celkově je projekt užitečný pro lidi.
Doporučuji všem, kteří chtějí začít pracovat s Terraform a nechtějí přepisovat všechno.
Budu rád za pull requesty, problémy, hvězdy.
Demo
Zdroj: habr.com
