

V této studii jsem chtěl zkoumat, jakých výkonových zlepšení mohu dosáhnout použitím datového zdroje ClickHouse místo PostgreSQL. Vím, jaké výhody výkonu získávám při používání ClickHouse. Zachovají se tyto výhody, pokud získám přístup k ClickHouse z PostgreSQL pomocí externí datové obálky (FDW)?
Zkoumanými databázovými prostředími jsou PostgreSQL v11, clickhousedb_fdw a databáze ClickHouse. Nakonec budeme z PostgreSQL v11 spouštět různé SQL dotazy, které budou směrovány přes náš clickhousedb_fdw do databáze ClickHouse. Poté uvidíme, jak se výkon FDW porovná s těmi samými dotazy prováděnými v nativním PostgreSQL a nativním ClickHouse.
Databáze ClickHouse
ClickHouse je systém správy databází založený na sloupcích s otevřeným zdrojovým kódem, který může dosahovat výkonu 100-1000x rychleji než tradiční přístupy k databázím a je schopen zpracovávat více než miliardu řádků za méně než sekundu.
Clickhousedb_fdw
clickhousedb_fdw je obálka externích dat databáze ClickHouse, nebo FDW, je projekt s otevřeným zdrojovým kódem od Percona. .
.
Jak uvidíte, poskytuje FDW pro ClickHouse, který umožňuje SELECT from a INSERT INTO databáze ClickHouse ze serveru PostgreSQL v11.
FDW podporuje pokročilé funkce, jako jsou agregace a spojení. To výrazně zvyšuje výkon díky využití zdrojů vzdáleného serveru pro tyto náročné operace.
Benchmarkové prostředí
- Server Supermicro:
- Intel® Xeon® CPU E5-2683 v3 @ 2.00GHz
- 2 sokety / 28 jader / 56 vláken
- Paměť: 256GB RAM
- Úložiště: Samsung SM863 1.9TB Enterprise SSD
- Souborový systém: ext4/xfs
- OS: Linux smblade01 4.15.0-42-generic #45~16.04.1-Ubuntu
- PostgreSQL: verze 11
Benchmarkové testy
Místo použití nějaké datové sady generované strojově, jsme pro tento test použili data "Výkon podle času, vykazovaného o době provozu operátora" od roku 1987 do 2018. K datům se můžete dostat .
Velikost databáze je 85 GB, což zabezpečuje jednu tabulku se 109 sloupci.
Benchmarkové dotazy
Zde jsou dotazy, které jsem použil k porovnání ClickHouse, clickhousedb_fdw a PostgreSQL.
Q#
Dotaz obsahuje agregace a GROUP BY
Q1
SELECT DayOfWeek, count(*) AS c FROM ontime WHERE Year >= 2000 AND Year <= 2008 GROUP BY DayOfWeek ORDER BY c DESC;
Q2
VYBERTE DenVTýdnu, COUNT(*) jako c FROM ontime WHERE DepDelay>10 A Rok >= 2000 A Rok <= 2008 SKUPINA PODLE DenVTýdnu OBJEDNAT PODLE c DESC;
Q3
VYBERTE Původ, COUNT(*) jako c Z ontime WHERE DepDelay>10 A Rok >= 2000 A Rok <= 2008 SKUPINA PODLE Původ OBJEDNAT PODLE c DESC LIMIT 10;
Q4
VYBERTE Dopravce, COUNT() Z ontime WHERE DepDelay>10 A Rok = 2007 SKUPINA PODLE Dopravce OBJEDNAT PODLE COUNT() DESC;
Q5
VYBERTE a.Dopravce, c, c2, c1000/c2 jako c3 Z ( VYBERTE Dopravce, COUNT() jako c Z ontime WHERE DepDelay>10 A Rok=2007 SKUPINA PODLE Dopravce ) a VNITŘNÍ PŘIPOJENÍ ( VYBERTE Dopravce, COUNT(*) jako c2 Z ontime WHERE Rok=2007 SKUPINA PODLE Dopravce) b na a.Dopravce=b.Dopravce OBJEDNAT PODLE c3 DESC;
Q6
VYBERTE a.Dopravce, c, c2, c1000/c2 jako c3 Z ( VYBERTE Dopravce, COUNT() jako c Z ontime WHERE DepDelay>10 A Rok >= 2000 A Rok = 2000 A Rok <= 2008 SKUPINA PODLE Dopravce ) b na a.Dopravce=b.Dopravce OBJEDNAT PODLE c3 DESC;
Q7
VYBERTE Dopravce, průměr(DepDelay) * 1000 jako c3 Z ontime WHERE Rok >= 2000 A Rok <= 2008 SKUPINA PODLE Dopravce;
Q8
VYBERTE Rok, průměr(DepDelay) Z ontime SKUPINA PODLE Rok;
Q9
vyberte Rok, COUNT(*) jako c1 z ontime skupina podle Rok;
Q10
VYBERTE průměr(cnt) Z (VYBERTE Rok, Měsíc, COUNT(*) jako cnt Z ontime WHERE DepDel15=1 SKUPINA PODLE Rok, Měsíc) a;
Q11
vyberte průměr(c1) z (vyberte Rok, Měsíc, COUNT(*) jako c1 z ontime skupina podle Rok, Měsíc) a;
Q12
VYBERTE PůvodMěsto, DestMěsto, COUNT(*) jako c Z ontime SKUPINA PODLE PůvodMěsto, DestMěsto OBJEDNAT PODLE c DESC LIMIT 10;
Q13
VYBERTE PůvodMěsto, COUNT(*) jako c Z ontime SKUPINA PODLE PůvodMěsto OBJEDNAT PODLE c DESC LIMIT 10;
Dotaz obsahuje spojení
Q14
VYBERTE a.Rok, c1/c2 Z ( vyberte Rok, COUNT()1000 jako c1 z ontime WHERE DepDelay>10 SKUPINA PODLE Rok) a VNITŘNÍ PŘIPOJENÍ ( vyberte Rok, COUNT(*) jako c2 z ontime SKUPINA PODLE Rok ) b na a.Rok=b.Rok OBJEDNAT PODLE a.Rok;
Q15
VYBERTE a."Rok", c1/c2 Z ( vyberte "Rok", COUNT()1000 jako c1 Z fontime WHERE "DepDelay">10 SKUPINA PODLE "Rok") a VNITŘNÍ PŘIPOJENÍ (vyberte "Rok", COUNT(*) jako c2 Z fontime SKUPINA PODLE "Rok" ) b na a."Rok"=b."Rok";
Tabulka-1: Dotazy použité v benchmarku
Provádění dotazů
Zde jsou výsledky každého dotazu při provádění v různých nastaveních databáze: PostgreSQL s indexy a bez nich, vlastní ClickHouse a clickhousedb_fdw. Čas je uváděn v milisekundách.
Q#
PostgreSQL
PostgreSQL (indexovaný)
ClickHouse
clickhousedb_fdw
Q1
27920
19634
23
57
Q2
35124
17301
50
80
Q3
34046
15618
67
115
Q4
31632
7667
25
37
Q5
47220
8976
27
60
Q6
58233
24368
55
153
Q7
30566
13256
52
91
Q8
38309
60511
112
179
Q9
20674
37979
31
81
Q10
34990
20102
56
148
Q11
30489
51658
37
155
Q12
39357
33742
186
1333
Q13
29912
30709
101
384
Q14
54126
39913
124
1364212
Q15
97258
30211
245
259
Tabulka-1: Čas potřebný k provedení dotazů použitých v benchmarku
Přehled výsledků
Graf ukazuje dobu provádění dotazu v milisekundách, osa X ukazuje číslo dotazu z výše uvedených tabulek a osa Y ukazuje dobu provádění v milisekundách. Výsledky ClickHouse a data získaná z postgres pomocí clickhousedb_fdw jsou zobrazeny. Z tabulky je vidět, že mezi PostgreSQL a ClickHouse existuje obrovský rozdíl, ale minimální rozdíl mezi ClickHouse a clickhousedb_fdw.
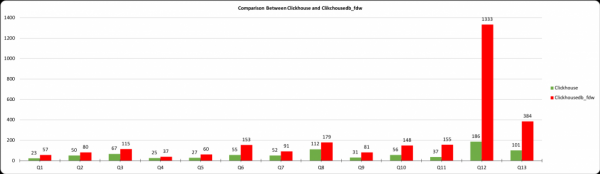
Tento graf ukazuje rozdíl mezi ClickhouseDB a clickhousedb_fdw. U většiny dotazů nejsou režijní náklady FDW tak velké a sotva významné, kromě Q12. Tento dotaz zahrnuje spojení a klauzuli ORDER BY. Kvůli klauzuli ORDER BY GROUP/BY a ORDER BY se nedochází k ClickHouse.
V tabulce 2 vidíme skok v čase u dotazů Q12 a Q13. Opakuji, to je způsobeno příkazem ORDER BY. Abych to potvrdil, vykonal jsem dotazy Q-14 a Q-15 s příkazem ORDER BY a bez něj. Bez příkazu ORDER BY je doba dokončení 259 ms, a s příkazem ORDER BY je to 1364212. Pro ladění tohoto dotazu vysvětluji oba dotazy, a zde jsou výsledky vysvětlení.
Q15: Bez příkazu ORDER BY
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2
     FROM (SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) AS c2 FROM fontime GROUP BY "Year") b ON a."Year"=b."Year";
Q15: Dotaz bez příkazu ORDER BY
PLÁN DOTAZU
Hash Join  (cost=2250.00..128516.06 rows=50000000 width=12)
Výstup: fontime."Year", (((count(*) * 1000)) / b.c2)
Inner Unique: true   Hash Cond: (fontime."Year" = b."Year")
->  Foreign Scan  (cost=1.00..-1.00 rows=100000 width=12)
Výstup: fontime."Year", ((count(*) * 1000))
Vztahy: Agregace na (fontime)
Remote SQL: SELECT "Year", (count(*) * 1000) FROM "default".ontime WHERE (("DepDelay" > 10)) GROUP BY "Year"
->  Hash  (cost=999.00..999.00 rows=100000 width=12)
Výstup: b.c2, b."Year"
->  Subquery Scan on b  (cost=1.00..999.00 rows=100000 width=12)
Výstup: b.c2, b."Year"
->  Foreign Scan  (cost=1.00..-1.00 rows=100000 width=12)
Výstup: fontime_1."Year", (count(*))
Vztahy: Agregace na (fontime)
Remote SQL: SELECT "Year", count(*) FROM "default".ontime GROUP BY "Year"(16 rows)
Q14: Dotaz s příkazem ORDER BY
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2 FROM(SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) as c2 FROM fontime GROUP BY "Year") b  ON a."Year"= b."Year"
     ORDER BY a."Year";
Q14: Plán dotazu s příkazem ORDER BY
PLÁN DOTAZU
Merge Join (cost=2.00..628498.02 rows=50000000 width=12)
Výstup: fontime."Year", (((count(*) * 1000)) / (count(*)))
Inner Unique: true   Merge Cond: (fontime."Year" = fontime_1."Year")
-> GroupAggregate (cost=1.00..499.01 rows=1 width=12)
Výstup: fontime."Year", (count(*) * 1000)
Skupinový klíč: fontime."Year"
-> Foreign Scan on public.fontime (cost=1.00..-1.00 rows=100000 width=4)
Remote SQL: SELECT "Year" FROM "default".ontime WHERE (("DepDelay" > 10))
            ORDER BY "Year" ASC
-> GroupAggregate (cost=1.00..499.01 rows=1 width=12)
Výstup: fontime_1."Year", count(*)       Skupinový klíč: fontime_1."Year"
-> Foreign Scan on public.fontime fontime_1 (cost=1.00..-1.00 rows=100000 width=4)

Remote SQL: SELECT "Year" FROM "default".ontime ORDER BY "Year" ASC(16 rows)
Výstup
Výsledky těchto experimentů ukazují, že ClickHouse nabízí skutečně dobrý výkon, zatímco clickhousedb_fdw přináší výhody výkonu ClickHouse z PostgreSQL. I když při používání clickhousedb_fdw existují určité režijní náklady, jsou nepatrné a srovnatelné s výkonem dosaženým při přímém spuštění v databázi ClickHouse. To také potvrzuje, že fdw v PostgreSQL poskytuje vynikající výsledky.
Telegramová skupina pro Clickhouse
Telegramová skupina pro PostgreSQL
Zdroj: habr.com
