

Překlad článku byl připraven speciálně pro studenty kurzu .
– softwarový vývojář, fanoušek Go a milovník řešení složitých problémů. Je také správcem Prometheus a spoluzakladatelem Kubernetes SIG instrumentation. Dříve byl produkčním inženýrem ve společnosti SoundCloud a vedl monitoring tým v CoreOS. V současné době pracuje v Googlu.
– infrastrukturální inženýr ve společnosti Improbable. Zajímá se o nové technologie a problémy distribuovaných systémů. Má zkušenosti s nízkoúrovňovým programováním ve společnosti Intel, zkušenosti jako přispěvatel v Mesos a globální produkční zkušenosti SRE ve společnosti Improbable. Pracuje na zlepšení světa mikroslužeb. Tři jeho vášně: Golang, open source a volejbal.
S ohledem na náš vlajkový produkt SpatialOS si můžete domyslet, že pro společnost Improbable je potřeba vysoce výkonná cloudová infrastruktura globálního měřítka s desítkami Kubernetes clusterů. Byli jsme jedni z prvních, kdo začal používat monitorovací systém . Prometheus dokáže sledovat miliony metrik v reálném čase a dodává se s výkonným dotazovacím jazykem, který umožňuje extrakci potřebných informací.
Jednoduchost a spolehlivost Prometheus je jednou z jeho hlavních výhod. Nicméně při určitém měřítku jsme se setkali s několika nedostatky. Pro řešení těchto problémů jsme vyvinuli – projekt s otevřeným zdrojovým kódem, vytvořený společností Improbable, pro bezproblémovou transformaci existujících clusterů Prometheus na jednotný monitorovací systém s neomezeným úložištěm historických dat. Thanos je dostupný na Githubu. .
Naše cíle s Thanosem
Při určitém měřítku vznikají problémy, které překračují možnosti vanilkového Prometheusu. Jak spolehlivě a ekonomicky ukládat petabajty historických dat? Je možné to udělat bez zhoršení doby odezvy na dotazy? Lze přistupovat ke všem metrikám rozloženým na různých serverech Prometheus pomocí jednoho API dotazu? Lze nějakým způsobem sloučit replikovaná data shromážděná pomocí Prometheus HA?
Pro řešení těchto otázek jsme vytvořili Thanos. V následujících oddílech popisujeme, jak jsme přistoupili k řešení těchto problémů a vysvětlujeme cíle, které jsme sledovali.
Dotazování dat z více instancí Prometheus (globální dotaz)
Prometheus nabízí funkční přístup k shardingu. I jeden server Prometheus poskytuje dostatečnou škálovatelnost, aby uvolnil uživatele od složitostí horizontálního shardingu téměř ve všech scénářích použití.
I když je to skvělý model nasazení, často je třeba získat přístup k datům na různých serverech Prometheus prostřednictvím jednotného API nebo UI — global view. Samozřejmě je možné zobrazit několik dotazů na jednom panelu Grafana, ale každý dotaz může být proveden pouze na jednom serveru Prometheus. Na druhou stranu, pomocí Thanos můžete dotazovat a agregovat data z několika serverů Prometheus, protože všechny jsou k dispozici z jednoho koncového bodu.
Dříve jsme pro získání global view v Improbable zorganizovali naše instance Prometheus do vícestupňové . To znamenalo vytvoření jedné meta-serveru Prometheus, který shromažďoval část metrik z každého "listového" serveru.
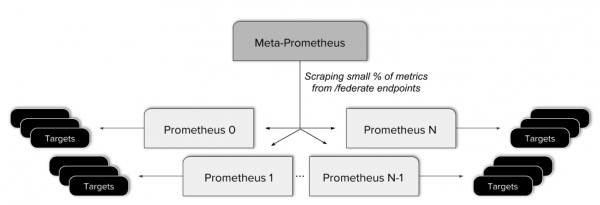
Tento přístup se ukázal jako problematický. Vedl k složitější konfiguraci, přidání další potenciálního bodu selhání a použití složitých pravidel pro poskytování federované koncovému bodu pouze potřebná data. Kromě toho taková federace neumožňuje získat skutečné global view, protože všechna data nejsou dostupná z jednoho API dotazu.
S tím úzce souvisí jednotné zobrazení dat shromážděných na vysoce dostupných (high-availability, HA) serverech Prometheus. HA model Prometheus sbírá data nezávisle dvakrát, což je tak jednoduché, že snazší to být nemůže. Přesto by bylo mnohem pohodlnější používat sloučené a deduplifikované zobrazení obou toků.
Samozřejmě je v serverech Prometheus s vysokou dostupností potřeba. V Improbable se opravdu vážně věnujeme minutovému monitorování dat, ale mít jeden instance Prometheus v clusteru je jediný bod selhání. Jakákoliv chybová konfigurace nebo selhání hardwaru mohou potenciálně vést ke ztrátě důležitých dat. I jednoduché nasazení může vést k drobným výpadkům při shromažďování metrik, protože restart může být výrazně delší než interval sběru.
Spolehlivé uchovávání historických dat
Levné, rychlé a dlouhodobé úložiště metrik je naším snem (sdíleným většinou uživatelů Prometheus). V Improbable jsme byli nuceni nastavit dobu uchovávání metrik na devět dní (pro Prometheus 1.8). To přináší zjevná omezení v tom, jak daleko můžeme pohlédnout zpět.
Prometheus 2.0 se v tomto ohledu zlepšil, protože počet časových řad již nemá vliv na celkový výkon serveru (viz ). Přesto Prometheus uchovává data na místním disku. Ačkoli vysoce účinné zpracování dat může významně snížit využití místního SSD, stále existuje omezení na objem uchovávaných historických dat.
Kromě toho nám v Improbable záleží na spolehlivosti, jednoduchosti a nákladech. Velké místní disky jsou složitější na údržbu a zálohování. Jsou dražší a vyžadují více nástrojů pro zálohování, což vede k nadměrné složitosti.
Snížení vzorkování
Jakmile jsme začali pracovat s historickými daty, uvědomili jsme si, že existují základní komplikace s O-velkým, které dělají dotazy stále pomalejšími, pokud pracujeme s daty za týdny, měsíce a roky.
Standardním řešením tohoto problému bude (downsampling) — snížení frekvence vzorkování signálu. Pomocí snížení vzorkování můžeme "přeškálovat" na delší časové období a udržet původní počet vzorků, což umožní zachovat rychlost dotazů.
Snížení vzorkování starých dat je nevyhnutelnou součástí jakéhokoli řešení pro dlouhodobé uchovávání a přesahuje možnosti vanilkového Prometheus.
Další cíle
Jedním z prvotních cílů projektu Thanos byla bezproblémová integrace s jakoukoli existující instalací Prometheus. Druhým cílem byla snadná údržba s minimálními vstupními překážkami. Jakékoli závislosti by měly být snadno splnitelné jak pro malé, tak pro velké uživatele, což také znamená nízké základní náklady.
Architektura Thanos
Poté, co jsme v předchozím oddíle uvedli naše cíle, pojďme se s nimi vypořádat a podívat se, jak Thanos řeší tyto problémy.
Globální pohled
Abychom získali global view nad existujícími instancemi Prometheu, musíme spojit jednotný vstupní bod dotazů se všemi servery. To je úkol komponenty Thanos. . Nasazuje se vedle každého serveru Promethea a funguje jako proxy, obsluhující místní data Promethea prostřednictvím gRPC rozhraní Store API, které umožňuje vybírat časové řady podle značek a časového rozmezí.
Na druhé straně se nachází horizontálně škálovatelná komponenta Querier bez udržování stavu, která dělá trochu více než jen odpovídá na dotazy PromQL prostřednictvím standardního HTTP API Promethea. Komponenten Querier, Sidecar a další Thanos komunikují prostřednictvím .
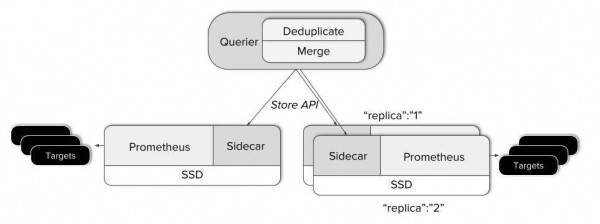
- Querier při příjmu dotazu připojuje k příslušnému serveru Store API, tedy k našim Sidecarům, a získává časové řady z příslušných serverů Promethea.
- Poté spojuje odpovědi a provádí na nich dotaz PromQL. Querier může kombinovat jak nepřekrývající se data, tak duplikovaná data z HA serverů Promethea.
To řeší většinu naší hádanky — spojení dat z izolovaných serverů Promethea do jednoho pohledu. Vlastně lze Thanos použít pouze kvůli této funkčnosti. Do existujících serverů Promethea není třeba provádět žádné změny!
Neomezená doba uchovávání!
Avšak dříve či později budeme chtít uchovat data, která překračují běžnou dobu uchovávání Promethea. Pro uchovávání historických dat jsme zvolili objektové úložiště. Je široce dostupné v jakémkoli cloudu, stejně jako v místních datových centrech, a je velmi ekonomické. Navíc je prakticky jakékoli objektové úložiště dostupné přes dobře známé S3 API.
Prometheus zapisuje data z operační paměti na disk přibližně každé dvě hodiny. Blok ukládaných dat obsahuje všechna data pro pevné časové období a je neměnný. To je velmi pohodlné, protože Thanos Sidecar může jednoduše sledovat adresář dat Promethea a jakmile se objeví nové bloky, nahrát je do kbelíků objektového úložiště.
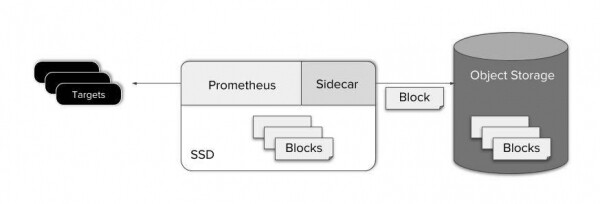
Nahrávání do objektového úložiště hned po zápisu na disk také umožňuje udržet jednoduchost „scraperu“ (Prometheus a Thanos Sidecar). To usnadňuje údržbu, náklady a design systému.
Jak vidíte, zálohování dat se provádí velmi jednoduše. Ale co dotazy na data v objektovém úložišti?
Komponenta Thanos Store působí jako proxy pro načítání dat z objektového úložiště. Stejně jako Thanos Sidecar se účastní gossip clusteru a implementuje Store API. Existující Querier je tak může vnímat jako Sidecar, jako další zdroj časových řad dat — žádné speciální nastavení není potřeba.
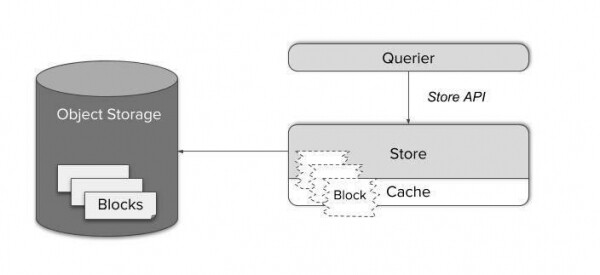
Bloky časových řad dat se skládají z několika velkých souborů. Načítání na vyžádání by bylo poměrně neefektivní a místní cache by vyžadovala obrovské množství paměti a úložného prostoru.
Store Gateway místo toho ví, jak pracovat s formátem úložiště Prometheus. Díky inteligentnímu plánovači dotazů a ukládání pouze potřebných indexových částí bloků se podařilo zjednodušit složité dotazy na minimální počet HTTP požadavků na soubory objektového úložiště. Tím se lze dostat k počtu dotazů sníženému o čtyři až šest řádů a dosáhnout doby odezvy, která se celkově těžko odlišuje od dotazů na data na místním SSD.
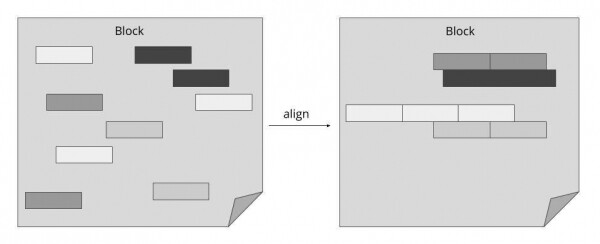
Jak ukazuje výše uvedený diagram, Thanos Querier významně snižuje náklady na jeden dotaz na data v objektovém úložišti, používající formát úložiště Prometheus a umisťující související data blízko sebe. S tímto přístupem můžeme sloučit množství jednotlivých dotazů do minimálního počtu hromadných operací.
Kompakce a downsampling
Jakmile je nový blok časových řad dat úspěšně nahrán do objektového úložiště, považujeme ho za „historická“ data, která jsou ihned k dispozici prostřednictvím Store Gateway.
Po nějaké době se bloky z jednoho zdroje (Prometheus se Sidecar) hromadí a již nevyužívají celý potenciál indexace. Pro vyřešení tohoto problému jsme zavedli další komponentu nazvanou Compactor. Ta jednoduše aplikuje místní mechanismus kompakce Prometheus na historická data v objektovém úložišti a může být spuštěna jako jednoduchý periodický dávkový úkol.
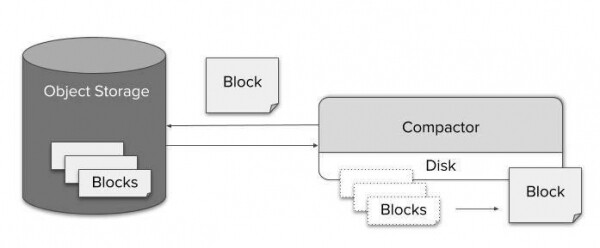
Díky efektivnímu kompresi není pro dlouhodobý požadavek na úložiště problémem velikost dat. Potenciální náklady na dekomprese miliardy hodnot a jejich zpracování prostřednictvím dotazového zpracovatele však nevyhnutelně povedou k dramatickému zvýšení doby provádění dotazů. Na druhou stranu, protože na každý pixel obrazovky připadá stovky datových bodů, stává se vizualizace dat v plném rozlišení nemožnou. Downsampling je tedy nejen možný, ale také nezpůsobí významnou ztrátu přesnosti.
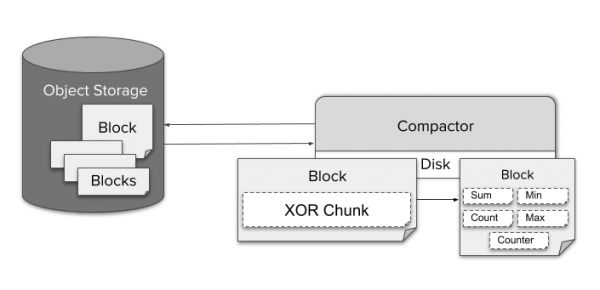
Pro downsampling dat Compactor nepřetržitě agreguje data s rozlišením pět minut a jedna hodina. Pro každý nezpracovaný fragment, který je kódován pomocí TSDB XOR komprese, jsou ukládány různé typy agregovaných dat, jako např. min, max nebo sum pro jeden blok. To umožňuje Querieru automaticky vybrat agregát, který je vhodný pro daný PromQL dotaz.
K používání dat s nižší přesností uživatel nemusí mít žádnou speciální konfiguraci. Querier se automaticky přepíná mezi různými rozlišeními a nezpracovanými daty, když uživatel zvětšuje a zmenšuje měřítko. Pokud si to uživatel přeje, může to řídit přímo pomocí parametru “step” ve dotazu.
Protože náklady na uložené 1 GB jsou malé, Thanos ve výchozím nastavení uchovává původní data, data s rozlišením pět minut a jednu hodinu. Není potřeba mazat původní data.
Recording rules
I s Thanos jsou recording rules důležitou součástí monitorovacího stacku. Snižují složitost, latenci a náklady na dotazy. Jsou také užitečné pro uživatele, kteří potřebují agregovaná data o metrikách. Thanos je založen na vanilkových instancích Promethea, a proto je zcela přípustné uchovávat recording rules a alerting rules na stávajícím serveru Promethea. Nicméně v některých případech to může být nedostatečné:
- Globální alert a rule (např. upozornění, když služba nefunguje na více než dvou ze tří clusterů).
- Rule pro data mimo místní úložiště.
- Tendence uchovávat všechny rule a alert na jednom místě.
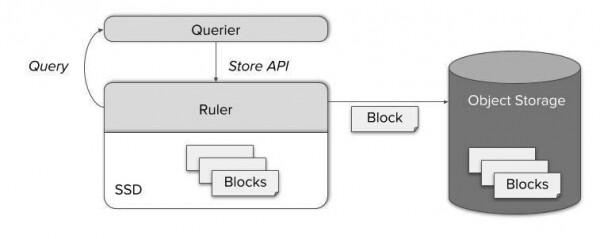
Pro tyto případy Thanos obsahuje samostatnou komponentu zvanou Ruler, která vypočítává pravidla a upozornění prostřednictvím dotazů na Thanos. Poskytováním dobře známého StoreAPI může Query uzel přistupovat k čerstvě vypočítaným metrikám. Později se také ukládají do objektového úložiště a stávají se dostupnými prostřednictvím Store Gateway.
Síla Thanose
Thanos je dost flexibilní, aby jej bylo možné přizpůsobit vašim požadavkům. To je zvlášť užitečné při migraci z jednoduchého Promethea. Pojďme si na malém příkladu rychle připomenout, co jsme se o komponentech Thanose naučili. Zde je, jak přenést váš základní Prometheus do světa 'neomezeného ukládání metrik':
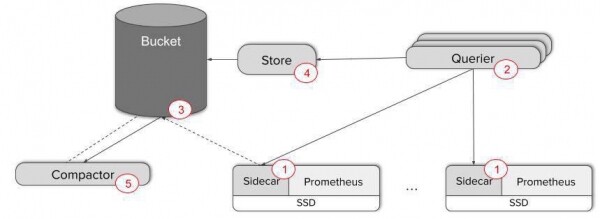
- Přidejte Thanos Sidecar k vašim serverům Prometheus – například jako sousední kontejner v Kubernetes podu.
- Nasazujte několik replik Thanos Querier pro možnost prohlížení dat. V této fázi je snadné nastavit gossip mezi Scraperem a Querierem. Pro ověření interakce komponent použijte metriky 'thanos_cluster_members'.
Pouze tyto dva kroky jsou dostatečné k zajištění globálního pohledu a bezproblémové deduplikace dat z potenciálních HA replik Promethea! Jednoduše připojte své dashboardy k HTTP end-pointu Querieru nebo použijte rozhraní Thanos UI přímo.
Pokud však potřebujete zálohování metrik a dlouhodobé uložení, bude potřeba provést ještě tři kroky:
- Vytvořte AWS S3 nebo GCS bucket. Nakonfigurujte sidecar pro kopírování dat do těchto bucketů. Nyní je možné minimalizovat lokální ukládání dat.
- Nasazujte Store Gateway a připojte jej k existujícímu gossip klastru. Nyní je možné posílat dotazy na data v zálohování!
- Nasazujte Compactor, abyste zvýšili efektivitu dotazů pro delší časové intervaly pomocí komprese a downsamplingu.
Pokud se chcete dozvědět více, neváhejte se podívat na naše a !
Celkem za pět kroků jsme proměnili Prometheus v spolehlivý monitorovací systém s globálním pohledem, neomezeným časem ukládání a potenciální vysokou dostupností metrik.
Pull request: potřebujeme vás!
od samého začátku byl projektem s otevřeným zdrojovým kódem. Bezproblémová integrace s Prometheem a možnost používat pouze část Thanose z něj činí skvělou volbu pro škálování monitorovacího systému bez zbytečné námahy.
Vždy nás potěší GitHub Pull Request a Issues. Zároveň se na nás klidně obraťte přes Github Issues nebo slack., pokud máte otázky nebo názory, nebo se chcete podělit o své zkušenosti! Pokud se vám líbí to, co děláme v Improbable, neváhejte nás kontaktovat — !
Zdroj: habr.com
