

Doporučuji se seznámit s přepisem zprávy z počátku roku 2016 od Andreje Salnikova "Typické chyby v aplikacích, které vedou k bloat v PostgreSQL"
V této zprávě se podívám na hlavní chyby v aplikacích, které vznikají ve fázi návrhu a psaní kódu aplikace. A zaměřím se pouze na ty chyby, které vedou k bloat v PostgreSQL. Obvykle je to začátek konce výkonu vašeho systému jako celku, přičemž zpočátku nebyly vidět žádné předpoklady pro to.
Rád vás všechny zdravím! Tato zpráva není tak technická jako předchozí od mého kolegy. Tato zpráva je určena především pro vývojáře backendových systémů, protože máme poměrně velké množství klientů. A všichni dělají stejné chyby. O těchto chybách vám povím. Vysvětlím, k čemu fatálnímu a špatnému vedou tyto chyby.
Proč se chyby dělají? Dělají se ze dvou důvodů: na náhodu, možná to vyjde, a z neznalosti některých mechanismů, které se dějí na úrovni mezi databází a aplikací, a také v samotné databázi.
Přivedu vám tři příklady s hroznými obrázky toho, jak vše dopadlo špatně. Stručně popíšu mechanismus, který tam probíhá. A jak s nimi bojovat, když se již staly, a jaké preventivní metody použít k prevenci chyb. Povědím o pomocných nástrojích a poskytnu užitečné odkazy.
Použil jsem testovací databázi, kde jsem měl dvě tabulky. Jedna tabulka se zahrnutými účty klientů, druhá s operacemi na těchto účtech. A s určitou periodicností aktualizujeme zůstatky na těchto účtech.
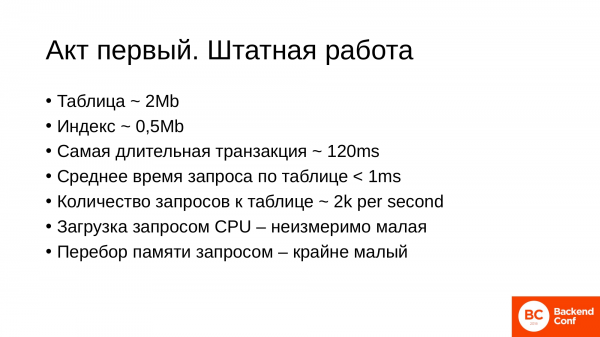
Výchozí data tabulky: je dost malá, 2 MB. Doba odezvy na databázi a konkrétně na tabulku je také velmi dobrá. A také dost dobré zatížení – 2000 operací za sekundu na tabulce.
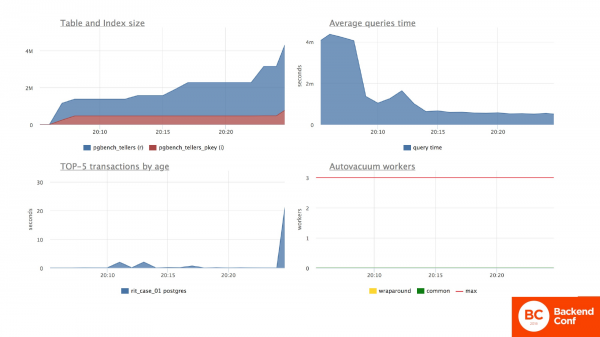
A skrze tuto zprávu vám budu ukazovat grafy, aby bylo jasné, co se děje. Vždy budou 2 snímky s grafy. První snímek – to, co se děje obecně na serveru.
A v této situaci vidíme, že skutečně máme tabulku malé velikosti. Index je malý, 2 MB. To je první graf zleva.
Průměrná doba odezvy na serveru je také stabilní, malá. To je pravý horní graf.
Levý dolní graf ukazuje nejdelší transakce. Vidíme, že transakce jsou prováděny rychle. A automatický úklid zatím nefunguje, protože – to byl startovní test. Dále bude fungovat a bude nám užitečný.
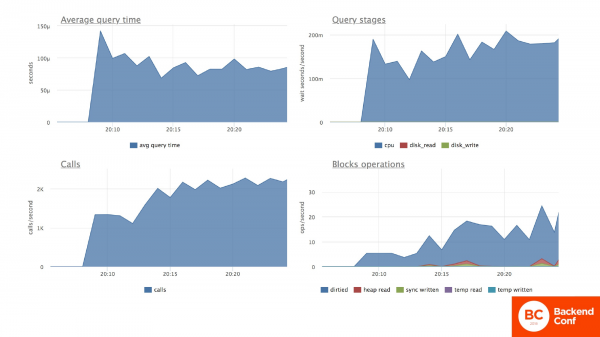
Druhý snímek bude vždy zaměřen na testovací tabulku. V této situaci neustále aktualizujeme zůstatky na účtech klienta. A vidíme, že průměrná doba odezvy při aktualizaci je velmi dobrá, méně než milisekundu. Vidíme, že také procesorové zdroje (to je pravý horní graf) jsou spotřebovávány rovnoměrně a v dostatečně malých hodnotách.
Pravý dolní graf ukazuje, kolik operační a diskové paměti procházíme při hledání našeho požadovaného řádku, než ho aktualizujeme. A počet operací na tabulce je 2000 za sekundu, jak jsem říkal na začátku.
A teď se stává tragédie. Z nějakého důvodu vzniká dlouhá zapomenutá transakce. Příčiny jsou většinou banální:
- Jednou z nejběžnějších je to, že jsme v kódu aplikace začali volat externí službu. A tato služba nám neodpovídá. Tedy jsme otevřeli transakci, provedli změnu v databázi a šli si v aplikaci číst e-maily nebo k jiné službě v rámci naší infrastruktury, a ta nám nějakým způsobem neodpovídá. A máme visící relaci v stavu – nevíme, kdy se to vyřeší.
- Druhá situace, kdy v našem kódu z nějakého důvodu došlo k výjimce. A my jsme ve výjimce neprovedli uzavření transakce. A máme visící relaci s otevřenou transakcí.
- A poslední – to je také docela častý případ. To je nekvalitní kód. Některé frameworky otevírají transakci. Ta visí a v aplikaci nemusíte vědět, že vám visí.
Kam tohle vede?
K tomu, že se nám začnou rapidně zvětšovat tabulky a indexy. To je právě ono bloat efekt. Pro databázi to bude znamenat, že nám rychle vzroste doba odezvy databáze, zvýší se zátěž na databázový server. A jako výsledek bude trpět aplikace. Protože pokud jste v kódu trávili 10 milisekund na dotaz do databáze, 10 milisekund na svou logiku, tak vaše funkce pracovala 20 milisekund. A teď bude situace mnohem smutnější.
A pojďme se podívat, co se děje. Levý dolní graf ukazuje, že máme dlouhou transakci. A když se podíváme na levý horní graf, vidíme, že velikost tabulky z dvou megabajtů vystřelila na 300 megabajtů. Přitom počet dat v tabulce se nezměnil, tj. je tam dostatečné množství nepotřebných dat.
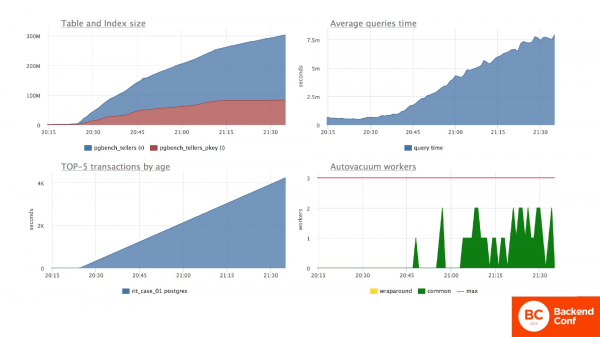
Celková situace ohledně průměrné doby odezvy serveru se také změnila o několik řádů. To znamená, že všechny požadavky na server začaly výrazně zpomalovat. A zároveň se spustily interní procesy Postgres ve formě autovacuum, které se snaží něco dělat a spotřebovávají zdroje.
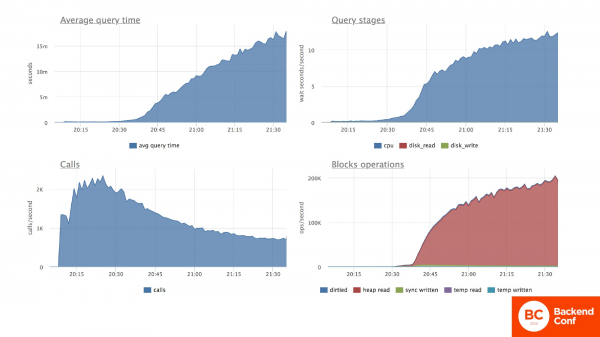
Co se děje s naší tabulkou? To samé. Průměrná doba odezvy tabulky nám vzrostla o několik řádů. Pokud konkrétně zhodnotíme spotřebované zdroje, vidíme, že se výrazně zvýšila zátěž na procesor. To je pravý horní graf. A zvýšila se proto, že procesoru se musí projít spoustou nepotřebných řádků při hledání jednoho potřebného. To je pravý dolní graf. A jako výsledek – počet volání za sekundu začal výrazně klesat, protože databáze nestíhá zpracovávat stejné množství požadavků.
Musíme se vrátit k životu. Pustíme se na internet a zjistíme, že dlouhé transakce způsobují problém. Najdeme a zrušíme tuto transakci. A vše se zase vrátí do normálu. Všechno funguje, jak má.
Zklidnili jsme se, ale po nějaké době začínáme vnímat, že aplikace nefunguje tak, jak před havárií. Požadavky jsou stále pomalejší, a to výrazně pomalejší. V mém konkrétním případě je to o 50-100 % pomalejší. Zátěž na serveru je také vyšší než před havárií.
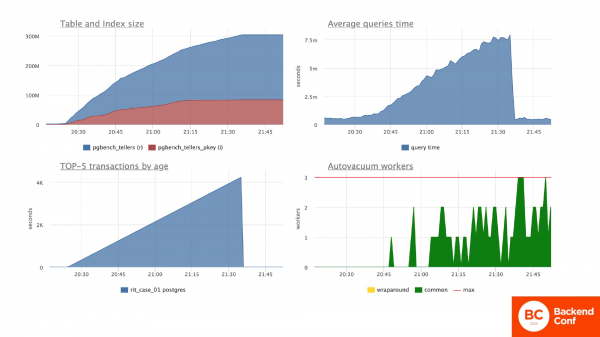
A otázka: „Co se s databází v tu chvíli děje?“. A v databázi se děje následující situace. Na grafu transakcí vidíte, že se zastavila a opravdu tam nejsou dlouhé transakce. Ale velikosti tabulky během havárie fatálně vzrostly. A od té doby se nezmenšily. Průměrná doba v databázi se stabilizovala. A odpovědi se zdají být adekvátní s přijatelnou rychlostí pro nás. Autovacuum se stalo aktivnějším a začalo s tabulkou něco dělat, protože musí zpracovat větší množství dat.
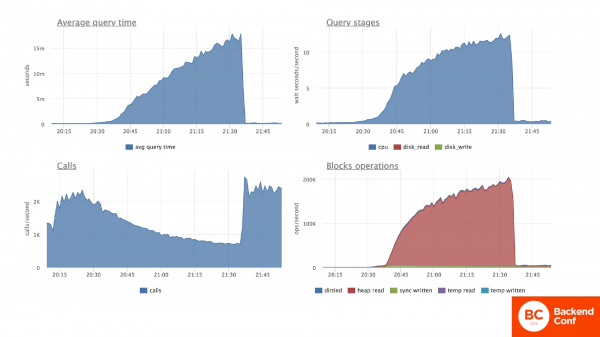
Konkrétně k testované tabulce s účty, kde měníme zůstatky: doba odezvy na dotaz se zdá, že se vrátila do normálu. Ve skutečnosti je však 1,5krát vyšší.
A co se zatížení CPU týče, vidíme, že zatížení procesoru se nevrátilo na požadovanou úroveň před havárií. Příčiny lze nalézt v pravém dolním grafu. Je zřejmé, že tam dochází k procházení určitého množství paměti. To znamená, že při hledání požadovaného řádku utrácíme zdroje serveru databáze při procházení nepotřebnými daty. Počet transakcí za sekundu se stabilizoval.
Celkově je to dobré, ale situace je horší než byla. Zřejmá degradace databáze jako důsledek naší aplikace, která s touto databází pracuje.
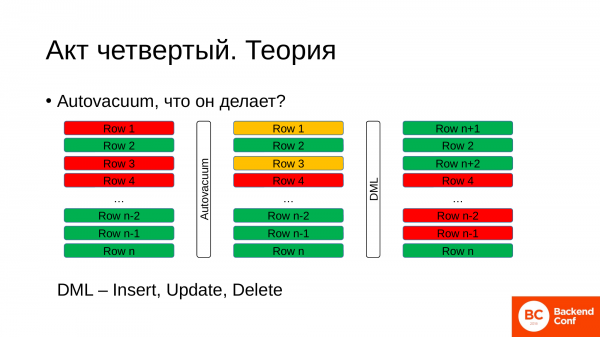
A abychom pochopili, co se tam děje, pokud jste nebyli na předchozí přednášce, teď trošku teorie. Teorie o interním procesu. Proč je potřeba autovakuum a co dělá?
Doslova stručně pro porozumění. V určitém okamžiku máme tabulku. V tabulce máme řádky. Tyto řádky mohou být aktivní, živé, potřebné nám teď. Na obrázku jsou označeny zelenou barvou. A jsou tu mrtvé řádky, které už byly zpracovány, byly aktualizovány, objevily se na nich nové záznamy. A jsou označeny, že už nejsou zajímavé pro databázi. Ale zůstávají v tabulce kvůli zvláštnosti Postgresu.
Proč potřebujeme autovakuum? Autovakuum v určitém okamžiku přichází, obrací se na databázi a ptá se: „Dej mi, prosím, id nejstarší transakce, která je v tuto chvíli otevřená v databázi.“ Databáze vrací toto id. A autovakuum, opíraje se o něj, prochází řádky v tabulce. A pokud vidí, že některé řádky byly změněny mnohem staršími transakcemi, má právo je označit jako řádky, které můžeme v budoucnu znovu použít, zapisující tam nová data. To je pozadí procesu.
My v té době pokračujeme v práci s databází, nadále provádíme nějaké změny v tabulce. A na tyto řádky, které můžeme znovu použít, zapisujeme nová data. Takto máme cyklus, to znamená, že se tam neustále objevují nějaké mrtvé staré řádky, místo nich zapisujeme nové řádky, které potřebujeme. A to je normální stav pro práci s PostgreSQL.
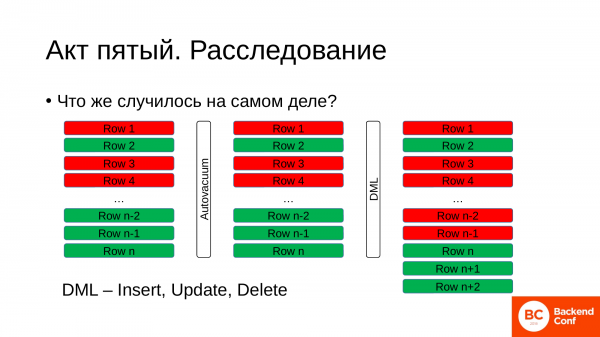
Co se stalo během havárie? Jak tento proces probíhal?
Měli jsme tabulku v určitém stavu, některé řádky byly živé, některé mrtvé. Přišel autovakua. Zeptal se databáze, jaká je naše nejstarší transakce a jaké má ID. Získal toto ID, které může být několik hodin staré, nebo může být deset minut staré. Záleží to na tom, jak silné je zatížení vaší databáze. A začal hledat řádky, které může označit jako znovupoužitelné. A takové řádky v naší tabulce nenašel.
Ale v tu dobu stále pracujeme s tabulkou. Něco v ní děláme, aktualizujeme, měníme data. A co má databáze v tu dobu dělat? Nemá na výběr, než zapisovat nové řádky na konec existující tabulky. Tím se začíná zvyšovat velikost tabulky.
Ve skutečnosti potřebujeme pro práci zelené řádky. Ale během takového problému máme často velmi nízké procento zelených řádků v celém objemu tabulky.
A když vykonáváme dotaz, databáze musí projít všemi řádky: jak červenými, tak zelenými, aby našla potřebný řádek. A efekt zvětšení tabulky zbytečnými daty se nazývá „bloat“, což nám také žere naše diskové místo. Pamatujete, bylo to 2 MB, nyní je to 300 MB? A teď si vyměňte megabyty za gigabyty a rychle přijdete o všechny zásoby svých diskových zdrojů.
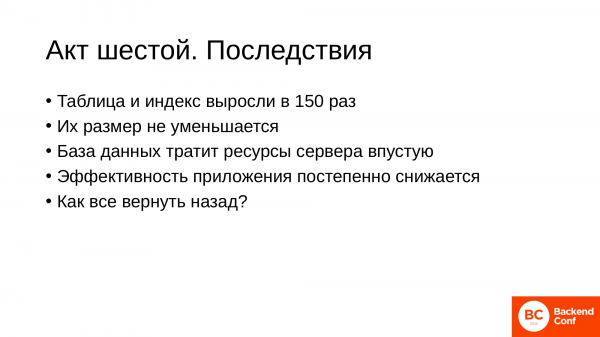
Jaké mohou být důsledky pro nás?
- V mém příkladu tabulka a index vzrostly 150krát. Někteří naši klienti měli horší případy, kdy začalo docházet místo na disku.
- Velikost tabulek se sama o sobě nikdy nezmenší. Autovakua může v některých případech odříznout konec tabulky, pokud tam jsou pouze mrtvé řádky. Ale protože dochází k neustálé rotaci, jeden zelený řádek může na konci zůstat viset a neaktualizovat se, zatímco všechny ostatní budou kdesi na začátku tabulky zapsány. Ale to je tak nepravděpodobné, že by se tabulka sama od sebe zmenšila, na to se nedá spoléhat.
- Databáze musí procházet celou hromadou zbytečných řádků. A my plýtváme diskovými zdroji, plýtváme procesorovými zdroji a energií.
- A to přímo ovlivňuje naši aplikaci, protože pokud na začátku jsme trávili 10 milisekund na požadavek a 10 milisekund na náš kód, během havárie jsme začali trávit sekundu na požadavek a 10 milisekund na kód, tedy výkon aplikace klesl o řád. A když byla havárie odstraněna, začali jsme trávit 20 milisekund na požadavek a 10 milisekund na kód. To znamená, že jsme stejně klesli na 1,5krát nižší výkon. A to vše kvůli jedné transakci, která se zasekla, pravděpodobně vinou nás.
- A otázka zní: "Jak vše vrátit zpět?" Abychom dosáhli toho, že požadavky budou znovu běhat stejně rychle, jako před havárií.
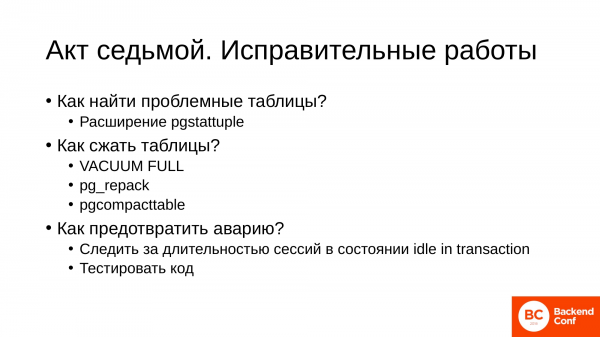
K tomu existuje určitý pracovní cyklus, který se provádí.
Nejprve musíme najít problematické tabulky, které se nafoukly. Chápeme, že u některých tabulek se zápis provádí aktivněji, u jiných méně aktivně. A k tomu se používá rozšíření . Po nainstalování tohoto rozšíření můžete napsat dotazy, které vám pomohou najít tabulky, které se dostatečně nafoukly.
Poté, co jste tyto tabulky našli, je nutné je zkomprimovat. K tomu již existují nástroje. V naší společnosti používáme tři nástroje. První je vestavěný VACUUM FULL. Je přísný, tvrdý a bezohledný, ale někdy je velmi užitečný. a – to jsou externí utilitky pro kompresi tabulek. A ty se k databázi mají bližší přístup.
Používají se podle toho, co je pro vás pohodlnější. Ale o tom budu mluvit až na závěr. Hlavní je, že existují tři nástroje. Je z čeho vybírat.
Poté, co jsme všechno napravili a ujistili se, že je vše v pořádku, musíme vědět, jak tomuto problému v budoucnu předejít:
- Prevence je dost snadná. Je třeba sledovat délku relací na Master serveru. Zvláště nebezpečné jsou relace ve stavu idle in transaction. To jsou ty, které právě otevřely transakci, něco udělaly a odešly, nebo se pouze zasekly, ztratily se v kódu.
- A pro vás, jako pro vývojáře, je důležité testovat kód při vzniku těchto situací. Není to složité udělat. Bude to užitečná kontrola. Vyhnete se velkému množství "dětských" problémů spojených s dlouhými transakcemi.
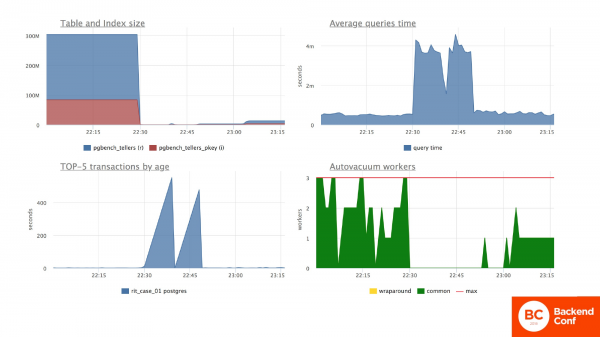
Na těchto grafech jsem vám chtěl ukázat, jak se změnila tabulka a chování databáze poté, co jsem provedl v tomto případě VACUUM FULL na tabulce. To není v produkci.
Velikost tabulky se okamžitě vrátila do normálního pracovního stavu na pár megabajtů. Na průměrnou dobu odezvy serveru to nemělo výrazný vliv.
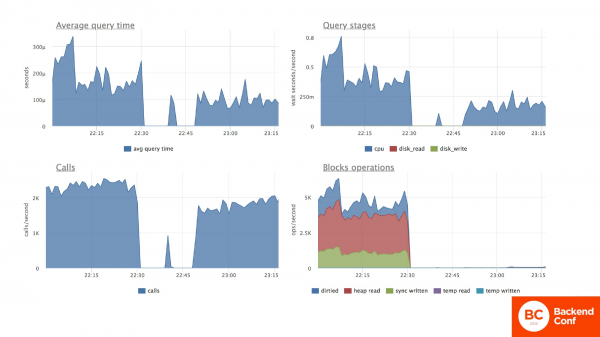
Ale konkrétně u naší zkoušené tabulky, kde jsme aktualizovali zůstatky na účtech, vidíme, že průměrná doba odezvy na dotaz na aktualizaci dat v tabulce se snížila na úroveň před havárií. Také zdroje využívané procesorem pro provádění tohoto dotazu klesly na úroveň před havárií. A pravý dolní graf ukazuje, že nyní nalezneme přesně ten řádek, který potřebujeme hned, aniž bychom museli procházet hromadu mrtvých řádků, které byly před kompresí tabulky. A průměrná doba dotazů zůstala přibližně na stejné úrovni. Ale tady mám spíše chybu mého hardwaru.
Na tom první příběh končí. Je to ten nejběžnější. A stává se to každému, bez ohledu na zkušenosti klienta, kolik kvalifikovaných programátorů tam je. Dříve nebo později se to stane.
Druhý příběh, ve kterém rozdělujeme zátěž a optimalizujeme serverové zdroje
- Už jsme vyrostli a stali se vážnými hráči. A chápeme, že máme repliku a bylo by dobré vyvážit zátěž: zapisovat na Master a číst z repliky. A tato situace obvykle nastává, když chceme připravit nějaké zprávy nebo ETL. A podnik tomu velmi ráda. Velmi chce různorodé zprávy s hromadou složité analýzy.
- Zprávy jsou hodinové, protože složitou analýzu nelze spočítat za milisekundy. My, jako odvážní kluci, píšeme kód. Děláme v aplikaci vkládání, že zápis provádíme na Master, zprávy realizujeme na replikaci.
- Rozdělujeme zátěž.
- Všechno funguje skvěle. Jsme šikovní.
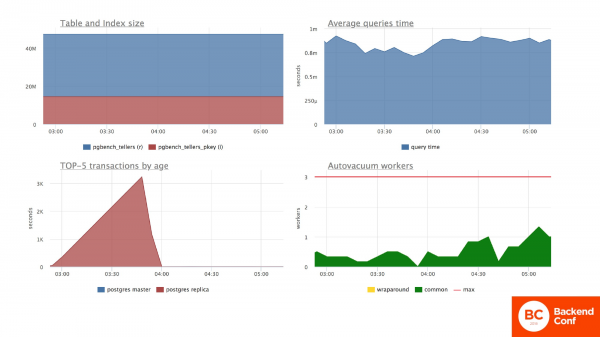
A jak vypadá tato situace? Konkrétně na těchto grafech jsem také přidal dobu transakcí z repliky. Všechny ostatní grafy se vztahují pouze k Master serveru.
Tabulka s reporty mi nyní vzrostla. Jejich počet se zvýšil. Vidíme, že průměrná doba odezvy serveru je stabilní. Vidíme, že na replikaci máme dlouhou transakci, která trvá 2 hodiny. Pozorujeme klidnou práci autovacua, které zpracovává mrtvé řádky. A všechno je u nás v pořádku.
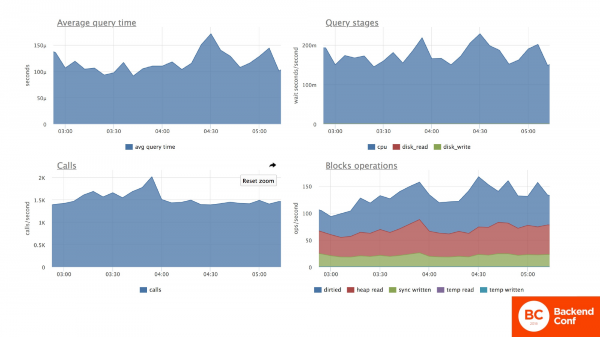
Konkrétně k testované tabulce nadále aktualizujeme zůstatky na účtech. A máme také stabilní dobu odezvy na dotazy, stabilní spotřebu zdrojů. Všechno je u nás v pořádku.
Všechno je v pořádku, dokud se tyto reporty nezačnou objevovat z důvodu konfliktu s replikací. A objevují se s konstantní periodicitou.
Jdeme na internet a začínáme číst, proč se to děje. A nacházíme řešení.
První řešení – zvýšit zpoždění replikace. Víme, že náš report funguje 3 hodiny. Nasadíme zpoždění replikace – 3 hodiny. Spustíme všechno, ale přesto se stále objevují problémy s tím, že se reporty občas objevují.
Chceme, aby bylo vše dokonalé. Jdeme dál. A na internetu nacházíme skvělou konfiguraci – hot_standby_feedback. Zapneme ji. Hot_standby_feedback nám umožňuje zadržet práci autovacua na Masteru. Tím se zcela zbavujeme konfliktů replikace. A vše nám funguje dobře s reporty.
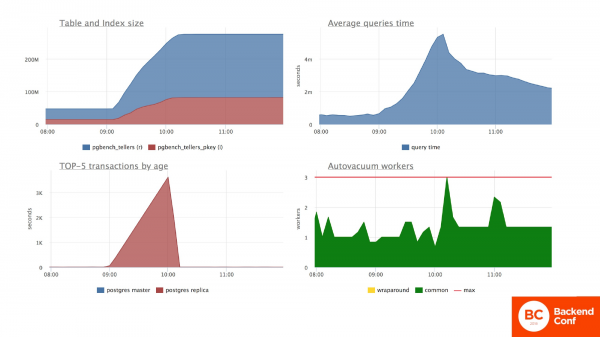
Ale co se v této době děje s Master serverem? S Master serverem se děje totální katastrofa. Nyní sledujeme grafy, když jsem zapnul obě tyto nastavení. A vidíme, že sezení na replikaci nějakým způsobem začalo ovlivňovat situaci na Master serveru. Opravu ovlivňuje, protože zastavilo autovacuum, které čistí mrtvé řádky. Velikost tabulky opět vzrostla do nebes. Průměrná doba provádění dotazů na celé databázi také vzrostla do nebes. Autovacuum se mírně zapotilo.
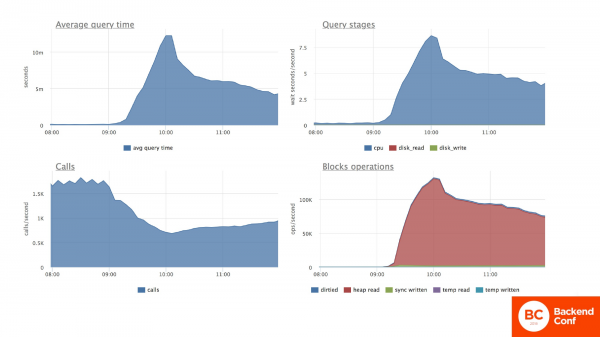
Konkrétně k naší tabulce vidíme, že aktualizace dat na ní také vzrostla do nebes. Spotřeba procesorových zdrojů podobně výrazně vzrostla. Opět procházíme velké množství mrtvých bezcenných řádků. A doba odezvy pro tuto tabulku, počet transakcí klesl.
Jak to bude vypadat, pokud nevíme, o čem jsem mluvil dříve?
- Začínáme hledat problémy. Pokud jsme se setkali s problémy v první části, víme, že to může být způsobeno dlouhou transakcí, a zkoumáme Mistr. Problém máme na Mistrovi. Zase se mu nedaří. Zahřívá se, jeho Load Average je téměř sto.
- Žádosti tam zpomalují, ale nevidíme žádné dlouhé transakce. A nechápeme, v čem je problém. Nevíme, kde hledat.
- Kontrolujeme serverové vybavení. Možná se nám rozpadl raid. Možná nám shořel modul paměti. Může se stát cokoliv. Ale ne, servery jsou nové, vše funguje skvěle.
- Běhají tam všichni: administrátoři, vývojáři a ředitel. Nic nepomáhá.
- A v určitém okamžiku se všechno nečekaně začíná samo opravovat.
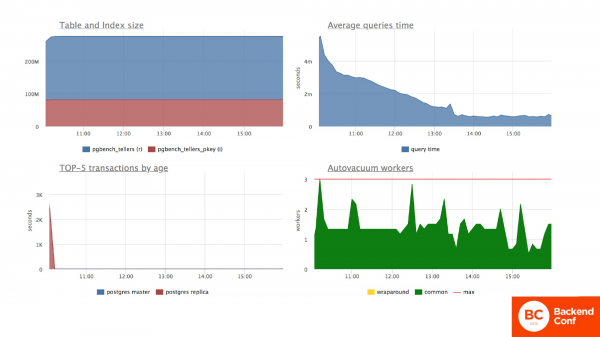
Na replikaci v této době požadavek dokončil a odešel. Dostali jsme zprávu. Byznys je stále spokojený. Jak vidíme, tabulka nám opět vzrostla a nehodlá se zmenšovat. Na grafu sezení jsem nechal úryvek této dlouhé transakce z repliky, abyste mohli posoudit, jak dlouho trvá, než se situace stabilizuje.
Sezení odešlo. A až po chvíli server přichází víceméně do pořádku. A průměrná doba odezvy požadavků na Mistru se vrací k normálu. Protože konečně autovakua dostala možnost uklidit a označit ty mrtvé řádky. A začala vykonávat svou práci. A jak rychle to dělá, tak rychle se dostaneme do pořádku.
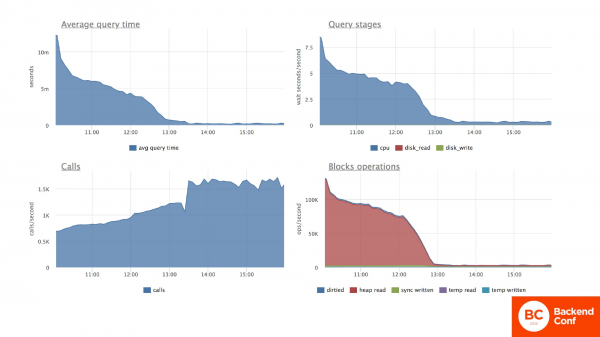
U zkoumané tabulky, kde aktualizujeme zůstatky na účtech, vidíme stejný obraz. Průměrná doba aktualizace účtu se také postupně normalizuje. Zdroje spotřebovávané procesorem se také snižují. A počet transakcí za sekundu se vrací k normálu. Ale opět ne k normální úrovni, jakou jsme měli před havárií.
V každém případě dostáváme pokles výkonnosti jako v prvním případě o půl až dvě čísla, a někdy i více.
Zdá se, že jsme udělali všechno správně. Rozložili jsme zátěž. Vybavení neprostoje. Správně jsme rozdělili požadavky, ale stejně to dopadlo špatně.
- Nemít zapnutý hot_standby_feedback? Ano, obecně se nedoporučuje ho zapínat bez vážného důvodu. Tato funkce totiž přímo ovlivňuje hlavní server a pozastavuje činnost automatického údržbového procesu. Pokud jej zapnete na nějaké replikaci a zapomenete na to, můžete způsobit problémy hlavnímu serveru a vyvolat vážné komplikace s aplikací.
- Zvětšit max_standby_streaming_delay? Ano, to platí pro reporty. Pokud máte tříhodinový report a nechcete, aby se zastavil kvůli konfliktům replikací, jednoduše prodlužte zpoždění. Dlouhý report nikdy nevyžaduje data, která přišla do databáze právě teď. Pokud jde o tříhodinový report, spouštíte jej za nějaké starší období dat. A zda máte tříhodinové zpoždění, nebo šestis hodinové, to nehraje žádnou roli, ale budete stále dostávat reporty a nebudete mít problémy s jejich selháním.
- Samozřejmě, je třeba kontrolovat dlouhé relace na replikách, zejména pokud jste se rozhodli zapnout hot_standby_feedback na replikaci. Protože se může stát cokoliv. Dali jste tuto replikaci vývojáři, aby otestoval dotazy. Napsal šílený dotaz. Spustil ho a šel si udělat čaj, a my máme zahlcený hlavní server. Nebo jsme tam pustili špatnou aplikaci. Situací je nespočet. Relace na replikách je třeba kontrolovat stejně pečlivě, jako na hlavním serveru.
- A pokud máte rychlé a dlouhé dotazy na replikách, pak je v tomto případě lepší rozdělit je pro vyrovnání zátěže. To souvisí se streaming_delay. Pro rychlé dotazy mít jednu replikaci s malým zpožděním. Pro dlouhé reportní dotazy mít replikaci, která může být pozadu o 6 hodin nebo dokonce o den. To je zcela běžná situace.
Odstraňujeme následky stále stejným způsobem:
- Nalezneme nafouknuté tabulky.
- A zkomprimujeme je nejvhodnějším nástrojem, který máme k dispozici.
Druhá historie na tom skončila. Přecházíme k třetí historii.
Také docela běžná pro nás, ve které provádíme migraci.
- Každý software roste. Mění se požadavky na něj. V každém případě se chceme vyvíjet. A někdy je potřeba aktualizovat data v tabulce, tedy provést aktualizaci v rámci naší migrace pod nový funkce, které zavádíme v rámci našeho rozvoje.
- Starý formát dat nám nevyhovuje. Představme si, že se nyní obrátíme na druhou tabulku, kde mám operace s těmito účty. A dejme tomu, že byly v rublech, ale rozhodli jsme se zvýšit přesnost a pracovat v kopejkách. A k tomu potřebujeme provést aktualizaci: pole se součtem operace vynásobíme sto.
- V moderním světě používáme automatizované prostředky pro správu verzí databáze. Představme si, . Zapisujeme sem naši migraci. Testujeme ji na naší testovací databázi. Vše v pořádku. Aktualizace probíhá. Na nějakou dobu blokuje provoz, ale dostáváme tak aktualizovaná data. A můžeme spustit novou funkcionalitu. Vše jsme otestovali, zkontrolovali. Všichni potvrdili.
- Provedli jsme plánované práce, provedli migraci.
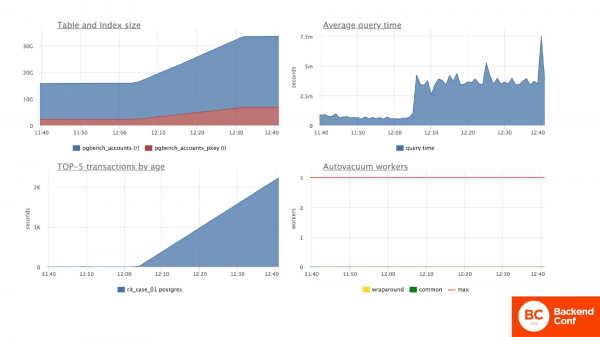
Zde je migrace s aktualizací před vámi. Protože se jedná o operace s účty, tabulka měla 15 GB. A protože aktualizujeme každý řádek, zvětšili jsme tabulku při aktualizaci na dvojnásobek, protože jsme přepsali každý řádek.
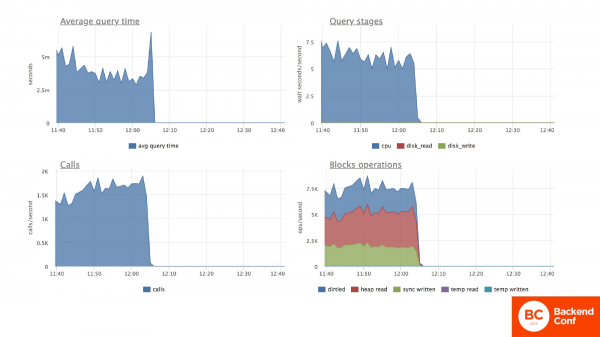
Během migrace jsme s touto tabulkou nemohli dělat nic, protože všechny dotazy na ni čekaly v řadě a čekaly na dokončení této aktualizace. Ale zde chci upozornit na čísla, která jsou na vertikální ose. Tedy máme průměrnou dobu dotazu před migrací kolem 5 milisekund a zatížení procesoru, počet blokových operací pro čtení z disku je méně než 7,5.
Provedli jsme migraci a znovu jsme dostali problémy.
Migrace proběhla úspěšně, ale:
- Starý funkční prvek začal trvat déle.
- Tabulka znovu vzrostla na velikosti.
- Zatížení serveru bylo znovu vyšší, než bylo předtím.
- A samozřejmě stále si hrajeme s tím funkčním prvkem, který fungoval dobře, trochu jsme ho vylepšili.
A to je znovu bloat, který nám znovu ztěžuje život.
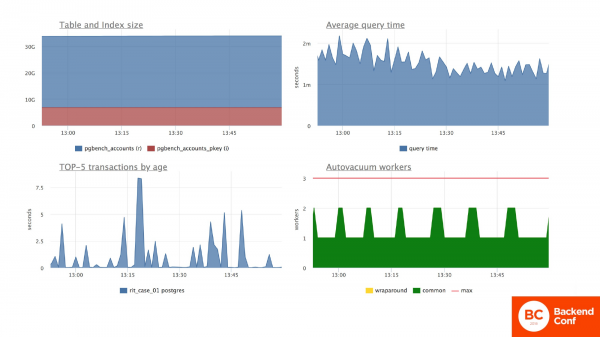
Zde demonstruji, že tabulka, jako v předchozích dvou případech, se nechystá vrátit k předchozím velikostem. Průměrné zatížení serveru se zdá být adekvátní.
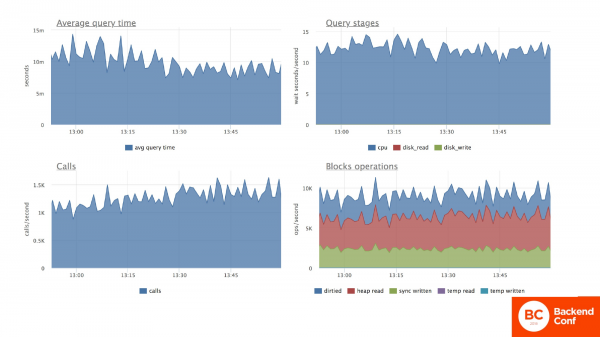
A pokud se podíváme na tabulku s účty, vidíme, že průměrná doba dotazu se zdvojnásobila vůči této tabulce. Zatížení procesoru a počet procházených řádků v paměti vzrostl nad 7,5, zatímco byl nižší. A vzrostl v případě procesorů dvojnásobně, v případě blokových operací o 1,5krát, tedy došlo k degradaci výkonu serveru. A jako důsledek – degradaci výkonu naší aplikace. Přitom počet volání zůstal přibližně na stejné úrovni.
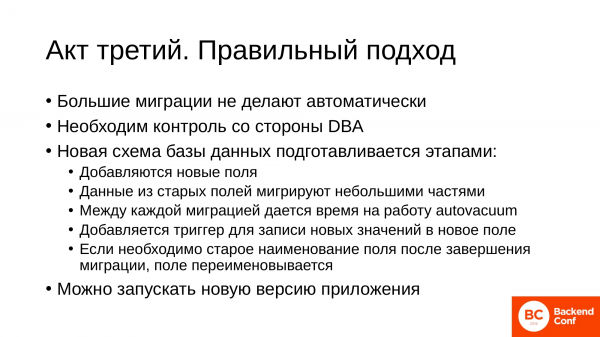
A zde je hlavní porozumět tomu, jak správně provádět takové migrace. A ty je nutné provádět. Tyto migrace realizujeme docela pravidelně.
- Takové velké migrace nejsou prováděny automaticky. Vždy by měly být pod kontrolou.
- Je potřebný dohled ze strany znalé osoby. Pokud máte v týmu DBA, nechte to udělat DBA. To je jeho práce. Pokud ne, měl by to udělat nejzkušenější člověk, který ví, jak pracovat s databázemi.
- Nová schéma databáze, i když aktualizujeme pouze jeden sloupec, vždy připravujeme ve fázích, tedy dopředu, než bude nasazena nová verze aplikace:
- Přidávají se nová pole, do kterých budeme zapisovat právě aktualizovaná data.
- Přesouváme data ze starého pole do nového pole po menších částech. Proč to děláme? Za prvé, vždy kontrolujeme průběh tohoto procesu. Víme, že jsme přesunuli tolik a tolik bloků a zbývá nám tolik.
- A druhý pozitivní efekt spočívá v tom, že mezi každým takovým blokem uzavíráme transakci, otevíráme novou a to umožňuje automatickému úklidu pracovat s tabulkou a označit mrtvé řádky k opětovnému použití.
- Pro řádky, které se objeví během práce aplikace (naše stará aplikace stále běží), přidáváme spouštěč, který zapisuje nové hodnoty do nových polí. V našem případě to znamená vynásobení sta staré hodnoty.
- Pokud jsme úplně neústupní a chceme to stejné pole, po dokončení všech migrací a před nasazením nové verze aplikace jednoduše přejmenujeme pole. Staré na nějaký vymyšlený název a nová pole přejmenujeme na staré.
- A až poté spustíme novou verzi aplikace.
A přitom nezískáme bloat a nedaří se nám výkon.
A na tomto třetím příběhu končí.
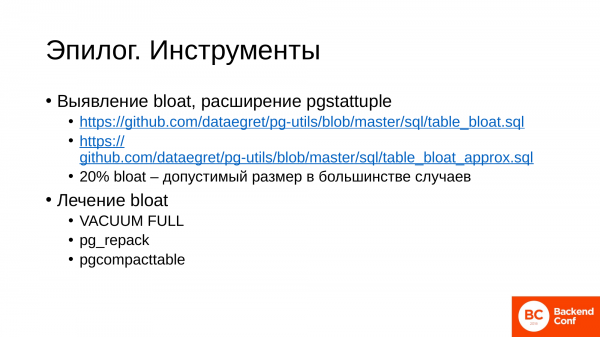
A teď se podíváme trochu podrobněji na nástroje, které jsem zmínil v první historii.
Než začnete hledat bloat, musíte určitě nainstalovat rozšíření. .
Abychom vám neusnadnili vymýšlení dotazů, v naší práci jsme již tyto dotazy napsali. Můžete je použít. Zde jsou prezentovány dva dotazy.
- První dotaz trvá poměrně dlouho, ale ukáže vám přesné hodnoty bloat podle tabulky.
- Druhý dotaz je rychlejší a velmi efektivní, když potřebujete rychle vyhodnotit, zda existuje bloat nebo ne. A také byste měli mít na paměti, že bloat v tabulce Postgres je vždy. Je to vlastnost jeho modelu MVCC.
- A 20 % bloat je normální pro tabulky ve většině případů. T. j. nemusíte se obávat a komprimovat tuto tabulku.
Jak identifikovat tabulky, které nám zbytněly, jsme si objasnili, a to, když zbytněly bezcennými daty.
Teď o tom, jak opravit bloat:
- Pokud máme malou tabulku a dobré disky, tj. s tabulkou do jednoho gigabytu je zcela možné použít VACUUM FULL. Získá na tabulku exkluzivní zámek na několik sekund a hotovo, rychle a efektivně všechno udělá. Co dělá VACUUM FULL? Získá exkluzivní zámek na tabulku a přepisuje živé řádky ze starých tabulek do nové tabulky. A na konci je zamění. Staré soubory odstraní, nové vloží místo starých. Ale po dobu své činnosti získává exkluzivní zámek na tabulku. To znamená, že s touto tabulkou nic nebudete moci udělat: ani do ní zapisovat, ani ji číst, ani ji měnit. A VACUUM FULL vyžaduje další místo na disku k zápisu dat.
- Další nástroj . Podle svého principu je velmi podobný VACUUM FULL, protože také přepisuje data ze starých souborů do nových a mění je v tabulce. Ale na začátku své činnosti nezískává exkluzivní zámek na tabulku, ale pouze v okamžiku, kdy má již připravená data k nahrazení souborů. Požadavky na diskové zdroje jsou u něj podobné jako u VACUUM FULL. Potřebujete další místo na disku, což může být někdy kritické, pokud máte terabajtové tabulky. A je dost náročný na procesor, protože vykonává aktivní činnost s vstupy a výstupy.
- Třetí utilita je . Je více šetrná k prostředkům, protože funguje na trochu jiných principech. Hlavní podstatou pgcompacttable je to, že aktualizacemi v tabulce přesouvá všechny živé řádky na začátek tabulky. A poté spouští vacuumb na této tabulce, protože víme, že na začátku máme živé a na konci mrtvé řádky. A vacuum už sám ustřihne tento ocásek, t. j. nevyžaduje pro sebe příliš další diskový prostor. A je také možné jej omezit na prostředky.
Se nástroji je vše.
Pokud vám téma bloat připadá zajímavé na podrobnější prozkoumání, zde jsou některé užitečné odkazy:
- – to je prezentace mého kolegy. Je obecně o tom, kam se ztrácí místo v Postgres během jeho práce a života. A tam je velmi velký a podrobný technický kus pro administrátory databází o bloat.
- – to je odkaz na naše repo, kde uchováváme spoustu užitečných skriptů pro kontrolu stavu databáze. Tam můžete najít skripty na hledání bloat.
- a odkazy na nástroje, které vám pomohou zmenšit tabulky.
- – to je příspěvek mého kolegy. Tam se poměrně vážně a podrobně technicky zabývá bloat právě na úrovni blízké administrátorům.
Snažil jsem se spíše ukázat děsivý obraz pro vývojáře, protože jsou našimi přímými klienty databází a měli by rozumět, k čemu a jaké akce vedou. Doufám, že se mi to povedlo. Děkuji za pozornost!
Otázky
Děkuji za prezentaci! Mluvili jste o tom, jak lze odhalit problémy. Jak je lze předcházet? T. j. měl jsem situaci, kdy požadavky visely nejen kvůli tomu, že se obracely na nějaké externí služby. Byly to prostě nějaké šílené joins. Byly tam nějaké drobné neškodné požadavky, které visely celý den, a pak začaly dělat něco podivného. T. j. velmi to připomíná, co popisujete. Jak to sledovat? Sedět a neustále se dívat, který požadavek visí? Jak lze tomu předcházet?
V tomto případě je to úkol pro administrátory vaší společnosti, nezbytně ne pro DBA.
Jsem administrátor.
V PostgreSQL existuje takový pohled, jako je pg_stat_activity, ve kterém jsou uvedeny visící požadavky. A můžete vidět, jak dlouho tam visí.
Mám chodit každých 5 minut a dívat se?
Nastavte cron a kontrolujte. Pokud máte dlouhý dotaz, napište e-mail a hotovo. T. j. nemusíte se dívat na to, můžete to automatizovat. Přijde vám e-mail, na který reagujete. Můžete také automaticky odpovědět.
Existují jasné důvody, proč se to děje?
Některé jsem vyjmenoval. Jiné jsou složitější příklady. A tam může být debata na dlouho.
Děkuji za prezentaci! Chtěl jsem se zeptat na nástroj pg_repack. Pokud nedělá exkluzivní blokaci, tak...
Dělá exkluzivní blokaci.
… tak potenciálně mohu ztratit data. Moje aplikace by v tu dobu neměla nic zapisovat?
Ne, v pohodě pracuje s tabulkou, t. j. pg_repack nejprve přesune všechny aktivní řádky, které existují. Samozřejmě, že se do tabulky něco zapisuje. On prostě ten ocas dotáhne.
T. j. nakonec to dělal?
Na konci vezme exkluzivní blokaci, aby zaměnil tyto soubory.
Bude to rychlejší než VACUUM FULL?
VACUUM FULL, jak začalo, ihned vzalo exkluzivní blokaci. A dokud všechno nedokončí, tak ji nepustí. A pg_repack bere exkluzivní blokaci jen v okamžiku výměny souborů. V tuto chvíli tam nic nezapíšete, ale data se neztratí, všechno bude v pořádku.
Dobrý den! Hovořil jste o práci autovakuumu. Byl tam graf s červenými, žlutými a zelenými buňkami záznamu. T. j. žluté – označil jako smazané. A tudíž do nich můžeme zapisovat nové?
Ano. Postgres nemaže řádky. Má to svoji specifiku. Pokud aktualizujeme řádek, označíme ten starý jako smazaný. Tam se dostává id transakce, která tento řádek změnila, a zapisujeme nový řádek. A máme sezení, která je potenciálně mohou číst. V nějakém okamžiku se již stávají zcela starými. A podstata práce autovakuumu spočívá v tom, že prochází těmito řádky a označuje je jako nepotřebné. A tam lze přepsat data.
Rozumím. Ale otázka je trošku jiná. Nedokončil jsem. Předpokládejme, že máme tabulku. V ní jsou pole proměnné velikosti. A pokud se pokusím vložit něco nového, může to prostě do staré buňky nevejít.
Ne, tam se stejně aktualizuje celý řádek. V Postgres jsou dva modely ukládání dat. Rozlišuje podle typu dat. Některá data se ukládají přímo v tabulce, zatímco jiná jsou ještě tos-data. To jsou velké objemy dat: text, json. Ta se ukládají v oddělených tabulkách. A u těchto tabulek platí stejný problém s bloat, t. j. všechno stejné. Jen jsou vyčleněny zvlášť.
Děkuji za příspěvek! Jak přijatelné je používat statement timeout k omezení doby trvání dotazů?
Velmi přijatelné. Používáme to všude. A protože nemáme vlastní služby, poskytujeme vzdálenou podporu, takže máme poměrně rozmanité klienty. A všichni jsou tímto spokojeni. T. j. máme úkoly v cron, které kontrolují. Jen se s klientem dohodneme na době trvání sezení, což může být minuta nebo deset minut. Záleží to na zátěži databáze a jejím cíli. Ale všude používáme pg_stat_activity.
Děkuji za příspěvek! Snažím se aplikovat váš příspěvek na své aplikace. A vypadá to, že všude zahajujeme transakci a všude ji jasně ukončujeme. Pokud dojde k nějaké výjimce, tak se stejně provede rollback. A tady jsem se zamyslel. Mohla by přece transakce začít nejasně. To je asi nápověda pro dívku. Pokud udělám pouze aktualizaci záznamu, transakce se v PostgreSQL spustí a dokončí se až při odpojení spojení?
Pokud mluvíte teď o úrovni aplikace, záleží to na tom driveru, který používáte, a na tom ORM, které se používá. Tam je toho spousta nastavení. Jestliže máte zapnutou volbu auto commit on, transakce se spustí a hned se uzavře.
T. j. uzavře se hned po aktualizaci?
Záleží to na nastavení. Uvedl jsem jedno nastavení. To je auto commit on. To je docela běžné. Pokud je zapnuto, tak se transakce otevře a hned uzavře. Pokud jste výslovně neřekl „start transaction“ a „end transaction“, ale jednoduše spustil dotaz v relaci.
Dobrý den! Děkuji za příspěvek! Představme si, že máme databázi, která se zvětšuje a na serveru dochází místo. Existují nějaké nástroje, jak situaci vyřešit?
Místo na serveru je potřeba správně monitorovat.
Například, DBA šel na čaj, byl na dovolené atd.
Při vytváření souborového systému se vždy vytvoří nějaký rezervní prostor, kam se data nepíší.
A co když úplně na nulu?
Tomu se říká rezervovaný prostor, tedy ho lze uvolnit a v závislosti na tom, jak velký byl vytvořen, můžete získat volné místo. Standardně nevím, kolik tam je. A v jiném případě by bylo třeba dodat disky, aby bylo místo pro provedení obnovovací operace. Můžete odstranit nějakou tabulku, která vám jistě není potřeba.
Není žádný jiný nástroj?
To je vždy manuální práce. A na místě se rozhoduje, co by bylo lepší udělat, protože jsou kritická a nekritická data. A pro každou databázi a aplikaci, která s ní pracuje, to závisí na podnikání. Vždy se rozhoduje na místě.
Děkuji za prezentaci! Mám dvě otázky. Za prvé, ukazovali jste slidy, kde bylo uvedeno, že v případě zablokovaných transakcí roste jak objem tabulkového prostoru, tak velikost indexu. A dále ve zprávě bylo spoustu utilit, které balí tabulky. A co s indexem?
I ty se balí.
Ale vacuum se indexu netýká?
Některé pracují s indexem. Například pg_rapack, pgcompacttable. Vacuum znovu vytváří indexy, týká se jich. Hlavní myšlenka VACUUM FULL je přepsat všechno, tedy pracuje se všemi.
A druhá otázka. Nechápu, proč se zprávy na replikách tak silně závisí na samotné replikaci. Zdálo se mi, že zprávy jsou čtení, a replikace je zápis.
V čem vzniká konflikt replikace? Máme Master, na kterém probíhají procesy. Probíhá autovakuum. Co na autovakuum vlastně dělá? Odstraňuje některé staré řádky. Pokud v této době na replikaci probíhá dotaz, který čte tyto staré řádky, a na Masteru došlo k situaci, kdy autovakuum označilo tyto řádky jako možné pro přepsání, přepsali jsme je. A máme příchozí balík dat, kdy bychom měli přepsat ty řádky, které požaduje dotaz na replikaci, proces replikace vyčká na nastavený časový limit. A pak PostgreSQL rozhodne, co je pro něj důležitější. A replikace je pro něj důležitější než dotaz, a tak dotaz zahodí, aby mohl provést tyto změny na replikaci.
Andrei, mám otázku. Tyto skvělé grafy, které jste ukazovali během prezentace, jsou výsledkem práce nějakého vašeho nástroje? Jak byly grafy vytvořeny?
To je služba .
Je to komerční produkt?
Ano. Je to komerční produkt.
Zdroj: habr.com
