

Jmenuji se Jurij, jsem vedoucí skupiny systémového administrativního řízení ve společnosti Sitimobil. Dnes se podělím o zkušenosti s technologií tenkého rezervování (thin provisioning) souborových systémů Linux a ukážu, jak ji lze uplatnit v technologických CI/CD procesech firmy. Podíváme se na situaci, kdy pro automatické testování kódu při jeho dodání do produkce potřebujeme co nejrychleji kopie databází MySQL, co nejblíže k 'životní' verzi, dostupné pro čtení i zápis.
Úvod: proč dávat škodlivé rady?
Logická otázka, protože existují osvědčené mechanismy migrace schémat databází do testovacích prostředí. Proč vlastně přivádět hlavní nemodulární databázi k takovým objemům? A pro testování nejsou potřebná všechna data. Pokusím se to vysvětlit.
Přibližně před rokem, na pozadí aktivního růstu našeho agregátoru taxi (v roce 2018 vzrostl počet dokončených jízd přibližně 15krát), vzrostly objemy dat, zatížení serverů a frekvence nasazení. Ocitli jsme se v následující situaci:
- Hlavní databáze MySQL vzrostla přibližně na 1000 tabulek s celkovým objemem 2,5 TB a nadále rostla.
- Nebyla možnost rychle shardovat a rozdělit databázi. To neumožňoval starý přístup 'píšu do databáze, co chci a jak chci', spousta JOINů a vnitřních závislostí tabulek.
- Nebyl mechanismus migrací schématu databáze do testovacích prostředí.
- Nebyla automatizovaná testování kódu při nasazení do provozu.
Poslední problém bylo chtěné vyřešit co nejrychleji. Byly již napsány testy Postman pro ověření hlavního PHP monolitu, ale chyběla aktuální databáze. Přitom jsme nemohli v noci vytvořit replikaci, udělat ji masterem a předat ji na roztrhání přes den: velmi velké množství nasazení a změn, včetně dat a schématu databáze, by způsobilo, že by stroj přestal fungovat už v polovině dne. A omezovat nasazení pouze pracovním dnem by bylo neefektivní.
Nicméně, úkol byl splněn: první pracovní stroj jsme získali už za dva týdny. Během uplynulého roku prošel mnoha změnami a nadále se používá.
Dále podrobně popíšu všechny kroky a fáze vývoje našeho řešení. Ujistíte se, že tato metoda si zaslouží právo na existenci.
Co je 'tenké rezervování'?
Jedná se o hardwarovou nebo softwarovou technologii (jiný název — sparse volumes), která umožňuje alokovat větší množství požadovaného zdroje, než je k dispozici. Přitom alokovaný objem musí splňovat kritéria just-enough (tolik, kolik je potřeba) a just-in-time (v potřebném čase). Většinou se tenké rezervování používá v různých SŘBD, aby se poskytovalo diskové místo ve potřebných objemech, které přesahují skutečně dostupné. Tato technologie je podporována různými souborovými systémy, například LVM2, ZFS, BTRFS. Je široce používána v hypervizorech virtualizace. Tenké rezervování nám umožnilo rychle vytvořit z jednotlivých snímků hlavního oddílu s daty tolik kopií tohoto oddílu, kolik potřebujeme (data adresář DBMS MySQL).
První stojan, technologie Thin LVM
Tuto kapitolu lze nazvat "Jak vytvořit co nejrychlejší snímky velkých objemů dat pomocí ", čímž se stabilita souborového systému a DBMS MySQL sníží na nedůstojný úroveň."
Protože jsme již používali LVM k vytvoření základních oddílů OS, rozhodli jsme se začít právě s ní. Na začátek jsme potřebovali samostatný fyzický stroj — replikaci naší hlavní databáze MySQL, na kterém bychom mohli na požádání vytvářet snímek replikace a spouštět jej vedle jako samostatnou instanci MySQL. Během testování jsme povolili provádět na této instanci měnící operace a po dokončení testů jsme ji úspěšně odstranili. Konfigurace serveru byla následující:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD v RAID kontroléru Adaptec v RAID-10
Odborný výběr mezi RAID kontrolérem a softwarovým RAID MD by si zasloužil samostatný článek. Mohu pouze říci, že naše volba byla ovlivněna dvěma faktory:
- V době stanovování úkolu jsme všechny SŘBD instalovali na RAID kontroléry, takže se dá říct, že tímto způsobem to historicky vzniklo.
- Rozdíl ve výkonu při syntetických testech souborového systému a testech s různými operacemi v MySQL byl minimální.
Rozdělili jsme vytvořený RAID-10: vytvořili jsme jednotnou Volume Group (VG) na celý objem (s přidanými náklady přibližně 6,7 GB) a vytvořili logické oddělení (Logical Volume, LV) pro systém o velikosti 50 GB. V běžném případě bychom zbývající prostor přidělili pro oddělení s MySQL. Avšak potřebovali jsme tenké zálohování, a proto jsme nejprve vytvořili takzvaný pool, uvnitř kterého jsme vytvořili oddělení pro /var/lib/mysql o velikosti 3,5 TB (na základě předpokládaného objemu databází):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Naformátovali jsme oddělení na ext4, připojili jsme ho, zapsali replikaci a získali původní stav. Poté jsme vytvořili API, které by mělo vytvářet snímky, spouštět instanci databáze MySQL na daném portu a odstraňovat vytvořenou instanci. Jelikož se používají pouze systémové volání, jako jazyk pro psaní skriptů jsme zvolili běžný bash, a jako vazbu API HTTP → bash jsme nasadili open source řešení. , napsané v Go.
Jednou zveřejníme naše bash skripty jako open source, ale zatím prostě popíšu hlavní algoritmus:
Vytvoření hlavního snímku snapmain:
- Zastavíme hlavní replikaci.
- Nastavíme zámek na operace se snímkem snapmain.
- Vytvoříme nový snímek snapmain.
- Spustíme MySQL a odstraníme zámek.
Vytvoření databáze na libovolném portu ze snapmain:
- Nastavíme zámek na konkrétní instanci databáze (port).
- Ověříme přítomnost zámku na vytvoření hlavního snímku. Pokud existuje, čekáme a znovu kontrolujeme každých 5 sekund.
- Kontrolujeme, zda existuje starý LV oddíl instance.
3.1 Pokud existuje, zastavíme pomocí kill -9 instanci MySQL a odstraníme LV oddíl. - Vytvoříme z snapmain novou instanci.
- Připravíme a připojíme adresáře pro tuto instanci.
- Odstraníme znaky otroka (soubory) a spustíme instanci MySQL.
- Učiníme z ní master.
- Odstraníme zámek.
Odstranění databáze na libovolném portu:
- Nastavíme zámek na konkrétní instanci databáze (port).
- Zabijeme instanci MySQL pomocí kill -9.
- Odpojíme adresáře.
- Odstraníme LV oddíl a zrušíme zámek.
Příklad příkazů pro klonování oddílů nové instance databáze:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Nyní vám povím o hlavním problému, se kterým jsme se při používání tenkého zálohování setkali. Narazili jsme na výkon SSD disků. K tomu došlo díky vlastnostem Thin LVM: ta v podstatě pracuje na úrovni zařízení pomocí nízkoúrovňových bloků o defaultní velikosti 4 MB. Jak to vypadalo:
- Vytváříme snímek z hlavního oddílu /var/lib/mysql.
- Spouštíme replikaci, abychom dohnali master.
- Jakákoliv změna v tabulkách repliky nutí uchovávat staré, neměnné bloky dat v oddílu snímku.
- Jakákoliv změna v běžícím testovacím instance nutí uchovávat staré, neměnné bloky dat v oddílu zkopírovaného snímku pro tuto instanci.
- Získáváme zátěž operací vstupu a výstupu na 100% na zařízení, zpomalení jakýchkoliv operací a postupné zaostávání repliky.
- Na konci pracovního dne máme stán s několika hodinovým zpožděním.
Jak jsme se s tím vypořádali, abychom získali rozumnější výsledek (hlavní body):
RAID kontroler:
- Vypnuli jsme veškeré typy kešování.
- Nastavili jsme writeback (když jsou data v mezipaměti, zápis se dokončí dříve, než dojde k skutečnému uložení na disk).
Souborový systém:
- Na bodu připojení /var/lib/mysql jsme uvedli noatime,nodiratime,data=writeback
- Vypnuli jsme žurnálování ext4 pomocí tune2fs.
MySQL:
- Uvedli jsme innodb_flush_method = O_DSYNC (zvýšili jsme rychlost zápisu a tím snížili spolehlivost).
- Vypnuli jsme žurnálování, logy nejsou potřeba.
- Uvedli jsme innodb_buffer_pool_size = 4G (čím menší je velikost InnoDB poolu, tím rychleji se MySQL zastaví při výpadku a tím rychleji vytvoříme snímek).
To rozhodně není úplný seznam, zvlášť co se týká MySQL. Nicméně ostatní změny jsou drobné a často se neaplikují vždy a přesně. Například ve snaze zatížit disky méně jsme dokonce přemístili innodb_parallel_doublewrite_path do /dev/shm, což v některých případech při spuštění nesprávně dokončené instance šetřilo až 5 sekund.
Proč zastavujeme MySQL před tím, než uděláme snímek? Vždyť můžeme udělat snímek z běžící repliky. To je pravda, ale nový instance databáze na tomto snímku bude defaultně považována za poškozenou a bude vyžadovat úplné skenování při spuštění. Zastavit replikaci je rozhodně rychlejší, i když se to nakonec ukazuje být nejdelší operací v celém procesu.
V důsledku jsme získali přijatelnější časování a funkční stanoviště. Ačkoliv, jak ukazuje nejpřevislejší graf zpoždění replikace hlavní repliky, situace je stále daleko od ideálu:
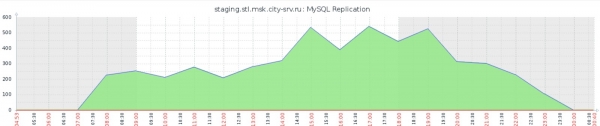
Mezi další nevýhody stojí za zmínku praktická nemožnost monitorování tenkého LVM poolu: kromě systémových standardních funkcí iostat není možné zjistit, například, který prvek poolu v současnosti vyvíjí největší zátěž na souborový systém.
Zvlášť je třeba zmínit jednu velkou nevýhodu spojenou s výše popsanou optimalizací: dostali jsme YOLO-stanoviště. Přibližně jednou za měsíc a půl ext4 nevydržela podobné přetěžování a bez varování se porouchala, vyžadující formátování a novou nahrávku repliky. I když jsme získali na rychlosti, stabilitu jsme beznadějně zhoršili.
Na jaké metriky je třeba dávat pozor při provozu tenkého LVM:
- Thin pool data %
- Thin pool metadata %
Pokud náš stan přežije nedostatek místa pro data (stačí vyčistit disky), nedostatek místa pro metadata povede k úplnému zhroucení poolu a nutnosti jeho opětovného vytvoření od nuly.
Souborový systém uvnitř poolu se časem velmi fragmentuje. Doporučuji spouštět každý den pomocí cronu příkaz fstrim -v /var/lib/mysql.
Mezivýsledky:
- Technologie je snadno aplikovatelná, stejně jako samotný LVM, a nevyžaduje zvláštní kvalifikaci inženýra.
- Dobře se hodí pro malé databáze a ty, které nejsou příliš zatěžovány. Čím menší databáze, tím méně částí se přesouvá uvnitř souborového systému v poolu, a tím menší zátěž na disky.
- Pro náš úkol jsme začali hledat jiná řešení, o čemž bude řeč v následující části.
Druhý stan, technologie ZFS
Kdysi dávno jsem měl zkušenosti se souborovým systémem ZFS, ale tehdy ZFS spolehlivě fungoval na svém domovském operačním systému Solaris. Existovala portovaná verze na FreeBSD s dostatečně dobrou úrovní implementace. Byla také nedokončená verze pro Linux, kterou málokdo používal. Vzhledem k tomu, že ZFS používal strukturu ukládání dat B-tree (mimochodem, stejnou strukturu jako má InnoDB MySQL), neukazoval se ZFS dobře na instalacích s velmi velkým počtem souborů. To vše v kombinaci s nutností studovat technickou stránku před použitím na dlouhou dobu vyloučilo tento souborový systém z mé praxe. Objevily se ext4 a xfs, které se staly standardem. Ale protože ZFS je pro náš úkol více než vhodné a linuxová verze, podle recenzí, vyrostla v docela rozumný produkt (i když není plně podporována, což znamená, že systém na ZFS lze kompletně nainstalovat pouze pomocí různých čarování), rozhodli jsme se to vyzkoušet.
Z pochopitelných důvodů jsme vybrali obdobnou konfiguraci (s výjimkou RAID řadiče). Nainstalovali jsme osm SSD disků o velikosti 1920 GB. Neměli jsme chuť vytvářet svůj síťový obrázek pro nahrávání serveru na holém ZFS, proto jsme odkousli z každého disku po 50 GB a vytvořili na nich MD RAID-10 pro systém. Zbývajících 1950 GB na každém disku jsme sloučili do ZFS analogie RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Vytvořili jsme oddíly pro MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Všimněte si, že jsme zapnuli standardní kompresi dat gzip. Na serveru máme dostatek procesorových zdrojů, které nejsou plně využívány. V důsledku toho se 3 TB naší databáze zúžily na 1,6 TB a protože slabým článkem, stejně jako v předchozím případě, je maximální výkon disků, čím méně dat — tím lépe, od začátku dostáváme skvělý bonus od ZFS! V době špičky při plné zátěži na údržbu fungování gzip využívá až 4 jádra, ale to nám nevadí.
Dále probíhalo zavádění rychleji. Po zkopírování z LVM stanice jsme nastavili replikaci MySQL. Museli jsme strávit nějaký čas přepisováním skriptů na příkazy ZFS, ale celkově algoritmy zůstaly stejné. Příklad vytvoření snapshotu:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
Z dalšího ladění: vyvedli jsme do paměti ZFS oddíly s metadaty a protokoly l2arc a zil. Pro náš úkol se ukázalo, že to bylo nadbytečné, ale zatím jsme tuto optimalizaci ponechali, změnit ji při příležitosti není složité. Z negativních efektů — je třeba po restartu serveru znovu vytvořit odpovídající oblasti paměti. Výstřižek z zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
V takové konfiguraci jsme začali testovat stojan a dostali skvělé výsledky: s dvěma současně pracujícími instancemi DB (a aktivní hlavní replikou) na snímcích jsme dosáhli zátěže disků na 50-60 %.
Zbavili jsme se našeho hlavního problému, což je vidět na grafu zpoždění replikace (srovnejte s předchozím grafem v sekci Thin LVM):
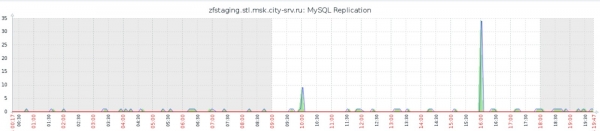
Díky tomu a mimo to jsme výrazně zrychlili všechny operace: kompletní vytvoření snímku se zastavením a spuštěním repliky trvá až 40 sekund, nasazení nového instance MySQL ze snímku trvá až 20 sekund. Což nás i naše testy softwarového kódu více než uspokojuje.
Mezivýsledky:
- Výsledky plně uspokojily naši potřebu získání kopie provozní DB pro testování kódu.
- Technologie vyžaduje znalosti: je třeba rozumět tomu, co je ZFS a jak s ním pracovat.
- Neprověřovali jsme aktuální stav funkce ZFS s velkým množstvím (více než 1 milion) malých souborů. Ale předpokládáme, že problém přetrvává, takže bych tuto souborový systém nedoporučoval pro žádné úložiště souborů.
Co dál?
V rámci stánku neděláme už nic jiného, výsledek nás uspokojuje. Možná v budoucnu přidáme do nastavení replikace stánku výjimky pro tabulky, které nejsou potřebné pro testování, což by ještě více zkrátilo objem databáze. Testovali jsme systém BTRFS a jeho implementaci technologie tenkého zálohování. Nicméně, tento úkol už není aktuální, protože hlavní cíl byl splněn. Celkově bychom se samozřejmě chtěli vzdálit od výše popsaného přístupu — realizovat funkční migrace databáze do testovacího prostředí, vytvořit samostatný testovací okruh databáze a zabývat se shardováním hlavní databáze. Mnoho z toho už realizujeme, o čemž se určitě podělíme v budoucích článcích.
Závěry
Původní úkol byl vyřešen, i když neobvyklým způsobem. V mezivýstupech byly popsány výhody a nevýhody každé z použitých technologií, takže se pojďme rozhodnout, jakou technologii a kdy můžeme použít:
- Thin LVM — na malých databázích a když se nechcete, nebo nemáte čas, na studium ZFS.
- ZFS — pokud máte zkušenosti s tím nebo máte možnost věnovat čas jeho studiu v jakékoli situaci.
Na vyšší úrovni pohledu je tento článek — nejen srovnání technologie dvou souborových systémů. Hlavní myšlenka, kterou chci předat a upevnit, je ta, že se nebojte myslet nekonvenčně v situacích kritických pro podnikání a brát pouze osvědčené recepty. Kdysi jsme se mohli celý technický tým zakrývat hlavami a říct, že úkol vytvořit tříterabajtové kopie databáze za méně než minutu je neproveditelný a nepotřebujeme riskantní technologie, pojďme to udělat správně. Bylo to možné, ale ztratili bychom přibližně půl roku až rok a mnoho cest klientů (cesty jsou naše hlavní obchodní ukazatel) bez testů a během implementace. Nezvykle jsme ztratili na implementaci méně času, získali zkušenosti s novými a zapomenutými starými technologiemi a poskytli testování právě v okamžiku, kdy jsme jej velmi potřebovali. Bezpochyby to pozitivně ovlivnilo všechny naše ukazatele. Výběr je vždy na vás, a my z naší strany budeme pokračovat v psaní o zajímavých současných a budoucích úspěších na našem blogu.
Zdroj: habr.com
