

Heisenbergův princip neurčitosti říká, že není možné současně změřit polohu a rychlost objektu. Pokud se objekt pohybuje, nemá žádnou polohu. A pokud existuje poloha, pak nemá rychlost.
Pokud jde o mikroservisy na platformě Red Hat OpenShift (řízené Kubernetes), díky odpovídajícímu softwaru s otevřeným zdrojovým kódem mohou současně hlásit jak svou výkonnost, tak svou funkčnost. Starý Heisenberg to samozřejmě nevyvrací, ale odstraňuje nejistotu při práci s cloudovými aplikacemi. Istio umožňuje snadno organizovat sledování a monitoring těchto aplikací, aby bylo vše pod kontrolou.
Stanovíme terminologii
Pod sledováním (Sledování) chápeme jako protokolování systémové aktivity. Zní to docela obecně, ale ve skutečnosti je jedním z hlavních pravidel zde shromažďovat data sledování do odpovídajícího úložiště, aniž byste se starali o jejich formátování. Celá práce na hledání a analýze dat je pak na jejich uživateli. V Istio je používán systém sledování Jaeger, který realizuje model dat OpenTracing.
Sledování (Sledování, a slovo "sledování" zde je použito ve smyslu "stopy", jako například v balistické expertize) budeme nazývat data, která kompletně popisují průchod žádosti nebo jednotky práce, jak se říká, „od a do“. Například, vše, co se děje od okamžiku, kdy uživatel stiskne tlačítko na webové stránce, až do návratu dat, včetně všech zapojených mikroservisů. Lze říci, že jedno sledování kompletně popisuje (nebo modeluje) průchod žádosti tam a zpět. V rozhraní Jaeger jsou sledování rozložena na složky podle osy času, podobně jako lze řetězec rozložit na jednotlivé články. Jen místo článků se sledování skládá z takzvaných spanů.
Span – to je interval od začátku vykonávání jednotky práce do jejího dokončení. Pokračujíc v analogii lze říci, že každý span představuje jednotlivý článek řetězu. Span může mít (nebo nemusí mít) jeden nebo více podřízených spanů. Jak následek, span nejvyšší úrovně (root span) bude mít stejnou celkovou délku trvání, jakou má sledování, ke kterému se vztahuje.
Monitoring – to je v podstatě samo pozorování vašeho systému – očima, prostřednictvím UI nebo automatizovaných nástrojů. Základem monitoringu jsou trace data. V Istio je monitoring implementován pomocí Promethea a má odpovídající UI. Prometheus podporuje automatické monitorování pomocí upozornění Alerts a Alert Managers.
Zanecháváme značky
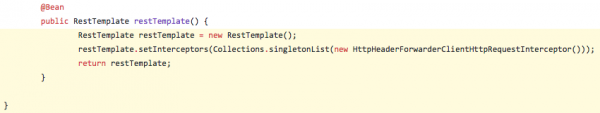
Aby byla trace dostupná, musí aplikace vytvořit sbírku spanů. Tyto span musí být exportovány do Jaegeru, aby vytvořil vizuální zobrazení trace. Mezi jinými tyto spany označují název operace, stejně jako časové značky jejího začátku a konce. Přenos spanů se provádí přesměrováním HTTP hlaviček směřujících k Jaegeru z příchozích požadavků na odchozí požadavky. V závislosti na používaném programovacím jazyce může být potřeba drobná úprava zdrojového kódu aplikací. Níže je příklad kódu v Javě (při použití rámce Spring Boot), který přidává B3 (Zipkin-style) hlavičky k vašemu požadavku v konfigurační třídě Spring:
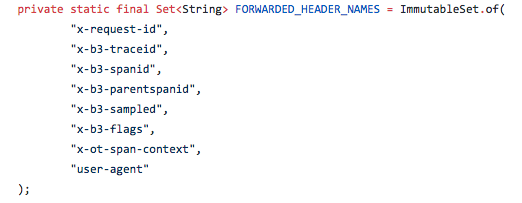
Přitom se používají následující nastavení hlaviček:
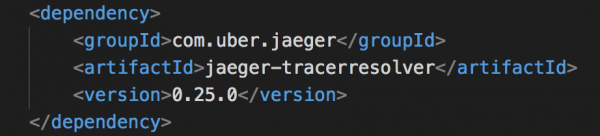
Pokud používáte Javu, nemusíte kód měnit, stačí přidat několik řádků do POM souboru Maven a nastavit environmentální proměnné. Zde jsou řádky, které je třeba přidat do souboru POM.XML, aby se implementoval Jaeger Tracer Resolver:
A odpovídající environmentální proměnné jsou nastaveny v Dockerfile:
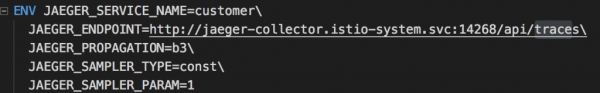
To je vše, nyní je vše nastaveno a naše mikro služby začnou generovat trace data.
Obecně se díváme
Součástí Istio je jednoduchý řídicí panel založený na Grafaně. Když je všechno nastaveno a funguje na platformě Red Hat OpenShift PaaS (v našem příkladu je Red Hat OpenShift a Kubernetes nasazen na minishift), tento panel se spouští následujícím příkazem:
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
Panel Grafana umožňuje rychlou evaluaci výkonu systému. Fragment tohoto panelu je zobrazen na obrázku níže:
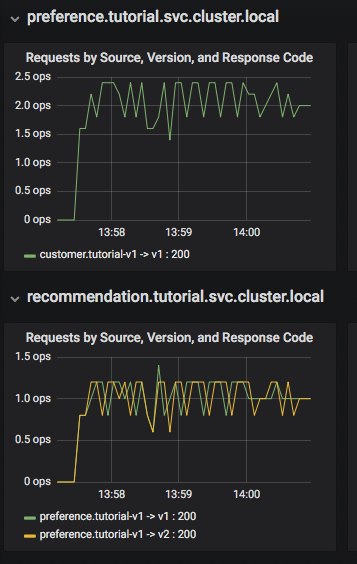
Zde je vidět, že mikroslužba customer volá mikroslužbu preference v1, která zase volá mikroslužby recommendation v1 a v2. Na panelu Grafana je blok Dashboard Row pro vysoceúrovňové metriky, jako je celkový objem požadavků (Global Request Volume), podíl úspěšných požadavků (success rates) a chyby 4xx. Kromě toho je zde zobrazení Server Mesh s grafy pro každou službu a blok Services Row pro zobrazení podrobných informací o každém kontejneru pro každou službu.
Teď se podíváme hlouběji.
Při správně nastaveném trasování Istio, což se dá říci, umožňuje analyzovat výkon systému téměř okamžitě. V uživatelském rozhraní Jaeger lze prohlížet trasování a vidět, jak daleko a hluboko sahají, a také vizuálně lokalizovat úzká místa v výkonu. Při použití Red Hat OpenShift na platformě minishift se Jaeger UI spustí následujícím příkazem:
minishift openshift service jaeger-query --in-browser
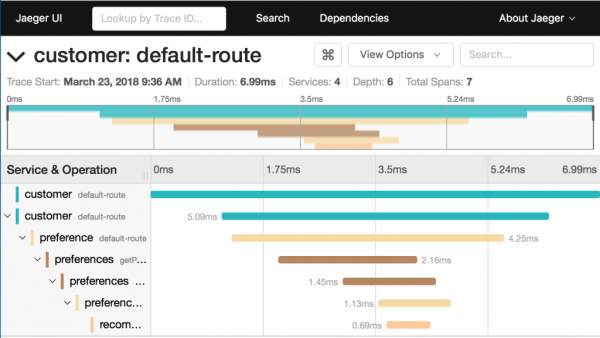
Co lze říci o trasování na tomto snímku:
- Rozdělí se do 7 spanů.
- Celkový čas provádění je 6,99 ms.
- Mikroslužba recommendation, která je poslední v řetězci, zabere 0,69 ms.
Diagramy tohoto typu umožňují rychle porozumět situaci, kdy výkon celého systému trpí kvůli jednomu méně výkonnému servisu.
A teď úkol ztížíme a spustíme dva instance mikroslužby recommendation:v2 příkazem oc scale --replicas=2 deployment/recommendation-v2. Takhle budou naše pod:
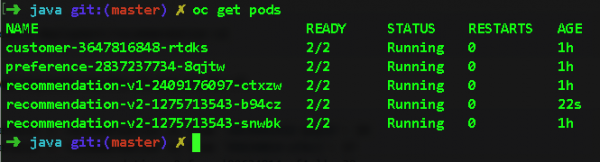
Pokud se teď vrátíme zpět do Jaeger a rozbalíme span pro službu recommendation, uvidíme, na který pod jsou směrovány požadavky. Takto můžeme snadno lokalizovat zpomalení na úrovni konkrétního podu. Je dobré se dívat na pole node_id:
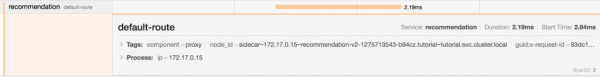
Kam a jak všechno chodí
Nyní přecházíme do uživatelského rozhraní Prometheus a očekávaně vidíme, že požadavky mezi druhou a první verzí služby recommendation se dělí v poměru 2:1, přesně podle počtu běžících podů. Tento graf se navíc dynamicky změní při škálování podů nahoru a dolů, což bude obzvlášť užitečné při Canary Deployment (tuto schéma nasazení podrobně probereme příště).
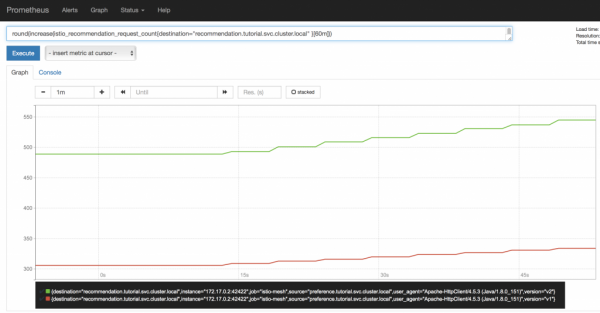
Všechno teprve začíná
Ve skutečnosti jsme dnes jen lehce přehodnotili poklad informací o Jaeger, Grafana a Prometheus. To bylo vlastně naším cílem – nasměrovat vás správným směrem a odhalit perspektivy Istio.
A pamatujte, to vše je již integrováno v Istio. Při použití některých programovacích jazyků (například Java) a frameworků (například Spring Boot) to vše lze realizovat, aniž byste se dotkli samotného kódu aplikací. Ano, kód bude nutné mírně upravit, pokud používáte jiné jazyky, přičemž na prvním místě stojí Node.js nebo C#. Ale protože sledovatelnost (čtěte „trasování“) je jednou z povinných podmínek pro vytváření spolehlivých cloudových systémů, budete v každém případě muset kód upravit, ať už máte Istio, nebo ne. Tak proč nespotřebovat své úsilí efektivněji?
Minimálně pro to, abyste mohli vždy s 100% jistotou odpovědět na otázky „kde?“ a „jak rychle?".
Chaos inženýrství v Istio: tak to bylo zamýšleno
Schopnost rozbíjet věci pomáhá zajistit, aby se nerozbily.
Testování softwaru je nejen složité, ale také důležité. Zatímco testování na správnost (například zda funkce vrací správný výsledek) je jedna věc, testování v podmínkách nespolehlivé sítě je zcela jiný úkol (často se předpokládá, že síť vždy funguje bez závad, a to je první z osmi mylných představ o distribuovaných výpočtech). Jednou z komplikací při řešení tohoto úkolu je, jak simulovat selhání v systému nebo je záměrně způsobovat prováděním tzv. fault injection. To lze provést prostřednictvím modifikace zdrojového kódu samotné aplikace. Ale pak nebudete testovat svůj původní kód, ale jeho verzi, která speciálně simuluje selhání. Výsledkem je, že riskujete spadnout do smrtící náruče fault injection a narazit na gejzebag – selhání, které zmizí při pokusu o jejich odhalení.
A nyní ukážeme, jak Istio pomáhá zvládat tyto složitosti raz dva.
Jak všechno vypadá, když je všechno v pořádku.
Zvažme následující scénář: máme dva pod‘á pro naši mikroservis recommendation, který jsme vzali z učebnice Istio. Jeden pod je označen jako v1 a druhý jako v2. Jak vidíme, zatím všechno funguje skvěle:
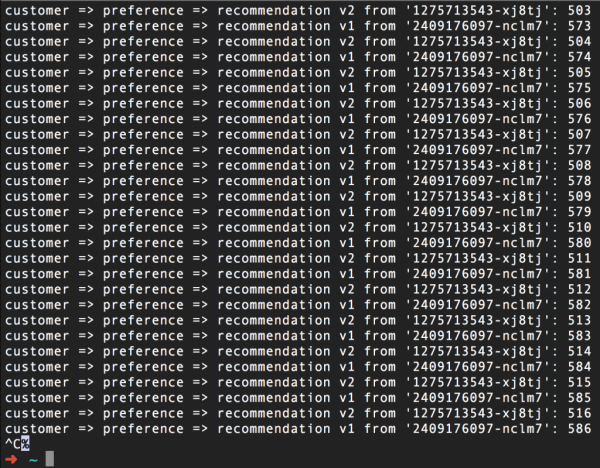
(Mimochodem, číslo vpravo je jen čítač pro každý pod.)
Ale přece to není to, co potřebujeme, že? Takže to zkusíme všechno porušit, aniž bychom se dotkli původního kódu.
Způsobujeme výpadky mikroservisu
Níže je uveden yaml soubor pro pravidlo směrování Istio, které v polovině případů způsobí chybu (chybu serveru 503):
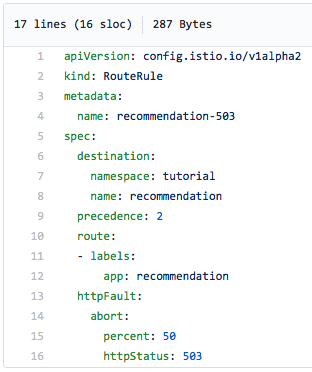
Všimněte si, že jasně uvádíme, že v polovině případů by měla být vrácena chyba 503.
Takto bude vypadat snímek obrazovky běžícího příkazu curl v cyklu poté, co aktivujeme toto pravidlo, abychom simulovali výpadky. Jak vidíme, polovina požadavků vrací chybu 503, a to bez ohledu na to, na který pod – v1 nebo v2 – jsou odeslány:
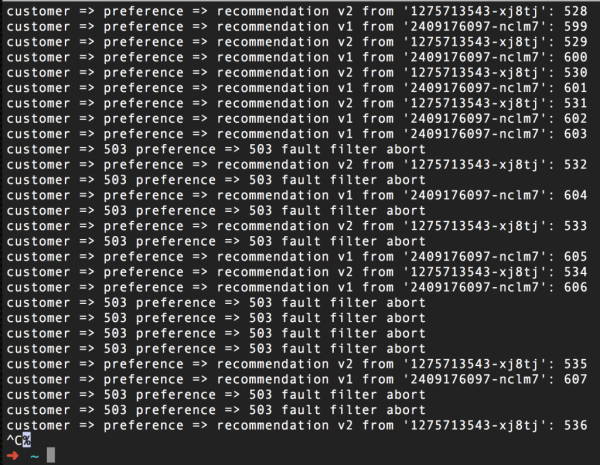
Pro obnovení normálního provozu stačí odstranit toto pravidlo, v našem případě příkazem istioctl delete routerule recommendation-503 -n tutorial. Zde Tutorial je název projektu Red Hat OpenShift, ve kterém běží náš výukový program o Istio.
Vytváříme umělé zpoždění
Umělé chyby 503 pomáhají otestovat systém na odolnost vůči selhání, ale schopnost předpovídat a zpracovávat zpoždění by vás měla ohromit ještě více. A zpoždění v reálném životě se vyskytují častěji než selhání. Pomalu běžící mikroservis je rakovina, která trápí celý systém. S pomocí Istio můžeme otestovat kód, který se týká zpracování zpoždění, aniž bychom ho při tom měnili. Nejdříve ukážeme, jak to udělat v případě uměle zavedených síťových zpoždění.
Všimněte si, že po takovém testování bude možná potřeba (nebo chcete) upravit svůj kód. Dobrou zprávou je, že v tomto případě budete jednat proaktivně, nikoli reaktivně. Takto by mělo být postaveno vývojové cyklu: kódování-testování-zpětná vazba-kódování-testování…
Takto vypadá pravidlo, které… I když víte co? Istio je tak jednoduché, a tento yaml soubor je tak srozumitelný, že vše v tomto příkladu mluví samo za sebe, podívejte se:
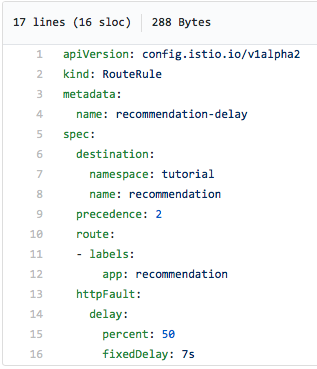
V polovině případů dojde k 7sekundovému zpoždění. A to rozhodně není totéž, jako bychom do zdrojového kódu vložili příkaz sleep, protože Istio skutečně zpožďuje požadavek o 7 sekund. Vzhledem k tomu, že Istio podporuje trasování Jaeger, je toto zpoždění jasně viditelné v uživatelském rozhraní Jaeger, jak je znázorněno na obrázku níže. Všimněte si dlouhého požadavku v pravém horním rohu diagramu – jeho doba trvání je 7,02 sekundy:
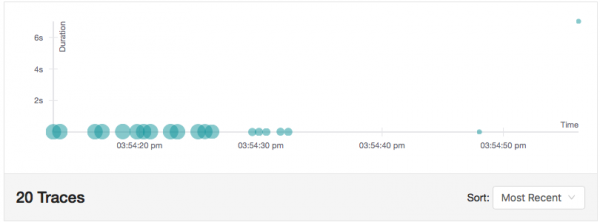
Tento scénář umožňuje otestovat kód za podmínek síťových zpoždění. A je jasné, že odstraněním tohoto pravidla odstraníme umělé zpoždění. Opakujeme, ale opět jsme to udělali, aniž bychom se dotkli zdrojového kódu.
Nevzdávat se a nezapomínat
Další užitečná funkce Istio pro chaos engineering je opakované volání služby zadaný početkrát. Smyslem je neodpustit se, když první požadavek skončí chybou 503 – a možná nám to konečně vyjde na N-tý pokus. Možná se služba na chvíli jen odmlčela z různých důvodů. Ano, tuto příčinu bychom měli prozkoumat a odstranit. Ale to až později, zatím se pokusíme, aby systém nadále fungoval.
Takže chceme, aby služba občas vracela chybu 503, a Istio se pak pokusilo znovu se s ní spojit. A tady zjevně potřebujeme způsob, jak generovat chybu 503, aniž bychom se dotkli samotného kódu…
Pozor, počkejte! To jsme právě dělali.
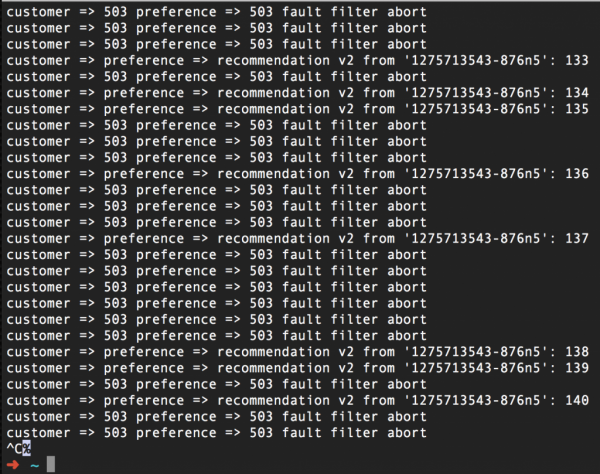
Tento soubor způsobí, že služba recommendation-v2 bude v polovině případů vracet chybu 503:
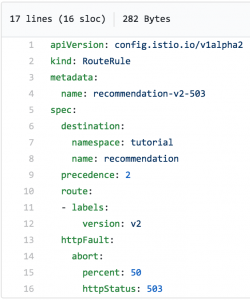
Je jasné, že část požadavků nebude úspěšná:
A teď zapojíme funkci Retry v Istio:
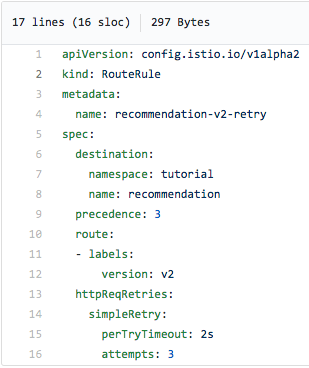
Toto pravidlo směrování provede tři pokusy s dvousekundovým intervalem a mělo by snížit (a ideálně úplně odstranit) chyby 503:
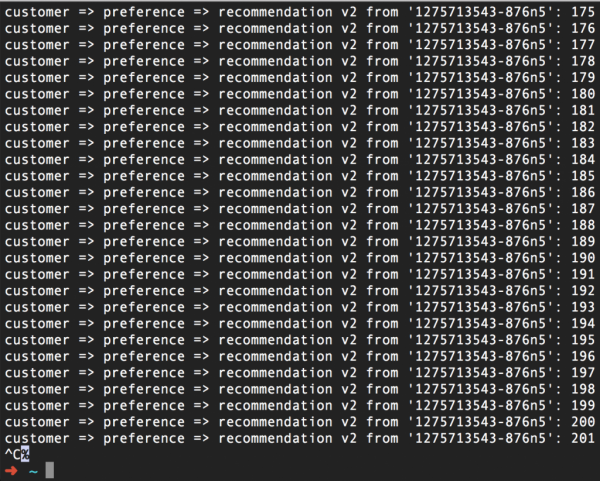
Shrnujeme: dosáhli jsme toho, že Istio, za prvé, generuje chybu 503 pro polovinu požadavků. A za druhé, stejné Istio provádí tři pokusy znovu se spojit se službou při chybě 503. V důsledku toho vše funguje prostě skvěle. Takže použitím funkce Retry jsme splnili svůj slib nezavdat.
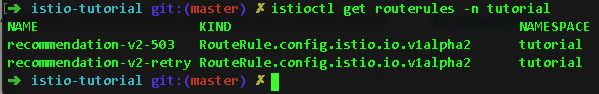
A ano, opět jsme to udělali, aniž bychom se dotkli kódu. Vše, co jsme potřebovali, byly dvě pravidla směrování v Istio:
Jak nezklamat uživatele nebo sedm jednoho nečeká
A nyní situaci převrátíme naruby a podíváme se na scénář, kdy se nevyplatí ustupovat a vzdávat to pouze po určitou pevně stanovenou dobu. Poté je třeba prostě přestat se snažit zpracovat požadavek, abychom nutili všechny čekat na nějakou jednu zpomalující službu. Jinými slovy, nebudeme chránit ztracenou pozici, ale ustoupíme na záložní pozici, abychom nezklamali uživatele webu a nenutili ho trpět v nevědomosti.
V Istio lze nastavit časový limit pro provedení požadavku. Pokud služba tento časový limit překročí, vrátí se chyba 504 (Gateway Timeout) – to vše se opět nastavuje prostřednictvím konfigurace Istio. Budeme však muset do zdrojového kódu služby přidat příkaz sleep (a poté, samozřejmě, provést rebuild a redeploy), abychom napodobili pomalou práci služby. Bohužel, jinak to nepůjde.
Takže jsme do kódu služby recommendation v2 vložili třísekundový sleep, znovu zkompilovali odpovídající obraz a provedli redeploy kontejneru, a nyní přidáme časový limit pomocí následujícího pravidla směrování Istio:
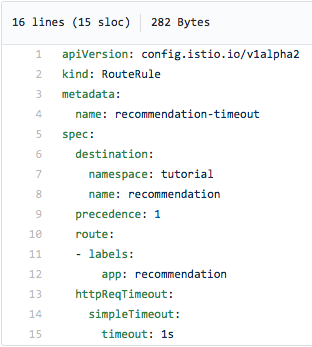
Na obrázku výše je vidět, že se pokoušíme kontaktovat službu recommendation, pokud nedostaneme odpověď během jedné sekundy, tedy ještě předtím, než dojde k chybě 504. Po aplikaci tohoto pravidla směrování (a přidání třísekundového sleepu do kódu služby recommendation:v2) dostaneme toto:
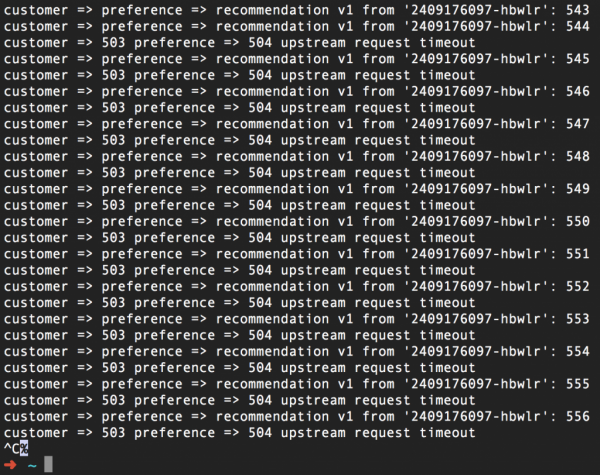
Opět se opakujeme, ale časový limit lze nastavit, aniž bychom se dotkli zdrojového kódu. Další výhodou je, že nyní můžete svůj kód upravit tak, aby reagoval na časový limit, a snadno otestovat tyto úpravy pomocí Istio.
A nyní všechno dohromady
Vnést trochu chaosu pomocí Istio je skvělý způsob, jak otestovat svůj kód a spolehlivost celého systému. Šablony fallback, bulkhead a circuit breaker, mechanismy pro vytváření umělých selhání a zpoždění, stejně jako opakované výskyty a časové limity budou velmi užitečné při vytváření odolných cloudových systémů. V kombinaci s Kubernetes a Red Hat OpenShift vám tyto nástroje pomohou se sebevědomě postavit před budoucnost.
Zdroj: habr.com
