

Pro kompletní osvojení Kubernetes je nutné znát různé způsoby škálování clusterových zdrojů: podle , to je jedna z hlavních úloh Kubernetes. Připravili jsme vysoce kvalitní přehled mechanismů horizontálního a vertikálního automasškálování a změn velikosti clusterů, stejně jako doporučení, jak je efektivně využívat.
Článek přeložil tým, který implementoval automasškálování v .
Proč je důležité uvažovat o škálování
— nástroj pro správu zdrojů a orchestraci. Samozřejmě není špatné si pohrát s cool funkcemi nasazení, monitorování a správy podů (modul pod — skupina kontejnerů spouštěných na základě požadavků).
Je však také třeba uvažovat o takových otázkách:
- Jak škálovat moduly a aplikace?
- Jak udržovat kontejnery v provozuschopném a efektivním stavu?
- Jak reagovat na neustálé změny v kódu a pracovních zátěžích od uživatelů?
Nastavení clusterů Kubernetes pro vyvážení zdrojů a výkonu může být složitý úkol, vyžaduje expertízu ohledně vnitřní práce Kubernetes. Zátěž na vaši aplikaci nebo služby se může během dne nebo dokonce jedné hodiny měnit, proto by mělo být vyvážení chápáno jako nepřetržitý proces.
Úrovně automasškálování Kubernetes
Efektivní automasškálování vyžaduje koordinaci mezi dvěma úrovněmi:
- Úroveň podů, která zahrnuje horizontální (Horizontal Pod Autoscaler, HPA) a vertikální automasškálování (Vertical Pod Autoscaler, VPA). Toto škálování představuje zdroje pro vaše kontejnery.
- Úroveň clusteru, kterou spravuje systém klasického automasškálování (Cluster Autoscaler, CA), zvyšuje nebo snižuje počet uzlů uvnitř clusteru.
Modul horizontálního automasškálování (HPA)
Jak napovídá název, HPA škáluje počet replik podů. Jako spouštěče pro změnu počtu replik většina devops používá zátěž na procesor a paměť. Můžete však systém škálovat na základě , jejich nebo dokonce .
Vysoce úrovňová schéma fungování HPA:
- HPA neustále kontroluje hodnoty metrik uvedené při instalaci s výchozím intervalem 30 sekund.
- HPA se pokouší zvýšit počet modulů, pokud je dosaženo stanoveného prahu.
- HPA aktualizuje počet replik uvnitř řadiče nasazení/replikace.
- Řadič nasazení/replikace poté nasadí všechny potřebné další moduly.
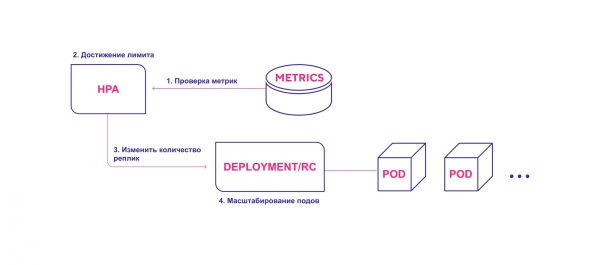
HPA spouští proces nasazení modulů při dosažení prahové hodnoty metrik.
Při použití HPA mějte na paměti následující:
- Výchozí interval kontroly HPA je 30 sekund. Je nastavován příznakem horizontal-pod-autoscaler-sync-period v řadiči.
- Relativní odchylka je ve výchozím nastavení 10%.
- Po posledním zvýšení počtu modulů HPA čeká na stabilizaci metrik po dobu tří minut. Tento interval je nastaven příznakem horizontal-pod-autoscaler-upscale-delay.
- Po posledním snížení počtu modulů HPA čeká na stabilizaci po dobu pěti minut. Tento interval je nastaven příznakem horizontal-pod-autoscaler-downscale-delay.
- HPA funguje nejlépe s objekty nasazení, nikoli s řadiči replik. Horizontální automatické škálování není kompatibilní s postupným aktualizováním (rolling update), které přímo manipuluje s řadiči replik. Při nasazení závisí počet replik přímo na objektech nasazení.
Vertikální automatické škálování podů
Vertikální automatické škálování (VPA) přiděluje více (nebo méně) procesorového času nebo paměti pro existující pody. Je vhodné pro pody se stavem (stateful) nebo bez něj (stateless), ale především je určeno pro stateful služby. Můžete však také použít VPA pro moduly bez stavu, pokud je potřeba automaticky upravit objem původně přidělených zdrojů.
VPA také reaguje na události OOM (out of memory, nedostatek paměti). Pro změnu procesorového času a objemu paměti je nutné restartovat pody. Při restartování VPA dodržuje rozpočet rozdělení (), aby zajistil minimálně potřebný počet modulů.
Můžete nastavit minimální a maximální objem zdrojů pro každý modul. Například můžete omezit maximální objem přidělené paměti na 8 GB. To je užitečné, pokud aktuální uzly nemohou přidělit více než 8 GB paměti na kontejner. Podrobné specifikace a mechanismus fungování jsou popsány v .
Kromě toho má VPA zajímavou funkci doporučení (VPA Recommender). Sleduje využití zdrojů a události OOM pro všechny moduly, aby navrhl nové hodnoty paměti a procesorového času na základě inteligentního algoritmu zohledňujícího historické metriky. K dispozici je také API, které přijímá popisovač podu a vrací navrhované hodnoty zdrojů.
Je třeba poznamenat, že VPA Recommender nesleduje „limit“ zdrojů. To může vést k tomu, že modul monopolizuje zdroje uvnitř uzlů. Je lepší nastavit limit na úrovni prostoru jmen, aby se předešlo nadměrnému využívání paměti nebo procesorového času.
Vysoká úroveň schématu práce VPA:
- VPA neustále kontroluje hodnoty metrik, které byly uvedeny při instalaci, v intervalu 10 sekund.
- Pokud je dosaženo zadaného prahu, VPA se pokusí změnit přidělené množství zdrojů.
- VPA aktualizuje množství zdrojů uvnitř ovladače nasazení/replicace.
- Při restartu modulů se všechny nové zdroje aplikují na vytvořené instance.
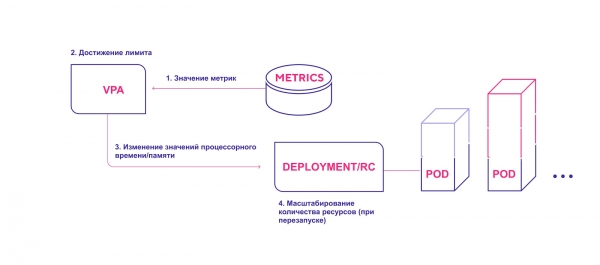
VPA přidává potřebné množství zdrojů
Zvažte následující skutečnosti při používání VPA:
- Škálování vyžaduje obligatorní restart podu. Je to nutné, aby se předešlo nestabilnímu fungování po provedení změn. Pro spolehlivost moduly restartují a distribuují se po uzlech na základě nově přidělených zdrojů.
- VPA a HPA jsou zatím navzájem nekompatibilní a nemohou pracovat na stejných podech. Pokud v jednom klastru používáte oba mechanismy škálování, ujistěte se, že nastavení neumožňují jejich aktivaci na stejných objektech.
- VPA nastavuje požadavky kontejnerů na zdroje pouze na základě jejich minulého a současného používání. Nezavádí limity pro využívání zdrojů. Mohou se vyskytnout problémy s nesprávným fungováním aplikací, které začnou zabírat stále více zdrojů, což povede k tomu, že Kubernetes vypne daný pod.
- VPA je zatím v rané fázi vývoje. Buďte připraveni na to, že systém může v blízké době projít určitými změnami. Můžete si přečíst o a . Takže v plánech je implementace spolupráce VPA a HPA, stejně jako nasazení modulů spolu s politikou vertikálního automatického škálování pro ně (například pomocí speciální etikety 'requires VPA').
Automatické škálování klastru Kubernetes
Automatické škálování klastru (Cluster Autoscaler, CA) mění počet uzlů na základě počtu čekajících modulů pod. Systém periodicky kontroluje přítomnost čekajících modulů — a zvětšuje velikost klastru, pokud jsou potřeba další zdroje a pokud klastr nepřekračuje stanovené limity. CA interaguje s poskytovatelem cloudových služeb, žádá o další uzly nebo uvolňuje nečinné. První veřejná verze CA byla představena v Kubernetes 1.8.
Vysoceúrovňový diagram fungování CA:
- CA kontroluje přítomnost modulů ve stavu čekání s výchozím intervalem 10 sekund.
- Pokud je jeden nebo více modulů ve stavu čekání kvůli nedostatečným dostupným zdrojům v klastru pro jejich rozdělení, pokusí se připravit jeden nebo více dodatečných uzlů.
- Když poskytovatel cloudových služeb přidělí potřebný uzel, připojí se k klastru a je připraven obsluhovat moduly pod.
- Plánovač Kubernetes rozděluje čekající moduly na nový uzel. Pokud některé moduly stále zůstávají ve stavu čekání, proces se opakuje — a do klastru se přidávají nové uzly.
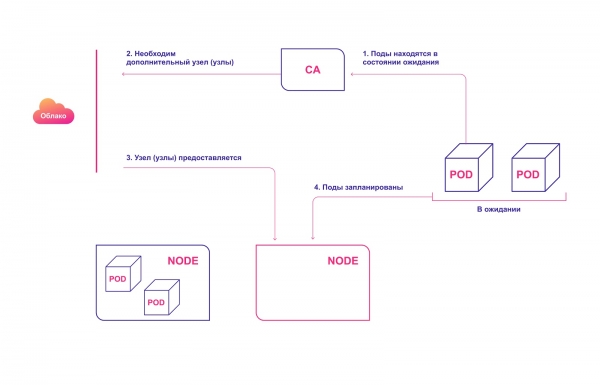
Automatické přidělování uzlů klastru v cloudu
Zvažte následující při používání CA:
- CA zajišťuje, že všechny moduly v klastru mají místo pro spuštění, bez ohledu na úroveň zatížení procesoru. Kromě toho se snaží zajistit, aby v klastru nebyly zbytečné uzly.
- CA registruje potřebu škálování přibližně po 30 sekundách.
- Jakmile uzel přestane být potřebný, CA ve výchozím nastavení čeká 10 minut, než začne škálovat systém.
- V systému automatického škálování existuje pojem rozšiřovače (expanders). To jsou různé strategie pro výběr skupiny uzlů, do které budou přidány nové.
- Odpovědně použijte možnost cluster-autoscaler.kubernetes.io/safe-to-evict (true). Pokud nastavíte mnoho podů nebo pokud budou mnohé z nich rozloženy po všech uzlech, výrazně ztratíte schopnost zmenšovat velikost clustera.
- Použijte , abyste zabránili odstraňování podů, což by mohlo způsobit, že část vaší aplikace by mohla úplně selhat.
Jak spolu systémy automatického škálování Kubernetes interagují
Pro ideální harmonii je třeba použít automatické škálování jak na úrovni podů (HPA/VPA), tak na úrovni clustera. Relativně snadno spolu interagují:
- HPA nebo VPA aktualizují repliky podů nebo prostředky přidělené existujícím podům.
- Pokud pro plánované škálování chybí uzly, CA si všimne, že pody jsou ve stavu čekání.
- CA přiděluje nové uzly.
- Pody jsou rozděleny mezi nové uzly.
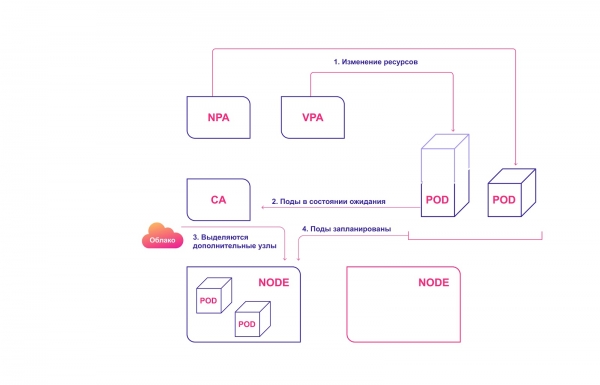
Společný systém automatického škálování Kubernetes
Typické chyby při automatickém škálování Kubernetes
Existuje několik typických problémů, se kterými se devops tým setkává, když se snaží aplikovat automatické škálování.
HPA a VPA závisí na metrikách a některých historických datech. Pokud je přiděleno nedostatečné množství prostředků, pody budou zredukovány a nebudou schopny generovat metriky. V takovém případě automatické škálování nikdy nenastane.
Samotná operace škálování je citlivá na čas. Chceme, aby se pody a cluster škálovaly rychle — než si uživatelé všimnou nějakých problémů a poruch. Proto je třeba vzít v úvahu průměrný čas škálování podů a clustera.
Ideální scénář — 4 minuty:
- 30 sekund. Aktualizace cílových metrik: 30–60 sekund.
- 30 sekund. HPA kontroluje hodnoty metrik: 30 sekund.
- Méně než 2 sekundy. Pody vytvořeny a přechází do stavu čekání: 1 sekunda.
- Méně než 2 sekundy. CA vidí čekající pody a posílá výzvy na přípravu uzlů: 1 sekunda.
- 3 minuty. Cloudový poskytovatel přiděluje uzly. K8s čeká, až budou připraveny: až 10 minut (závisí na několika faktorech).
Nejhorší (realističtější) scénář — 12 minut:
- 30 sekund. Aktualizace cílových metrik.
- 30 sekund. HPA kontroluje hodnoty metrik.
- Méně než 2 sekundy. Pod moduly jsou vytvořeny a přecházejí do stavu čekání.
- Méně než 2 sekundy. CA vidí čekající moduly a posílá požadavky na přípravu uzlů.
- 10 minut. Cloudový poskytovatel přiděluje uzly. K8s čeká, až budou připraveny. Doba čekání závisí na několika faktorech, jako jsou zpoždění poskytovatele, zpoždění OS a práce pomocných nástrojů.
Nezaměňujte mechanismy škálování cloudových poskytovatelů s naším CA. Ten pracuje uvnitř Kubernetes clusteru, zatímco mechanismus cloudového poskytovatele pracuje na základě distribuování uzlů. Nesleduje, co se děje s vašimi pod’y nebo aplikací. Tyto systémy fungují paralelně.
Jak spravovat škálování v Kubernetes
- Kubernetes je nástroj pro správu zdrojů a orchestraci. Operace správy pod’ů a zdrojů clusteru jsou klíčovým krokem v osvojení Kubernetes.
- Osvojte si logiku škálovatelnosti pod’ů s ohledem na HPA a VPA.
- CA by se měla používat pouze tehdy, pokud dobře rozumíte potřebám svých pod’ů a kontejnerů.
- Pro optimální nastavení clusteru je třeba pochopit, jak různé systémy škálování spolupracují.
- Při hodnocení doby škálování mějte na paměti nejhorší a nejlepší scénáře.
Zdroj: habr.com
