

Dobrý den, v předchozích článcích jsme se seznámili s prací nastavení ELK Stack. Teď se podíváme na možnosti, které může specialista na IT bezpečnost využít při práci s těmito systémy. Jaké logy je možné a třeba přenášet do ElasticSearch? Zjistíme, jaké statistiky můžeme získat nastavením dashboardů, a zda v tom existuje profit. Jakým způsobem lze implementovat automatizaci procesů IT bezpečnosti pomocí ELK stacku. Vytvoříme architekturu fungování systému. Celkově je realizace všech funkcí velmi rozsáhlý a náročný úkol, proto jsme oddělili jeho řešení pod jiným názvem - TS Total Sight.
V současnosti se stále více prosazují řešení, která konsolidují a analyzují incidenty IT bezpečnosti na jednom logickém místě, což specialistovi poskytuje statistiky a plán kroků ke zlepšení stavu IT bezpečnosti v organizaci. Tento úkol si klademe při používání ELK stacku a rozdělili jsme hlavní funkce do čtyř částí:
- Statistiky a vizualizace;
- Detekce incidentů IT bezpečnosti;
- Prioritizace incidentů;
- Automatizace procesů IT bezpečnosti.
Nyní se podrobněji podíváme na jednotlivé části.
Detekce incidentů IT bezpečnosti
Hlavním úkolem při použití ElasticSearch v našem případě je shromažďovat pouze incidenty IT bezpečnosti. Incidenty IT bezpečnosti lze shromažďovat z jakýchkoli ochranných prostředků, pokud podporují nějaké režimy odesílání logů, což je standardně syslog nebo ukládání do souboru přes SCP.
Můžeme uvést standardní příklady ochranných prostředků, z nichž je třeba nastavit odesílání logů:
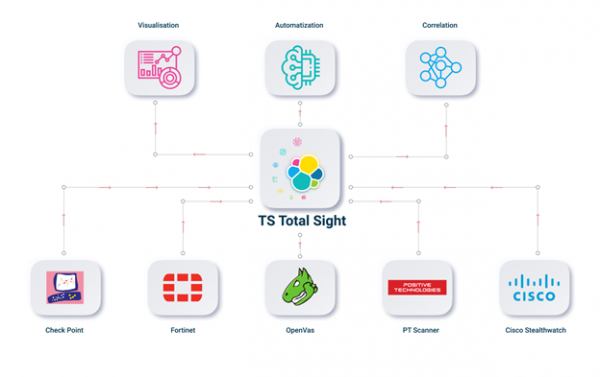
- Jakékoli prostředky NGFW (Check Point, Fortinet);
- Jakékoli skenery zranitelností (PT Scanner, OpenVas);
- Web Application Firewall (PT AF);
- Analyzátory netflow (Flowmon, Cisco StealthWatch);
- AD server.
Jakmile nastavíme odesílání logů a konfigurační soubory do Logstash, můžeme korelovat a porovnávat s incidenty pocházejícími z různých bezpečnostních prostředků. K tomu je vhodné použít indexy, ve kterých budeme uchovávat všechny incidenty vztahující se k určitému zařízení. Jinými slovy, jeden index se vztahuje ke všem incidentům jednoho zařízení. Tuto distribuci lze realizovat dvěma způsoby.
První varianta nastavení konfigurace Logstash. K tomu je potřeba duplikovat logy podle určitých polí do samostatné jednotky s jiným typem. A poté tuto jednotku v budoucnu používat. V příkladu se klonují logy podle IPS proxy firewallu Check Point.
filtr {
    pokud [produkt] == "SmartDefense" {
        klon {
	    klony => ["CloneSmartDefense"]
	    přidat_pole => {"systém" => "checkpoint"}
	}
    }
}
Pro ukládání takových událostí do samostatného indexu v závislosti na polích logů, například jako Destination IP signatury útoku, lze použít následující konstrukci:
výstup {
    pokud [typ] == "CloneSmartDefense"{
    {
         elasticsearch {
    	 servery => [",:9200"]
    	 index => "smartdefense-%{dst}"
    	 uživatel => "admin"
    	 heslo => "heslo"
  	 }
    }
}
A tímto způsobem je možné uložit do indexu všechny incidenty, například podle IP adresy nebo podle doménového jména stroje. V tomto případě ukládáme do indexu „smartdefense-%{dst}“, podle IP adresy hodnoty signatury.
Nicméně různé produkty budou mít různá pole pro logy, což povede k chaosu a nadměrnému využití paměti. A zde bude potřeba buď pečlivě v nastavení konfigurace Logstash nahradit pole předem zamýšlenými, které budou jednotná pro všechny typy incidentů, což je také složitý úkol.
Druhá varianta realizace — je napsat skript nebo proces, který bude v reálném čase přistupovat k databázi Elasticsearch, vybírat potřebné incidenty a ukládat je do nového indexu; to je obtížný úkol, ale umožňuje pracovat s logy dle potřeby a přímo korelovat s incidenty z dalších bezpečnostních nástrojů. Tato varianta umožňuje nastavit práci s logy maximálně užitečně pro váš případ s maximální flexibilitou, ale zde vzniká problém při hledání takového specialisty, který to umí realizovat.
A samozřejmě, nejdůležitější otázka, co vůbec lze korelovat a odhalit?
Zde může být několik variant a závisí na tom, jaké bezpečnostní nástroje jsou používány ve vaší infrastruktuře, pár příkladů:
- Nejvíce zřejmou a podle mého názoru nejzajímavější variantou pro ty, kteří mají řešení NGFW a skener zranitelností, je porovnání logů IPS a výsledků skenování zranitelností. Pokud byla detekována útok (nebyl zablokován) systémem IPS a tato zranitelnost nebyla uzavřena na koncovém zařízení na základě výsledků skenování — je třeba upozornit na tuto skutečnost, protože existuje vysoká pravděpodobnost, že byla zranitelnost zneužita.
- Mnoho pokusů o přihlášení z jednoho zařízení na různá místa může naznačovat škodlivou aktivitu.
- Stahování virusových souborů uživateli kvůli návštěvě velkého počtu potenciálně nebezpečných webů.
Statistika a vizualizace
Nejvíce zřejmé a srozumitelné, k čemu je ELK Stack — to je uchovávání a vizualizace logů, bylo ukázáno, jak lze importovat logy z různých zařízení pomocí Logstash. Jakmile logy putují do Elasticsearch, je možné nastavit dashboardy, o kterých jsme také hovořili , s informacemi a statistikami, které potřebujete prostřednictvím vizualizace.
Příklady:
- Dashboard pro události Threat Prevention s nejkritičtějšími událostmi. Zde lze zobrazit, jaké podpisy IPS byly detekovány a odkud geograficky pocházejí.
- Dashboard pro využití nejkritičtějších aplikací, z nichž mohou být uniklé informace.
- Výsledky skenování z jakéhokoli bezpečnostního skeneru.
- Logy z Active Directory podle uživatelů.
- Dashboard pro připojení VPN.
V tomto případě, pokud nastavíte dashboardy na aktualizaci každých několik sekund, můžete získat velmi pohodlný systém pro monitorování událostí v reálném čase, který lze poté využít pro rychlejší reakce na incidenty kybernetické bezpečnosti, pokud se dashboardy zobrazí na samostatném monitoru.
Prioritizace incidentů
V rámci rozsáhlé infrastruktury může počet incidentů dosáhnout vysokých hodnot, a specialisté nebudou schopni včas zpracovávat všechny incidenty. V takovém případě je nezbytné prioritizovat pouze ty incidenty, které představují větší hrozbu. Systém by proto měl řadit incidenty podle jejich nebezpečnosti vzhledem k vaší infrastruktuře. Doporučuje se nastavit upozornění na tyto události, a to buď na e-mail, nebo do Telegramu. Prioritizaci lze realizovat pomocí standardních nástrojů Kibana, nastavením vizualizace. S upozorněním je to složitější, tento funkční prvek není ve výchozí verzi Elasticsearch zahrnut, pouze v placené. Takže buďto zakoupit placenou verzi, nebo opět sami napsat proces, který bude v reálném čase informovat specialisty na e-mail nebo do Telegramu.
Automatizace procesů kybernetické bezpečnosti
Jednou z nejzajímavějších částí je automatizace akcí při incidentech kybernetické bezpečnosti. Tuto funkcionalitu jsme dříve implementovali pro Splunk, o podrobnostech si můžete přečíst zde . Hlavní myšlenka spočívá v tom, že politika IPS nikdy není kontrolována a optimalizována, přestože je v některých případech klíčovou částí procesů informační bezpečnosti. Například rok po zavedení NGFW, aniž by došlo k jakýmkoli akcím na optimalizaci IPS, se vám hromadí velké množství signatur s akcí Detect, které nebudou blokovány, což výrazně snižuje stav informační bezpečnosti v organizaci. Zde je několik příkladů toho, co lze automatizovat:
- Změna signatury IPS z Detect na Prevent. Pokud na kritické signatury nefunguje Prevent, je to problém a vážná slabina v systému ochrany. Změňte akci v politice pro tyto signatury. Tento funkční prvek lze realizovat, pokud zařízení NGFW disponuje funkcionalitou REST API. To je možné pouze pokud máte programátorské dovednosti, je potřeba vytáhnout potřebné informace z Elasticsearch a provést API dotazy na řídicím serveru NGFW.
- Pokud bylo z jednoho IP adresy v síťovém provozu detekováno nebo zablokováno mnoho signatur, má smysl dočasně zablokovat tuto IP adresu v politice firewallu. Realizace spočívá také ve využití REST API.
- Spustit kontrolu hostitele pomocí skeneru zranitelností, pokud na tento host připadá velké množství podpisů podle IPS nebo jiných bezpečnostních nástrojů; pokud se jedná o OpenVas, lze napsat skript, který se připojí přes ssh ke skeneru zabezpečení a spustí skenování.
TS Total Sight
Celková implementace všech funkcí je velmi rozsáhlý a náročný úkol. Bez znalostí programování lze nastavit minimální funkčnost, která může být dostatečná pro provoz v produkčním prostředí. Pokud vás zajímají všechny funkce, můžete se podívat na TS Total Sight. Podrobněji se můžete seznámit na našem . Výsledkem bude, že celá struktura práce a architektura budou vypadat následovně:
Závěr
Zkoumali jsme, co lze realizovat pomocí ELK Stack. V následujících článcích se zaměříme podrobněji na funkčnost TS Total Sight!
Tak sledujte aktualizace (, , , ), .
Zdroj: habr.com
