

Co byste cítili, kdyby jednoho krásného letního dne datové centrum s vaším vybavením vypadalo takto?
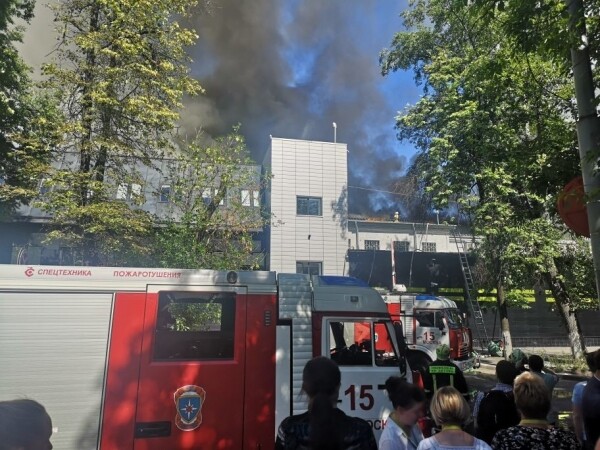
Ahoj všem! Jmenuji se Dmitrij Samsonov, pracuji jako vedoucí systémový administrátor v „“. Na fotografii je jedno ze čtyř datových center, kde je nainstalováno vybavení, které slouží našemu projektu. Za těmito zdmi se nachází přibližně 4 tisíce jednotek techniky: servery, systémy pro uložení dat, síťové vybavení atd. — téměř ⅓ celého našeho vybavení.
Většina serverů běží na Linuxu. Máme také několik desítek serverů na Windows (MS SQL) — naše dědictví, od kterého se postupně během mnoha let vzdáváme.
Dne 5. června 2019 v 14:35 informovali inženýři jednoho z našich datových center o požární alarmu.
Popření
14:45. Menší incidenty se zakouřením v datových centrech se stávají častěji, než se zdá. Parametry uvnitř sálů byly normální, proto naše první reakce byla relativně klidná: zakázali jsme práce s produkcí, tedy jakékoliv změny konfigurací, nasazování nových verzí atd., kromě oprav něčeho.
Hněv
Zkoušeli jste někdy zjistit od hasičů, kde přesně na střeše došlo k požáru, nebo se sami dostat na hořící střechu, abyste posoudili situaci? Jaká bude míra důvěry k informacím získaným skrze pět lidí?
14:50. Obdrželi jsme informace, že oheň se blíží k chladicímu systému. Ale dostane se tam? Hlavní systémový administrátor přesměrovává externí provoz z front tohoto datového centra.
V tuto chvíli jsou fronty všech našich služeb duplikovány ve třech datových centrech, používá se vyvážení na úrovni DNS, což umožňuje odstranit adresy jednoho datového centra z DNS, a tím ochránit uživatele před možnými problémy s přístupem k službám. V případě, že k problémům v datovém centru již došlo, automaticky vypadne z rotace. Více informací si můžete přečíst zde:
Požár nás zatím nijak neovlivnil — ani uživatelé, ani vybavení neutrpěli. Je to havárie? První část dokumentu „Plán postupů při havárii“ definuje pojem „Havárie“, a končí takto:
«Pokud existují pochybnosti, zda se jedná o havárii nebo ne, tak se jedná o havárii!»
14:53. Je přidělen koordinátor havárie.
Koordinátor je osoba, která řídí komunikaci mezi všemi účastníky, hodnotí rozsah havárie, používá „Akční plán pro havárie“, povolává potřebný personál, kontroluje dokončení oprav a především deleguje veškeré úkoly. Jinými slovy, je to osoba, která řídí celý proces likvidace havárie.
Obchod
15:01. Začínáme vypínat servery, které nejsou spojeny s produkcí.
15:03. Správně vypínáme všechny vyhrazené služby.
To zahrnuje nejen fronty (na které v tuto chvíli uživatelé nepřistupují) a jejich pomocné služby (obchodní logika, cache atd.), ale také různé databáze s replikací 2 a více (, , , a další).
15:06. Obdrželi jsme informaci, že požár ohrožuje jednu z místností datového centra. V této místnosti nemáme žádné zařízení, ale to, že oheň může přejít z střechy na místnosti, zásadně mění situaci.
(Později se ukázalo, že fyzické ohrožení pro místnost nebylo, protože je hermeticky uzavřena od střechy. Hrozba byla pouze pro chladicí systém této místnosti.)
15:07. Umožňujeme provádění příkazů na serverech v urychleném režimu bez dalších kontrol ().
15:08. Teplota v místnostech je v normě.
15:12. Bylo zaznamenáno zvýšení teploty v místnostech.
15:13. Více než polovina serverů v datovém centru je vypnuta. Pokračujeme.
15:16. Bylo přijato rozhodnutí o vypnutí veškerého zařízení.
15:21. Začínáme vypínat napájení na stateless serverech bez správného vypnutí aplikace a operačního systému.
15:23. Je vytvořena skupina odpovědných za MS SQL (je jich málo, závislost služeb na nich není velká, ale procedura obnovení funkčnosti trvá déle a je složitější než, například, u Cassandry).
Deprese
15:25. Obdrželi jsme informaci o vypnutí napájení ve čtyřech místnostech z 16 (č. 6, 7, 8, 9). V 7. a 8. místnosti je naše zařízení. O dalších dvou našich místnostech (č. 1 a 3) nemáme informace.
Obvykle při požárech se napájení ihned vypíná, ale v tomto případě, díky koordinované práci hasičů a technického personálu datového centra, nebylo vypnuto všude a okamžitě, ale podle potřeby.
(Později se ukázalo, že napájení v halách 8 a 9 nebylo vypnuto.)
15:28. Začínáme obnovovat databáze MS SQL ze záloh v jiných datových centrech.
Kolik času na to bude potřeba? Bude dostatečná propustnost sítě na celé trase?
15:37. Bylo zaznamenáno odpojení některých částí sítě.
Management a produkční síť jsou fyzicky izolovány. Pokud je produkční síť dostupná, můžete se přihlásit na server, zastavit aplikaci a vypnout OS. Pokud je nedostupná, lze se přihlásit přes IPMI, zastavit aplikaci a vypnout OS. Pokud není dostupná žádná ze sítí, nic nemůžete udělat. "Děkuji, kapitáne!", pomyslíte si.
"A vlastně, je to tu nějak moc chaosu," možná si také pomyslíte.
Všechno je v tom, že servery i bez požáru generují obrovské množství tepla. Přesněji řečeno, když je chlazení, generují teplo, a když není, vytvářejí peklo, které v lepším případě roztaví část vybavení a odpojí jinou část, a v horším... způsobí požár uvnitř haly, který prakticky zaručí zničení všeho.
15:39. Zaznamenáváme problémy s databází conf.
Databáze conf je backendem pro stejnojmennou službu, kterou používají všechny aplikace produkce pro okamžité změny nastavení. Bez této databáze nemůžeme řídit provoz portálu, ale samotný portál může fungovat.
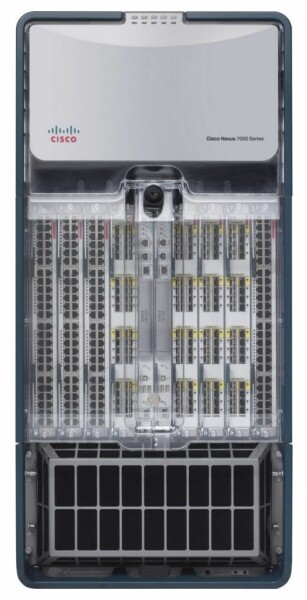
15:41. Teplotní senzory na Core síťovém zařízení zaznamenávají hodnoty blízké maximálním únosným limitům. Je to krabička zabírající celý stojan a zajišťující provoz všech sítí uvnitř datového centra.
15:42. Issue tracker a wiki nejsou dostupné, přepínáme se na záložní systém.
Toto není produkce, ale v případě havárie může být dostupnost jakékoliv znalostní báze kritická.
15:50. Odpojil se jeden z monitorovacích systémů.
Je jich několik a odpovídají za různé aspekty fungování služeb. Některé z nich jsou nastaveny na autonomní provoz uvnitř každého datového centra (tj. monitorují pouze svoje datové centrum), jiné se skládají z distribuovaných komponent, které bez problémů přežívají ztrátu jakéhokoli datového centra.
V tomto případě přestala fungovat , který funguje v režimu master-standby. Přepnuli jsme se na záložní systém.
Schválení
15:51. Přes IPMI jsme vypnuli všechny servery bez správného ukončení práce, kromě MS SQL.
Jste připraveni na hromadnou správu serverů přes IPMI v případě potřeby?
Ten pravý moment, kdy je záchrana hardwaru v datovém centru v tomto stádiu dokončena. Všechno, co bylo možné udělat, bylo uděláno. Někteří kolegové mohou odpočívat.
16:13. Byly hlášeny informace, že na střeše praskly trubky s freonem od klimatizací — to oddálí spuštění datového centra po odstranění požáru.
16:19. Podle údajů získaných od technického personálu datového centra přestalo stoupat teplotu v prostorách.
17:10. Obnovili jsme provoz databázového konfiguračního souboru. Nyní můžeme změnit nastavení aplikací.
Proč je to tak důležité, když je všechno redundantní a funguje to i bez jednoho datového centra?
Za prvé, ne vše je redundantní. Existují různé sekundární služby, které zatím nepřežívají výpadek datového centra dostatečně dobře, a existují databáze v režimu master-standby. Možnost spravovat nastavení umožňuje udělat vše potřebné, aby se i v obtížných podmínkách minimalizovaly následky havárie pro uživatele.
Za druhé, stalo se jasným, že v nejbližších hodinách nebude provoz datového centra zcela obnoven, proto bylo nutné přijmout opatření, aby dlouhodobá nedostupnost replik nevedla k dalším nepříjemnostem, jako je přetížení disků v zbývajících datových centrech.
17:29. Čas na pizzu! Máme tu lidi, ne roboty.
Rehabilitace
18:02. V prostorách č. 8 (naše), 9, 10 a 11 se stabilizovala teplota. V jedné z těch, které zůstávají odpojené (č. 7), se nachází naše vybavení a teplota tam pokračuje v růstu.
18:31. Dali jsme zelenou k spuštění zařízení v prostorách č. 1 a 3 — tyto prostory požár nezasáhl.
V tuto chvíli probíhá spuštění serverů v prostorách č. 1, 3, 8, začínáme s těmi nejkritičtějšími. Kontroluje se správnost fungování všech spuštěných služeb. Problémy stále přetrvávají v prostoru č. 7.
18:44. Technický personál datového centra zjistil, že v prostoru č. 7 (kde je jen naše zařízení) není mnoho serverů vypnuto. Podle našich údajů zde zůstává zapnuto 26 serverů. Po opětovné kontrole objevujeme 58 serverů.
20:18. Technický personál datového centra provádí ventilaci vzduchu v prostoru bez klimatizací pomocí mobilních vzduchovodů, které jsou položeny přes chodby.
23:08. Prvního administrátora jsme poslali domů. Někdo musí přes noc spát, aby zítra mohl pokračovat v práci. Další část administrátorů a vývojářů nyní také odchází.
02:56. Spustili jsme všechno, co šlo spustit. Provádíme rozsáhlou kontrolu všech služeb automatickými testy.
03:02. Klimatizace v posledním, 7. sálu byla obnovena.
03:36. Spustili jsme fronty v datovém centru do rotace v DNS. Od tohoto okamžiku začíná přicházet uživatelský provoz.
Odvoláváme většinu týmu administrátorů domů. Několik lidí však zůstává.
Malý FAQ:
Q: Co se dělo od 18:31 do 02:56?
A: Podle "Plánu akcí v případě havárie" spouštíme všechny služby, počínaje těmi nejdůležitějšími. Přitom koordinátor v chatu přiděluje službu volnému administrátorovi, který kontroluje, zda se OS a aplikace spustily, zda nejsou chyby a zda jsou hodnoty v normě. Po dokončení spuštění hlásí v chatu, že je volný, a dostává od koordinátora novou službu.
Proces je navíc zpomalen vadným železem. I když zastavení OS a vypnutí serverů proběhlo správně, část serverů se nevrací kvůli náhle selhaným diskům, paměti nebo šasi. Při ztrátě napájení se procento selhání zvyšuje.
Q: Proč není možné všechno spustit najednou a pak opravit to, co se objeví v monitoringu?
A: Všechno je třeba dělat postupně, protože mezi službami existují závislosti. A vše je třeba kontrolovat okamžitě, aniž bychom čekali na monitoring — protože s problémy je lepší se vypořádat hned a nečekat, až se zhorší.
7:40. Poslední administrátor (koordinátor) odešel spát. Práce prvního dne byly dokončeny.
8:09. První vývojáři, inženýři v datových centrech a administrátoři (včetně nového koordinátora) zahájili obnovovací práce.
09:37. Začali jsme zvedat sál č. 7 (poslední).
Současně pokračujeme v obnově toho, co jsme nedokončili v jiných sálech: výměna disků/paměti/serverů, oprava všeho, co "hoří" v monitoringu, zpětné přepínání rolí v schématech master-standby a další drobnosti, kterých je však dostatek.
17:08. Umožňujeme všechny plánované práce s produkcí.
21:45. Práce druhého dne byly dokončeny.
09:45. Dnes je pátek. V monitoringu stále přetrvává poměrně hodně drobných problémů. Před námi jsou víkendy, všichni si chtějí odpočinout. Pokračujeme masivně opravovat vše, co je možné. Administrativní úkoly, které bylo možné odložit, byly odloženy. Je tu nový koordinátor.
15:40. Nečekaně restartovala polovina stacku Core síťového vybavení v JINÉM datovém centru. Vyřadili jsme fronty z rotace, abychom minimalizovali rizika. Pro uživatele to nemělo žádný vliv. Později se ukázalo, že to bylo chybnou šasi. Koordinátor pracuje na opravě rovnou dvou havárií.
17:17. Práce sítě v jiném datovém centru byla obnovena, vše bylo zkontrolováno. Datové centrum bylo zařazeno do rotace.
18:29. Práce třetího dne a obecně obnova po havárii byla dokončena.
Poznámka na závěr
04.04.2013, , „Odnoklassniki“ — během tří dnů byl portál zcela nebo částečně nedostupný. Po celou tuto dobu více než 100 lidí z různých měst, z různých společností (ještě jednou velké díky!), opravovalo tisíce serverů vzdáleně i přímo v datových centrech, ručně a automaticky.
Vyvodili jsme závěry. Aby se podobné situace neopakovaly, provedli jsme a pokračujeme v rozsáhlých pracích.
Jaké jsou hlavní rozdíly mezi současnou havárií a 404?
- Máme „Plán akcí v případě havárie“. Každý čtvrtletí provádíme cvičení — simuluje se havarijní situace, kterou skupina administrátorů (každý postupně) musí odstranit podle „Plánu akcí v případě havárie“. Vedení systémových administrátorů postupně hraje roli koordinátora.
- Každé čtvrtletí v testovacím režimu izolujeme datová centra (všechna postupně) po síti LAN a WAN, což umožňuje včas odhalit slabá místa.
- Méně poškozených disků, protože jsme zpřísnili normy: méně hodin provozu, přísnější prahové hodnoty pro S.M.A.R.T.
- Zcela jsme opustili BerkeleyDB — starou a nestabilní databázi, která vyžadovala hodně času na obnovu po restartu serveru.
- Snížili jsme počet serverů s MS SQL a omezili závislost na zbývajících.
- Máme vlastní , do kterého již po dobu dvou let aktivně migrujeme všechny služby. Cloud výrazně usnadňuje celý cyklus práce s aplikací a v případě havárie poskytuje unikátní nástroje, jako jsou:
- jednoduché zastavení všech aplikací jedním kliknutím;
- snadná migrace aplikací ze selhaných serverů;
- automatické spuštění celého datacentra podle priority služeb.
Nehoda popsaná v tomto článku se stala největší od 404. Dalo by se říci, že ne všechno probíhalo hladce. Například během nedostupnosti postiženého datacentra se v jiném datacentru porouchal disk na jednom ze serverů, takže zůstala dostupná pouze jedna ze tří replik v Cassandra clusteru, což způsobilo, že 4,2 % uživatelů mobilních aplikací se nemohlo přihlásit. Přitom již připojení uživatelé pokračovali v práci. Celkově bylo během nehody zjištěno více než 30 problémů — od běžných chyb až po nedostatky v architektuře služeb.
Největším rozdílem mezi současnou nehodou a 404. je to, že zatímco jsme odstraňovali následky požáru, uživatelé se stále komunikovali a videohovorili v , hráli hry, poslouchali hudbu, posílali si dárky, sledovali videa, seriály a televizní kanály v , a také streamovali na .
Jak probíhají vaše havárie?
Zdroj: habr.com
