

Krátké úvodní slovo
Domnívám se, že bychom mohli vykonat větší množství úkolů, pokud by nám byly poskytnuty podrobné návody, které by nám řekly, co a jak dělat. Sám si vzpomínám na chvíle, kdy jsem nemohl začít s něčím novým, protože bylo obtížné pochopit, kde začít. Možná jsi kdysi na internetu viděl termín „Data Science“ a myslel si, že je to něco, co se tě netýká, a lidé, kteří se tím zabývají, jsou někde daleko. Ale není to tak, jsou tady. A díky lidem z této oblasti se ti do feedu dostala článek. Existuje spousta kurzů, které ti pomohou ovládnout toto řemeslo, a já ti pomohu udělat první krok.
Tak co, jsi připraven? Hned říkám, že budeš potřebovat znát Python 3, protože právě ten budu používat. Také doporučuji předem nainstalovat Jupyter Notebook nebo se podívat, jak používat Google Colab.
Krok první
Kaggle je tvůj významný pomocník v této záležitosti. V zásadě se bez něj obejdeš, ale o tom si povíme v jiném článku. To je taková platforma, kde se konají soutěže v oblasti Data Science. V každé takové soutěži na začátku získáš neuvěřitelné množství zkušeností s řešením různých úloh, vývoje a práce v týmu, což je dnes velmi důležité.
Naši úlohu vezmeme odtud. Jmenuje se: „Titanic“. Podmínka je taková: předpovědět, zda každý jednotlivý člověk přežije. Obecně řečeno, úkolem člověka, který se zabývá DS, je sběr dat, jejich zpracování, učení modelu, předpověď a tak dále. Na Kaggle nám umožňují přeskočit fázi sběru dat — jsou přítomna na platformě. Musíme je nahrát a můžeme začít pracovat!
To lze udělat následujícím způsobem:
v záložce Data jsou soubory, které obsahují data


Data jsme nahráli, připravili jsme si naše Jupyter sešity a…
Krok druhý
Jak nyní nahrajeme tato data?
Za prvé, importujeme potřebné knihovny:
import pandas as pd
import numpy as np
Pandas nám umožní načíst .csv soubory pro následné zpracování.
Numpy je potřeba proto, aby naše datová tabulka byla představena jako matice čísel.
Pokračujeme dále. Vezmeme soubor train.csv a nahrajeme ho k nám:
dataset = pd.read_csv('train.csv')
Budeme se odkazovat na naši vzorkovou datovou sadu train.csv prostřednictvím proměnné dataset. Podívejme se, co tam máme:
dataset.head()
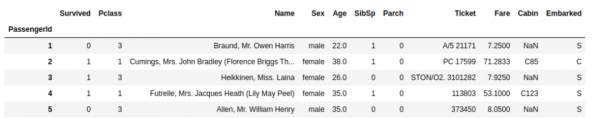
Funkce head() nám umožňuje zobrazit první několik řádků datového rámce.
Sloupec Survived je to, co naše výsledky v tomto datovém rámci ukazují. V rámci úlohy musíme předpovědět sloupec Survived pro data test.csv. Tato data obsahují informace o dalších pasažérech Titaniku, pro které nejsou výsledky známé.
Takže rozdělíme naši tabulku na závislé a nezávislé údaje. Tady je to jednoduché. Závislé údaje jsou ty, které závisí na nezávislých — to, co je obsaženo v výsledcích. Nezávislé údaje jsou ty, které ovlivňují výsledek.
Například máme takovou datovou sadu:
"Vova se učil informatiku — ne.
Vova dostal z informatiky 2."
Hodnocení z informatiky závisí na odpovědi na otázku: učil se Vova informatiku? Rozumíš? Pokračujeme, už jsme blíž k cíli!
Tradiční proměnná pro nezávislé údaje je X. Pro závislé — y.
Děláme následující:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Co to je? Funkcí iloc[:, 2: ] říkáme pythonu: chci vidět v proměnné X data, začínající od druhého sloupce (včetně, za předpokladu, že počítání začíná od nuly). V druhém řádku říkáme, že chceme vidět v y data z prvního sloupce.
[ a:b, c:d ] — to je konstrukce, kterou používáme v závorkách. Pokud neuvádíme nějaké proměnné, zůstanou výchozí. To znamená, že můžeme uvést [:,: d] a potom dostaneme v datovém rámci všechny sloupce kromě těch, které začínají od čísla d a dál. Proměnné a a b určují řádky, ale ty potřebujeme všechny, proto to necháváme jako výchozí.
Podívejme se, co jsme dostali:
X.head() 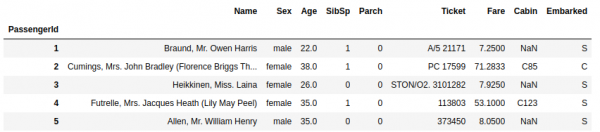
y.head() 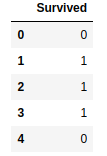
Abychom zjednodušili tuto krátkou lekci, odstraníme sloupce, které vyžadují zvláštní "péči", nebo vůbec neovlivňují přežití. Obsahují údaje typu str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Jdeme k dalšímu kroku.
Krok třetí
Zde potřebujeme kódovat naše data, aby stroj lépe rozuměl, jak tato data ovlivňují výsledek. Ale kódovat nebudeme všechna, pouze data typu str, která jsme nechali. Sloupec „Sex“. Jak chceme kódovat? Představme si údaje o pohlaví člověka jako vektor: 10 — mužské pohlaví, 01 — ženské pohlaví.
Nejprve převedeme naše tabulky na matici NumPy:
X = np.array(X)
y = np.array(y)
A teď se podíváme:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Knihovna sklearn je skvělá knihovna, která nám umožňuje provádět kompletní práci v oblasti Data Science. Obsahuje velké množství zajímavých modelů strojového učení a také nám umožňuje se zabývat přípravou dat.
OneHotEncoder nám umožní zakódovat pohlaví člověka v tom zobrazení, jak jsme popsali. Vytvoří se 2 třídy: mužská, ženská. Pokud je člověk muž, do sloupce „mužská“ bude zapsáno 1 a do „ženská“, příslušně 0.
Po OneHotEncoder() stojí [1] — to znamená, že chceme zakódovat sloupec číslo 1 (počítáno od nuly).
Super. Posouváme se dál!
Obvykle se stává, že některá data zůstanou nezaplněná (to znamená NaN — not a number). Například máme informace o osobě: její jméno, pohlaví. Ale chybí nám údaje o jejím věku. V takovém případě použijeme následující metodu: najdeme aritmetický průměr ve všech sloupcích a pokud nějaké údaje v sloupci chybí, vyplníme prázdné místo aritmetickým průměrem.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
A teď vezmeme v úvahu, že existují situace, kdy jsou data velmi nesourodá. Některá data se nacházejí v intervalu [0:1], zatímco jiná mohou být ve stovkách a tisících. Abychom vyloučili takový rozptyl a aby byl počítač přesnější ve výpočtech, provedeme škálování dat, normalizaci. Nechť všechna čísla nepřesahují tři. K tomu použijeme funkci StandardScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Nyní naše data vypadají takto:

Skvělé. Jsme už blízko našemu cíli!
Krok čtvrtý
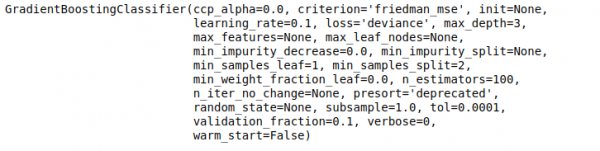
Naučíme se naši první model! Z knihovny sklearn můžeme nalézt obrovské množství zajímavostí. Aplikoval jsem na tuto úlohu model Gradient Boosting Classifier. Používáme klasifikátor, protože naším úkolem je klasifikace. Musíme předpovědět, zda patří k 1 (přežil) nebo 0 (nepřežil).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Funkce fit říká Pythonu: Nech model hledat závislosti mezi X a y.
Méně než sekundu a model je hotový.
Jak jej použít? Teď se na to podíváme!
Krok pátý. Závěr
Nyní potřebujeme načíst tabulku s našimi testovacími daty, pro která je třeba provést předpověď. S touto tabulkou provedeme všechny stejné kroky, které jsme udělali pro X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Aplikujeme už náš model!
gbc_predict = gbc.predict(X_test)
Hotovo. Vytvořili jsme předpověď. Nyní ji musíme uložit do csv a nahrát na web.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Hotovo. Získali jsme soubor, který obsahuje předpovědi pro každého pasažéra. Teď zbývá nahrát tato řešení na web a získat hodnocení předpovědi. Takové primitivní řešení dává nejen 74 % správných odpovědí na veřejnosti, ale také určitý stimul v oblasti Data Science. Nejdůvěřivější mi mohou kdykoli napsat do soukromých zpráv a položit otázku. Děkuji všem!
Zdroj: habr.com
