

Ahoj, Habr!
Vzhledem k současným událostem způsobeným koronavirem začalo několik internetových služeb zažívat zvýšenou zátěž. Například, , protože jim došly kapacity. A ne vždy je možné zrychlit server jednoduše přidáním výkonnějšího hardwaru, nicméně je třeba zpracovávat požadavky zákazníků (jinak odejdou ke konkurenci).
V tomto článku krátce popíšu populární praktiky, které umožní vytvořit rychlou a odolnou službu. Nicméně jsem vybral pouze ty vývojové schémata, které jsou v současnosti snadno dostupné.Pro každý bod už máte buď hotové knihovny, nebo možnost vyřešit úkol pomocí cloudové platformy.
Horizontální škálování
Nejjednodušší a všem známý bod. Obvykle se nejčastěji setkáváme se dvěma schématy rozdělení zátěže — horizontálním a vertikálním škálováním. dovolujete službám pracovat paralelně, čímž rozdělujete zátěž mezi nimi. objednáváte výkonnější servery nebo optimalizujete kód.
Jako příklad vezmu abstraktní cloudové úložiště souborů, tedy určitý analog OwnCloud, OneDrive a tak dále.
Standardní obrázek podobného schématu je níže, nicméně pouze demonstruje složitost systému. Protože musíme nějak synchronizovat služby. Co se stane, pokud uživatel uloží soubor z tabletu a pak ho chce zobrazit na mobilu?
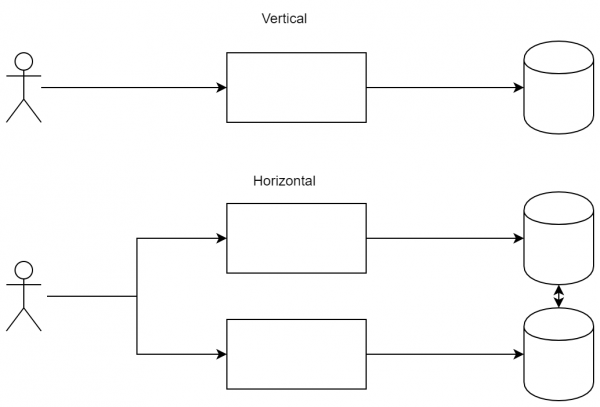
Rozdíl mezi přístupy: u vertikálního škálování jsme připraveni zvyšovat výkon uzlů, zatímco u horizontálního — přidávat nové uzly pro rozdělení zátěže.
CQRS
je docela důležitý vzor, protože umožňuje různým klientům nejen připojit se k různým službám, ale také dostávat stejné proudy událostí. Jeho výhody nejsou tak zřejmé pro jednoduchou aplikaci, nicméně je nesmírně důležitý (a jednoduchý) pro zatížené služby. Jeho podstata spočívá v tom, že příchozí a odchozí toky dat se nesmí překrývat. To znamená, že nemůžete poslat požadavek a očekávat odpověď, místo toho posíláte požadavek do služby A, ale odpověď dostáváte ve službě B.
První výhodou tohoto přístupu je možnost přerušení spojení (v širokém smyslu tohoto slova) během provádění dlouhého dotazu. Jako příklad zvažme více méně standardní sekvenci:
- Klient odeslal dotaz na server.
- Server zahájil dlouhé zpracování.
- Server odpověděl klientovi výsledkem.
Představme si, že v bodě 2 došlo k přerušení spojení (nebo se síť přeconnectovala, nebo uživatel přešel na jinou stránku a přerušil spojení). V takovém případě by bylo serveru obtížné poslat odpověď uživateli s informací, co bylo právě zpracováno. Aplikací CQRS bude sekvence trochu jiná:
- Klient se přihlásil k odběru aktualizací.
- Klient odeslal dotaz na server.
- Server odpověděl 'požadavek přijat'.
- Server odpověděl výsledkem prostřednictvím kanálu z bodu '1'.
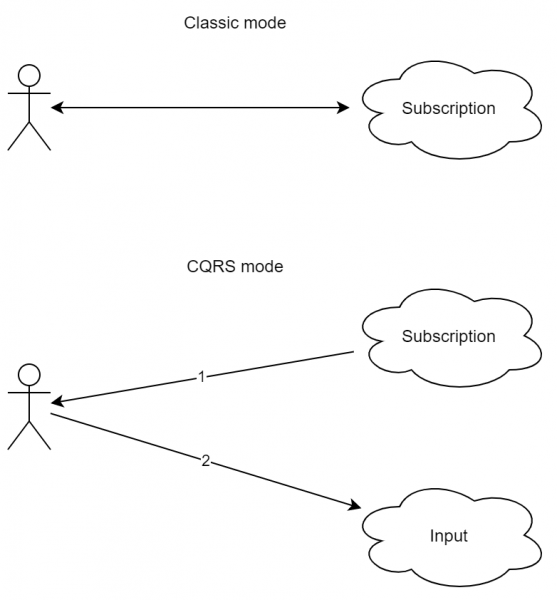
Jak vidno, schéma je o něco složitější. Navíc intuitivní přístup request-response zde chybí. Nicméně jak vidno, přerušení spojení během zpracování dotazu nepovede k chybě. Co více, pokud je uživatel skutečně připojen k službě z více zařízení (například z mobilního telefonu a tabletu), lze zajistit, aby odpověď přišla na obě zařízení.
Co je zajímavé, kód zpracování příchozích zpráv se stává stejným (ne na 100 %) jak pro události, na které měl vliv sám klient, tak pro ostatní události, včetně těch od jiných klientů.
V reálu však získáváme další výhody díky tomu, že jednosměrný tok lze zpracovávat funkcionálním stylem (používající RX a analogie). A to už je vážný plus, protože v podstatě lze aplikaci udělat zcela reaktivní, navíc s implementací funkcionálního přístupu. Pro robustní aplikace to může výrazně ušetřit zdroje na vývoj a údržbu.
Pokud tento přístup spojíme s horizontálním škálováním, získáváme možnost odesílat dotazy na jeden server, ale přijímat odpovědi od jiného. Tímto způsobem si klient může sám vybrat pohodlnou službu a systém uvnitř si stejně dokáže správně zpracovat události.
Event Sourcing
Jak víte, jednou z hlavních vlastností distribuovaných systémů je absence společného času a společné kritické sekce. Pro jeden proces můžete udělat synchronizaci (na stejných mutexech), během níž máte jistotu, že nikdo jiný tento kód nevykonává. Avšak pro distribuovaný systém je to nebezpečné, protože by to přineslo náklady na synchronizaci a zároveň by se zabil celý půvab škálovatelnosti — všechny komponenty by přesto čekaly na jednu.
Odtud získáváme důležitý fakt — rychlý distribuovaný systém nelze synchronizovat, protože bychom tím snížili výkon. Na druhou stranu, často potřebujeme určitou konzistenci komponent. A k tomu lze použít přístup s , kde je zaručeno, že v případě absence změn dat po určitém časovém období od poslední aktualizace („v konečném důsledku“) budou všechny požadavky vracet poslední aktualizovanou hodnotu.
Je důležité chápat, že pro klasické databáze se často používá , kde každý uzel má stejné informace (toho se často dosahuje v situaci, kdy je transakce považována za dokončenou až po odpovědi druhého serveru). Zde existují určité úlevy z důvodu úrovní izolace, nicméně celková podstata zůstává stejná — můžete žít v plně konzistentním světě.
Ale vraťme se k původnímu úkolu. Pokud může být část systému postavena s , lze postavit následující schéma.
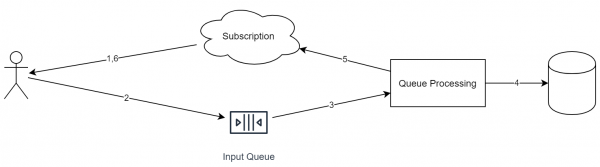
Hlavní rysy tohoto přístupu:
- Každý příchozí požadavek je umístěn do jedné fronty.
- Během zpracování požadavku může služba také umístit úkoly do jiných front.
- Každá příchozí událost má identifikátor (který je potřebný pro deduplikaci).
- Fronta ideologicky funguje na principu "append only". Z ní nelze odstraňovat prvky nebo je přemisťovat.
- Fronta pracuje podle schématu FIFO (omlouvám se za tautologii). Pokud je nutné provést paralelní zpracování, je třeba v jednom z kroků přesunout objekty do různých front.
Připomínám, že zvažujeme případ online úložiště souborů. V tomto případě bude systém vypadat přibližně takto:
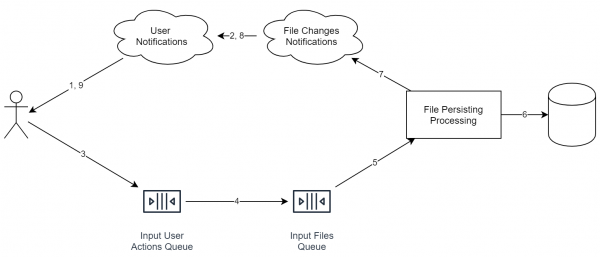
Je důležité si uvědomit, že služby v diagramu nemusí nutně znamenat samostatný server. I proces může být stejný. Důležité je něco jiného: ideologicky jsou tyto věci rozděleny tak, aby bylo možné snadno uplatnit horizontální škálování.
A pro dva uživatele bude schéma vypadat takto (služby určené různým uživatelům jsou označeny různými barvami):
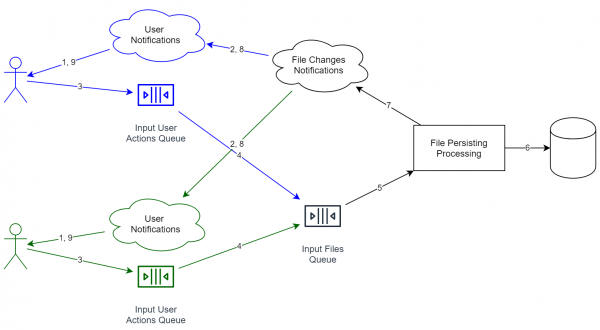
Výhody takové kombinace:
- Služby zpracování informací jsou rozděleny. Fronty jsou také rozděleny. Pokud budeme potřebovat zvýšit propustnost systému, stačí spustit více služeb na větším počtu serverů.
- Když dostaneme informace od uživatele, nemusíme se nutně dočkat úplného uloženía dat. Naopak, stačí odpovědět "ok" a potom postupně začít pracovat. Fronta zároveň vyhlazuje špičky, protože přidání nového objektu probíhá rychle a uživatel nemusí čekat na úplné projití celým cyklem.
- Pro příklad jsem přidal službu deduplikace, která se snaží spojit stejné soubory. Pokud pracuje dlouho v 1 % případů, klient toho téměř nezaznamená (viz výše), což je velké plus, protože od nás už není vyžadována stoprocentní rychlost a spolehlivost.
Nicméně okamžitě jsou viditelné i nevýhody:
- Naše systém ztratil přísnou konzistenci. To znamená, že pokud se například přihlásíte k různým službám, teoreticky můžete získat různé stavy (protože jedna ze služeb může mít problém přijmout oznámení z interní fronty). Jako další důsledek, systém nyní nemá společný čas. To znamená, že nelze například třídit všechny události jednoduše podle času příchodu, protože hodiny mezi servery nemusí být synchronizované (navíc stejné časové údaje na dvou serverech jsou utopie).
- Žádné události nelze nyní jednoduše vrátit zpět (jak by to bylo možné udělat s databází). Místo toho je nutné přidat novou událost — , která změní poslední stav na potřebný. Jako příklad z podobné oblasti: bez přepsání historie (což je špatně v určitých případech) nelze v gitu vrátit commit, ale lze provést speciální , který v podstatě jen vrátí starý stav. V historii však zůstane jak chybný commit, tak rollback.
- Datová schéma se může měnit z verze na verzi, avšak staré události již není možné aktualizovat na nový standard (protože události se obecně nemohou měnit).
Jak je vidět, Event Sourcing se výborně kombinuje s CQRS. Navíc, realizovat systém s efektivními a pohodlnými frontami, ale bez oddělení toků dat, je samo o sobě složité, neboť bude nutné přidávat synchronizační body, které vyrovnají veškerý pozitivní efekt front. Při použití obou přístupů najednou je třeba mírně upravit kód práce programu. V našem případě, při odesílání souboru na server, se v odpovědi objevuje pouze „ok“, což znamená, že „operace přidání souboru byla uložena“. Formálně to neznamená, že data jsou již dostupná na jiných zařízeních (například služba deduplikace může přestavět index). Nicméně po nějakém čase dostane klient oznámení ve stylu „soubor X byl uložen“.
A jako výsledek:
- Počet stavů odesílání souborů se zvyšuje: místo klasického „soubor byl odeslán“ máme nyní dva: „soubor byl přidán do fronty na serveru“ a „soubor byl uložen ve skladu“. To poslední znamená, že ostatní zařízení již mohou začít soubor přijímat (s ohledem na to, že fronty pracují různou rychlostí).
- Vzhledem k tomu, že informace o odesílání nyní přichází různými kanály, musíme vymýšlet řešení, jak získat stav zpracování souboru. Důsledkem toho je: na rozdíl od klasického request-response může být klient restartován během zpracování souboru, nicméně stav této zpracování bude správný. Tento bod funguje vlastně „z krabice“. V důsledku toho jsme nyní tolerantnější k chybám.
Sharding
Jak již bylo zmíněno výše, v systémech s event sourcing neexistuje přísná konzistence. To znamená, že můžeme používat několik úložišť bez jakékoliv synchronizace mezi nimi. Přibližujeme se k našemu úkolu, můžeme:
- Rozdělovat soubory podle typů. Například obrázky/videa lze dekódovat a vybrat efektivnější formát.
- Rozdělení účtů podle zemí. Z důvodu mnoha zákonů může být něco takového nezbytné, avšak tato architektonická schéma tuto možnost nabízí automaticky.
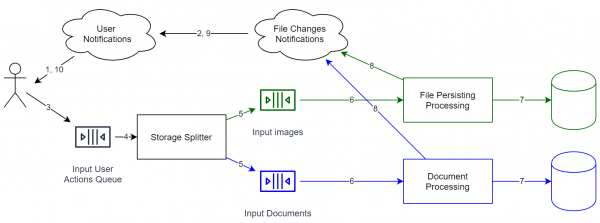
Pokud chcete přenést data z jednoho úložiště do druhého, již nestačí standardní prostředky. Bohužel je v takovém případě nutné zastavit frontu, provést migraci a poté ji znovu spustit. Obecně vzato, data nelze přesunout 'za běhu', nicméně pokud jsou události ve frontě uloženy kompletně a máte snapshoty předchozích stavů úložiště, můžeme události opakovat následujícím způsobem:
- V Event Source každá událost má své vlastní identifikační číslo (ideálně se nezmenšující). A proto můžeme do úložiště přidat pole – id posledního zpracovaného prvku.
- Duplikuji frontu, aby všechny události mohly být zpracovány pro několik nezávislých úložišť (první je to, ve kterém jsou již nyní uložena data, a druhé je nové, zatím prázdné). Druhá fronta je samozřejmě zatím nezpracovávána.
- Spouštíme druhou frontu (to znamená začínáme opakovat události).
- Když bude nová fronta relativně prázdná (tj. průměrný časový rozdíl mezi přidáním prvku a jeho vyjmutím bude přijatelný), můžeme začít přepínat čtenáře na nové úložiště.
Jak je vidět, v našem systému jak nebyla, tak ani není přísná konzistence. Existuje pouze eventual consistency, tedy záruka, že události jsou zpracovávány ve stejném pořadí (ale možná s různou latencí). A využitím toho můžeme relativně snadno přesunout data bez zastavení systému na druhou stranu světa.
Takže, pokračující v našem příkladu online úložiště pro soubory, taková architektura nám již poskytuje celou řadu výhod:
- Můžeme přesouvat objekty blíže k uživatelům, a to dynamickým způsobem. Tímto způsobem lze zvýšit kvalitu služby.
- Můžeme uchovávat část dat uvnitř firem. Například uživatelé Enterprise často požadují uchovávat svá data v kontrolovaných datových centrech (aby se předešlo únikům dat). Díky sharding se nám to může snadno podporovat. Úkol je ještě snadnější, pokud má zákazník kompatibilní cloud (například, ).
- A to nejdůležitější je, že to nemusíme dělat. Pro začátek nám totiž stačí jedno úložiště pro všechny účty (abychom mohli rychle začít pracovat). Klíčovou vlastností tohoto systému je, že ačkoliv je rozšiřitelný, v počátečním stádiu je dostatečně jednoduchý. Není nutné ihned psát kód, který pracuje s milionem samostatných nezávislých front atd. Pokud to bude potřeba, lze to udělat v budoucnu.
Hosting statického obsahu
Tento bod se může zdát docela zřejmý, ale přesto je nezbytný pro více či méně standardní zatíženou aplikaci. Jeho podstata je jednoduchá: veškerý statický obsah je distribuován ne z toho samého serveru, kde se nachází aplikace, ale ze speciálně vyhrazených serverů. V důsledku toho jsou tyto operace prováděny rychleji (konvenční nginx dodává soubory rychleji a s menšími náklady než Java server). Navíc architektura CDN () umožňuje umístit naše soubory blíže k koncovým uživatelům, což pozitivně ovlivňuje pohodlí při používání služby.
Nejjednodušší a standardní příklad statického obsahu jsou skripty a obrázky pro web. S nimi je vše jasné - jsou známy předem, poté se archiv nahrává na servery CDN, odkud jsou distribuovány koncovým uživatelům.
Ve skutečnosti však pro statický obsah lze aplikovat přístup podobný lambda architektuře. Vraťme se k našemu úkolu (online úložiště souborů), v němž je třeba distribuovat soubory uživatelům. Nejjednodušší řešení v tomto případě je vytvořit službu, která pro každý požadavek uživatele provede všechny potřebné kontroly (autorizace atd.) a poté stáhne soubor přímo z našeho úložiště. Hlavní nevýhodou takového přístupu je, že statický obsah (a soubor s určitou revizí je v podstatě statický obsah) je distribuován stejným serverem, který obsahuje obchodní logiku. Místo toho je možné vytvořit následující schéma:
- Server vygeneruje URL pro stažení. Může mít formát file_id + key, kde key je mini-cyfrový podpis, který dává právo na přístup k prostředku na následujících 24 hodin.
- O soubor se stará jednoduchý nginx s následujícími možnostmi:
- Uložení obsahu do mezipaměti. Vzhledem k tomu, že tato služba může být umístěna na odděleném serveru, ponechali jsme si prostor do budoucna s možností ukládat všechny poslední stažené soubory na disku.
- Kontrola klíče v okamžiku navázání spojení
- Volitelně: streamování obsahu. Například, pokud ve službě komprimujeme všechny soubory, můžeme provést jejich dekompresi přímo v tomto modulu. V důsledku toho: IO operace se provádějí tam, kde mají největší smysl. Archivátor napsaný v Javě bude snadno spotřebovávat nadměrné množství paměti, nicméně přepisování služby s obchodní logikou do jazyků jako Rust/C++ může ukázat také jako neefektivní. V našem případě se používají různé procesy (nebo dokonce služby), což umožňuje efektivně oddělit obchodní logiku a IO operace.
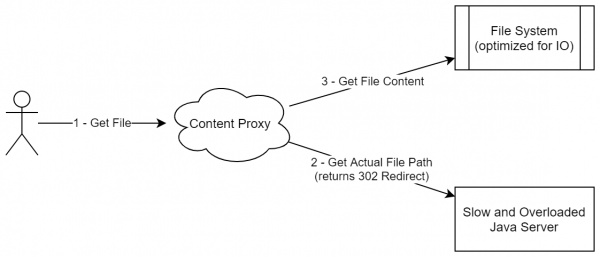
Tento model se nezdá být příliš podobný distribuci statického obsahu (protože nevysíláme celý balíček statiky někam), avšak ve skutečnosti takový přístup se skutečně zabývá distribucí neměnných dat. Více než to, tento model lze zobecnit i na jiné situace, kdy obsah není pouze statický, ale může být reprezentován jako soubor neměnných a neodstranitelných bloků (i když mohou být přidávány).
Jako další příklad (pro upevnění): pokud jste pracovali s Jenkins/TeamCity, víte, že obě řešení jsou napsána v Javě. Oba představují Java proces, který se věnuje jak orchestraci buildů, tak správě obsahu. Konkrétně mají oba úkoly typu 'přenést soubor/složku ze serveru'. Například: dodání artefaktů, přenos zdrojového kódu (když agent nestahuje kód přímo z repozitáře, ale server to dělá za něj), přístup k logům. Všechny tyto úkoly se liší zátěží IO. To znamená, že server odpovědný za složitou obchodní logiku by měl být také schopen efektivně protlačovat velké objemy dat. A co je nejzajímavější, takovou operaci lze delegovat stejnému nginxu stejným způsobem (jen je třeba do požadavku přidat klíč dat).
Ale pokud se vrátíme k našemu systému, dostaneme takovou schéma:
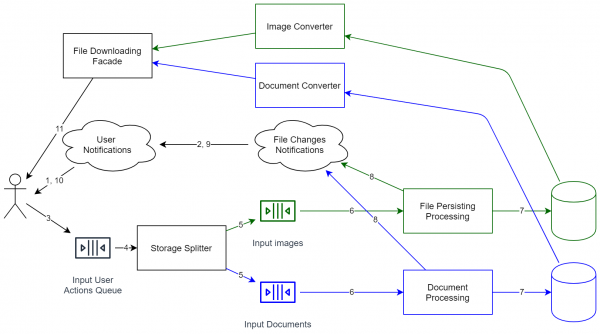
Jak je patrné, systém se radikálně zkomplikoval. Nyní to není jen mini proces, který ukládá soubory lokálně. Nyní je potřeba již ne zcela jednoduchá podpora, kontrola verzí API atd. Proto, jakmile jsou všechny diagramy nakresleny, je nejlepší podrobně zhodnotit, zda stojí za to investovat do rozšiřitelnosti takových nákladů. Pokud však chcete mít možnost rozšiřovat systém (včetně práce s ještě větším počtem uživatelů), budete muset přistoupit k takovým řešením. Výsledkem je, že architektura systému je připravena na zvýšení zátěže (prakticky každý komponent může být klonován pro horizontální škálování). Systém lze aktualizovat bez jeho zastavení (jen některé operace se mírně zpomalí).
Jak už jsem říkal na začátku, nyní řada internetových služeb začíná zažívat zvýšenou zátěž. A některé z nich prostě přestaly správně fungovat. V podstatě systémy selhaly právě v okamžiku, kdy by podnik měl vydělávat peníze. To znamená, že místo odložené dodávky, místo nabídky klientům "plánujte dodávku na nejbližší měsíce", systém prostě řekl "běžte ke konkurenci". Vlastně, to je cena nízké výkonnosti: ztráty nastanou právě ve chvíli, kdy by zisk byl nejvyšší.
Závěr
Všechny tyto přístupy byly známy již dříve. Totéž VK již dávno využívá myšlenku Dlouhodobého hostingování statického obsahu pro distribuci obrázků. Mnoho online her využívá schéma Shardingu pro rozdělení hráčů podle regionů nebo pro rozdělení herních lokalit (pokud je svět jednotný). Přístup Event Sourcing se aktivně používá v elektronické poště. Většina aplikací obchodníků, kde neustále přicházejí data, je ve skutečnosti postavena na přístupu CQRS, aby bylo možné filtrovat získaná data. Horizontální škálování je také dost dlouho používáno v mnoha službách.
Nicméně, co je nejdůležitější, všechny tyto vzory se staly velmi snadno aplikovatelnými v moderních aplikacích (pokud jsou samozřejmě na místě). Cloudové služby nabízí sharding a horizontální škálování hned, což je mnohem snazší, než samostatně objednávat různé dedikované servery v různých datových centrech. CQRS se stal mnohem jednodušším, alespoň díky rozvoji knihoven, jako je RX. Před deseti lety mohl jen málokterý web podporovat něco takového. Event sourcing je také neuvěřitelně snadno nastavitelný díky již hotovým kontejnerům s Apache Kafka. Před deseti lety by to bylo inovativní, nyní je to běžné. Podobně i statické hostování obsahu: díky pohodlnějším technologiím (včetně toho, že existuje podrobná dokumentace a velká databáze odpovědí) se takový přístup stal ještě jednodušším.
Výsledkem je, že realizace řady poměrně složitých architektonických vzorů se nyní stala mnohem jednodušší, což znamená, že byste se na ně měli lépe předem podívat. Pokud se v desetileté aplikaci z nějakého důvodu vzdali některého z výše uvedených řešení kvůli vysokým nákladům na zavedení a provoz, nyní, v nové aplikaci nebo po refaktoringu, můžete vytvořit službu, která bude architektonicky jak rozšiřitelná (z pohledu výkonu), tak připravená na nové požadavky od klientů (například pro lokalizaci osobních údajů).
A co je nejdůležitější: prosím, nepoužívejte tyto přístupy, pokud máte jednoduchou aplikaci. Ano, jsou krásné a zajímavé, ale pro web s vrcholovou návštěvností 100 lidí se často dá obejít s klasickým monolitem (alespoň zvenčí, uvnitř lze vše rozčlenit na moduly atd.).
Zdroj: habr.com
