

Úvod
Na světě existuje taková jednoduchá a velmi užitečná utilita — , a tak se stalo, že se velmi dlouho usadila v našem výrobním procesu (pravda, její verzi se nepodařilo nainstalovat, ale rozhodně to nebyla poslední dostupná). Používáme ji k jejímu přímému účelu — vytváření binárních patchů. Když se podíváte, co tam je v repozitáři, — je to trochu smutné: v podstatě je dávno opuštěn a mnoho z toho je silně zastaralé (kdysi tam učinil několik úprav můj bývalý kolega, ale to už bylo dávno). Rozhodl jsem se toto oživit: fork, odstranil jsem to, co neplánuji používat, a převádím projekt na , za-inlinil jsem „horké“ mikrofunkce, odstranil jsem z zásobníku velké pole (a pole proměnné délky, které mě upřímně „štvou“), znovu jsem spustil profiler — a zjistil jsem, že asi 40% času se tráví na …
Co tam máme s fwrite?
V tomto kódu se fwrite (v mém konkrétním testovacím případě: vytváření patchu mezi blízkými 300 MB soubory, vstupy jsou zcela v paměti) volá milionkrát s malou velikostí bufferu. Je zřejmé, že tahle věc bude zpomalovat, a proto bych chtěl nějak ovlivnit tento nepořádek. Nechci zavádět různé zdroje dat, asynchronní vstup/výstup, chtěl jsem najít jednodušší řešení. První, co mě napadlo — zvýšit velikost bufferu
setvbuf(file, nullptr, _IOFBF, 64 * 1024)ale zásadního zlepšení výsledku jsem nedosáhl (nyní na fwrite odpadalo asi 37% času) — znamená to, že problém není v častém zápisu dat na disk. Když se podíváte „pod kapotu“ fwrite, můžete vidět, že uvnitř se děje lock/unlock struktury FILE přibližně takto (pseudokód, celá analýza byla prováděna pod Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
Pokud věříte profileru, na _fwrite_nolock připadá pouze 6% času, zbytek — na overhead. V mém konkrétním případě je vlákno bezpečnost zřejmým přebytkem, a proto ji obětuji, když nahradím volání fwrite na — dokonce není třeba špekulovat s argumenty. Celkově: tato prostá manipulace podstatně snížila náklady na záznam výsledku, které v původní variantě představovaly téměř polovinu časových nároků. Mimochodem, ve světě POSIX existuje podobná funkce — . Obecně platí, že to samé se týká i fread. Tímto způsobem lze pomocí pár definic #define dosáhnout zcela multiplatformního řešení bez zbytečného blokování, pokud to není nezbytné (což se velmi často stává).
fwrite, _fwrite_nolock, setvbuf
Pojďme se abstrahovat od původního projektu a zaměřme se na testování konkrétního případu: záznam velkého souboru (512 MB) v minimálních porcích — po 1 bajtu. Testovací systém: AMD Ryzen 7 1700, 16 GB RAM, HDD 7200 ot./min 64 MB cache, Windows 10 1809, binární soubor byl sestaven jako 32bitový, optimalizace zapnuty, knihovna staticky přilinkována.
Vzorek pro provedení experimentu:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Jako proměnné budou vystupovat TEST_BUFFER_SIZE, a pro pár případů nahradíme fwrite_unlocked za fwrite. Začneme s případem fwrite bez explicitního nastavení velikosti buffru (zakomentujeme setvbuf a související kód): doba 27048906 μs, rychlost zápisu — 18.93 MB/s. Nyní nastavíme velikost buffru na 64 KB: doba — 25037111 μs, rychlost — 20.44 MB/s. Nyní otestujeme práci _fwrite_nolock bez volání setvbuf: 7262221 μs, rychlost — 70.5 MB/s!
Pokračujeme s experimentováním s velikostí buffru (setvbuf):
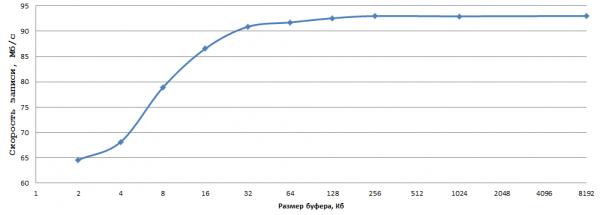
Data byla získána průměrováním 5 experimentů, na chyby jsem se neobtěžoval počítat. Podle mého názoru je 93 MB/s při zápisu po 1 bajtu na běžném HDD velmi slušný výsledek, stačí si jen vybrat optimální velikost buffru (v mém případě 256 KB — to je právě ono) a nahradit fwrite za _fwrite_nolock/fwrite_unlocked (pokud není potřeba bezpečnost pro více vláken, samozřejmě).
Podobně s fread za podobných podmínek. Protože nemám po ruce 'hardwarový' stroj s linuxem (jednodeskové počítače neberu v úvahu), rozhodl jsem se provést omezený experiment na virtuálce (Hyper-V, OpenSUSE 15, GCC 8.3.1) — zákonitost je v zásadě stejná: 'holé' fwrite 20 MB/s, fwrite + buffr na 256 KB dosáhl 23 MB/s, fwrite_unlocked s tímto stejným buffrem — 35 MB/s (binární soubor 64bitový, kompilovalo se g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Poznámka na závěr
Cílem tohoto článku bylo popsat jednoduchou a účinnou techniku, která se v mnoha případech osvědčuje (s funkcemi _fwrite_nolock/fwrite_unlocked jsem se předtím příliš nesetkal, i když jsou poměrně málo známé — což je škoda). Na originalitu materiálu si nehraji, ale doufám, že článek bude pro komunitu užitečný.
Zdroj: habr.com
