

Veeam má rád logy. A protože většina našich řešení je modulární, generují poměrně hodně logů. A jelikož naším oborem je zajištění bezpečnosti vašich dat (tedy klidný spánek), logy musí nejen zachycovat každý náznak, ale také to dělat dost podrobně. Je to nezbytné, aby v případě potřeby bylo jasné, jak k tomu "něčemu" došlo, kdo je za to odpovědný a co dál dělat. Jak v kriminalistice: nikdy nevíš, jaký detail ti pomůže najít vraha Lory Palmerové.
Proto jsem se rozhodl pustit do série článků, kde postupně vyprávím o tom, co zapisujeme do logů, kde je uchováváme, jak se nezbláznit z jejich struktury a co vlastně v nich hledat.
Proč série článků a proč nepopisovat všechno najednou?
Jednoduše vyjmenovat, který log se kde nachází a co v něm je, je dost nešťastná myšlenka. A udržovat tyto informace aktuální je ještě horší. Prosté sepsání všech možných typů logů ve Veeam Backup & Replication by bylo tabulkou na několik listů malým písmem. A navíc by byla aktuální jen v okamžiku publikace, protože s vydáním dalšího patche by se mohly objevit nové logy, změnit logika uchovávaných informací ve starých atd. Proto bude mnohem výhodnější vysvětlit jejich strukturu a podstatu obsažených informací. To umožní lépe se orientovat na místech než prosté memorování názvů.
Abychom se tedy neskočili do hloubky textových příběhů, pojďme v tomto článku provést určitou přípravu. Dnes se tedy nebudeme zabývat samotnými logy, ale přistoupíme k tomu z dálky: vytvoříme glosář a trochu se pobavíme o struktuře Veeam z pohledu generace logů.
Glosář a žargon
Zde se především omlouvám příznivcům čistoty češtiny a svědkům Ožegova slovníku. Všichni velmi milujeme svůj rodný jazyk, ale prokletý IT průmysl funguje v angličtině. No, my jsme to nevymysleli, ale historicky to tak dopadlo. Nejsem v tom nevinně, přišel sám (c)
V našem oboru má problém anglicismů (a žargonu) svou specifiku. Když pod nevinnými slovy jako "host" nebo "hostitel" celý svět už dávno chápe zcela konkrétní věci, tak na ⅙ části souše pokračuje hrdinské rozpadání a váhání s hledáním v slovech. A striktně nezbytný argument "A u nás v práci...".
Kromě toho máme terminologii, která patří konkrétně produktům Veeam, i když některá slova a obraty se dostaly i mezi lid. Proto se teď dohodneme, co který termín znamená, a v budoucnu pod slovem "host" budu mít na mysli právě to, co je napsáno v této kapitole, a ne to, co jste zvyklí mít ve své práci. A ano, to není moje osobní přání, ale ustálené termíny v průmyslu. Bojovat s nimi je poněkud bezvýznamné. I když komentáře mi nevadí.
Bohužel, termínů v naší práci a produktech je extrémně mnoho, takže se je všechny snažit vyjmenovat nebudu. Jen ty nejzákladnější a nezbytné pro přežití v moři informací o zálohách a logách. Pro zájemce mohu také kolegy o pásech, kde také zmiňoval seznam termínů vztahujících se k té části funkcionality.
Host (Hostitel): Ve světě virtualizace je to stroj s hypervizorem. Fyzický, virtuální, cloudový — nezáleží na tom. Jestliže na něčem běží hypervizor (ESXi, Hyper-V, KVM atd.), tak to "něco" se nazývá hostitelem. Ať už je to cluster se deseti racky nebo váš laptop s laborkou na půl virtuálního stroje — pokud jste spustili hypervizor, pak jste se stali hostitelem. Protože hypervizor hostí virtuální stroje. Dokonce existuje pověst, že VMware kdysi chtěla dosáhnout pevné asociace slova hostitel právě s ESXi. Ale nezvládli to.
V moderním světě se pojem "hostitel" prakticky slil s pojmem "server", což působí určité zmatek v komunikaci, zejména pokud jde o Windows infrastrukturu. Takže jakýkoli stroj, na kterém je nějaká zajímavá služba, může být směle nazván hostitelem. Například v logách WinSock je slovo host označováno úplně vším. Klasické "Host not found" je tomu příkladem. Takže vycházíme z kontextu, ale pamatujeme — ve světě virtualizace hostitel je ten, kdo hostí hosty (o tom dvě řádky níže).
Z lokálního žargonu (spíše akronymů, v tomto případě) si vzpomeneme, že VMware je VI, vSphere je VC a Hyper-V je HV.
Guest (Host): Virtuální stroj běžící na hostiteli. Tady ani není co vysvětlovat, je to tak logické a jednoduché. Nicméně mnozí se snaží zatahovat nějaké jiné významy.
Proč? To nevím.
Guest OS, tedy operační systém hostitelského stroje. A tak dále.
Backup/Replication Job (úkol): Čistý VMware žargon, označující nějaký úkol. Backup job == Zálohovací úkol. Jak to hezky přeložit do češtiny — nikdo nevymyslel, proto všichni říkají "úkol" s důrazem na poslední slabiku.
Ano, tak jednoduše prostě říkají "úkol". A dokonce to píší v emailech, a vše je v pořádku.
Různé zálohovací práce, úkoly zálohy atd., díky, ale to není potřeba. Prostě úkol, a budete pochopeni. Hlavní je klást důraz na poslední slabiku.
Backup (Záloha, backup. Pro pravé old-schooláky je přípustné říkat bakUp): Kromě zřejmého (někde uložená záloha dat) označuje také samotný úkol (tři řádky výše, pokud už jste zapomněli), na jehož základě vzniká ten samý zálohovací soubor. Pravděpodobně jsou anglicky mluvící lidé příliš líní, aby pokaždé říkali I ran my backup job, takže prostě řeknou I ran my backup, a všichni se skvěle chápou. Navrhuji podpořit tento výborný záměr.
Consolidate (Konsolidace): Termín, který se objevil v ESXi 5.0. Možnost v nabídce práce se snapshoty, spouštějící proces odstraňování takzvaných orphaned snapshotů. To jsou snapshoty, které fyzicky existují, ale vypadly z zobrazené logické struktury. Teoreticky by tento proces neměl zasáhnout soubory zobrazené v manažeru snapshotů, ale může se stát cokoliv. Podstata procesu konsolidace je v tom, že data ze snapshotu (child disk) jsou zapisována do hlavního (parent) disku. Proces sloučení disků se nazývá mergen (merge). Pokud byla vydána objednávka na konsolidaci, záznam o snapshotu může být smazán z databáze dříve, než bude snapshot sloučen a odstraněn. A pokud se snapshot z nějakého důvodu nepodařilo odstranit, objeví se právě tyto orphaned snapshoty. O práci se snapshoty má VMware . A také jsme o nich .
Datastore (Sklad nebo storage): Velmi široký pojem, avšak ve světě virtualizace se tím rozumí místo, kde jsou uloženy soubory virtuálních strojů. V každém případě je nutné velmi jasně pochopit kontext a v případě nejmenšího pochybnosti si ujasnit, co přesně váš protějšek měl na mysli.
Proxy (Proxy): Je důležité ihned pochopit, že Veeam Proxy není úplně to samé, na co jsme zvyklí na poli internetu. V rámci produktů od Veeam je to jakási entita, která se zabývá přesunem dat z jednoho místa na druhé. Pokud se nepodrobíme podrobnostem, VBR je týmový server, a proxy jsou jeho pracovní koně. To znamená, že proxy je stroj, skrze který protéká provoz a na kterém jsou nainstalovány komponenty VBR, které pomáhají řídit tento provoz. Například přesouvat data z jednoho kanálu do druhého nebo prostě připojit další disky (režim HotAdd).
Repository (Repozitář): Technicky se jedná pouze o záznam v databázi VBR, který ukazuje na místo, kde jsou uchovávány zálohy, a jak se k tomuto místu připojit. V praxi to může být jak prostá CIFS sdílená složka, tak i samostatný disk, server nebo cloudový bucket. Opět se nacházíme v kontextu, ale chápeme, že repozitář je prostě místo, kde leží vaše zálohy.
Snapshot (Snapshot): Milovníci oxfordské gramatiky preferují mluvit kdo snapšot, kdo snapšot, avšak bezgramotná většina vyhrává díky větší mase. Pokud někdo neví — jedná se o technologii, která umožňuje obnovit stav disku k určitému času. Dělá se to buď díky dočasnému přesměrování I/O operací od hlavního disku — pak se to nazývá RoW (Redirect on Write) snapshot — nebo díky přesunu přepisovaných bloků z vašeho disku na jiný — to se nazývá CoW (Copy on Write) snapshot. Právě díky širokým možnostem využití těchto funkcí může Veeam vykonávat svou zálohovací magii. Přesněji řečeno, nejen jemu, ale je to otázka nejbližších vydání.
V dokumentaci a logech ESXi panuje okolo tohoto termínu chaos, a v kontextu zmínky o snapshotu můžete narazit na samotné snapshoty, redo logy a dokonce delta disky. V dokumentaci Veeam takový zmatek není, a snapshot je snapshot, zatímco redo log je přesně REDO soubor, vytvořený nezávislým non-persistent diskem. REDO soubory jsou smazány při vypnutí virtuálního stroje, takže jejich zaměňování se snapshoty je cesta k neúspěchu.
Synthetic (Syntetika): Syntetické zálohy se vztahují k reverse incremental a forever forward zálohám. Pokud jste se s tímto termínem dosud nesetkali, jedná se o jeden z mechanismů používaných k vytváření transformace zálohového řetězce. V logech se však také můžete setkat s pojmem Transform, který se používá v rámci vytváření plných kopií z inkrementů (syntetická plná).
Task (Úkol): To je proces zpracování každého jednotlivého stroje v rámci úlohy. Takže: máte zálohovou úlohu, do které jsou zahrnuty tři stroje. To znamená, že každý stroj bude zpracován v rámci samostatného úkolu. Celkem tedy budou čtyři logy: jeden hlavní pro úlohu a tři pro úkoly. Nicméně zde je zásadní nuance: postupem času se slovo „úkol“ stalo příliš mnohoznačným. Když mluvíme o obecných logech, máme na mysli, že úkol je právě VM. Ale své „úkoly“ mají i proxy a úložiště. Pro ně to může znamenat jak virtuální disk, tak virtuální stroj nebo celou úlohu. Je důležité neztratit kontext.
Veeam %name% Service (Služba): Pro úspěšné zálohy pracuje hned několik služeb, jejichž seznam naleznete ve standardní konzole. Jejich názvy dostatečně jasně odrážejí jejich podstatu, nicméně mezi nimi je nejdůležitější - Veeam Backup Service, bez které ostatní nebudou fungovat.
VSS: Technicky by VSS vždy měl označovat Microsoft Volume Shadow Copy Service. Ve skutečnosti je mnohými používán jako synonymum pro Application-Aware Image Processing. Což, samozřejmě, je naprosto chybný údaj, nicméně to je příběh ze sféry „Každé SUV můžete nazvat jeepem, a vy budete pochopeni.“
Fantastické logy a místa, kde žijí
Chci tuto kapitolu začít odhalením velkého tajemství - jaký čas se zobrazuje v logech?
Pamatujte:
- ESXi vždy zapisuje logy v UTC+0.
- vCenter vede logy podle času své časové zóny.
- Veeam vede logy podle času a časové zóny serveru, na kterém běží.
- A pouze Windows události ve formátu EVTX netrpí vazbami na nic. Při otevření se čas přepočítá podle stroje, na kterém jsou otevřeny. Nejpohodlnější varianta, i když i s tím mohou nastat komplikace. Jedinou znatelnou potíž představuje rozdíl lokalizací. To je téměř zaručenou cestou k nečitelným logům. Ano, existují možnosti, jak to napravit, ale pojďme se prostě nesporovat o tom, že vše v IT funguje v angličtině, a dohodneme se, že na serverech vždy nastavíme anglickou lokalizaci. Prosím.
Teď se přece jen podívejme na místa, kde žijí logy a jak je získat. V případě VBR existují dva přístupy.
První varianta se hodí, pokud nemáte chuť hledat mezi množstvím souborů ty, které se týkají právě vaší situace. Pro to máme zvláštní průvodce, kterému můžete zadat konkrétní úlohu a konkrétní období, za které potřebujete logy. Poté sám projde složkami a shromáždí všechno potřebné do jednoho archivu. O tom, kde jej hledat a jak s ním pracovat, je podrobně napsáno v .
Nicméně průvodce sbírá logy ne všech úloh a například v případě potřeby prozkoumat logy restaurace, failoveru nebo failbacku váš směr je do složky %ProgramData%/Veeam/Backup. To je hlavní úložiště logů VBR, a %ProgramData% je skrytá složka, což je normální. Mimochodem, výchozí umístění lze přenastavit pomocí registračního klíče typu REG_SZ: LogDirectory v větvi HKEY_LOCAL_MACHINE\SOFTWARE\Veeam\Veeam Backup and Replication.
Na linuxových strojích byste logy pracovních agentů měli hledat v /var/log/VeeamBackup/, pokud používáte root nebo sudo účet. Pokud nemáte taková práva, hledejte logy v /tmp/VeeamBackup.
Pro Veeam agent for %OS_name% byste měli hledat logy v %ProgramData%/Veeam/Endpoint (nebo %ProgramData%/Veeam/Backup/Endpoint) a /var/log/veeam odpovídajícím způsobem.
Pokud používáte Application-Aware Image Processing (a pravděpodobně ano), situace se trochu komplikuje. Budete potřebovat logy našeho pomocníka, které jsou uloženy uvnitř samotné virtuálky, a logy VSS. O tom, jak a kde získat toto štěstí, je podrobně napsáno v . A samozřejmě existuje způsob, jak shromáždit potřebné systémové logy.
Události Windows je pohodlné shromažďovat podle . Pokud používáte Hyper-V, věc se komplikuje, protože budete potřebovat také všechny jeho logy ze sekce Applications and Service Logs > Microsoft > Windows. I když se vždy můžete vydat více násilnou cestou a jednoduše vzít všechny objekty z %SystemRoot%\System32\winevt\Logs.
Pokud se vám něco pokazí při instalaci/aktualizaci, vše potřebné najdete ve složce %ProgramData%/Veeam/Setup/Temp. I když neskrývám, že v událostech operačního systému můžete nalézt užitečnější informace než v těchto logách. Zajímavé zbytky se nacházejí ve %Temp%, ale většinou tam jsou logy instalace doplňkového softwaru, jako jsou databáze, .Net knihovny a podobně. Mějte na paměti, že Veeam se instaluje z msi a všechny jeho komponenty jsou také instalovány jako samostatné msi balíčky, i když to nebylo zobrazeno v GUI. Pokud tedy instalace jedné z komponent selže, celá instalace VBR bude zastavena. Proto je třeba podívat se do logů a zjistit, co se přesně pokazilo a v jakém okamžiku.
A poslední tip: pokud dostanete chybu při instalaci, nespěchejte stisknout OK. Nejprve si stáhněte logy, potom stiskněte OK. Tak získáte log, který končí v okamžiku chyby, bez odpadků na konci.
A někdy je třeba se ponořit do logů vSphere. Je to velmi vděčné zaměstnání, ale když si rukávy vyhrneme, musíme dělat i takové věci. V nejjednodušším případě potřebujeme logy událostí virtuálního stroje vmware.log, které leží vedle jeho .vmx souboru. V složitějších případech otevřeme Google a zjistíme, kde se nacházejí logy pro vaši verzi hosta, protože VMware má tento prostor tendenci měnit s každým vydáním. Například, , a tady je pro . Pro logy vCenter opakujeme proceduru . Obecně nás zajímají logy událostí hostitele hostd.log, události hostitelů řízených pomocí vCenter vpxa.log, logy jádra vmkernel.log a logy autentizace auth.log. Ve skutečně složitých případech se může hodit také log SSO, který se nachází ve složce SSO.
Je to složité? Zmatené? Strašidelné? A to je ještě ani ne polovina informací, se kterými náš support pracuje na denní bázi. Opravdu jsou velmi skvělí.
Komponenty Veeam
A jako závěr tohoto úvodního článku si povíme něco o komponentách Veeam Backup & Replication. Když hledáte příčinu bolestí, nebylo by špatné porozumět, jak je pacient uspořádán.
Jak je všem jistě známo, Veeam Backup je aplikace založená na SQL. To znamená, že všechny nastavení, všechny informace a vše, co je potřeba pro její správné fungování, se nachází v její databázi. Vlastně v dvou databázích, pokud mluvíme o spojení VBR a EM: VeeamBackup a VeeamBackupReporting, což odpovídá. Je to tak, že s instalací další aplikace přibude další databáze. Abychom neskladovali všechna vejce v jednom košíku.
Aby to vše fungovalo harmonicky, potřebujeme sadu služeb a aplikací, které spojí všechny komponenty dohromady. Pro příklad, takto to vypadá v jedné z mých laboratoří:
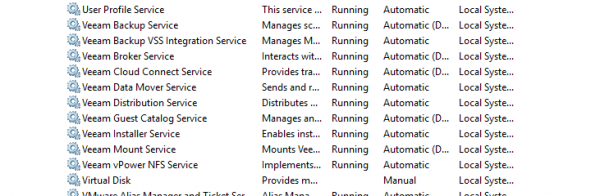
Hlavní roli hraje Veeam Backup Service. Ten je odpovědný za výměnu informací s databázemi. Také se stará o spuštění všech úloh, koordinuje přidělené zdroje a funguje jako komunikační centrum pro různé konzole, agenty a ostatní. Slabikářově, bez něj to rozhodně nejde, ale to vůbec neznamená, že vše dělá sám.
S realizací jeho plánů mu pomáhá Veeam Backup Manager. To není služba, ale entita, která se zabývá spuštěním úloh a sleduje průběh jejich vykonávání. Pracovní síly backup service, pomocí kterých se připojuje k hostitelům, vytváří snapshoty, sleduje retenci atd.
Ale vraťme se k seznamu služeb. Veeam Broker Service. Objevil se ve verzi v9.5 (a to není krypto-miner, jak si tehdy někteří mysleli). Zajišťuje sběr informací o hostitelích VMware a jejich aktualizaci. Ale nespěchejte s psaním rozhořčených komentářů, že vás špehujeme a vyzrazujeme všechna přihlašovací jména/hesla proudmajora. Vše je o něco jednodušší. Když spouštíte zálohu, první věc, kterou musíte udělat, je připojit se k hostiteli a aktualizovat všechny údaje o jeho struktuře. To je poměrně pomalý a objemný proces. Jen si vzpomeňte, jak dlouho trvá operace přihlášení přes webové rozhraní, a pamatujte, že se tam počítá pouze horní vrstva. A pak musíte navíc odhalit celou hierarchii až na potřebné místo, ostatně. Zkrátka, hrozné. Pokud spouštíte desítku záloh, každá úloha musí tuto proceduru udělat. Pokud jde o velké infrastruktury, může tento proces trvat deset minut a více. Proto bylo rozhodnuto vyčlenit na to samostatnou službu, přes kterou bude možné získávat vždy aktuální informace. Při spuštění kontroluje a skenuje celou přidanou infrastrukturu, a pak se snaží pracovat pouze na úrovni inkrementálních změn. Takže i když budete mít spuštěno současně sto záloh, všechny si vyžádají informace od našeho brokera, a nebudou zatěžovat hostitele svými požadavky. Pokud se obáváte o zdroje, podle našich výpočtů pro 5000 virtuálních strojů potřebujete jen asi 100 Mb RAM.
Dále máme Veeam Console. Také známá jako Veeam Remote Console, nebo Veeam.Backup.Shell. To je ten GUI, který vidíme na snímcích obrazovky. Všechno je jednoduché a zřejmé – konzoli můžete spustit odkudkoli, stačí mít Windows a připojení k serveru VBR. Jediné, co lze říci: proces FLR bude montovat body lokálně (t.j. na stroj, kde je konzole spuštěna). No a různorodí Veeam Explorers se také spustí lokálně, protože jsou součástí konzole. Ale to už mě zavádí na klikatější cestu...
Další zajímavou službou je Veeam Backup Catalog Data Service. Na seznamu služeb je znám jako Veeam Guest Catalog Service. Zajišťuje indexaci souborových systémů na hostitelských strojích a plní tyto znalosti do složky VBRCatalog. Používá se pouze tam, kde je zaškrtnutá volba indexace. A zapínat ji má smysl jen tehdy, máte-li Enterprise Manager. Proto doporučení z celého srdce: nezapínejte indexaci jen tak, pokud nemáte EM. Šetřete si nervy a čas podpory.
Dále mezi dalšími důležitými službami stojí za zmínku Veeam Installer Service, pomocí něhož probíhá dodání a instalace potřebných komponentů na proxy, repozitáře a další brány. V podstatě, doručuje potřebné .msi balíčky na servery a provádí jejich instalaci.
Veeam Data Mover — pomocí spouštěných na proxy (a nejen tam) pomocných agentů se zabývá přenášením dat. Například při zálohování jeden agent přečte soubory z datastorů hostitele, zatímco druhý je pečlivě zapisuje do zálohy.
Samostatně bych chtěl zdůraznit důležitou věc, na kterou často reagují klienti — to je rozdíl verzí služeb a informací v nástroji Programs and Features. Ano, seznam bude stejný, ale verze mohou být v chaosu. To není příliš dobré z vizuálního hlediska, ale je to zcela normální, pokud to všechno funguje stabilně. Například u Installer služby číslo verze značně zaostává za sousedními. Hrozba a noční můra? Ne, protože se neinstaluje celá znovu, ale jednoduše se aktualizuje jeho DLL. V patchi v9.5 U4 se stala hrozná noční můra technické podpory: při aktualizaci všechny služby dostaly nové verze, kromě té nejdůležitější. V patchi U4b transportní služba předběhla všechny ostatní dokonce o dvě verze (pokud to posoudíme podle čísel). A to je také normální — byla v ní nalezena vážná chyba, proto dostala bonusovou aktualizaci ve srovnání s ostatními. Takže shrneme-li to: rozdíl verzí MŮŽE být problémem, ale pokud rozdíl existuje a všechno funguje správně, pravděpodobně to tak má být. Ale nikdo vám zakazuje to ověřit u technické podpory.
To byly takzvané povinné nebo Mandatory services. A existuje ještě celá řada podpůrných, jako Tape Service, Mount Service, vPowerNFS Service a tak dále.
Pro Hyper-V je to v podstatě stejné, jen je zde specifický Veeam Backup Hyper-V Integration Service a jeho ovladač pro práci s CBT.
A nakonec si povíme, kdo pracuje na virtuálních strojích během zálohování. K provádění skriptů pre- a post-freeze, pro vytváření shadow copy, sběr metadat, práci s logy SQL transakcí a další se používá Veeam Guest Helper. A pokud dochází k indexaci souborových systémů, Veeam Guest Indexer . To jsou dočasné služby, které se nasazují během zálohování a po něm se odstraňují.
V případě Linuxových strojů je to mnohem jednodušší díky široké škále vestavěných knihoven a možností samotného systému. Například, indexace se provádí prostřednictvím mlocate.
Na tomhle zatím skončíme
Nesmím vás déle trápit a krátké úvod do podkapotního prostoru Veeam považuji za ukončený. Ano, ani zdaleka jsme se nedostali k samotným logům, ale věřte, že abyste informace, které v nich jsou, nevnímali jako nesouvislý tok vědomí, takové úvodní slovo je naprosto nutné. K samotným logům plánuji přejít až v třetím článku, a plán na další je vysvětlit, kdo generuje logy, co přesně v nich je zobrazeno a proč právě tak, a ne jinak.
Zdroj: habr.com
