

Ahoj všem, sdílíme s vámi druhou část publikace „Virtuální souborové systémy v Linuxu: k čemu jsou a jak fungují?“ První část si můžete přečíst . Připomínáme, že tato série publikací je věnována spuštění nového cyklu kurzu , který již brzy začne.
Jak sledovat VFS pomocí nástrojů eBPF a bcc
Nejjednodušší způsob, jak pochopit, jak jádro manipuluje s soubory sysfs – je pozorovat to v praxi, a nejběžnější způsob, jak sledovat ARM64 – je použít eBPF. eBPF (zkráceně od Berkeley Packet Filter) se skládá z virtuální stroje spuštěného v , jehož privilegovaní uživatelé mohou dotazovat (query) z příkazového řádku. Zdrojové kódy jádra informují čtenáře, co jádro může provádět; spuštění nástrojů eBPF v provozovaném systému ukazuje, co jádro skutečně dělá.
Naštěstí je začít používat eBPF poměrně jednoduché pomocí nástrojů , které jsou dostupné jako balíčky z běžné distribuce a jsou podrobně zdokumentovány . Nástroje bcc – jsou skripty v Pythonu s malými vložkami kódu v C, což znamená, že každý, kdo zná oba jazyky, je může snadno upravit. V bcc/tools je 80 skriptů v Pythonu, což znamená, že pravděpodobně vývojář nebo systémový administrátor najde něco vhodného k vyřešení úkolu.
Abychom získali alespoň povrchovou představu o tom, jakou práci vykonávají VFS v provozovaném systému, zkuste vfscount nebo vfsstat. To ukáže, že například deset výzev vfs_open() a jeho „přátel“ se odehrává doslova každou sekundu.
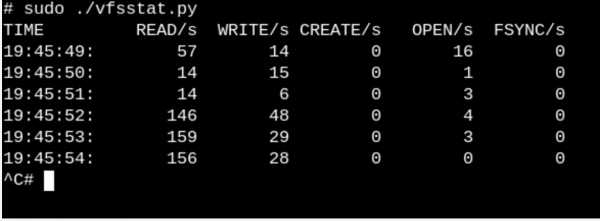
vfsstat.py– je skript v Pythonu, se vložkami C kódu, který jednoduše počítá volání funkcí VFS.
Uveďme triviálnější příklad a podívejme se, co se stane, když připojíme USB flash disk k počítači a systém ho zaznamená.
Pomocí eBPF můžeme zjistit, co se děje v
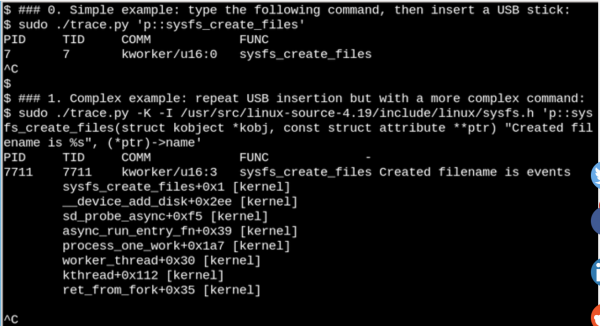
/sys, když je připojen USB flash disk. Zde je jednoduchý a složitý příklad.
V příkladu uvedeném nahoře, bcc nástroj vytiskne zprávu, když je spuštěna příkaz sysfs_create_files(). Vidíme, že sysfs_create_files() byl spuštěn pomocí kworker vlákna v reakci na to, že byl disk připojen, ale jaký soubor byl v této souvislosti vytvořen? Druhý příklad ukazuje celou sílu eBPF. Zde trace.py provádí zpětné sledování jádra (kernel backtrace) (volba -K) a název souboru, který byl vytvořen sysfs_create_files(). Vložení do jednotlivých výroků je kód v C, který zahrnuje snadno rozpoznatelný formátovací řetězec, zajišťovaný Python skriptem, který spouští LLVM just-in-time kompilátor. Tento řetězec se kompiluje a vykonává ve virtuální stroji uvnitř jádra. Kompletní signatura funkce sysfs_create_files () musí být reprodukována ve druhém příkazu, aby se formátovací řetězec mohl odkazovat na jeden z parametrů. Chyby v tomto úseku kódu v C vedou k rozpoznatelným chybám C kompilátoru. Například, pokud je vynechán parametr -l, uvidíte "Failed to compile BPF text." Vývojáři, kteří jsou dobře obeznámeni s C a Python, najdou nástroje bcc snadné pro rozšíření a úpravy.
Když je USB disk vložen, zpětné sledování jádra ukáže, že PID 7711 je vlákno kworker, které vytvořilo soubor "events" v sysfs. Odpovídající volání s sysfs_remove_files() ukáže, že odstranění disku vedlo k odstranění souboru events, což odpovídá celkové koncepci počítání referencí. Při tom, prohlédnutí sysfs_create_link () s eBPF během vložení USB disku ukáže, že bylo vytvořeno nejméně 48 symbolických odkazů.
Jaký je tedy smysl souboru events? Použití k vyhledání , ukazuje, že volá disk_add_events (), a buď "media_change", nebo "eject_request" mohou být zapsány do souboru událostí. Zde bloková vrstva jádra informuje userspace o přítomnosti a odstranění "disku". Všimněte si, jak informativní je tato metoda zkoumání na příkladu vložení USB disku v porovnání s pokusy zjistit, jak vše funguje, výhradně z zdrojových kódů.
Kořenové souborové systémy pouze pro čtení umožňují vestavěná zařízení
Samozřejmě nikdo nevypíná server nebo svůj počítač tím, že vytáhne zástrčku ze zásuvky. Ale proč? A to proto, že připojené souborové systémy na fyzických zařízeních ukládání mohou mít odložené zápisy, a datové struktury, které je ukládají, se nemusí synchronizovat se zápisy v úložišti. Když se to stane, majitelé systému musí čekat na příští spuštění, aby spustili nástroj fsck filesystem-recovery a v nejhorším případě ztratit data.
Nicméně, všichni víme, že mnoho zařízení IoT, jakož i směrovače, termostaty a automobily nyní běží na Linuxu. Mnohá z těchto zařízení prakticky nemají uživatelské rozhraní a není žádný způsob, jak je „čistě“ vypnout. Představte si spuštění auta s vybitou baterií, když se napájení řídicího zařízení neustále mění. Jak je možné, že systém se spustí bez dlouhého fsck, když motor konečně začne běžet? Odpověď je jednoduchá. Vestavěná zařízení se spoléhají na kořenový souborový systém (zkráceně ro-rootfs (read-only root fileystem)).
ro-rootfs Nabízejí mnoho výhod, které jsou méně zřejmé než nefalšovanost. Jedna z výhod spočívá v tom, že škodlivý software nemůže zapisovat do /usr nebo /lib, pokud žádný proces Linuxu do něj nemůže zapisovat. Další spočívá v tom, že do značné míry neměnný souborový systém je klíčový pro support vzdálených zařízení, protože pomocný personál používá místní systémy, které jsou nominálně identické s systémy na místě. Možná nejdůležitější (ale také nejzáludnější) výhodou je, že ro-rootfs nutí vývojáře rozhodnout, které systémové objekty budou neměnné, ještě v době navrhování systému. Práce s ro-rootfs může být nepríjemná a bolestivá, jak to často bývá s proměnnými const v programovacích jazykách, ale jejich výhody snadno převáží dodatečné náklady.
Tvorba rootfs Pouze pro čtení vyžaduje určité další úsilí od vývojářů vestavěných systémů, a právě zde přichází VFS do hry. Linux vyžaduje, aby soubory v /var byly dostupné pro zápis, a navíc mnohé populární aplikace, které spouští vestavěné systémy, se pokusí vytvořit konfigurační dot-files v $HOME. Jedním z řešení pro konfigurační soubory v domácím adresáři je obvykle jejich předběžné vygenerování a sestavení do rootfs. Pro /var Jedním z možných přístupů je namontovat je na samostatnou partition, která je dostupná pro zápis, zatímco samotný / je namontován pouze pro čtení. Další populární alternativou je použití propojených nebo překrývajících se montáží (bind or overlay mounts).
Svázané a překryté montáže, jejich použití kontejnery
Provedení příkazu man mount je nejlepší způsob, jak se seznámit se svázanými a překrytými montážemi, které umožňují vývojářům a systémovým administrátorům vytvářet souborový systém na jedné cestě a poté jej poskytovat aplikacím na jiné. Pro vestavěné systémy to znamená možnost uchovávat soubory na /var flash disku, který je dostupný pouze pro čtení, ale překrytí nebo svázání montáže cesty z tmpfs v /var při spuštění umožní aplikacím zapisovat poznámky. Při dalším zapnutí budou změny v /var ztraceny. Překrytá montáž vytváří spojení mezi tmpfs a podkladovým souborovým systémem a umožňuje údajné změny existujících souborů v ro-tootf zatímco svázaná montáž může udělat nové prázdné tmpfs adresáře viditelné jako dostupné pro zápis v ro-rootfs cestách. Zatímco overlayfs je správný (proper) typ souborového systému, svázaná montáž je realizována v .
Na základě popisu překrytí a svázání montáže se nikdo nediví, že je aktivně využívají. Pojďme pozorovat, co se stane, když použijeme k spuštění kontejneru, používající nástroj mountsnoop od bcc.
Zavolání system-nspawn spouští kontejner během práce mountsnoop.py.
Podívejme se, co se stalo:
Spuštění mountsnoop během "načítání" kontejneru ukazuje, že běhové prostředí kontejneru silně závisí na svázané montáži (Zobrazen pouze začátek dlouhého výstupu).
Zde systemd-nspawn poskytuje vybrané soubory v procfs a sysfs hosta do kontejneru jako cesty v jeho rootfs. Kromě MS_BIND flag, který nastavuje svázanou montáž, existují v montovaném systému některé další flagy, které určují vztah mezi změnami v prostoru názvů hostitele a kontejneru. Například svázaná montáž může buď propustit změny do /proc a /sys kontejneru, nebo je skrýt v závislosti na volání.
Závěr
Pochopení vnitřní struktury Linuxu se může zdát jako nesplnitelný úkol, protože jádro samo obsahuje obrovské množství kódu, aniž by se braly v úvahu aplikace uživatelského prostoru Linuxu a rozhraní systémových volání v knihovnách jazyka C, jako jsou glibc. Jedním ze způsobů, jak dosáhnout pokroku, je přečíst si zdrojový kód jedné podsystémy jádra se zaměřením na pochopení systémových volání a hlaviček, které se týkají prostoru uživatele, jakož i základních vnitřních rozhraní jádra, například tabulka file_operations. Operace se soubory zajišťují princip „všechno je soubor“, takže jejich správa je obzvlášť příjemná. Zdrojové soubory jádra v jazyce C se nacházejí v základním adresáři fs/ představují implementaci virtuálních souborových systémů, které tvoří vrstvu obalu zajišťující širokou a relativně jednoduchou kompatibilitu populárních souborových systémů a úložných zařízení. Připojování s vazbou a překrývání prostřednictvím jmenných prostorů systému Linux je kouzlo VFS, které umožňuje vytváření kontejnerů a kořenových souborových systémů pouze pro čtení. V kombinaci se studiem zdrojového kódu, jádrovým nástrojem eBPF a jeho rozhraním bcc
učiní výzkum jádra snadnějším než kdy dříve.
Přátelé, napište, zda vám tento článek byl užitečný. Možná máte nějaké komentáře nebo poznámky? A ty, které zajímá kurz „Administrátor Linux“, zveme na , který proběhne 18. dubna.
Zdroj: habr.com
