

Pozadí
Tak se stalo, že server byl napaden ransomwarem, který z "šťastné náhody" částečně ponechal nedotčené soubory .ibd (soubory surových dat tabulek innodb), ale přitom úplně zašifroval soubory .fpm (strukturní soubory). .idb lze rozdělit na:
- klasifikuje se na soubory, které lze obnovit pomocí standardních prostředků a průvodců. Pro takové případy existuje skvělá ;
- částečně zašifrované tabulky. Přednostně se jedná o velké tabulky, na které (jak jsem pochopil) útočníkům nestačilo místo v paměti na úplné šifrování;
- a zcela zašifrované tabulky, které nelze obnovit.
Určit, do které varianty tabulky patří, se podařilo prostým otevřením v jakémkoli textovém editoru se správným kódováním (v mém případě to bylo UTF8) a prostým prozkoumáním souboru na přítomnost textových polí, například:
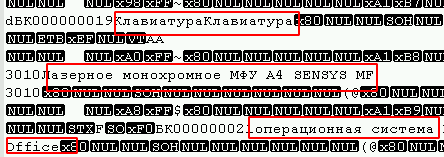
Také na začátku souboru lze pozorovat velké množství 0-byte, a viry používající algoritmus blokového šifrování (nejběžněji používaný) obvykle zasahují i ty.

V mém případě útočníci na konci každého zašifrovaného souboru zanechali řetězec ze 4 bytů (1, 0, 0, 0), což úkol usnadnilo. K nalezení nezasažených souborů stačil i skript:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Tímto způsobem se podařilo najít soubory náležící k prvnímu typu. Druhý typ vyžaduje dlouhé manuální zasahování, ale již nalezeného bylo dost. Vše by bylo v pořádku, ale je třeba vědět naprosto přesnou strukturu a (samozřejmě) došlo k takové situaci, že bylo nutné pracovat s často se měnící tabulkou. Nikdo si už nevzpomněl, zda se měnil typ pole, nebo zda byl přidán nový sloupec.
Dibry City bohužel nemohlo pomoci s takovým případem, proto je napsán tento článek.
Přejděme k věci
Existuje struktura tabulky staré 3 měsíce, která neodpovídá současné (možná podle jednoho pole, ale možná i více). Struktura tabulky:
VYTVOŘIT TABULKU `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
je nutné extrahovat:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
K obnově se používá byte-analýza .ibd souboru, po níž se převede do čitelnější podoby. Jelikož pro nalezení potřebného nám stačí analyzovat typy dat jako int a datetime, článek se bude zabývat pouze nimi, ale občas se budu odkazovat i na jiné typy dat, což může pomoci v jiných podobných případech.
Problém 1: v polích s typy DATETIME a TEXT byly hodnoty NULL, a v souboru byly jednoduše přeskočeny, proto nebylo možné určit strukturu pro obnovu v mém případě. V nových sloupcích byla výchozí hodnota null, a část transakce mohla být ztracena kvůli nastavení innodb_flush_log_at_trx_commit = 0, proto by na určení struktury bylo nutné vynaložit další čas.
Problém 2: je třeba vzít v úvahu, že řádky odstraněné pomocí DELETE se stále nacházejí v ibd souboru, ale při ALTER TABLE se jejich struktura neaktualizuje. V konečném důsledku se struktura dat může lišit od začátku souboru k jeho konci. Pokud často používáte OPTIMIZE TABLE, s podobným problémem se pravděpodobně nesetkáte.
Vezměte prosím na vědomí, že verze DBMS ovlivňuje způsob ukládání dat, a tento příklad nemusí fungovat pro jiné hlavní verze. V mém případě byla použita Windows verze mariadb 10.1.24. Také, i když v mariadb pracujete s tabulkami InnoDB, ve skutečnosti jsou , což vylučuje použití metody s InnoDB mysql.
Analýza souboru
V pythonu datový typ zobrazuje data v unicode místo běžného číselného souboru. I když je možné soubor prohlížet v této podobě, pro pohodlí je možné převést bajty na číselnou formu převedením pole bajtů na běžné pole (list(example_byte_array)). V každém případě se pro analýzu hodí oba způsoby.
Při prohlížení několika ibd souborů můžete narazit na následující:
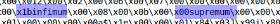
Přičemž, pokud byste soubor rozdělili podle těchto klíčových slov, získáte převážně jednotné bloky dat. Budeme používat infimum jako dělitel.
table = table.split("infimum".encode())Zajímavé pozorování, pro tabulky s malým množstvím dat, mezi infimum a supremum existuje ukazatel na počet řádků v bloku.
 — testovací tabulka s 1 řádkem
 — testovací tabulka se 2 řádky
Pole řetězců table[0] lze přeskočit. Po jeho prozkoumání jsem však stále nedokázal objevit syrová data tabulek. Pravděpodobně tento blok slouží k uložení indexů a klíčů.
Od table[1] a převedením jej na číselné pole již lze pozorovat určité vzory, a to:
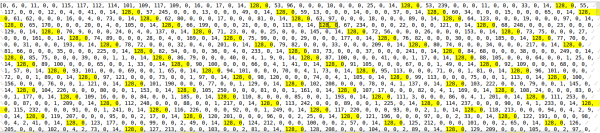
Jedná se o hodnoty int uložené v řetězci. První bajt ukazuje, zda je číslo kladné, nebo záporné. V mém případě jsou všechna čísla kladná. Z dalších 3 bajtů lze určit číslo pomocí následující funkce. Skript:
def find_int(val: str):  # příklad '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Například, 128, 0, 0, 1 = 1, nebo 128, 0, 75, 108 = 19308.
V tabulce byl primární klíč s autoinkrementací, a zde je také možné jej objevit.
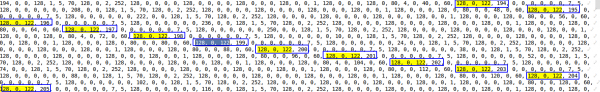
Porovnáním dat z testovacích tabulek bylo zjištěno, že objekt DATETIME se skládá z 5 bajtů a začíná číslem 153 (pravděpodobně ukazuje na roční intervaly). Protože rozsah DATETIME je ‘1000-01-01’ až ‘9999-12-31’, myslím, že se počet bajtů může lišit, ale v mém případě data spadají do rozsahu od roku 2016 do 2019, takže budeme předpokládat, že 5 bajtů je dostatečné.
Pro určení času bez sekund byly napsány následující funkce. Skript:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Pro rok a měsíc se mi nepodařilo napsat funkci, která by správně fungovala, takže jsem musel použít hardcoding. Skript:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Jsem si jistý, že pokud strávíš n času, pak se tuto nepříjemnost podaří vyřešit.
Další funkce, která vrací objekt datetime ze řetězce. Skript:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Bylo možné zjistit často se opakující hodnoty z int, int, datetime, datetime 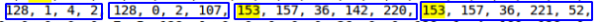 , zdá se, že to je to, co potřebujeme. Navíc, taková sekvence se ve stejném řetězci dvakrát neopakuje.
Pomocí regulárního výrazu najdeme potřebná data:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Všimněte si, že při hledání podle tohoto výrazu není možné určit NULL hodnoty v požadovaných polích, ale v mém případě to není kritické. Poté v cyklu procházíme nalezené. Skript:
výsledek = []
pro val v fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    pro it v bd_int:
        pre_result.append(find_int(bd_int[it]))
    pro bd v bd_date:
        pre_result.append(find_data_time(bd))
    výsledek.append(pre_result)
V podstatě všechno, data z pole výsledek, to jsou ta potřebná data. ###PS.###
Chápu, že tento způsob nebude vyhovovat všem, ale hlavním cílem článku je spíše podnítit k akci než vyřešit všechny vaše problémy. Myslím, že nejrozumnější by bylo začít studovat zdrojový kód samotného , ale vzhledem k omezenému času se aktuální způsob zdál být nejrychlejší.
V některých případech, po analýze souboru, budete schopni určit přibližnou strukturu a obnovit jednu z běžných metod uvedených výše. To bude mnohem správnější a vyvolá méně problémů.
Zdroj: habr.com
