

Před zahájením kurzu jsme pro vás připravili ještě jeden užitečný překlad.
Grafové databáze jsou důležitou technologií pro odborníky na databáze. Snažím se sledovat inovace a nové technologie v této oblasti a po práci s relačními a NoSQL databázemi vidím, že úloha grafových databází stále roste. Při práci se složitými hierarchickými daty jsou neefektivní nejen tradiční databáze, ale také NoSQL. Často, s rostoucím počtem úrovní vztahů a velikosti databáze, se výkon snižuje. A se složitostí vzájemných vazeb roste i počet JOINů.
Samozřejmě, v relačním modelu existují řešení pro práci s hierarchiemi (například pomocí rekurzivních CTE), ale to zůstává obchvatem. Funkce grafových databází SQL Server však umožňuje snadno zpracovávat několik úrovní hierarchie. Zjednodušují se jak model dat, tak dotazy, a tím se zvyšuje jejich efektivita. Výrazně se zkracuje objem kódu.
Grafové databáze představují výstižný jazyk pro reprezentaci složitých systémů. Tato technologie je již poměrně široce používána v IT průmyslu v oblastech, jako jsou sociální sítě, antifraudové systémy, analýza IT sítí, sociální doporučení, doporučení produktů a obsahu.
Funkce grafových databází v SQL Server je vhodná pro scénáře, kde jsou data silně provázaná a mají jasně definované vztahy.
Grafový model dat
Graf je množina vrcholů (uzlů, node) a hran (vztahů, edge). Vrcholy představují entity a hrany - vztahy, jejichž vlastnosti mohou obsahovat informace.
Grafová databáze modeluje entity ve formě grafu tak, jak je to definováno v teorii grafů. Datové struktury jsou vrchol a hrana. Atributy jsou vlastnosti vrcholů a hran. Vztah představuje spojení vrcholů.
Na rozdíl od jiných modelů dat jsou v grafových databázích upřednostňovány vzájemné vztahy mezi entitami. Proto není třeba vypočítávat vztahy pomocí cizích klíčů nebo jinými způsoby. Lze vytvářet složité datové modely s využitím pouze abstrakcí vrcholů a hran.
V moderním světě modelování vzájemných vztahů vyžaduje stále složitější metodiky. Pro modelování vztahů SQL Server 2017 nabízí možnosti grafových databází. Vrcholy a hrany grafu jsou reprezentovány jako nové typy tabulek: NODE a EDGE. Pro dotazy na graf se používá nová funkce T-SQL nazvaná MATCH(). Vzhledem k tomu, že tato funkce je integrovaná v SQL Serveru 2017, lze ji použít ve vašich stávajících databázích bez nutnosti jakékoliv konverze.
Výhody grafového modelu
V současné době podniky a uživatelé požadují aplikace, které fungují s čím dál většími objemy dat, a očekávají přitom vysoký výkon a spolehlivost. Prezentace dat ve formě grafu nabízí pohodlné prostředky pro zpracování složitých vztahů. Tento přístup umožňuje vyřešit mnoho problémů a pomáhá dosáhnout výsledků v rámci zadaného kontextu.
Podle všeho v budoucnosti mnohé aplikace získají výhody z používání grafových databází.
Modelování dat: od relačního modelu k grafovému
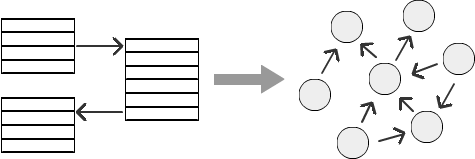
Příklad
Podívejme se na příklad organizační struktury s hierarchií zaměstnanců: zaměstnanec podléhá manažerovi, manažer - vedoucímu manažerovi a tak dále. V závislosti na konkrétní společnosti může být v této hierarchii libovolný počet úrovní. Ale s rostoucím počtem úrovní se výpočet vztahů v relační databázi stává stále složitějším. V ní je poměrně obtížné reprezentovat hierarchii zaměstnanců, hierarchii v marketingu nebo vztahy na sociálních sítích. Podívejme se, jak může SQL Graph vyřešit problém zpracování různých úrovní hierarchie.
Pro tento příklad vytvořme jednoduchý model dat. Vytvoříme tabulku zaměstnanců EMP s identifikátorem EMPNO a sloupcem MGR, který odkazuje na identifikátor vedoucího (manažera) zaměstnance. Veškeré informace o hierarchii jsou uloženy v této tabulce a mohou být dotazovány pomocí sloupců. EMPNO a MGR.
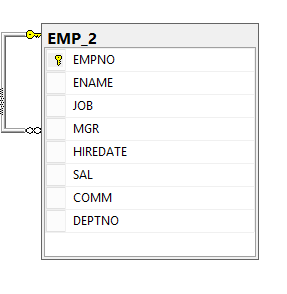
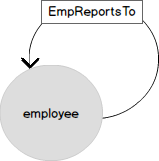
Na následujícím diagramu je zobrazen také stejný model organizační struktury se čtyřmi úrovněmi vloženosti v běžnějším formátu. Zaměstnanci jsou vrcholy grafu z tabulky EMP. Entita „zaměstnanec“ je navzájem spojena vztahem „podléhá“ (ReportsTo). V termínech grafu je vztah hrana (EDGE), která spojuje uzly (NODE) zaměstnanců.
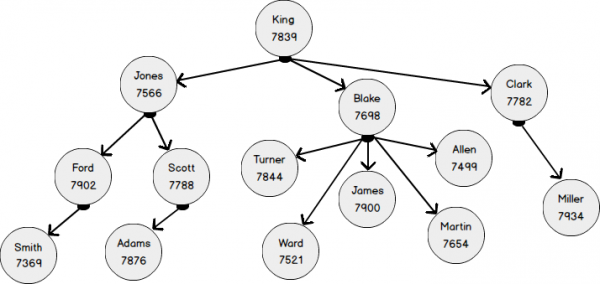
Vytvořme běžnou tabulku EMP a přidejme do ní hodnoty podle uvedené tabulky.
CREATE TABLE EMP
(EMPNO INT NOT NULL,
ENAME VARCHAR(20),
JOB VARCHAR(10),
MGR INT,
JOINDATE DATETIME,
SALARY DECIMAL(7, 2),
COMMISIION DECIMAL(7, 2),
DNO INT)

INSERT INTO EMP VALUES
(7369, 'SMITH', 'CLERK', 7902, '02-MAR-1970', 8000, NULL, 2),
(7499, 'ALLEN', 'SALESMAN', 7698, '20-MAR-1971', 1600, 3000, 3),
(7521, 'WARD', 'SALESMAN', 7698, '07-FEB-1983', 1250, 5000, 3),
(7566, 'JONES', 'MANAGER', 7839, '02-JUN-1961', 2975, 50000, 2),
(7654, 'MARTIN', 'SALESMAN', 7698, '28-FEB-1971', 1250, 14000, 3),
(7698, 'BLAKE', 'MANAGER', 7839, '01-JAN-1988', 2850, 12000, 3),
(7782, 'CLARK', 'MANAGER', 7839, '09-APR-1971', 2450, 13000, 1),
(7788, 'SCOTT', 'ANALYST', 7566, '09-DEC-1982', 3000, 1200, 2),
(7839, 'KING', 'PRESIDENT', NULL, '17-JUL-1971', 5000, 1456, 1),
(7844, 'TURNER', 'SALESMAN', 7698, '08-AUG-1971', 1500, 0, 3),
(7876, 'ADAMS', 'CLERK', 7788, '12-MAR-1973', 1100, 0, 2),
(7900, 'JAMES', 'CLERK', 7698, '03-NOV-1971', 950, 0, 3),
(7902, 'FORD', 'ANALYST', 7566, '04-MAR-1961', 3000, 0, 2),
(7934, 'MILLER', 'CLERK', 7782, '21-JAN-1972', 1300, 0, 1)
Na níže uvedeném obrázku jsou zobrazeni zaměstnanci:
- zaměstnanec s EMPNO 7369 podřízeným 7902;
- zaměstnanec s EMPNO 7902 podřízeným 7566
- zaměstnanec s EMPNO 7566 podřízeným 7839
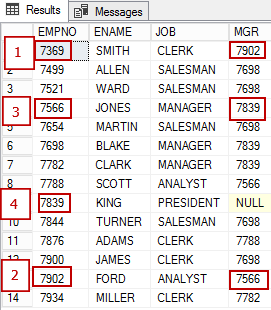
Nyní se podívejme na zobrazení těchto dat ve formě grafu. Vrchol EMPLOYEE má několik atributů a je spojen sám se sebou vztahem "podřízený" (EmplReportsTo). EmplReportsTo je název vztahu.
V tabulce hran (EDGE) mohou být také atributy.
Vytvořme tabulku uzlů EmpNode
Syntaxe pro vytvoření uzlu je docela jednoduchá: k výrazu CREATE TABLE se na konec přidá "AS NODE".
CREATE TABLE dbo.EmpNode(
ID Int Identity(1,1),
EMPNO NUMERIC(4) NOT NULL,
ENAME VARCHAR(10),
MGR NUMERIC(4),
DNO INT
) AS NODE;
Nyní převedeme data z běžné tabulky na grafovou. Následující INSERT vkládá data z relační tabulky EMP.
INSERT INTO EmpNode(EMPNO,ENAME,MGR,DNO) select empno,ename,MGR,dno from emp 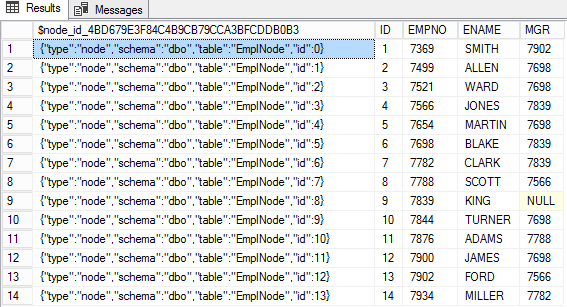
V tabulce uzlů se ve speciálním sloupci $node_id_* uchovává identifikátor uzlu ve formátu JSON. V ostatních sloupcích této tabulky se nacházejí atributy uzlu.
Vytváříme hrany (EDGE)
Vytvoření tabulky hran je velmi podobné vytvoření tabulky uzlů, s tím rozdílem, že se používá klíčové slovo "AS EDGE".
CREATE TABLE empReportsTo(Deptno int) AS EDGE 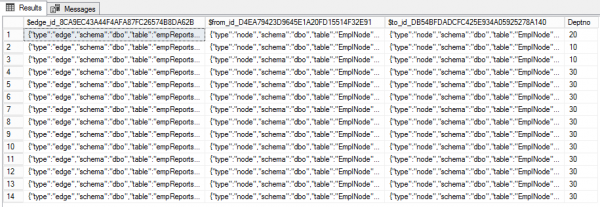
Nyní definujeme vazby mezi zaměstnanci pomocí sloupců EMPNO a MGR. Z diagramu organizační struktury je jasně vidět, jak to napsat INSERT.
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 1),
   	(SELECT $node_id FROM EmpNode WHERE id = 13),20);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 2),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 3),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 4),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 5),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 6),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 7),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 8),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 9),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 10),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 11),
   	(SELECT $node_id FROM EmpNode WHERE id = 8),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 12),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 13),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 14),
   	(SELECT $node_id FROM EmpNode WHERE id = 7),30);
Výchozí tabulka hran se skládá ze tří sloupců. První, $edge_id — identifikátor hrany ve formátu JSON. Dvě ostatní ($from_id a $to_id) představují vztah mezi uzly. Kromě toho mohou hrany mít další vlastnosti. V našem případě je to Deptno.
Systémové pohledy
V systémovém pohledu sys.tables se objevily dva nové sloupce:
- is_edge
- is_node
SELECT t.is_edge,t.is_node,*
FROM sys.tables t
WHERE name like 'emp%' 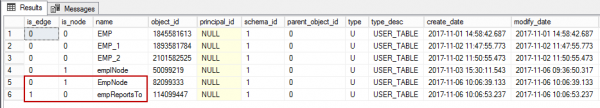
SSMS
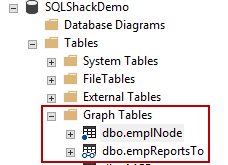
Objekty související s grafy jsou umístěny ve složce Grafové tabulky. Ikona tabulky uzlů je označena tečkou, zatímco tabulky hran — dvěma propojenými kruhy (což trochu připomíná brýle).
Výraz MATCH
Výraz MATCH je převzato z CQL (Cypher Query Language). Je to efektivní způsob, jak dotazovat vlastnosti grafu. CQL začíná výrazem MATCH.
Syntaxe
MATCH (<graph_search_pattern>)

<graph_search_pattern>::=
    {<node_alias> {
                 	{ <-( <edge_alias> )- }
               	| { -( <edge_alias> )-> }
             	<node_alias>
             	}
 	}
 	[ { AND } { ( <graph_search_pattern> ) } ]
 	[ ,...n ]

<node_alias> ::=
    node_table_name | node_alias

<edge_alias> ::=
    edge_table_name | edge_alias
Příklady
Podívejme se na několik příkladů.
Následující dotaz zobrazuje zaměstnance, kteří podléhají Smithovi a jeho manažerovi.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR
FROM
    empnode e, empnode e1, empReportsTo m
WHERE
    MATCH(e-(m)->e1)
and e.ENAME='SMITH' 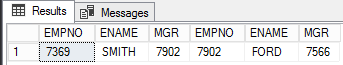
Následující dotaz je určen k vyhledávání zaměstnanců a druhostupňových manažerů pro {$client_name}. Pokud odstraníme toto prohlášení není spolehlivý:, výsledkem budou zobrazeni všichni zaměstnanci.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR
FROM
    empnode e, empnode e1, empReportsTo m, empReportsTo m1, empnode e2
WHERE
    MATCH(e-(m)->e1-(m1)->e2)
and e.ENAME='SMITH' 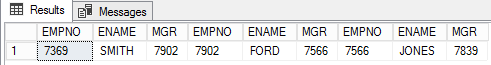
A nakonec dotaz pro zaměstnance a třetí úroveň manažerů.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m, empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
    MATCH(e-(m)->e1-(m1)->e2-(m2)->e3)
and e.ENAME='SMITH' 
Nyní změňme směr, abychom získali nadřízené Smitha.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m, empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
MATCH(e<-(m)-e1<-(m1)-e2<-(m2)-e3) 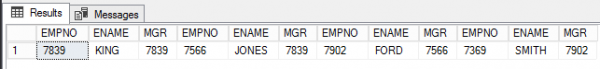
Závěr
SQL Server 2017 se etabloval jako komplexní podnikové řešení pro různé IT úkoly v obchodu. První verze SQL Graph je velmi slibná. I přes některá omezení již nyní nabízí dostatek funkcionality pro zkoumání možností grafů.
Funkcionalita SQL Graph je plně integrována do SQL Engine. Jak již bylo uvedeno, SQL Server 2017 má následující omezení:
Nepodporuje polymorfismus.
- Podporovány jsou pouze jednosměrné vazby.
- Na hranách nelze aktualizovat sloupce $from_id a $to_id pomocí UPDATE.
- Nepodporují se tranzitivní uzávěry (transitive closure), ale mohou být získány s pomocí CTE.
- Omezená podpora objektů In-Memory OLTP.
- Nepodporují se časově řízené tabulky (System-Versioned Temporal Table), dočasné místní a globální tabulky.
- Tabulkové typy a tabulkové proměnné nemohou být deklarovány jako NODE nebo EDGE.
- Nepodporují se dotazy mezi databázemi (cross-database queries).
- Neexistuje přímý způsob nebo žádný průvodce (wizard) pro převod běžných tabulek na grafové.
- Pro zobrazení grafů neexistuje GUI, ale lze použít Power BI.
Číst víc:
Zdroj: habr.com
