

Nebo trochu praktické tetrisologie.
Všechno nové je dobře zapomenuté staré.
Epigrafy.
Formulace úkolu
Je nutné pravidelně stahovat aktuální log soubor PostgreSQL z cloudu AWS na lokální Linux host. Ne v reálném čase, ale řekněme s malým zpožděním.
Doba stahování aktualizace log souboru je 5 minut.
Log soubor na AWS se rotuje každou hodinu.
Používané nástroje
Pro stahování log souboru na host se používá bash skript, který volá API AWS „».
Parametry:
- —db-instance-identifier: Název instance v AWS;
- —log-file-name: název aktuálního vygenerovaného log souboru
- —max-item: Celkový počet prvků vrácených ve výstupu příkazu.Velikost části stahovaného souboru.
- —starting-token: Označení počáteční části
V tomto konkrétním případě vznikl úkol stahování logů při práci na
A prostě - zajímavý úkol, pro cvičení a rozmanitost v průběhu pracovní doby.
Předpokládám, že úkol už byl z důvodu každodennosti vyřešen. Ale rychlé vyhledávání na Googlu nenalezlo žádná řešení a neměl jsem zvláštní chuť hledat hlouběji. V každém případě - dobrý trénink.
Formalizace úkolu
Konečný log soubor představuje množství řádků proměnlivé délky. Graficky lze log soubor představit zhruba takto:
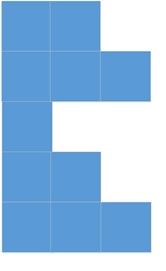
Už to něco připomíná? Jak to souvisí s „tetrisem“? A takto.
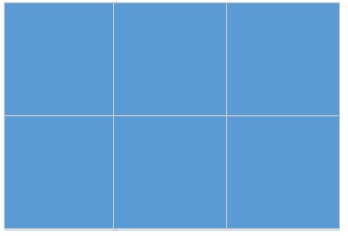
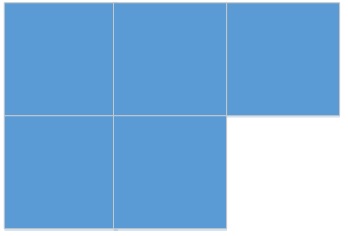
Pokud graficky představíme možné varianty, které vznikají při stahování nového souboru (pro zjednodušení, v tomto případě, ať mají řádky stejnou délku), dostaneme standardní tetrisové tvary:
1) Soubor byl stažen úplně a je konečný. Velikost části je větší než velikost konečného souboru:
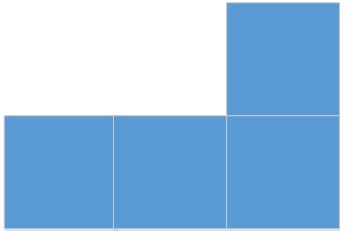
2) Soubor má pokračování. Velikost části je menší než velikost konečného souboru:
3) Soubor je pokračováním předchozího souboru a má pokračování. Velikost části je menší než zbytek konečného souboru:
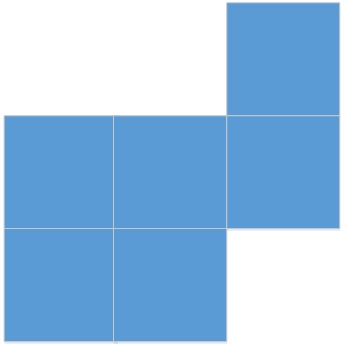
4) Soubor je pokračováním předchozího souboru a je konečný. Velikost části je větší než zbytek konečného souboru:
Úkol je sestavit obdélník nebo si zahrát tetris na nové úrovni.
Problémy, které vznikají při řešení úkolu
1) Složit řetězec ze 2 částí
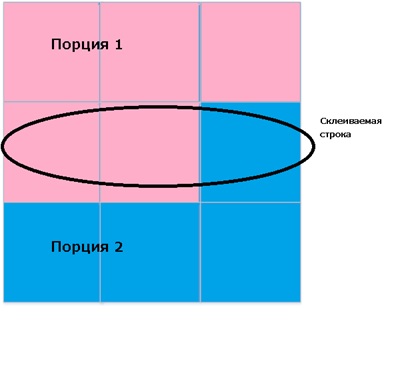
Žádné zvláštní problémy nenastaly. Standardní úkol z úvodního kurzu programování.
Optimální velikost části
A tohle je o něco zajímavější.
Bohužel nelze použít posun po označení počáteční dávky:
Jak již víte, možnost —starting-token se používá k určení, kde začít stránkování. Tato volba bere hodnoty typu String, což znamená, že pokud se pokusíte přidat hodnotu posunu před řetězec Next Token, možnost nebude považována za posun.
A proto musíme číst po částech.
Pokud čtete ve velkých dávkách, počet čtení bude minimální, ale objem bude maximální.
Pokud čtete v malých dávkách, naopak, počet čtení bude maximální, ale objem bude minimální.
Proto, aby se snížil provoz a pro celkovou krásu řešení, museli jsme vymyslet jakési řešení, které bohužel vypadá trochu jako kostra.
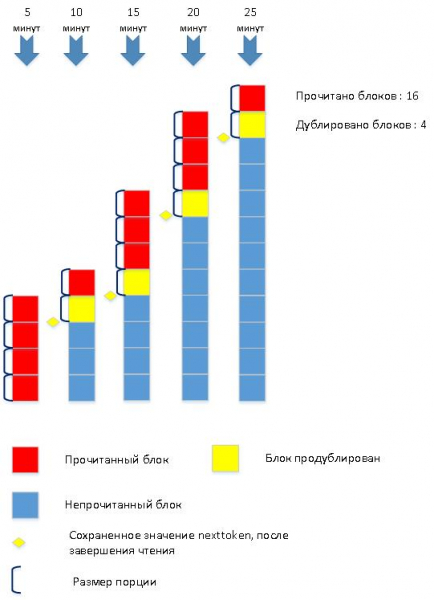
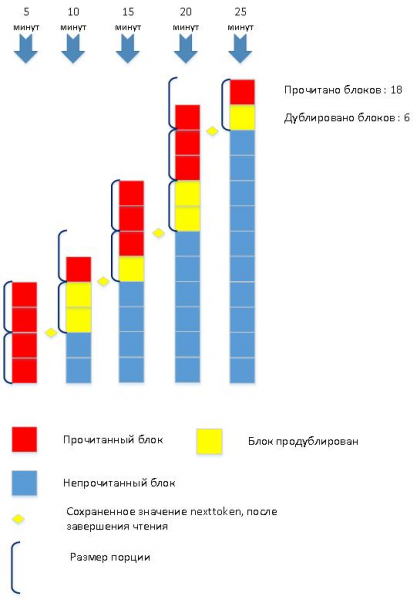
Pro ilustraci zvažme proces načítání logového souboru ve dvou výrazně zjednodušených variantách. Počet čtení v obou případech závisí na velikosti dávky.
1) Načítáme v malých dávkách:
2) Načítáme ve velkých dávkách:
Jak obvykle, optimálním řešením je compromise..
Velikost dávky je minimální, ale v průběhu čtení je možné velikost zvětšit, aby se snížil počet čtení.
Je třeba poznamenat, že zcela úkol nalezení optimální velikosti čtené dávky není dosud vyřešen a vyžaduje hlubší zpracování a analýzu. Možná později.
Obecný popis implementace
Používané servisní tabulky
CREATE TABLE endpoint
(
id SERIAL ,
host text
);

TABLE database
(
id SERIAL ,
…
last_aws_log_time text ,
last_aws_nexttoken text ,
aws_max_item_size integer
);
last_aws_log_time — časová značka posledního načteného logového souboru ve formátu YYYY-MM-DD-HH24.
last_aws_nexttoken — textová značka poslední načtené dávky.
aws_max_item_size- empiricky určená počáteční velikost dávky.
Celý text skriptu
download_aws_piece.sh
#!/bin/bash
#########################################################
# download_aws_piece.sh
# downloan piece of log from AWS
# version HABR
 let min_item_size=1024
 let max_item_size=1048576
 let growth_factor=3
 let growth_counter=1
 let growth_counter_max=3

 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:''STARTED'

 AWS_LOG_TIME=$1
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:AWS_LOG_TIME='$AWS_LOG_TIME

 database_id=$2
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:database_id='$database_id
 RESULT_FILE=$3

 endpoint=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE_DATABASE -A -t -c "select e.host from endpoint e join database d on e.id = d.endpoint_id where d.id = $database_id "`
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:endpoint='$endpoint

 db_instance=`echo $endpoint | awk -F"." '{print toupper($1)}'`

 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:db_instance='$db_instance

 LOG_FILE=$RESULT_FILE'.tmp_log'
 TMP_FILE=$LOG_FILE'.tmp'
 TMP_MIDDLE=$LOG_FILE'.tmp_mid'
 TMP_MIDDLE2=$LOG_FILE'.tmp_mid2'

 current_aws_log_time=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select last_aws_log_time from database where id = $database_id "`

 echo $(date +%Y%m%d%H%M)':      download_aws_piece.sh:current_aws_log_time='$current_aws_log_time

  if [[ $current_aws_log_time != $AWS_LOG_TIME  ]];
  then
    is_new_log='1'
	if ! psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -q -c "update database set last_aws_log_time = '$AWS_LOG_TIME' where id = $database_id "
	then
	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - update database set last_aws_log_time .'
	  exit 1
	fi
  else
    is_new_log='0'
  fi

  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:is_new_log='$is_new_log

  let last_aws_max_item_size=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select aws_max_item_size from database where id = $database_id "`
  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: last_aws_max_item_size='$last_aws_max_item_size

  let count=1
  if [[ $is_new_log == '1' ]];
  then
	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF NEW AWS LOG'
	if ! aws rds download-db-log-file-portion
		--max-items $last_aws_max_item_size
		--region REGION
		--db-instance-identifier  $db_instance
		--log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 2
	fi
  else
    next_token=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -c "select last_aws_nexttoken from database where id = $database_id "`

	if [[ $next_token == '' ]];
	then
	  next_token='0'
	fi

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: CONTINUE DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
	    --max-items $last_aws_max_item_size
		--starting-token $next_token
		--region REGION
		--db-instance-identifier  $db_instance
		--log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 3
	fi

	line_count=`cat  $LOG_FILE | wc -l`
	let lines=$line_count-1

	tail -$lines $LOG_FILE > $TMP_MIDDLE
	mv -f $TMP_MIDDLE $LOG_FILE
  fi

  next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
  next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

  grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

  if [[ $next_token == '' ]];
  then
	  cp $TMP_FILE $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
          rm $TMP_MIDDLE2
	  exit 0
  else
	psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "
  fi

  first_str=`tail -1 $TMP_FILE`

  line_count=`cat  $TMP_FILE | wc -l`
  let lines=$line_count-1

  head -$lines $TMP_FILE  > $RESULT_FILE

###############################################
# MAIN CIRCLE
  let count=2
  while [[ $next_token != '' ]];
  do
    echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: count='$count

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
             --max-items $last_aws_max_item_size
             --starting-token $next_token
             --region REGION
             --db-instance-identifier  $db_instance
             --log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 4
	fi

	next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
	next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

	TMP_FILE=$LOG_FILE'.tmp'
	grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

	last_str=`head -1 $TMP_FILE`

    if [[ $next_token == '' ]];
	then
	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  tail -$lines $TMP_FILE >> $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
          rm $TMP_MIDDLE2
	  exit 0
	fi

    if [[ $next_token != '' ]];
	then
		let growth_counter=$growth_counter+1
		if [[ $growth_counter -gt $growth_counter_max ]];
		then
			let last_aws_max_item_size=$last_aws_max_item_size*$growth_factor
			let growth_counter=1
		fi

		if [[ $last_aws_max_item_size -gt $max_item_size ]];
		then
			let last_aws_max_item_size=$max_item_size
		fi

	  psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "

	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  #############################
	  #Get middle of file
	  head -$lines $TMP_FILE > $TMP_MIDDLE

	  line_count=`cat  $TMP_MIDDLE | wc -l`
	  let lines=$line_count-1
	  tail -$lines $TMP_MIDDLE > $TMP_MIDDLE2

	  cat $TMP_MIDDLE2 >> $RESULT_FILE

	  first_str=`tail -1 $TMP_FILE`
	fi

    let count=$count+1

  done
#
#################################################################

exit 0
Úryvky skriptu s některými vysvětlivkami:
Vstupní parametry skriptu:
- Časová značka názvu logového souboru ve formátu YYYY-MM-DD-HH24: AWS_LOG_TIME=$1
- ID databáze: database_id=$2
- Název sestaveného logového souboru: RESULT_FILE=$3
Získat časovou značku posledního načteného logového souboru:
current_aws_log_time=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select last_aws_log_time from database where id = $database_id "`Pokud se časová značka posledního načteného logového souboru neshoduje se vstupním parametrem — načte se nový logový soubor:
pokud [[ $current_aws_log_time != $AWS_LOG_TIME ]];
  pak
    is_new_log='1'
	pokud ! psql -h ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -c "update database set last_aws_log_time = '$AWS_LOG_TIME' where id = $database_id "
	potom
	  echo '***download_aws_piece.sh -FATAL_ERROR - update database set last_aws_log_time .'
	  exit 1
	fi
  jinak
    is_new_log='0'
  fi
Získáváme hodnotu značky nexttoken ze staženého souboru:
  next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
  next_token=`echo $next_token_str | awk -F" " '{ print $2}' `
Znamením konce načítání je prázdná hodnota nexttoken.
V cyklu počítáme porce souboru, přičemž připojujeme řádky a zvyšujeme velikost porce:
Hlavní cyklus
# MAIN CIRCLE
  let count=2
  while [[ $next_token != '' ]];
  do
    echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: count='$count

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
     --max-items $last_aws_max_item_size
	 --starting-token $next_token
     --region REGION
     --db-instance-identifier  $db_instance
     --log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 4
	fi

	next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
	next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

	TMP_FILE=$LOG_FILE'.tmp'
	grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

	last_str=`head -1 $TMP_FILE`

    if [[ $next_token == '' ]];
	then
	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  tail -$lines $TMP_FILE >> $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
         rm $TMP_MIDDLE2
	  exit 0
	fi

    if [[ $next_token != '' ]];
	then
		let growth_counter=$growth_counter+1
		if [[ $growth_counter -gt $growth_counter_max ]];
		then
			let last_aws_max_item_size=$last_aws_max_item_size*$growth_factor
			let growth_counter=1
		fi

		if [[ $last_aws_max_item_size -gt $max_item_size ]];
		then
			let last_aws_max_item_size=$max_item_size
		fi

	  psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "

	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  #############################
	  #Get middle of file
	  head -$lines $TMP_FILE > $TMP_MIDDLE

	  line_count=`cat  $TMP_MIDDLE | wc -l`
	  let lines=$line_count-1
	  tail -$lines $TMP_MIDDLE > $TMP_MIDDLE2

	  cat $TMP_MIDDLE2 >> $RESULT_FILE

	  first_str=`tail -1 $TMP_FILE`
	fi

    let count=$count+1

  done
Co dál?
Takže první mezikrok — „stáhnout log soubor z cloudu“ je splněn. Co dělat se staženým logem?
Nejprve je nutné analyzovat log soubor a vybrat z něj samotné dotazy.
Úkol není příliš složitý. Nejjednodušší bash-script si s tím poradí.
upload_log_query.sh
#!/bin/bash
#########################################################
# upload_log_query.sh
# Upload table table from dowloaded aws file
# version HABR
###########################################################
echo 'TIMESTAMP:'$(date +%c)' Upload log_query table '
source_file=$1
echo 'source_file='$source_file
database_id=$2
echo 'database_id='$database_id

beginer=' '
first_line='1'
let "line_count=0"
sql_line=' '
sql_flag=' '
space=' '
cat $source_file | while read line
do
  line="$space$line"

  if [[ $first_line == "1" ]]; then
    beginer=`echo $line | awk -F" " '{ print $1}' `
    first_line='0'
  fi

  current_beginer=`echo $line | awk -F" " '{ print $1}' `

  if [[ $current_beginer == $beginer ]]; then
    if [[ $sql_flag == '1' ]]; then
     sql_flag='0'
     log_date=`echo $sql_line | awk -F" " '{ print $1}' `
     log_time=`echo $sql_line | awk -F" " '{ print $2}' `
     duration=`echo $sql_line | awk -F" " '{ print $5}' `

     #replace ' to ''
     sql_modline=`echo "$sql_line" | sed 's/'''/''''''/g'`
     sql_line=' '

	 ################
	 #PROCESSING OF THE SQL-SELECT IS HERE
     if ! psql -h ENDPOINT.rds.amazonaws.com -U USER -d DATABASE -v ON_ERROR_STOP=1 -A -t -c "select log_query('$ip_port',$database_id , '$log_date' , '$log_time' , '$duration' , '$sql_modline' )"
     then
        echo 'FATAL_ERROR - log_query '
        exit 1
     fi
	 ################

    fi #if [[ $sql_flag == '1' ]]; then

    let "line_count=line_count+1"

    check=`echo $line | awk -F" " '{ print $8}' `
    check_sql=${check^^}

    #echo 'check_sql='$check_sql

    if [[ $check_sql == 'SELECT' ]]; then
     sql_flag='1'
     sql_line="$sql_line$line"
	 ip_port=`echo $sql_line | awk -F":" '{ print $4}' `
    fi
  else

    if [[ $sql_flag == '1' ]]; then
      sql_line="$sql_line$line"
    fi

  fi #if [[ $current_beginer == $beginer ]]; then

done
Nyní s vybraným dotazem z log souboru můžeme pracovat.
A užitečných možností se otevírá několik.
Analyzované dotazy je třeba někde uchovávat. K tomu se používá servisní tabulka log_query
CREATE TABLE log_query
(
   id SERIAL ,
   queryid bigint ,
   query_md5hash text not null ,
   database_id integer not null ,
   timepoint timestamp without time zone not null,
   duration double precision not null ,
   query text not null ,
   explained_plan text[],
   plan_md5hash text  ,
   explained_plan_wo_costs text[],
   plan_hash_value text  ,
   baseline_id integer ,
   ip text ,
   port text
);
ALTER TABLE log_query ADD PRIMARY KEY (id);
ALTER TABLE log_query ADD CONSTRAINT queryid_timepoint_unique_key UNIQUE (queryid, timepoint );
ALTER TABLE log_query ADD CONSTRAINT query_md5hash_timepoint_unique_key UNIQUE (query_md5hash, timepoint );

CREATE INDEX log_query_timepoint_idx ON log_query (timepoint);
CREATE INDEX log_query_queryid_idx ON log_query (queryid);
ALTER TABLE log_query ADD CONSTRAINT database_id_fk FOREIGN KEY (database_id) REFERENCES database (id) ON DELETE CASCADE ;
Zpracování analyzovaného dotazu se provádí v plpgsql funkci „log_query».
log_query.sql
--log_query.sql
--verison HABR
CREATE OR REPLACE FUNCTION log_query( ip_port text ,log_database_id integer , log_date text , log_time text , duration text , sql_line text   ) RETURNS boolean AS $$
DECLARE
  result boolean ;
  log_timepoint timestamp without time zone ;
  log_duration double precision ;
  pos integer ;
  log_query text ;
  activity_string text ;
  log_md5hash text ;
  log_explain_plan text[] ;

  log_planhash text ;
  log_plan_wo_costs text[] ;

  database_rec record ;

  pg_stat_query text ;
  test_log_query text ;
  log_query_rec record;
  found_flag boolean;

  pg_stat_history_rec record ;
  port_start integer ;
  port_end integer ;
  client_ip text ;
  client_port text ;
  log_queryid bigint ;
  log_query_text text ;
  pg_stat_query_text text ;
BEGIN
  result = TRUE ;

  RAISE NOTICE '***log_query';

  port_start = position('(' in ip_port);
  port_end = position(')' in ip_port);
  client_ip = substring( ip_port from 1 for port_start-1 );
  client_port = substring( ip_port from port_start+1 for port_end-port_start-1 );

  SELECT e.host , d.name , d.owner_pwd
  INTO database_rec
  FROM database d JOIN endpoint e ON e.id = d.endpoint_id
  WHERE d.id = log_database_id ;

  log_timepoint = to_timestamp(log_date||' '||log_time,'YYYY-MM-DD HH24-MI-SS');
  log_duration = duration:: double precision;


  pos = position ('SELECT' in UPPER(sql_line) );
  log_query = substring( sql_line from pos for LENGTH(sql_line));
  log_query = regexp_replace(log_query,' +',' ','g');
  log_query = regexp_replace(log_query,';+','','g');
  log_query = trim(trailing ' ' from log_query);


  log_md5hash = md5( log_query::text );

  --Explain execution plan--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
  --------------------------
  BEGIN
	INSERT INTO log_query
	(
		query_md5hash ,
		database_id ,
		timepoint ,
		duration ,
		query ,
		explained_plan ,
		plan_md5hash ,
		explained_plan_wo_costs ,
		plan_hash_value ,
		ip ,
		port
	)
	VALUES
	(
		log_md5hash ,
		log_database_id ,
		log_timepoint ,
		log_duration ,
		log_query ,
		log_explain_plan ,
		md5(log_explain_plan::text) ,
		log_plan_wo_costs ,
		md5(log_plan_wo_costs::text),
		client_ip ,
		client_port
	);
	activity_string = 	'Nový dotaz byl zaznamenán '||
						' database_id = '|| log_database_id ||
						' query_md5hash='||log_md5hash||
						' , timepoint = '||to_char(log_timepoint,'YYYYMMDD HH24:MI:SS');

	RAISE NOTICE '%',activity_string;

	PERFORM pg_log( log_database_id , 'log_query' , activity_string);

	EXCEPTION
	  WHEN unique_violation THEN
		RAISE NOTICE '*** unique_violation *** dotaz již byl zaznamenán';
	END;

	SELECT 	queryid
	INTO   	log_queryid
	FROM 	log_query
	WHERE 	query_md5hash = log_md5hash AND
			timepoint = log_timepoint;

	IF log_queryid IS NOT NULL
	THEN
	  RAISE NOTICE 'log_query s query_md5hash = % a timepoint = % již má QUERYID = %',log_md5hash,log_timepoint , log_queryid ;
	  RETURN result;
	END IF;

	------------------------------------------------
	RAISE NOTICE 'Aktualizace queryid';

	SELECT *
	INTO log_query_rec
	FROM log_query
	WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;

	log_query_rec.query=regexp_replace(log_query_rec.query,';+','','g');

	FOR pg_stat_history_rec IN
	 SELECT
         queryid ,
	  query
	 FROM
         pg_stat_db_queries
     WHERE
      database_id = log_database_id AND
       queryid is not null
	LOOP
	  pg_stat_query = pg_stat_history_rec.query ;
	  pg_stat_query=regexp_replace(pg_stat_query,'n+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'t+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,' +',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'$.','%','g');

	  log_query_text = trim(trailing ' ' from log_query_rec.query);
	  pg_stat_query_text = pg_stat_query;


	  --SELECT log_query_rec.query like pg_stat_query INTO found_flag ;
	  IF (log_query_text LIKE pg_stat_query_text) THEN
		found_flag = TRUE ;
	  ELSE
		found_flag = FALSE ;
	  END IF;


	  IF found_flag THEN

		UPDATE log_query SET queryid = pg_stat_history_rec.queryid WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;
		activity_string = 	' aktualizován queryid = '||pg_stat_history_rec.queryid||
		                    ' pro log_query s id = '||log_query_rec.id
		   				    ;
	    RAISE NOTICE '%',activity_string;
		EXIT ;
	  END IF ;

	END LOOP ;

  RETURN result ;
END
$$ LANGUAGE plpgsql;
Při zpracování se používá služební tabulka pg_stat_db_queries, obsahující snímek aktuálních dotazů z tabulky pg_stat_history (Použití tabulky je popsáno zde — )
TABLE pg_stat_db_queries
(
   database_id integer,
   queryid bigint ,
   query text ,
   max_time double precision
);
TABLE pg_stat_history
(
…
database_id integer ,
…
queryid bigint ,
…
max_time double precision	 ,
…
);
Funkce umožňuje provádět řadu užitečných operací při zpracování dotazů z logovacího souboru. A to konkrétně:
Možnost č. 1 — Historie provádění dotazů
Velmi užitečné pro zahájení řešení incidentu s výkonem. Nejprve se seznámit s historií — a kdy začalo zpomalení?
Následně, tradičně – hledání externích příčin. Možná došlo k náhlému zvýšení zátěže databáze a konkrétní dotaz s tím nemá nic společného.
Přidat nový záznam do tabulky log_query
  port_start = position('(' in ip_port);
  port_end = position(')' in ip_port);
  client_ip = substring( ip_port from 1 for port_start-1 );
  client_port = substring( ip_port from port_start+1 for port_end-port_start-1 );

  SELECT e.host , d.name , d.owner_pwd
  INTO database_rec
  FROM database d JOIN endpoint e ON e.id = d.endpoint_id
  WHERE d.id = log_database_id ;

  log_timepoint = to_timestamp(log_date||' '||log_time,'YYYY-MM-DD HH24-MI-SS');
  log_duration = to_number(duration,'99999999999999999999D9999999999');


  pos = position ('SELECT' in UPPER(sql_line) );
  log_query = substring( sql_line from pos for LENGTH(sql_line));
  log_query = regexp_replace(log_query,' +',' ','g');
  log_query = regexp_replace(log_query,';+','','g');
  log_query = trim(trailing ' ' from log_query);

  RAISE NOTICE 'log_query=%',log_query ;

  log_md5hash = md5( log_query::text );

  --Vysvětlit plán provádění--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
  --------------------------
  BEGIN
	INSERT INTO log_query
	(
		query_md5hash ,
		database_id ,
		timepoint ,
		duration ,
		query ,
		explained_plan ,
		plan_md5hash ,
		explained_plan_wo_costs ,
		plan_hash_value ,
		ip ,
		port
	)
	VALUES
	(
		log_md5hash ,
		log_database_id ,
		log_timepoint ,
		log_duration ,
		log_query ,
		log_explain_plan ,
		md5(log_explain_plan::text) ,
		log_plan_wo_costs ,
		md5(log_plan_wo_costs::text),
		client_ip ,
		client_port
	);
Možnost č. 2 — Ukládat plány provádění dotazů
Na tomto místě může vzniknout námitka-upřesnění-komentář: „Ale vždyť už existuje autoexplain“. Je to sice pravda, ale co z toho, když se plán provádění ukládá ve stejném logovacím souboru a pro jeho uchování pro další analýzu bude nutné parsovat logovací soubor?
Já, však, potřeboval:
za prvé: ukládat plán provádění do služební tabulky databáze monitorování;
Za druhé: mít možnost porovnávat plány vykonání navzájem, abychom viděli, že se plán vykonání dotazu změnil.
Existuje dotaz se specifickými parametry vykonání. Je jednoduchý úkol získat a uložit jeho plán vykonání pomocí EXPLAIN.
Navíc použitím výrazu EXPLAIN (COSTS FALSE) lze získat rámec plánu, který bude použit pro získání hash hodnoty plánu, což pomůže při následné analýze historie změn plánu vykonání.
Získat šablonu plánu vykonání
  --Vysvětlit plán vykonání--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
Možnost č. 3 — Využití logu dotazů pro monitoring
Jelikož jsou výkonnostní metriky nastaveny na ID dotazu, nikoli na text dotazu, je třeba spojit dotazy z logu se dotazy, pro které jsou nastaveny výkonnostní metriky.
Alespoň abychom měli přesný čas vzniku incidentu výkonnosti.
Takže při vzniku incidentu výkonnosti pro ID dotazu bude odkaz na konkrétní dotaz s konkrétními hodnotami parametrů a přesným časem vykonání a trváním dotazu. Získat tyto informace pomocí pouze pohledu — nelze. pg_stat_statements — není možné.
Najít queryid dotazu a aktualizovat záznam v tabulce log_query
SELECT *
	INTO log_query_rec
	FROM log_query
	WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;

	log_query_rec.query=regexp_replace(log_query_rec.query,';+','','g');

	FOR pg_stat_history_rec IN
	 SELECT
      queryid ,
	  query
	 FROM
       pg_stat_db_queries
     WHERE
	   database_id = log_database_id AND
       queryid is not null
	LOOP
	  pg_stat_query = pg_stat_history_rec.query ;
	  pg_stat_query=regexp_replace(pg_stat_query,'n+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'t+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,' +',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'$.','%','g');

	  log_query_text = trim(trailing ' ' from log_query_rec.query);
	  pg_stat_query_text = pg_stat_query;

	  --SELECT log_query_rec.query like pg_stat_query INTO found_flag ;
	  IF (log_query_text LIKE pg_stat_query_text) THEN
		found_flag = TRUE ;
	  ELSE
		found_flag = FALSE ;
	  END IF;


	  IF found_flag THEN

		UPDATE log_query SET queryid = pg_stat_history_rec.queryid WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;
		activity_string = 	' updated queryid = '||pg_stat_history_rec.queryid||
		                    ' for log_query with id = '||log_query_rec.id
		   				    ;

	    RAISE NOTICE '%',activity_string;
		EXIT ;
	  END IF ;

	END LOOP ;
Poznámka na závěr
Popisovaná metoda nakonec našla své uplatnění v , což umožnilo mít více informací pro analýzu při řešení vznikajících incidentů výkonu dotazů.
I když, samozřejmě, z mého osobního autorského pohledu, bude třeba ještě pracovat na algoritmu pro výběr a změnu velikosti načítané dávky. Úkol zatím nebyl vyřešen v obecném případě. Pravděpodobně to bude zajímavé.
Ale to je už úplně jiný příběh …
Zdroj: habr.com
