

Doporučuji podívat se na záznam přednášky z počátku roku 2020 od Georgije Rylova "WAL-G: nové možnosti a rozšíření komunity"
Správci open-source čelí mnoha problémům, jak rostou. Jak psát stále více požadovaných funkcí, opravovat stále více problémů a stihnout sledovat stále více požadavků na sloučení? Na příkladu WAL-G (nástroj pro zálohování pro PostgreSQL) vám povím, jak jsme tyto problémy řešili, zahájením kurzu o open-source vývoji na univerzitě, co jsme dosáhli a kam budeme směřovat dál.
Ahoj všem znovu! Jsem vývojář v Yandexu z Jekatěrinburgu. A dnes vám povím o WAL-G.
V názvu prezentace nebylo řečeno, že se jedná o něco ohledně záloh. Někdo neví, co je WAL-G? Nebo to všichni vědí? Zvedněte ruku, kdo neví. K čertu, přišli jste na přednášku a nevíte, o čem je.
Pojďme vám říci, co se dnes bude dít. Tak se stalo, že naše tým se již nějakou dobu věnuje zálohování. A je to další přednáška v sérii, kde vyprávíme o tom, jak bezpečně, spolehlivě, pohodlně a efektivně ukládáme data.
V předchozích sériích bylo mnoho přednášek Andreje Borodina, Vladimira Leskova. Bylo nás hodně. A už mnoho let jsme všichni hovořili o WAL-G.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Tato přednáška bude trochu odlišná od ostatních, protože se tam více zaměřujeme na technickou část, a zde vám povím, jak jsme se potýkali s problémy spojenými s růstem komunity. A jak jsme vymysleli malý nápad, který nám pomáhá s tímto vypořádat.
Před několika lety byl WAL-G poměrně malý projekt, který nám byl předán od Citus Data. A my jsme ho právě vzali. A vyvíjel ho jeden člověk.
A v WAL-G prakticky chybělo:
- Zálohování z repliky.
- Chyběly inkrementální zálohy.
- Chyběly WAL-Delta zálohy.
- A ještě spousta dalších věcí chyběla.
Za ta léta WAL-G výrazně narostl.
A do roku 2020 bylo již vše výše uvedené k dispozici. A navíc jsme nyní měli:
- Více než 1 000 hvězdiček na GitHubu.
- 150 forků.
- Cca 15 otevřených PR.
- A také mnoho přispěvatelů.
- A otevřených problémů neustále. A to i přesto, že tam každý den doslova chodíme a něco děláme.
A dospěli jsme k závěru, že tento projekt vyžaduje více naší pozornosti, i když nám samotným nic není potřeba realizovat pro naši službu Managed Databases v Yandexu.
A někde na podzim roku 2018 nás napadla myšlenka. Obvykle má tým několik způsobů, jak vyvíjet nové funkce nebo opravovat chyby, když nemáte dostatek lidí. Například můžete najít dalšího vývojáře a platit mu peníze. Nebo si můžete vzít stážistu na určitou dobu a také mu platit nějakou mzdu. Ale existuje také značná skupina lidí, z nichž někteří už skutečně umějí psát kód. Jenže ne vždy víte, jaké kvality ten kód je.
Rozhodli jsme se zkusit přilákat studenty. Ale studenti se nebudou účastnit všeho. Budou dělat pouze určitou část práce. Například budou psát testy, opravovat chyby, implementovat funkce, které se netýkají hlavní funkcionality. Hlavní funkcionalita zahrnuje vytváření záloh a jejich obnovování. Pokud dojde k chybě při vytváření zálohy, dojde ke ztrátě dat. A nikdo to samozřejmě nechce. Všichni chtějí, aby vše bylo velmi spolehlivé. Proto kód, kterému důvěřujeme méně než svému vlastnímu, do něj samozřejmě chtít nepustíme. Tedy jakýkoli nekritický kód je to, co bychom chtěli dostat od našich dalších pracovních sil.
Za jakých podmínek se přijímá PR studenta
- Musí pokrývat svůj kód testy. Vše by mělo probíhat v CI.
- Také procházíme dvěma revizemi. Jedna od Andreje Borodina a druhá moje.
- A navíc, abych zkontroloval, že to nezlomí nic v našem servisu, zvlášť nahrávám sestavení s tímto commitem. A kontrolujeme pomocí end-to-end testů, že nám nic nepadá.
Speciální kurz o Open Source
Trochu o tom, proč je to potřeba a proč se mi to zdá jako skvělý nápad.
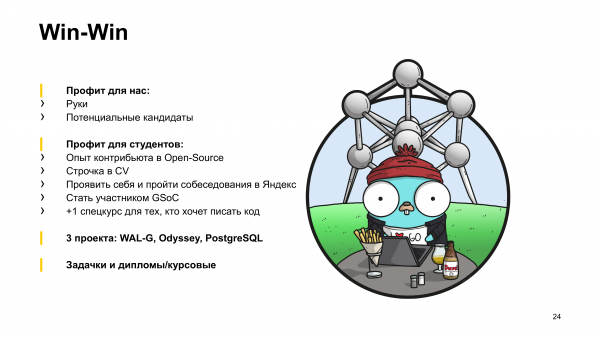
Pro nás je profit zřejmý:
- Získáváme další ruce.
- A hledáme kandidáty do týmu mezi schopnými studenty, kteří píší kvalitní kód.
Jaký je profit pro studenty?
Může být méně zřejmý, protože studenti alespoň nedostávají peníze za ten kód, který píší, ale dostávají pouze známky do zápočtového listu.
Zeptal jsem se jich na to. A podle jejich slov:
- Zkušenost přispěvatele v Open Source.
- Získat položku do životopisu.
- Projevit se a projít pohovorem v Yandexu.
- Stát se účastníkem GSoC.
- +1 speciální kurz pro ty, kteří chtějí psát kód.
Nebudu mluvit o tom, jak byl kurz organizován. Jen řeknu, že WAL-G byl hlavním projektem. A také jsme do tohoto kurzu zahrnuli projekty jako Odyssey, PostgreSQL a ClickHouse.
A úkoly byly zadávány nejen v tomto kurzu, ale také byly udělovány diplomy a semestrální práce.
A co profit pro uživatele?
Teď se dostaneme k části, která vás pravděpodobně více zajímá. Jaký z toho máte užitek? Užitek je v tom, že studenti opravili mnoho chyb. A vytvořili funkce, o které jste nás žádali.
A dovolte mi říct o věcech, které jste dlouho chtěli a které byly realizovány.
Podpora tablespaces. Tablespaces v WAL-G se čekaly pravděpodobně od doby, kdy byl WAL-G uveden na trh, protože WAL-G je nástupcem jiného nástroje pro zálohování WAL-E, kde byly podporovány zálohy databází s tablespaces.
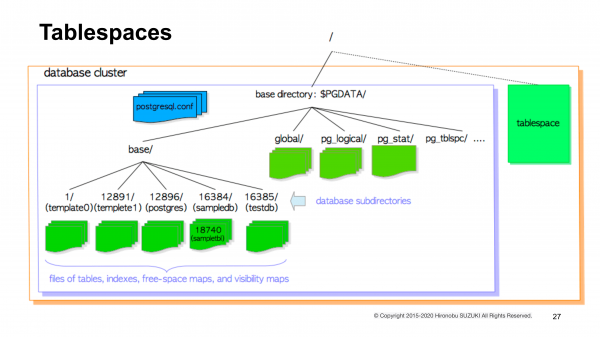
Krátce si připomeneme, co to vlastně je a proč je to všechno potřeba. Obvykle všechny vaše data PostgreSQL zabírají jeden adresář v souborovém systému, který se nazývá základní. A tento adresář již obsahuje všechny soubory a podadresáře potřebné pro PostgreSQL.
Tablespaces jsou adresáře, ve kterých se nacházejí data PostgreSQL, ale nezabírají místo mimo základní adresář. Na snímku je vidět, že tablespaces se nacházejí mimo základní adresář.
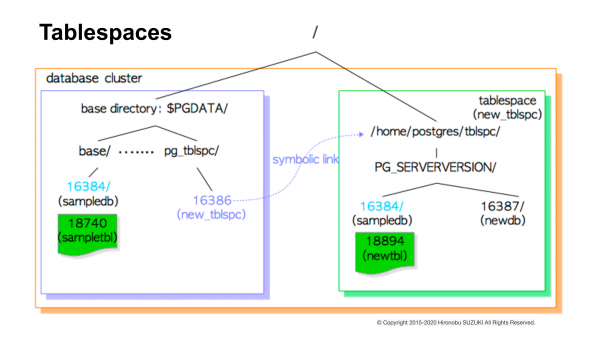
Jak to vypadá pro samotný PostgreSQL? V základním adresáři je samostatný podadresář pg_tblspc. A v něm jsou symlinky na adresáře, ve kterých se skutečně nachází data PostgreSQL mimo základní adresář.
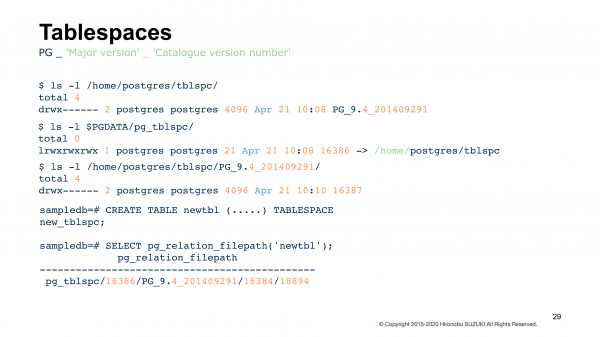
Když to všechno používáte, pro vás tyto příkazy mohou vypadat nějak takto. T. j. vytvoříte tabulku v nějakém zvoleném tablespace a podíváte se, kde ji nyní máte. Tyto dvě poslední řádky, dva poslední zavolané příkazy. A tam je vidět, že existuje nějaká cesta. Ale ve skutečnosti – to není skutečná cesta. Je to cesta s prefixem z základního adresáře k tablespace. A odtud je spárována symlinkem, který směřuje k vašim skutečným datům.
My to vše nepoužíváme v našem týmu, ale bylo to využíváno mnoha dalšími uživateli WAL-E, kteří nám psali, že chtějí přejít na WAL-G, ale to jim bránilo. Nyní je to podporováno.
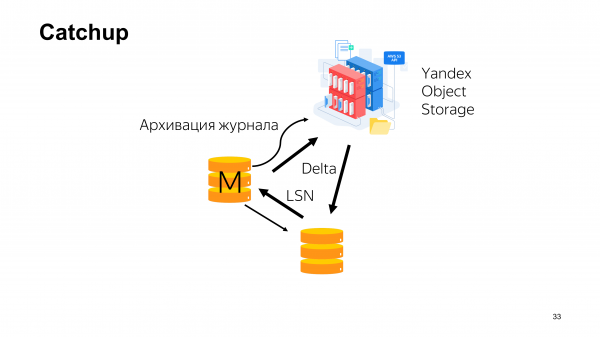
Další funkce, kterou nám přinesl náš specializovaný kurz, je catchup. O catchupu vědí lidé, kteří pravděpodobně více pracovali s Oracle než s PostgreSQL.
Stručně o tom, co to je. Takto může obvykle vypadat topologie clusteru v naší službě. Máme mastera. Existuje replikace, která streamuje write-ahead log. A replikace informuje mastera, na jakém LSN se právě nachází. A někde paralelně s tím se může archívovat žurnál. Kromě archívace žurnálu se také posílají zálohy do cloudu. A odesílají se delta-zálohy.
Jaký může být problém? Když máte docela velkou databázi, může se stát, že replikace začne zaostávat za masterem. A ona zaostává tak silně, že jej už nikdy nemůže dohnat. Tento problém je obvykle třeba nějak vyřešit.
A nejjednodušší způsob je odstranit replikaci a nalít ji znovu, protože ji už nikdy dohnat nemůže a je třeba se s problémem vyrovnat. Ale to trvá docela dlouho, protože obnovit celou zálohu databáze o velikosti 10 TB – to je velmi, velmi dlouhé. A chceme to dělat co nejrychleji, když takové problémy nastanou. A právě k tomu je určen catchup.
Catchup umožňuje používat delta-zálohy, které se ukládají do cloudu tímto způsobem. Řeknete, na jakém LSN se právě nachází zaostávající replikace a uvedete jej v příkazu catchup, abyste vytvořili delta-zálohu mezi tímto LSN a LSN, na kterém se právě nachází váš cluster. A poté obnovíte tuto zálohu na replikaci, která zaostávala.
Další databáze
Navíc nám studenti přinesli hned několik funkcí. Protože v Yandexu se nezaměřujeme pouze na Postgres, máme také MySQL, MongoDB, Redis, ClickHouse, takže v nějakém okamžiku jsme potřebovali, abychom mohli dělat zálohy s point-in-time recovery pro MySQL a aby byla možnost je nahrát do cloudu.
A chtěli jsme to dělat nějak podobným způsobem, jakým to dělá WAL-G. A rozhodli jsme se experimentovat a podívat se, jak to všechno bude vypadat.
A zprvu jsme tuto logiku nijak nerozlišovali v forku, napsali jsme kód. Viděli jsme, že máme nějaký funkční model a že to může fungovat. Pak jsme si uvědomili, že naše hlavní komunita jsou postgresisté, kteří používají WAL-G. A proto je potřeba tyto části nějak oddělit. Tedy když upravujeme kód pro Postgres, nezlomíme MySQL, a když upravujeme MySQL, nezlomíme Postgres.
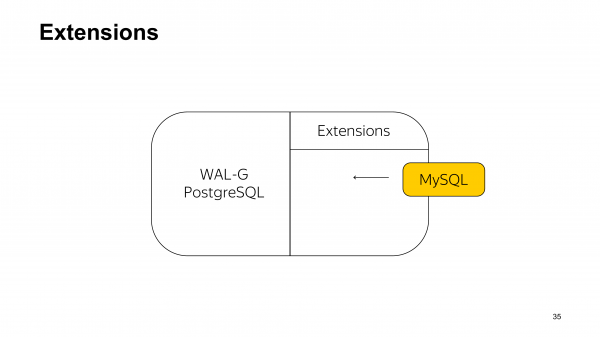
První myšlenkou, jak to rozdělit, bylo použít stejný přístup, jaký se používá v extensions PostgreSQL. A vlastně, abyste provedli zálohu MySQL, museli jste nainstalovat nějakou dynamickou knihovnu.
Ale hned je vidět asymetričnost tohoto přístupu. Když zálohujete Postgres, nainstalujete na něj normální zálohovací nástroj pro Postgres a vše funguje skvěle. A pro MySQL to vychází tak, že nainstalujete zálohovací nástroj pro Postgres a k tomu ještě dynamickou knihovnu pro MySQL. Zní to nějak zvláštně. I my jsme na to pomysleli a rozhodli jsme se, že to není to řešení, které potřebujeme.
Různé sestavení pro Postgres, MySQL, MongoDB, Redis
Ale to nám, jak si myslíme, umožnilo dospět k správnému řešení - vyčlenit různá sestavení pro různé databáze. Tím jsme mohli izolovat logiku spojenou se zálohami různých databází, které budou přistupovat ke společnému API, které implementuje WAL-G.
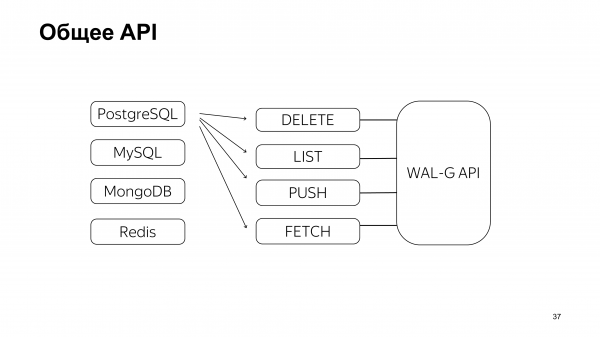
To je ta část, kterou jsme napsali sami - předtím, než jsme uvedli studentům úkoly. Tedy toto je ta část, kde mohli něco udělat špatně, proto jsme se rozhodli, že lépe uděláme něco tak, aby všechno bylo skvělé.
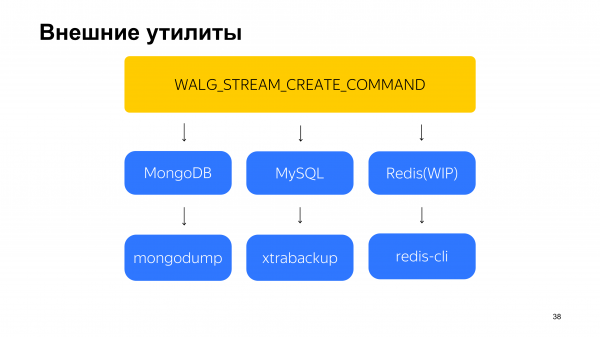
Po tom jsme zadali úkoly. Ty hned převzali. Od studentů se očekávalo, že podpoří tři databáze.
To je MySQL, kterou zálohujeme pomocí WAL-G tímto způsobem už více než rok.
A nyní se MongoDB blíží k produkci, tam ji jemně dolaďují. V podstatě jsme napsali kostru pro to všechno. Poté studenti napsali nějaké funkční věci. A poté je dovedeme do stavu, který můžeme přijmout do našeho produkčního prostředí.
Tyto úkoly nevypadaly tak, že by studenti museli napsat kompletní zálohovací nástroje pro každou z těchto databází. Toto nebyl náš problém. Naším problémem bylo to, že jsme chtěli point-in-time recovery a chtěli jsme zálohovat do cloudu. A požádali jsme studenty, aby napsali nějaký kód, který to bude řešit. Studenti využili již existující zálohovací nástroje, které nějakým způsobem provádějí zálohy, a potom to spojili s WAL-G, který všechno přenášel do cloudu. A také k tomu přidali point-in-time recovery.
Co ještě přinesli studenti? Přinesli do WAL-G podporu šifrování Libsodium.
Také jsme zavedli zásady uchovávání záloh. Nyní lze zálohy označovat jako trvalé. A je nějak pohodlnější pro vaši službu automatizovat proces jejich uchovávání.
Co se z tohoto experimentu vyvinulo?
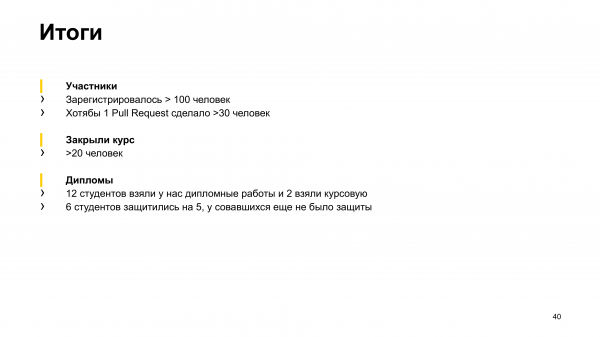
Na kurz se původně zaregistrovalo více než 100 lidí. Na začátku jsem neřekl, že univerzita v Jekatěrinburgu je Uralská federální univerzita. Tam jsme to všechno oznámili. 100 lidí se zaregistrovalo. Opravu něco začalo dělat mnohem méně, přibližně 30 lidí.
Kurz uzavřelo ještě méně lidí, protože bylo potřeba napsat testy k již existujícím kódům. A také opravit nějakou chybu nebo vytvořit nějakou funkci. A část studentů kurz opravdu dokončila.
V současné době studenti v tomto kurzu opravili přibližně 14 problémů, vytvořili 10 funkcí různých velikostí. A, jak se domnívám, je to plnohodnotná náhrada jednoho až dvou vývojářů.
Kromě toho jsme vydávali diplomy a závěrečné práce. 12 z nich získalo diplomy. 6 z nich už obhájilo na „5“. U zbývajících obhajoby ještě nebyly, ale myslím, že to u nich také dopadne dobře.
Plány do budoucna
Jaké máme plány do budoucna?
Minimálně ty požadavky na funkce, které jsme od uživatelů slyšeli a chceme je realizovat. To je:
- Sledování správnosti sledování časového plánu v archivu záloh HA-klastru. S pomocí WAL-G je to možné. A myslím, že najdeme studenty, kteří se toho ujmou.
- Za přenos záloh a WAL mezi cloudy už máme odpovědného člověka.
- A nedávno jsme zveřejnili nápad na to, jak můžeme urychlit WAL-G ještě víc pomocí rozbalování inkrementálních záloh bez přepisování stránek a optimalizace archivů, které tam posíláme.
Můžete se o ně podělit tady
K čemu byla tato prezentace? K tomu, že nyní, kromě nás čtyř lidí, kteří tento projekt podporují, máme spoustu dalších rukou. Zejména, pokud jim napíšete soukromou zprávu. A pokud zálohujete svá data a děláte to pomocí WAL-G nebo byste chtěli přejít na WAL-G, vaše přání můžeme snadno zohlednit.
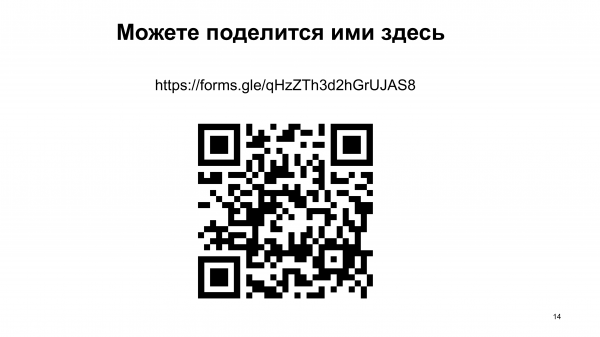
Tohle je qr-kód a odkaz. Můžete se podle nich dostat a napsat všechny vaše požadavky. Například, nějakou chybu neopravujeme. Nebo nějakou funkci, kterou velmi chcete, ale nějakým způsobem ještě není v žádném zálohovacím nástroji, včetně našeho. Určitě nám o tom dejte vědět.
Otázky
Dobrý den! Děkuji za prezentaci! Mám otázku ohledně WAL-G, ale ne ohledně Postgresu. WAL-G zálohuje MySQL a provádí extra zálohu. Pokud vezmete moderní instalace na CentOS a provedete yum install MySQL, nainstaluje se MariaDB. Od verze 10.3 se extra záloha nepodporuje, podporuje se MariaDB záloha. Jak to máte s tím?
V tuto chvíli jsme se nesnažili zálohovat MariaDB. Měli jsme poptávky po podpoře FoundationDB, ale obecně, pokud je taková poptávka, můžeme najít lidi, kteří to udělají. Není to tak dlouhé a složité, jak se mi zdá.
Dobrý den! Děkuji za prezentaci! Mám otázku ohledně potenciálně nových funkcí. Jste připraveni donutit WAL-G pracovat s páskami, aby bylo možné zálohovat na pásky?
Záloha na páskovém úložišti má být?
Ano.
Je tam Andrej Borodin, který na tuto otázku může lépe odpovědět než já.
(Andrej) Ano, děkuji za otázku! Měli jsme poptávku na přenos zálohy na pásku z cloudového úložiště. A pro to přenos mezi cloudy. Protože přenos mezi cloudy je jakási obecná verze přenosu na pásku. Kromě toho máme rozšiřitelnou architekturu v části úložišť. Mimochodem, mnohá úložiště byla napsána studenty. A pokud napíšete úložiště pro pásku, bude to samozřejmě podporováno. Jsme otevřeni pull requestům. Tam je potřeba zapsat soubor, přečíst soubor. Pokud tyto věci uděláte ve vyvozu, obvykle to vyjde na 50 řádků kódu. A pak bude v WAL-G páska podporována.
Děkuji za prezentaci! Zajímavý proces vývoje. Záloha je vážná část funkcionality, která by měla být dobře pokrytá testy. Když jste implementovali funkcionalitu pro nové databáze, psali také testy studenti, nebo jste testy napsali vy sami a potom je předali studentům k implementaci?
Testy psali také studenti. Ale studenti psali více pro takové funkce, jako jsou nové databáze. Psali integrační testy. A psali jednotkové testy. Pokud integrační testy proběhnou, t. j. v tuto chvíli – je to scénář, který vykonáváte ručně nebo vám to dělá cron, například. T. j. ten scénář je velmi srozumitelný.
Studenti nemají moc zkušeností. Kolik času zabere revize?
Ano, recenze skutečně zabere hodně času. T. j. obvykle, když přijde hned několik komitérů a říkají, že jsem udělal to či ono, musím přemýšlet a vyhradit si půlden na to, abych se se vším, co napsali, seznámil. Protože kód je třeba důkladně přečíst. Oni přece neprošli pohovorem. Neznáme je moc dobře, a proto to zabere značný čas.
Děkuji za přednášku! Dříve Andrej Borodin uvedl, že archive_command v WAL-G by měl být vyvoláván přímo. Ale v případě nějakého patron clusteru, potřebujeme další logiku pro určení uzlu, ze kterého odeslat WAL soubory. Jak tuto problematiku řešíte vy?
V čem tu máte problém? Mějte na paměti, že máte synchronní repliku, ze které děláte zálohu? Nebo co?
(Andrej) Skutečností je, že WAL-G skutečně předpokládá použití bez obalu shell skripty. Pokud něco chybí, mohli bychom doplnit logiku, která by měla být uvnitř WAL-G. Co se týče toho, odkud by měla být archiverace, považujeme za správné archiveraci provádět z aktuálního master uzlu v clusteru. Archiverace z repliky je špatný nápad. Mohou se tam objevit různé scénáře s problémovými situacemi. Zejména problémy s archiverací časových linií a dalšími informacemi. Děkuji za otázku!
(Upřesnění: Od obalu shell skripty jsme se zbavili) )
Dobrý večer! Děkuji za přednášku! Zaujal mě prvek catchup, o kterém jste hovořili. Setkali jsme se se situací, kdy replika zaostávala a nemohla dohnat. A v dokumentaci k WAL-G jsem nenašel popis této funkce.
Catchup se objevil doslova na přelomu ledna 2020. S dokumentací by se možná mělo lépe pracovat. My ji sami píšeme a nepíšeme ji dokonale. A možná by se od studentů mělo začít vyžadovat, aby ji psali.
Je už v releasu?
Pull request už byl sloučen, t. j. zkontroloval jsem ho. Zkoušel jsem to na testovacím clusteru. Doposud jsme neměli situaci, kdy bychom to mohli ověřit na reálném příkladu.
Kdy očekávat?
Nevím. Počkejte měsíc, určitě to zkontrolujeme.
Zdroj: habr.com
