

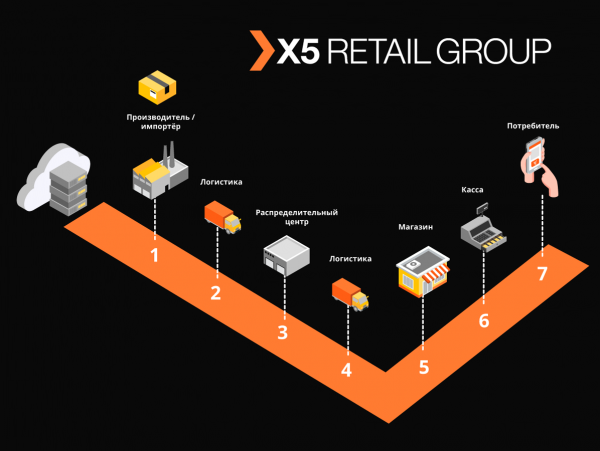
Od roku 2019 v Rusku platí zákon o povinném označování. Tento zákon se nevztahuje na všechny skupiny zboží a termíny zavedení povinného označování jsou pro jednotlivé skupiny odlišné. Prvními produkty, které budou povinně označovány, jsou tabák, obuv, léky, později se přidají také další produkty, jako jsou parfémy, textil a mléko. Tento legislativní krok podnítil vývoj nových IT řešení, která umožní sledovat celou životnost produktu od výroby po koupi koncovým spotřebitelem, všem účastníkům procesu: jak samotnému státu, tak všem organizacím, které prodávají zboží s povinným označováním.
Ve společnosti X5 systém, který bude sledovat označené produkty a vyměňovat si data se státem a dodavateli, dostal název „Markus“. Řekneme si postupně, jak a kdo ho vyvíjel, jaký má technologický stack a proč máme důvod být hrdí.
Skutečný HighLoad
„Markus“ řeší řadu úloh, hlavní z nich je integrační interakce mezi informačními systémy X5 a státním informačním systémem označovaného zboží (GIS MP) pro sledování pohybu označeného zboží.Platforma také uchovává všechny kódy označení, které k nám dorazily, a celou historii pohybu těchto kódů mezi objekty, pomáhá odstranit nesrovnalosti označeného zboží. Například u tabákových výrobků, které patří do prvních skupin označovaného zboží, pouze jedno kamion s cigaretami obsahuje přibližně 600 000 krabiček, z nichž každá má svůj unikátní kód. Úkolem našeho systému je sledovat a ověřovat legálnost přesunů každé takové krabičky mezi sklady a obchody, a nakonec zkontrolovat jejich povolenou prodej koncovému zákazníkovi. Evidujeme asi 125 000 pokladních operací za hodinu a také musíme zapsat, jak se každá taková krabička dostala do obchodu. S ohledem na všechny přesuny mezi objekty očekáváme desítky miliard záznamů ročně.
Tým M
I když je „Markus“ považován v rámci X5 za projekt, realizuje se podle produktového přístupu. Tým pracuje metodou Scrum. Start projektu byl v létě minulého roku, ale první výsledky přišly až v říjnu — byla zcela sestavena vlastní skupina, vyvinuta architektura systému a zakoupeno vybavení. Nyní je v týmu 16 lidí, z nichž šest se zabývá vývojem backendu a frontendu, tři systémovou analýzou. Další šest lidí se věnuje ručnímu, zátěžovému a automatizovanému testování a podpoře produktu. Kromě toho máme specialistu na SRE.
Kód v našem týmu nepíší pouze vývojáři, prakticky všichni členové umějí programovat a píší automatizované testy, zátěžové skripty a skripty pro automatizaci. Věnujeme tomu zvláštní pozornost, protože i podpora produktu vyžaduje vysokou úroveň automatizace. Kolegům, kteří dříve neprogramovali, se vždy snažíme pomoci a poradit, zadat do práce nějaké malé úkoly.
V souvislosti s pandemií koronaviru jsme převedli celý tým na práci na dálku, díky dostupnosti všech nástrojů pro řízení vývoje a vytvořenému workflow v Jira a GitLab jsme tento krok snadno zvládli. Měsíce strávené na dálku ukázaly, že produktivita týmu tím neutrpěla, pro mnohé se zvýšil komfort v práci, jediné, co chybí, je osobní komunikace.
Setkání týmu před prací na dálku
Setkání během práce na dálku
Technologický stack řešení
Standardním repozitářem a nástrojem CI/CD pro X5 je GitLab. Používáme ho pro uchovávání kódu, nepřetržité testování a nasazení na testovací a produkční servery. Také používáme praxi code review, kdy musí minimálně 2 kolegové schválit změny v kódu, které navrhuje vývojář. Statické analyzátory kódu SonarQube a JaCoCo nám pomáhají udržovat kód čistý a zajistit požadovanou úroveň pokrytí unit testy. Všechny změny v kódu musí povinně projít těmito kontrolami. Všechny testovací scénáře, které se provádějí ručně, jsou následně automatizovány.
Pro úspěšné provedení obchodních procesů pomocí „Markusu“ jsme museli vyřešit řadu technologických úkolů, o každém z nich podrobně.
Úkol 1. Potřeba horizontální škálovatelnosti systému
Pro řešení tohoto úkolu jsme zvolili mikroslužbový přístup k architektuře. Bylo velmi důležité pochopit oblasti odpovědnosti služeb. Snažili jsme se je rozdělit podle obchodních operací, s ohledem na specifika procesů. Například příjem ve skladech je sice méně častá, ale velmi objemná operace, během které je třeba co nejrychleji získat od státního regulátora informace o přijímaných jednotkách zboží, jejichž počet v jedné dodávce může dosáhnout až 600000, ověřit přípustnost přijetí tohoto zboží do skladu a poskytnout všechny potřebné informace automatizačnímu systému skladu. Naopak expedice ze skladů má mnohem větší intenzitu, ale operuje s menšími objemy dat.
Všechny služby implementujeme podle principu stateless a dokonce i interní operace se snažíme rozdělit na kroky, přičemž používáme, jak říkáme, self-topiky Kafka. To, když mikroslužba posílá zprávu sama sobě, umožňuje vyvážit zátěž při více náročných operacích a zjednodušuje údržbu produktu, ale o tom později.
Rozhodli jsme se vyčlenit moduly pro interakci s externími systémy do samostatných služeb. To umožnilo vyřešit problém často se měnících API externích systémů, prakticky bez vlivu na služby s obchodními funkcemi.
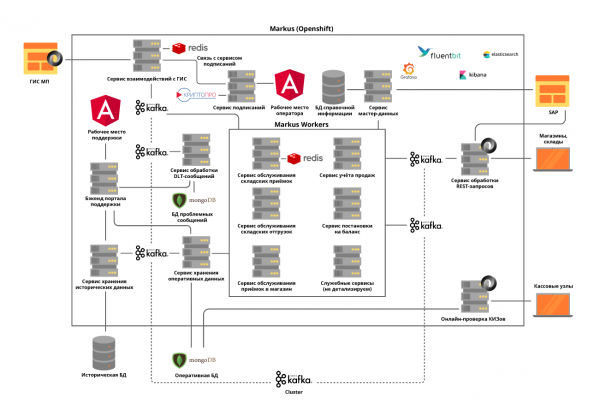
Všechny mikroslužby se nasazují v klastru OpenShift, který řeší jak problém škálování každé mikroslužby, tak nám umožňuje nevyužívat externí nástroje pro Service Discovery.
Úkol 2. Potřeba udržení vysokého zatížení a velmi intenzivní výměny dat mezi službami platformy: pouze v průběhu fáze spuštění projektu probíhá přibližně 600 operací za sekundu. Očekáváme, že toto číslo vzroste na 5000 operací/sekundu s připojováním obchodních objektů k naší platformě.
Tento úkol jsme řešili nasazením clustera Kafka a prakticky úplným odmítnutím synchronní interakce mezi mikroservisy platformy. To vyžaduje velmi pečlivou analýzu požadavků na systém, protože ne všechny operace mohou být asynchronní. Přitom nejen předáváme události přes broker, ale také v zprávě přenášíme všechny potřebné obchodní informace. Velikost zprávy může dosahovat až několika set kilobajtů. Omezení na objem zpráv v Kafka nás nutí k přesnému předpovězení velikosti zpráv, a pokud je to nutné, dělíme je, ale toto dělení je logické a souvisí s obchodními operacemi.
Například zboží, které přijelo autem, dělíme podle krabic. Pro synchronní operace jsou vyčleněny samostatné mikroservisy a provádí se důkladné zátěžové testování. Použití Kafka před nás postavilo jinou výzvu — ověření fungování našeho servisu s ohledem na integraci Kafka dělá všechny naše unit testy asynchronními. Tento úkol jsme řešili psaním vlastních utilitních metod s použitím Embedded Kafka Broker. To nezrušuje nutnost psát unit testy na jednotlivé metody, ale složité případy raději testujeme s použitím Kafka.
Velkou pozornost jsme věnovali trasování logů, aby jejich TraceId nezmizely při vzniku výjimek během práce servisů nebo při práci s dávkami Kafka. A pokud s prvním otázky nevznikly, pak v druhém případě musíme do logu zapsat všechna TraceId, se kterými přišla dávka, a vybrat jedno pro pokračování trasování. Při hledání podle původního TraceId tak uživatel snadno zjistí, s čím pokračovalo trasování.
Úkol 3. Potřeba uchovávat velké množství dat: více než 1 miliarda značkování ročně pouze pro tabák přichází do X5. Je vyžadován stálý a rychlý přístup. Celý systém by měl zpracovávat přibližně 10 miliard záznamů o historii pohybu dat označeného zboží.
Pro třetí úkol byla zvolena NoSQL databáze MongoDB. Máme postavený shard z 5 uzlů a v každém uzlu Replica Set ze 3 serverů. To umožňuje horizontální škálování systému přidáváním nových serverů do clustera a zajistit jeho odolnost vůči výpadkům. Zde jsme se setkali s jiným problémem — zajištěním transakčností v clusteru mongo s ohledem na používání horizontálně škálovatelných mikroservisů. Například jedním z úkolů našeho systému je odhalit pokusy o opětovný prodej zboží se stejnými kódy označení. Zde vznikají kolize s chybně provedenými skenováními nebo s chybnými operacemi pokladníků. Zjistili jsme, že takové duplicity mohou vznikat jak uvnitř jedné zpracovávané dávky Kafka, tak uvnitř dvou paralelně zpracovávaných dávek. Takže kontrola na vznik duplicit pomocí dotazu do databáze nic neřešila. Pro každou mikroservisu jsme řešili problém zvlášť podle obchodní logiky tohoto servisu. Například jsme pro účtenky přidali kontrolu uvnitř dávky a samostatné zpracování na vznik duplicit při vkládání.
Aby práce uživatelů s historií operací nijak neovlivnila to nejdůležitější — fungování našich obchodních procesů, všechny historické údaje jsme vyčlenili do samostatné služby se samostatnou databází, která také získává informace prostřednictvím Kafka. Tímto způsobem uživatelé pracují s izolovanou službou, aniž by ovlivňovali služby, které zpracovávají údaje o aktuálních operacích.
Úkol 4. Opětovné zpracování front a monitoring:
V distribuovaných systémech nevyhnutelně dochází k problémům a chybám dostupnosti databází, front, externích datových zdrojů. V případě "Markusa" je zdrojem těchto chyb integrace s externími systémy. Bylo nutné najít řešení, které umožňuje provádět opakované dotazy na chybné odpovědi s nějakým stanoveným časovým limitem, ale přitom nezkončit zpracování úspěšných dotazů v hlavní frontě. Pro toto byla zvolena takzvaná koncepce "retry podle témat". Pro každé hlavní téma se vytváří jeden nebo více retry témat, do kterých se směřují chybové zprávy, přičemž se vylučuje zpoždění při zpracování zpráv z hlavního tématu. Schéma interakce —
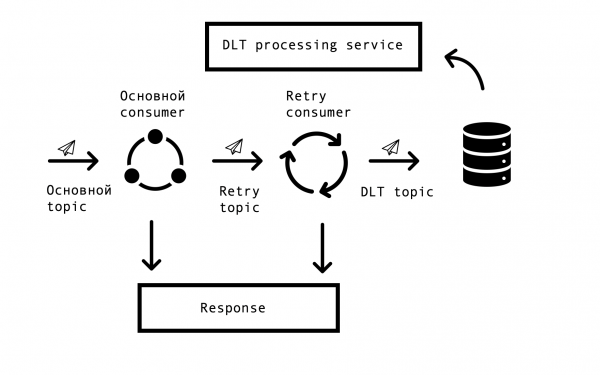
Pro realizaci tohoto schématu jsme potřebovali následující – integrovat toto řešení se Spring a vyhnout se duplicity kódu. Na internetu jsme narazili na podobné řešení založené na Spring BeanPostProcessor, ale připadalo nám příliš obtížné. Naše týmem vyvinulo jednodušší řešení, které se umožňuje zapojit do cyklu Spring pro vytváření consumerů a dodatečně přidávat Retry Consumers. Prototyp našeho řešení jsme předložili týmu Spring, můžete si ho prohlédnout. . Počet Retry Consumerů a počet pokusů každého consumera se nastavuje přes parametry, v závislosti na potřebách obchodního procesu, a aby vše fungovalo, stačí pouze umístit všem Spring vývojářům známou anotaci org.springframework.kafka.annotation.KafkaListener.
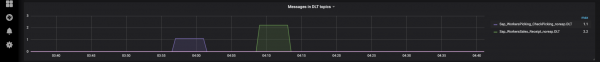
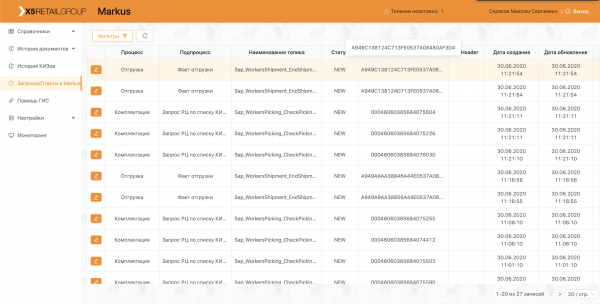
V případě, že zpráva nemohla být zpracována po všech retry pokusech, dostane se na DLT (dead letter topic) pomocí Spring DeadLetterPublishingRecoverer. Na žádost podpory jsme tuto funkcionalitu rozšířili a vytvořili samostatnou službu, která umožňuje prohlížet zprávy, které se dostaly do DLT, stackTrace, traceId a další užitečné informace o nich. Kromě toho byly přidány monitorování a upozornění na všechny DLT topiky, a nyní v podstatě je přítomnost zprávy v DLT topiku důvodem pro analýzu a založení defektu. To je velmi pohodlné – podle názvu topiku ihned pochopíme, na jakém kroku procesu došlo k problému, což výrazně urychluje hledání jeho kořenové příčiny.
Nedávno jsme implementovali rozhraní, které umožňuje znovu poslat zprávy pomocí naší podpory po odstranění jejich příčin (například obnovení funkčnosti externího systému) a samozřejmě založení odpovídajícího defektu k analýze. Tady přišly vhod naše self-topiky, abychom nemuseli znovu spouštět dlouhý řetězec zpracování, můžeme jej spustit z požadovaného kroku.
Exploatace platformy
Platforma je již v produkčním provozu, každý den provádíme dodávky a expedice, připojujeme nové distribuční centra a obchody. V rámci pilotního projektu systém pracuje se skupinami produktů „Tabák“ a „Obuv“.
Celý náš tým se podílí na realizaci pilotů, analyzuje vzniklé problémy a navrhuje vylepšení našeho produktu od zlepšení logů po změny v procesech.
Abychom se vyhnuli opakování našich chyb, všechny případy z pilotního projektu se odrážejí v automatizovaných testech. Vysoký počet automatizovaných testů a unit testů nám umožňuje provádět regresní testování a nasadit hotfix doslova během několika hodin.
Nyní pokračujeme ve vývoji a zlepšování naší platformy a neustále se setkáváme s novými výzvami. Pokud vás to zajímá, rádi vám sdělíme naše řešení v následujících článcích.
Zdroj: habr.com
