

27. května v hlavním sále konference DevOpsConf 2019, která se koná v rámci festivalu , v rámci sekce „Nepřetržité dodávání“, zazněla přednáška „werf — náš nástroj pro CI/CD v Kubernetes“. Ta se zabývá těmi problémy a výzvami, kterým čelí každý při nasazování do Kubernetes, i nuancemi, které si nemusíme hned uvědomit. Při rozboru možných řešení ukazujeme, jak je to realizováno v Open Source nástroji .
Od doby vystoupení naše utilita (dříve známá jako dapp) překonala historickou hranici 1000 hvězd na GitHubu — doufáme, že rostoucí komunita jejích uživatelů usnadní život mnoha DevOps inženýrům.
Takže představujeme (~47 minut, mnohem informativnější než článek) a hlavní shrnutí z ní v textové podobě. Jdeme na to!
Dodávání kódu do Kubernetes
V přednášce se již nebudeme zabývat werf, ale CI/CD v Kubernetes, s předpokladem, že náš software je zabalen v Docker kontejnerech (o tom jsem mluvil v ), a K8s bude použit pro jeho spuštění v produkci (o tom — v ).
Jak vypadá dodávání do Kubernetes?
- Existuje Git repozitář s kódem a instrukcemi pro jeho sestavení. Aplikace se sestavuje do Docker obrazu a publikuje se v Docker Registry.
- Ve stejném repozitáři jsou také instrukce o tom, jak aplikaci nasadit a spustit. V fázi nasazení se tyto instrukce posílají do Kubernetes, který získává potřebný obraz z registry a spouští ho.
- Navíc jsou obvykle k dispozici testy. Některé z nich lze provádět při publikaci obrazu. Také je možné (podle těchto instrukcí) nasadit kopii aplikace (v odděleném prostoru názvů K8s nebo v odděleném clusteru) a testy spouštět tam.
- Nakonec je potřeba CI systém, který přijímá události z Gitu (nebo stisknutí tlačítek) a vyvolává všechny vymezené fáze: build, publish, deploy, test.
Je zde několik důležitých poznámek:
- Protože máme neměnnou infrastrukturu (immutable infrastructure), obraz aplikace, který se používá ve všech fázích (staging, production atd.), musí být jeden. Podrobnosti o tom a s příklady jsem popisoval .
- Protože se řídíme přístupem infrastruktura jako kód (IaC), kód aplikace, instrukce pro jeho sestavení a spuštění musí ležet přesně v jednom repozitáři. Podrobnosti o tom — viz v .
- Dodávkový řetězec (delivery) Obvykle vidíme takto: aplikaci sestavíme, otestujeme, vydáme. (fáze vydání) A to je vše — distribuce byla dokončena. Ale ve skutečnosti uživatel dostává to, co jste vydali, ne v okamžiku, kdy jste to dodali do produkce, a kdy do něj mohl vstoupit a tato produkce fungovala. Proto si myslím, že dodací řetězec končí až ve fázi provozu (běh), a pokud to vezmeme přesněji, dokonce v okamžiku, kdy byl kód odstraněn z produkce (nahradil ho nový).
Vraťme se k výše uvedenému schématu dodání v Kubernetes: nevynalezli jsme ho jen my, ale doslova každý, kdo se daným problémem zabýval. V podstatě se tento vzor nyní nazývá GitOps (více o pojmu a myšlenkách, které za ním stojí, se můžete dočíst ). Podívejme se na fáze schématu.
Fáze sestavení
Zdálo by se, že v roce 2019 je o sestavení Docker obrazů co říct, když už každý umí psát Dockerfile a spouštět je. docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- Hmotnost obrazu má význam, proto použijte , abyste v obrazu ponechali pouze to, co je skutečně potřebné pro fungování aplikace.
- Počet vrstev je třeba minimalizovat sloučením řetězců příkazů podle smyslu.
RUNNicméně to přidává problémy - při ladění , protože při selhání sestavení je potřeba najít ten správný příkaz v řetězci, který problém způsobil.Rychlost sestavení
- je důležitá, protože chceme rychle vydávat změny a sledovat výsledek. Například, nechceme při každém sestavení aplikace znovu sestavovat závislosti v jazykových knihovnách. Často je z jednoho Git repozitáře vyžadováno
- více obrazů, což lze vyřešit sadou Dockerfile (nebo pojmenovanými fázemi v jednom souboru) a Bash skriptem pro jejich sekvenční sestavení.To byla pouze špička ledovce, se kterou se všichni setkávají. Ale existují i další problémy, zejména:
Často v fázi sestavení potřebujeme něco
- připojit (například mezipaměť výsledku příkazu typu apt do externího adresáře). Chceme
- místo psaní v shellu. Ansible sestavit bez Dockeru
- místo psaní v shellu. (proč bychom potřebovali další virtuální stroj, na kterém bychom to všechno nastavovali, když už máme klastr Kubernetes, kde můžeme spouštět kontejnery?). Paralelní sestavování
- Paralelní sestavení, kterou lze chápat různými způsoby: různé příkazy v Dockerfile (pokud používáte víceúrovňovou sestavu), několik commitů jednoho repozitáře, několik Dockerfile’ů.
- Distribuovaná sestava: chceme sestavovat něco v pody, které jsou „efemérní“, protože ztrácejí cache, a to znamená, že je potřeba ji uchovávat někde jinde.
- Nakonec jsem vrchol přání nazval automagie: bylo by ideální vstoupit do repozitáře, napsat nějaký příkaz a obdržet hotový obraz, sestavený s porozuměním, jak a co správně udělat. Nicméně osobně nejsem si jistý, zda lze všechny nuance takto předpokládat.
A tak jsou projekty:
- — tvůrce od společnosti Docker Inc (již integrovaný v aktuálních verzích Dockeru), který se snaží vyřešit všechny tyto problémy;
- — tvůrce od Googlu, který umožňuje sestavovat bez Dockeru;
- — pokus CNCF udělat automagii a konkrétně zajímavé řešení s rebase pro vrstvy;
- a ještě spousta dalších utilit, jako například , …
… a podívejte se, kolik mají hvězdiček na GitHubu. To znamená, že na jedné straně docker build existují a mohou něco udělat, ale ve skutečnosti otázka není vyřešena — důkazem toho je paralelní rozvoj alternativních tvůrců, z nichž každý řeší část problémů.
Sestavení v werf
Tak jsme se dostali k (dříve jak dapp) — open source utilitě společnosti „Flant“, kterou děláme už mnoho let. Všechno to začalo před pěti lety s Bash skripty, optimalizujícími sestavení Dockerfile, a poslední tři roky probíhá plnohodnotný vývoj v rámci jednoho projektu se svým Git repozitářem (původně na Ruby, a pak na Go, a zároveň přejmenované). Jaké otázky sestavení jsou vyřešeny ve werf?
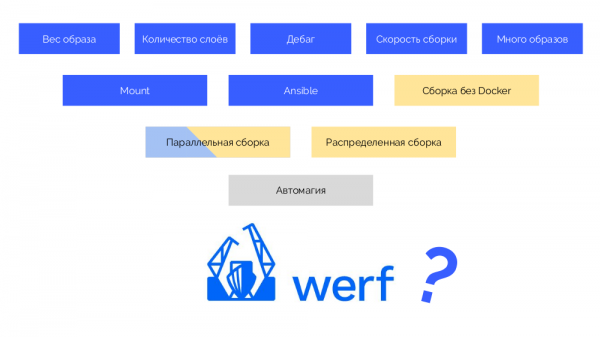
Modře označené problémy již byly realizovány, paralelní sestavení bylo provedeno v rámci jednoho hostitele, a otázky označené žlutě plánujeme dokončit do konce léta.
Fáze publikace v registry (publish)
Nabrali jsme docker push… — co může být obtížného na tom, abychom nahráli obraz do registry? A pak se objevuje otázka: „Jaký tag dát obrazu?“ Vzniká z toho důvodu, že máme Gitflow (nebo jinou Git strategii) a Kubernetes, a průmysl usiluje o to, aby to, co se děje v Kubernetes, odpovídalo tomu, co se dělá v Gitu. Vždyť Git je náš jediný zdroj pravdy.
Co na tom je složité? Zaručit reprodukovatelnost: od commitu v Gitu, který je ze své podstaty neměnný (immutable), až po Docker obraz, který by měl zůstat stejný.
Je pro nás také důležité určovat původ, protože chceme chápat, z jakého commitu byla sestavena aplikace spuštěná v Kubernetes (tehdy můžeme provádět diffy a podobné věci).
Strategie označování
První je jednoduché git tag. Máme registry s obrazem, který je označen jako 1.0. V Kubernetes existují fáze a produkce, kam byl tento obraz nahrán. V Gitu provádíme commity a v nějakém okamžiku nastavíme tag 2.0. Zpracováváme ho podle pokynů z repozitáře a ukládáme do registru s tagem 2.0. Nahráváme na stage a, pokud je vše v pořádku, pak na produkci.
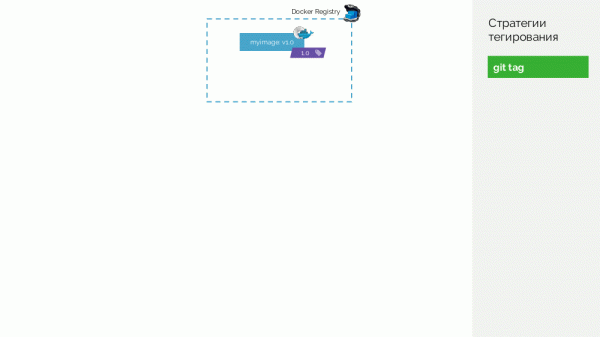
Problém s tímto přístupem je, že jsme nejprve nastavili tag a teprve potom testovali a nasadili. Proč? Jednak to prostě nedává smysl: vydáváme verzi softwaru, který jsme ještě ani neprověřili (nemůžeme udělat jinak, protože k prověření je potřeba nastavit tag). Za druhé, taková cesta se neslučuje s Gitflow.
Druhá varianta je git commit + tag. V master větvi je tag 1.0; pro něj v registru — obraz, nasazený na produkci. Kromě toho má Kubernetes klastr preview a staging obvody. Dále dodržujeme Gitflow: v hlavní větvi pro vývoj (develop) děláme nové funkce, což má za následek commit s identifikátorem #c1. Ten zpracováváme a publikujeme do registru pomocí tohoto identifikátoru (#c1). Se stejným identifikátorem nahráváme na preview. Stejně tak postupujeme s commity #c2 a #c3.
Když jsme pochopili, že funkcí je dost, začínáme vše stabilizovat. V Gitu vytváříme větev release_1.1 ), používá se v RAPIDS. BlazingSQL je dodatečná vrstva, která pracuje nad cuDF a využívá knihovnu cuIO pro čtení dat z disku. SQL dotazy jsou převedeny na volání funkcí cuUDF, které umožňují načítání dat do GPU a provádění nad nimi operací sloučení, agregace a filtrování. Podporuje se vytváření distribuovaných konfigurací zahrnujících tisíce GPU. #c3 z develop). Sestavit tuto verzi nebude třeba, protože to bylo uděláno v předchozí fázi. Proto ji můžeme jednoduše nasadit na staging. Opravené bugy v #c4 a podobně nasazujeme na staging. Současně probíhá vývoj v develop, kam se občas přebírají změny z release_1.1. V nějakém okamžiku získáme zkompilovaný a nahraný commit na staging, se kterým jsme spokojeni (#c25).
Tehdy provedeme merge (s fast-forwardem) release větve (release_1.1) do master. Na tento commit nastavíme tag s novou verzí (1.1). Ale tento obraz už byl sestaven v registru, proto, abychom ho znovu nesestavovali, jednoduše přidáme druhý tag na existující obraz (nyní má v registru tagy #c25 a 1.1). Po tom ho nasazujeme na produkci.
Existuje nevýhoda, že na staging byl nahrán jeden obraz (#c25), a na produkci — jakoby jiný (1.1), ale víme, že „fyzicky“ je to stejný obraz z registru.
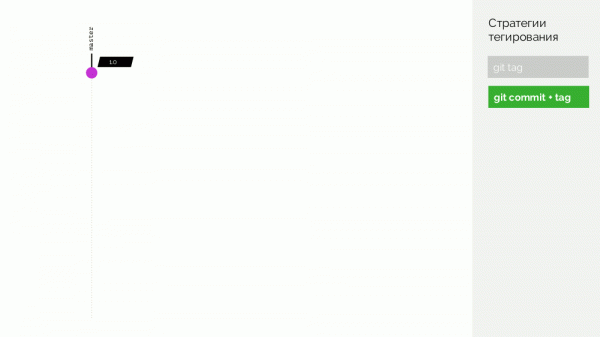
Skutečný nedostatek spočívá v tom, že neexistuje podpora pro merge commit, je nutné dělat fast-forward.
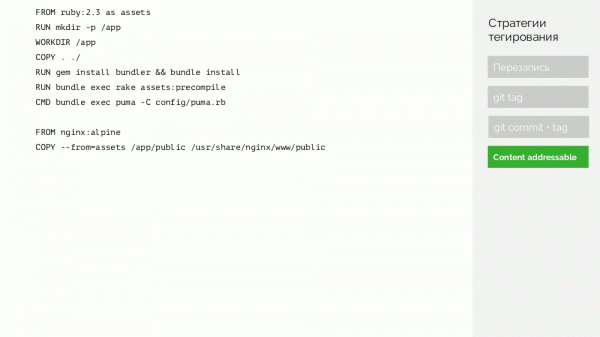
Můžeme zajít dál a udělat trik… Zvažme příklad jednoduchého Dockerfile:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
Vytvoříme soubor podle tohoto principu, že vezmeme:
- SHA256 z identifikátorů použitých obrazů (
ruby:2.3anginx:alpine), které jsou kontrolními součty jejich obsahu; - všechny příkazy (
RUN,CMDatd.); - SHA256 z přidaných souborů.
… a vezmeme kontrolní součet (opět SHA256) z takového souboru. To je podpis všech, co určuje obsah Docker obrazu.
Vraťme se ke schématu a namísto commitů budeme používat takové podpisy, tedy tagovat obrazy podpisy.
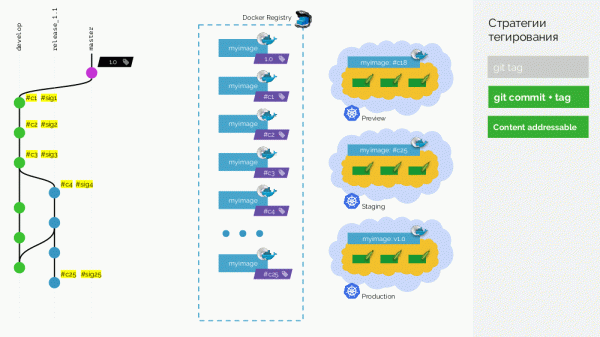
Nyní, když bude potřeba například ‚sloučit‘ změny z vydání do master, můžeme udělat skutečný merge commit: ten bude mít jiný identifikátor, ale stejný podpis. S tímto identifikátorem nasadíme obraz i na produkci.
Nevýhodou je, že nyní nebude možné určit, jaký commit byl nasazen na produkci — kontrolní součty fungují pouze jedním směrem. Tento problém se řeší dodatečnou vrstvou metadat — podrobněji povím později.
Tagování ve werf
Ve werf jsme zašli ještě dál a připravujeme se na distribuovanou výstavbu s cachem, který není uložen na jednom stroji… Takže, sestavujeme Docker obrazy dvou typů, nazýváme je stage a obrázek.
V Git repozitáři werf jsou uloženy specifické instrukce pro stavbu, popisující různé fáze výstavby (beforeInstall, install, beforeSetup, setup). První stage-obraz sestavujeme s podpisem definovaným jako kontrolní součet prvních kroků. Pak přidáváme zdrojový kód, pro nový stage-obraz počítáme jeho kontrolní součet… Tyto operace se opakují pro všechny fáze, což nám poskytuje sadu stage-obrazů. Poté vytvoříme finální image-obraz, který také obsahuje metadata o jeho původu. A tento obraz pak tagujeme různými způsoby (podrobnosti později).
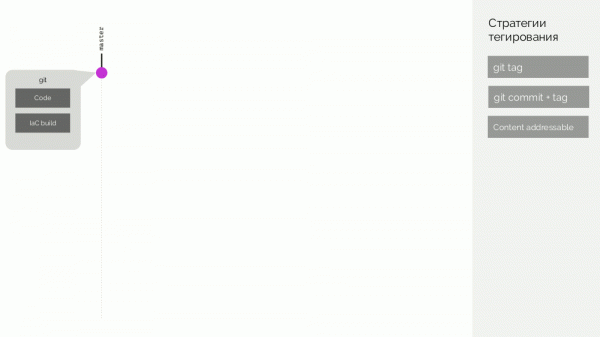
Pokud se objeví nový commit, ve kterém byl změněn pouze kód aplikace, co se stane? Bude vytvořen patch pro změny kódu, připraven nový stage-image. Jeho podpis bude určen jako kontrolní součet starého stage-image a nového patch. Z tohoto obrazu bude vytvořen nový finální image.
Stage-image tedy představují cache, kterou je možné uchovávat distribuovaně, a z nich vytvořené image budou nahrány do Docker Registry.
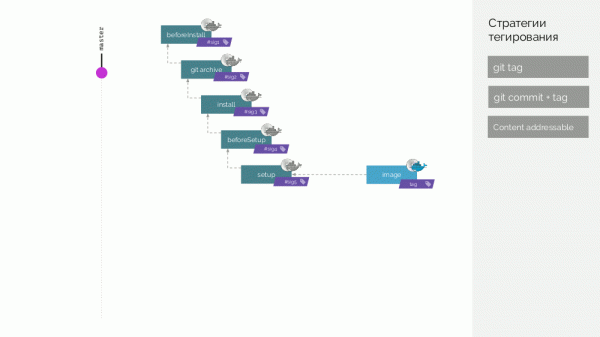
Úklid registry
Nepůjde o mazání vrstev, které zůstaly viset po odstraněných tazích — to je standardní možnost samotného Docker Registry. Jde o situaci, kdy se hromadí velké množství Docker-tags a my víme, že některé z nich již nepotřebujeme, a zabírají místo (a/nebo za ně platíme).
Jaké jsou strategie úklidu?
- Můžete klidně nic nečistit.Někdy je opravdu jednodušší zaplatit za nadbytečný prostor, než se snažit rozplést obrovský klubko tagů. Ale to funguje jen do určitého okamžiku.
- Úplný reset. Pokud odstraníte všechny obrazy a znovu sestavíte pouze aktuální v CI systému, může nastat problém. Pokud se na produkci restartuje kontejner, načte se nový obraz — takový, který ještě nikdo netestoval. To zabíjí myšlenku immutable infrastructure.
- Blue-green. Když se jeden registry začne plnit — nahráváme obrazy do jiného. Stejný problém jako v předchozím způsobu: kdy můžeme začít čistit ten registry, který se začal plnit?
- Časově. Odstranit všechny obrazy starší než 1 měsíc? Ale jistě se najde služba, která nebyla aktualizována celý měsíc…
- Manuálně určit, co již lze odstranit.
Opravdu životaschopných variant je dvě: nečistit nebo kombinace blue-green + ručně. V posledním případě jde o následující: když chápete, že je čas na úklid registry, vytvoříte nový a po dobu, například jednoho měsíce, přidáváte všechny nové obrazy do něj. A po měsíci zkontrolujete, které pod’y v Kubernetes stále používají starý registry, a ty také přesunete do nového registry.
K čemu jsme dospěli v werf? Мы собираем:
- Git head: všechny tagy, všechny větve, — s předpokladem, že vše, co je označeno v Gitu, potřebujeme i v obrazech (a pokud ne, je třeba to odstranit v samotném Gitě);
- všechny pod’y, které jsou nyní nasazeny v Kubernetes;
- staré ReplicaSety (to, co bylo nedávno nasazeno), a také plánujeme skenovat Helm-releases a vybírat poslední obrazy tam.
… a vytváříme z této sady whitelist — seznam obrazů, které nebudeme odstraňovat. Všechno ostatní vyčistíme, a poté najdeme osiřelé stage-obrazy a také je odstraníme.
Fáze nasazení (deploy)
Spolehlivá deklarativnost
První věc, na kterou bychom chtěli upozornit při nasazení, je nasazení aktualizované konfigurace zdrojů, oznámené deklarativně. Původní YAML dokument s popisem Kubernetes zdrojů se vždy silně liší od výsledku, který skutečně funguje v clusteru. Protože Kubernetes přidává do konfigurace:
- identifikátory;
- služební informace;
- mnoho výchozích hodnot;
- sekci s aktuálním stavem;
- změny provedené v rámci práce admission webhook;
- výsledek práce různých kontrolérů (a plánovače).
Proto, když se objeví nová konfigurace zdroje (nový), nemůžeme prostě vzít a přepsat jí aktuální, „živou“ konfiguraci (live). K tomu budeme muset porovnat nový s předchozí aplikovanou konfigurací (last-applied) a aplikovat live získanou opravu.
Takový přístup se nazývá 2-way merge. Používá se například v Helmu.
Ještě existuje 3-way merge, který se liší tím, že:
- při porovnávání last-applied a nový, se díváme, co bylo odstraněno;
- při porovnávání nový a live, díváme se, co bylo přidáno nebo změněno;
- souhrnnou opravu aplikujeme na live.
Nasazujeme více než 1000 aplikací s Helmem, proto v podstatě žijeme s 2-way merge. Má však řadu problémů, které jsme vyřešili našimi patchi, které Helmu pomáhají správně fungovat.
Skutečný stav nasazení
Po tom, co naše CI-systém vygeneroval nové konfigurace pro Kubernetes podle události, přenáší ji na aplikaci (apply) do clusteru — pomocí Helmu nebo kubectl apply. Dále se provádí již popsaný N-way merge, na což Kubernetes API souhlasně odpovídá CI-systému, a ten — svému uživateli.
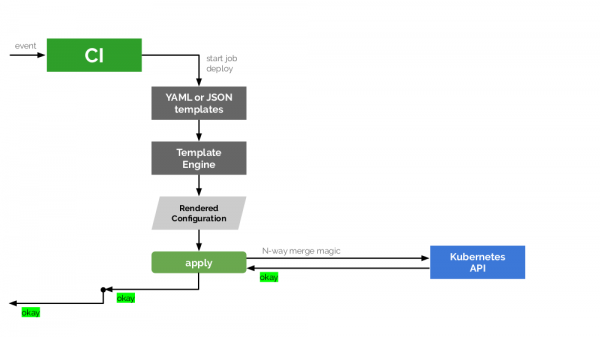
Je však obrovský problém: protože úspěšná aplikace neznamená úspěšné nasazení. Pokud Kubernetes pochopil, jaké změny je třeba aplikovat, aplikuje je — ještě nevíme, co z toho vznikne. Například aktualizace a restart pod’ů na frontendě může proběhnout úspěšně, zatímco na backendě nikoli, a my dostaneme různé verze spuštěných obrazů aplikace.
Aby vše probíhalo správně, v tomto schématu se nabízí další prvek — speciální tracker, který bude přijímat informace od Kubernetes API o stavu a předávat je k dalšímu analýze skutečné situace. Vytvořili jsme knihovnu Open Source v Go — (viz její oznámení ), — která tento problém řeší a je integrovaná ve werf.
Chování tohoto trackera na úrovni werf se konfiguruje pomocí anotací, které se umisťují na Deployments nebo StatefulSets. Hlavní anotace — fail-mode — rozumí následujícím hodnotám:
-
IgnoreAndContinueDeployProcess— ignorovat problémy s nasazením této komponenty a pokračovat v deployi; -
FailWholeDeployProcessImmediately— chyba v této komponentě okamžitě zastaví proces deploye; -
HopeUntilEndOfDeployProcess— doufáme, že tato komponenta začne fungovat do konce deploye.
Například tato kombinace zdrojů a hodnot anotace fail-mode:
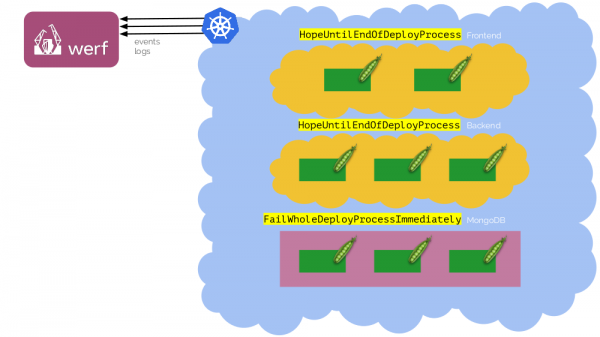
Když nasazujeme poprvé, databáze (MongoDB) může být ještě nepřipravená — Deployments selžou. Ale můžeme počkat, až se spustí, a nasazení nakonec proběhne.
Dále existují dvě anotace pro kubedog ve werf:
-
failures-allowed-per-replica— počet povolených selhání na každou replikaci; -
show-logs-until— reguluje čas, do kterého werf zobrazuje (v stdout) logy ze všech nasazovaných podů. Výchozí hodnota jePodIsReady(abychom ignorovali zprávy, které pravděpodobně nepotřebujeme, když na pod začíná přicházet provoz), ale také jsou povolené hodnotyControllerIsReadyaEndOfDeploy.
Co dalšího chceme od nasazení?
Kromě již popsaných dvou bodů bychom chtěli:
- vidět logy — a to pouze potřebné, ne všechny;
- sledovat pokrok, protože pokud job „tiše“ visí několik minut, je důležité pochopit, co se tam děje;
- mít automatický rollback v případě, že něco neproběhne podle plánu (a proto je kriticky důležité znát skutečný stav nasazení). Nasazení musí být atomární: buď proběhne do konce, nebo se vše vrátí do předchozího stavu.
Závěry
Naše společnost potřebuje k implementaci všech popsaných nuancí na různých fázích dodávky (build, publish, deploy) pouze CI systém a nástroj .
Na závěr:
S pomocí werf jsme udělali značný pokrok v řešení mnoha problémů DevOps inženýrů a budeme rádi, pokud širší komunita tuto utilitu alespoň vyzkouší. Společně bude snazší dosáhnout dobrého výsledku.
Video a slajdy
Video z prezentace (~47 minut):
Prezentace zprávy:
P.S.
Další zprávy o Kubernetes na našem blogu:
- «» (Dmitrij Stoljarov; 27. dubna 2019 na "Stachka");
- «» (Andrej Polovov; 8. dubna 2019 na Saint HighLoad++);
- «» (Dmitrij Stoljarov; 8. listopadu 2018 na HighLoad++);
- «» (Dmitrij Stoljarov; 28. května 2018 na RootConf);
- «» (Dmitrij Stoljarov; 7. listopadu 2017 na HighLoad++);
- «» (Dmitrij Stoljarov; 6. června 2017 na RootConf).
Zdroj: habr.com
