

Logy jsou důležitou součástí systému, která umožňuje pochopit, zda funguje (nebo nefunguje) podle očekávání. V podmínkách mikroslužeb se práce s logy stává samostatnou disciplínou speciální olympiády. Je třeba vyřešit celou řadu otázek:
- jak psát logy z aplikace;
- kam psát logy;
- jak doručovat logy pro ukládání a zpracování;
- jak zpracovávat a ukládat logy.
Použití populárních technologií kontejnerizace přidává na hromadu dalších problémů v řešení úkolu.
O tom je právě rozbor přednášky Jurije Bušmělova "Mapa problémů v oblasti sběru a doručování logů".
Kdo má zájem, prosím, pokračujte dál.
Jmenuji se Jurij Bušmelov. Pracuji v Lazadě. Dnes budu vyprávět o tom, jak jsme vytvářeli naše logy, jak jsme je sbírali a co do nich zapisujeme.
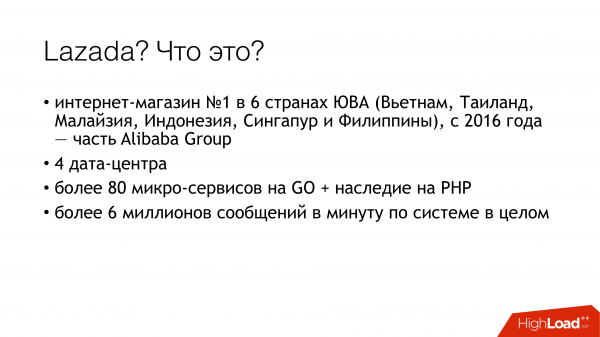
Odkud jsme? Kdo jsme? Lazada je internetový obchod č. 1 v šesti zemích jihovýchodní Asie. Všechny tyto země máme rozdělené mezi datová centra. V současnosti máme celkem 4 datová centra. Proč je to důležité? Protože některá rozhodnutí byla ovlivněna tím, že mezi centry existuje velmi slabé spojení. Máme mikroslužební architekturu. Byl jsem překvapen, když jsem zjistil, že už máme 80 mikroslužeb. Když jsem začínal s úkolem ohledně logů, bylo jich pouze 20. K tomu máme také poměrně velký kus PHP legacy, se kterým si musíme porovnat a smířit. To všechno v současnosti generuje více než 6 milionů zpráv za minutu v celém systému. Dále ukážu, jak se s tím snažíme žít, a proč to tak je.
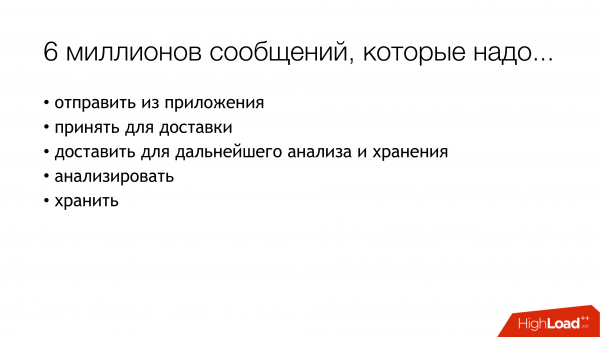
S těmito 6 miliony zpráv je potřeba nějak žít. Co s nimi tedy máme udělat? 6 milionů zpráv, které je potřeba:
- odeslat z aplikace,
- přijmout k doručení,
- doručit k analýze a uložení.
- analyzovat
- nějak uchovávat.
Když se objevily tři miliony zpráv, měla jsem přibližně takový výraz. Protože jsme začínali s nějakými drobnými. Je jasné, že se tam zapisují logy aplikací. Například se nepodařilo připojit k databázi, podařilo se připojit k databázi, ale nepodařilo se něco přečíst. Kromě toho každý náš mikroslužbový systém zapisuje také access-log. Každý požadavek, který dorazil na mikroslužbu, je zaznamenán do logu. Proč to děláme? Vývojáři chtějí mít možnost sledování. V každém access-logu je pole traceid, podle kterého speciální rozhraní rozvíjí celou řetězec a krásně ukazuje sledování. Sledování ukazuje, jak probíhal požadavek, a to pomáhá našim vývojářům rychleji se vypořádat s každým neidentifikovaným problémem.
Jak s tím žít? Teď vám stručně popíšu možnosti — jak se tato problém vůbec řeší. Jak řešit úkol sběru, přenosu a ukládání logů.
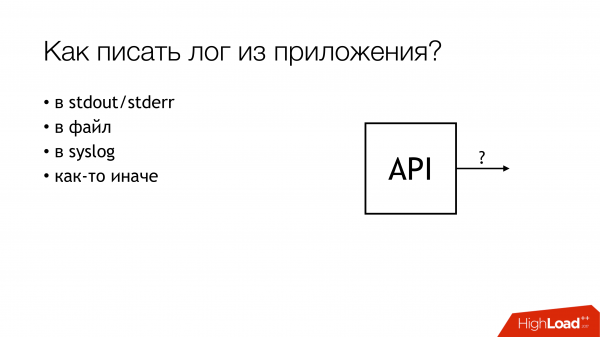
Jak zapisovat z aplikace? Je jasné, že existují různé způsoby. Zejména existují osvědčené postupy, jak nám říkají módní odborníci. Existuje stará škola ve dvou variantách, jak říkali naši předkové. Existují i jiné způsoby.
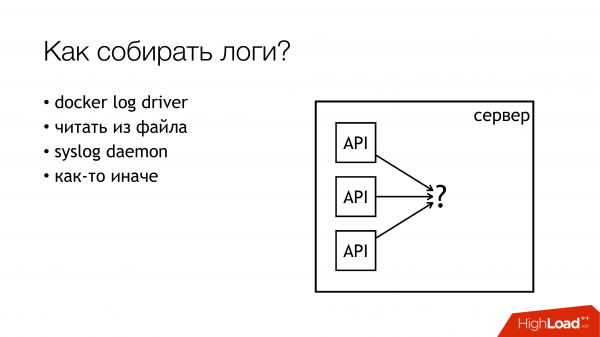
Se sběrem logů je to zhruba stejné. Možností řešení této konkrétní části není tolik. Už jich je více, ale stále jich ještě není tolik.
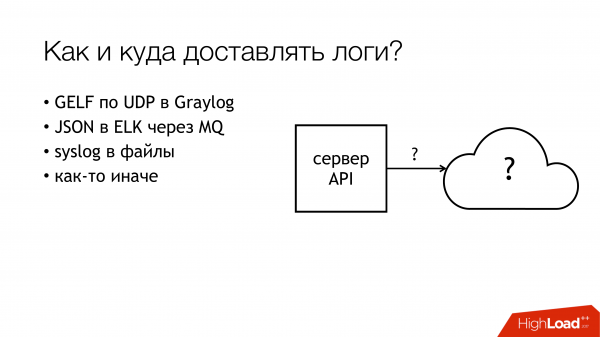
Pokud jde o doručování a následnou analýzu — počet variant začíná explodovat. Nebudu popisovat každou variantu nyní. Myslím, že hlavní varianty jsou známé všem, kdo se o toto téma zajímali.
Ukážu vám, jak jsme to dělali v Lazadě a jak to celé začalo.
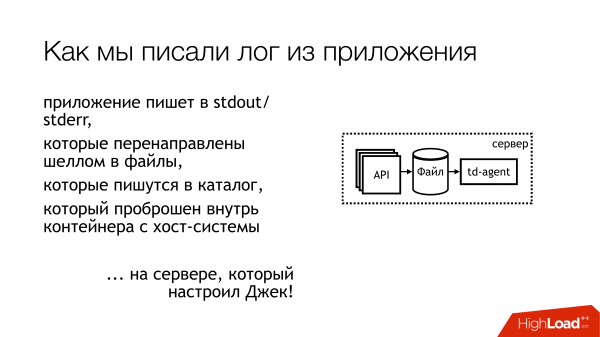
Před rokem jsem přišel do Lazady a poslali mě na projekt o logech. Bylo to asi takto. Log z aplikace byl zapisován do stdout a stderr. Všechno to udělali podle posledních trendů. Ale poté to vývojáři vyhodili ze standardních proudů a pak si s tím nějak poradí specialisté na infrastrukturu. Mezi specialisty na infrastrukturu a vývojáři jsou také releaseři, kteří řekli: „eee… no dobře, zabalíme je do souboru jednoduše přes shell, a hotovo“. A protože to všechno bylo v kontejneru, zabalili to přímo v kontejneru, namapovali dovnitř adresář a uložili to tam. Myslím, že je každému přibližně jasné, co z toho vzešlo.
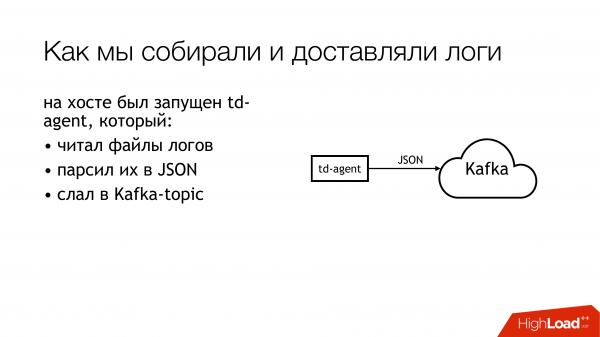
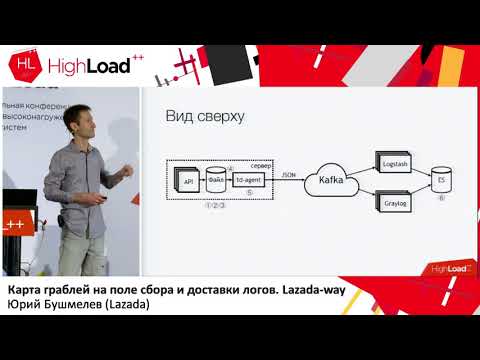
Podívejme se teď trochu dále. Jak jsme tyto logy doručovali. Někdo zvolil td-agent, což je vlastně fluentd, ale ne úplně fluentd. Stále jsem nechápal vztah mezi těmito dvěma projekty, ale vypadají, že se týkají téhož. A tenhle fluentd, napsaný v Ruby, četl soubory logů, parsoval je do JSON podle nějakých regulárních výrazů. Poté je posílal do Kafky. Přičemž v Kafce mělo každé API 4 samostatné topic. Proč 4? Protože je live, je staging a protože existují stdout a stderr. Vývojáři je vytvářejí a infrastrukturáři je musí vytvářet v Kafce. Přičemž, Kafku kontroloval jiný oddělení. Proto bylo nutné vytvořit ticket, aby tam vytvořili 4 topiky pro každé API. Na to se všichni zapomněli. Celkově to byla pěkná chaos.
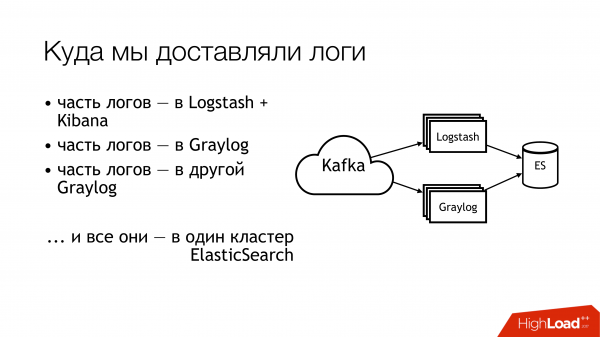
Co jsme s tím dále dělali? Posílali jsme to do Kafky. Dále z Kafky polovina logů letěla do Logstashi. Druhá polovina logů se dělila. Část letěla do jednoho Graylogu, část – do jiného Graylogu. Nakonec to všechno letělo do jednoho clusteru Elasticsearch. To znamená, že celý tento nepořádek nakonec padl tam. Tak se to dělat nemá!
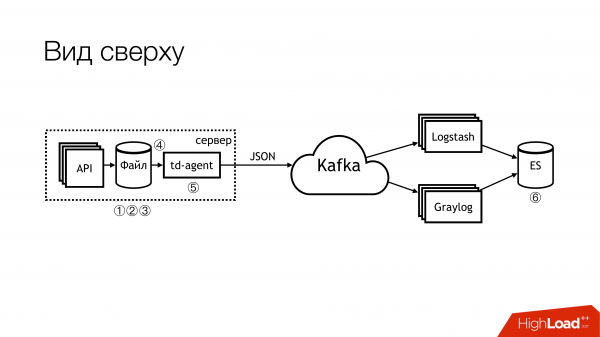
Takto to vypadá, pokud se na to podíváme z dálky. Tak se to dělat nemá! Zde jsou čísly hned označena problémová místa. Je jich ve skutečnosti více, ale 6 je opravdu problematických, se kterými je třeba něco dělat. O těchto místech teď povím zvlášť.
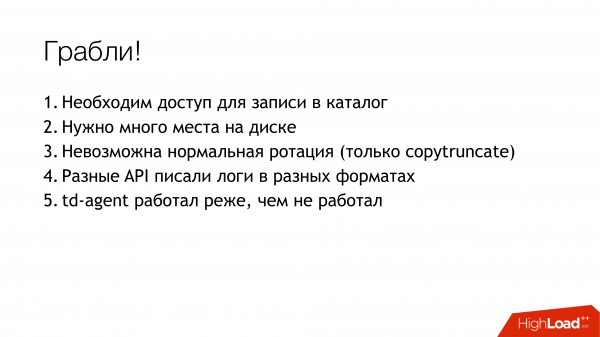
Tady (1,2,3) se píší soubory a tedy zde hned tři překážky.
Za prvé (1) – musíme je někam psát. Ne vždy bych chtěl dát API možnost psát přímo do souboru. Bylo by žádoucí, aby API bylo izolováno v kontejneru, a ještě lépe – aby bylo read-only. Jsem systémový administrátor, takže mám trochu alternativní pohled na tyto věci.
Druhý bod (2,3) – máme spoustu dotazů, které přicházejí do API. API zapisuje spoustu dat do souboru. Soubory rostou. Musíme je rotovat. Jinak si žádné disky nepořídíme. Rotace je obtížná, protože jsou provedeny přesměrováním přes shell do adresáře. Není možné je rotovat. Nelze říct aplikaci, aby znovu otevřela deskriptory. Protože na vás vývojáři budou koukat jako na blázna: „Jaké deskriptory? My vůbec píšeme do stdout.“ Infrastrukturové týmy vytvořily copytruncate v logrotate, který prostě udělá kopii souboru a truncatne originál. Odpovídajícím způsobem se mezi těmito procesy kopírování obvykle vyčerpá místo na disku.
(4) Měli jsme různé formáty v různých API. Trochu se lišily, ale bylo třeba psát různé regexp. Vzhledem k tomu, že celé to spravoval Puppet, byla tam velká hromada tříd se svými problémy. Kromě toho td-agent většinu času mohl jíst paměť, zpomalovat, mohl prostě dělat, že pracuje, a nic nedělat. Zvenčí bylo nemožné poznat, že nic nedělá. V tom lepším případě spadne a někdo ho později znovu zvedne. Přesněji, přiletí alert a někdo půjde a zvedne ho ručně.
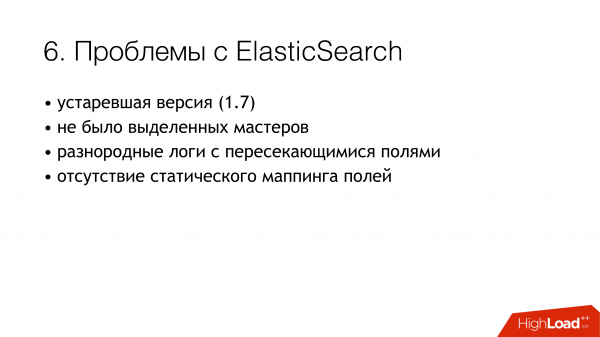
(6) A to nejhorší – to byl elasticsearch. Protože to byla stará verze. Protože jsme v té době neměli dedikované master servery. Měli jsme heterogenní logy, jejichž pole se mohla překrývat. Různé logy různých aplikací mohly být zapisovány se stejnými názvy polí, ale uvnitř mohly mít různá data. To znamená, že jeden log přichází s Integer v poli, například level. Druhý log přichází se String v poli level. Při absenci statického mapování vzniká taková podivná situace. Pokud po rotaci indexu v elasticsearch jako první příjde zpráva se řetězcem, žijeme normálně. A pokud jako první příjde s Integer, všechny následující zprávy, které příjdou se String, jsou prostě odmítány. Protože typ pole se neshoduje.
Začali jsme si klást tyto otázky. Rozhodli jsme se nevyhledávat viníky.
Je třeba něco udělat! Je zřejmé, že musíme zavést standardy. Některé standardy už máme. Některé jsme zavedli později. Naštěstí byl v té době schválen jednotný formát logů pro všechny API. Ten je uveden přímo ve standardech spolupráce služeb. Takže ti, kdo chtějí přijímat logy, musí je psát v tomto formátu. Pokud někdo nepíše logy v tomto formátu, pak nic nezaručujeme.
Dále bych chtěl zavést jednotný standard pro zapisování, doručování a shromažďování logů. O skutečnosti, kam je psát, a čím je doručovat. Ideální situace je, když se v projektech používá jedna a ta samá knihovna. M máme zvláštní knihovnu pro logování pro Go, máme zvláštní knihovnu pro PHP. Všichni, kdo u nás jsou, by měli tyto knihovny používat. V současné době bych řekl, že to máme na 80 %. Ale někteří stále jedí kaktusy.
A tam, na slidu, se pomalu začíná objevovat "SLA pro doručování logů". Zatím to nemáme, ale pracujeme na tom. Protože je to velmi pohodlné, když infrastruktura říká, že pokud píšete v určitém formátu na určité místo a ne více než N zpráv za sekundu, tak to s určitou pravděpodobností doručíme tam. To odstraňuje spoustu bolestí hlavy. Pokud SLA existuje, je to úžasné!
Jak jsme začali řešit problém? Hlavním problémem byl td-agent. Nebylo jasné, kam logy mizí. Doručují se? Shromažďují se? Kde jsou vůbec? Proto bylo prvním krokem rozhodnuto nahradit td-agent. Možnosti, čím jej nahradit, jsem zde stručně načrtl.
Fluentd. Za prvé, setkal jsem se s ním v předchozí práci a tam také občas padal. Za druhé, je to totéž, jen v profilu.
Filebeat. Čím byl pro nás výhodný? Tím, že je na Go, a my máme velkou odbornost v Go. Pokud by bylo třeba, mohli bychom ho nějak upravit. Proto jsme ho nevzali. Aby ani nebylo pokušení začít ho přepisovat.
Zřejmým řešením pro sysadmina zůstávají různé syslogy v takovém množství (syslog-ng/rsyslog/nxlog).
Nebo napsat něco vlastního, ale to jsme odložili, stejně jako filebeat. Pokud bychom měli něco psát, je lepší napsat něco užitečného pro podnikání. Pro doručování logů je lepší vzít něco hotového.
Protože výběr se vlastně zúžil na volbu mezi syslog-ng a rsyslog. Naklonil jsem se ke rsyslogu jednoduše proto, že jsme v Puppet už měli třídy pro rsyslog a nenašel jsem mezi nimi zjevný rozdíl. Co je tam syslog, to je tady syslog. Ano, někdo má horší dokumentaci, někdo lepší. Ten umí tohle, a ten jinak.
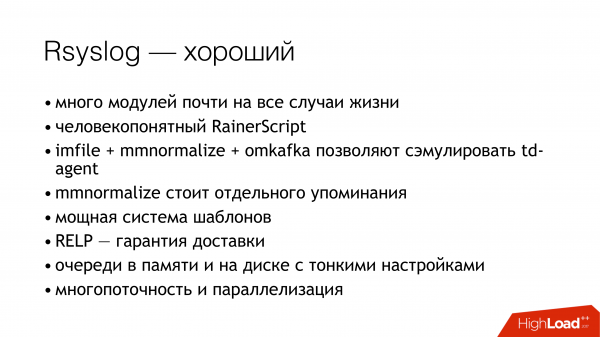
A trochu o rsyslogu. Za prvé, je skvělý, protože má spoustu modulů. Má člověku srozumitelný RainerScript (moderní jazyk konfigurace). Skvělý bonus je, že jsme mohli jeho standardními prostředky simulovat chování td-agent, a pro aplikace se nic nezměnilo. To znamená, že měníme td-agent na rsyslog, a vše ostatní zatím nevzrušujeme. A hned dostáváme funkční doručení. Dále, mmnormalize — to je skvělá věc v rsyslogu. Umožňuje parsovat logy, ale ne pomocí Grok a regexp. Vytváří abstraktní syntaktický strom. Parsuje logy zhruba tak, jak kompilátor parsuje zdrojáky. To umožňuje pracovat velmi rychle, spotřebovávat málo CPU, a vůbec je to opravdu skvělá věc. Je spousta dalších bonusů. Na těch se nezastavím.
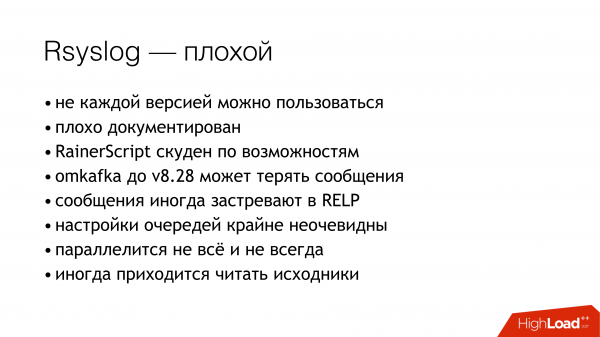
Rsyslog má také spoustu nedostatků. Jsou přibližně stejné jako bonusy. Hlavní problémy — je potřeba umět ho připravit a je třeba vybírat správnou verzi.
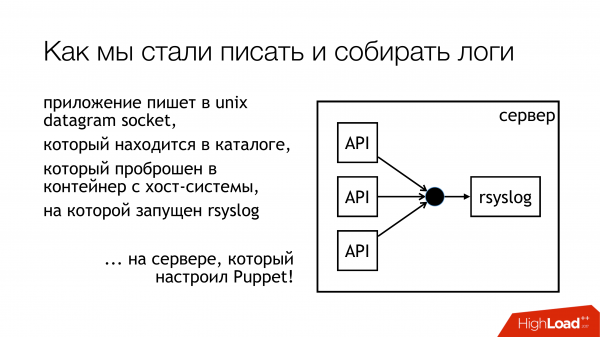
Rozhodli jsme se, že budeme psát logy do unix socketu. A to ne do /dev/log, protože tam máme chaos systémových logů, tam je journald v tomto pipeline. Proto pojďme psát do vlastního socketu. Připojíme ho k samostatnému pravidlovému setu. Nebudeme nic míchat. Všechno bude průhledné a srozumitelné. Tak jsme to vlastně udělali. Adresář s těmito sockety je standardizovaný a prosazuje se do všech kontejnerů. Kontejnery mohou vidět požadovaný socket, otevřít ho a psát do něj.
Proč ne soubor? Protože všichni četli , která se pokoušela propasovat soubor do Dockeru a zjistilo se, že po restartu rsyslogu se mění deskriptor souboru, a Docker ztrácí tento soubor. Drží otevřeno něco jiného, ale už ne ten socket, kam píší. Rozhodli jsme se, že tuto problému obejdeme, a zároveň se vyhneme problémům s blokováním.
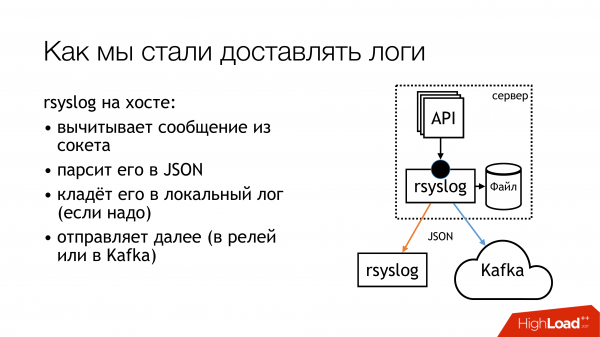
Rsyslog provádí akce uvedené na snímku a odesílá logy buď do relay, nebo do Kafka. Kafka odpovídá starému způsobu. Relay — to jsem se pokusil použít čistě rsyslog pro doručování logů. Bez Message Queue, standardními prostředky rsyslogu. V zásadě to funguje.
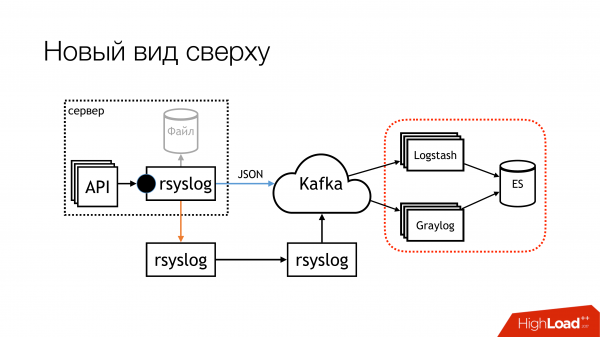
Ale jsou určité nuanční otázky ohledně toho, jak je později dostat do této části (Logstash/Graylog/ES). Tato část (rsyslog-rsyslog) se používá mezi datovými centry. Zde je komprimovaná TCP linka, která šetří šířku pásma a tím zvyšuje pravděpodobnost, že získáme nějaké logy z jiného datacentra v podmínkách, kdy je linka přetížena. Protože máme Indonésii, kde je situace špatná. Tam je to neustálý problém.
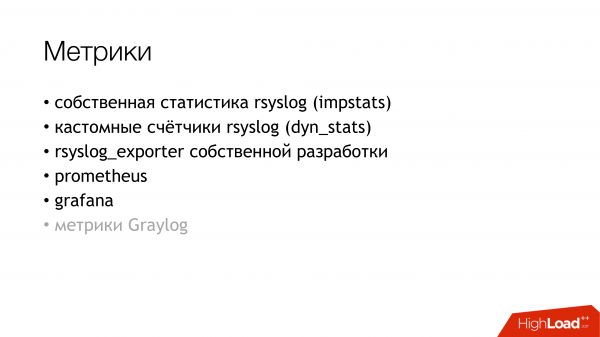
Zamysleli jsme se nad tím, jak vlastně monitorovat pravděpodobnost, že logy, které jsme z aplikace zaznamenali, dorazí na druhý konec? Rozhodli jsme se zavést metriky. Rsyslog má svůj modul pro sběr statistik, který obsahuje různé počítadla. Například může ukázat velikost fronty, nebo kolik zpráv přišlo v určité akci. Z toho už lze něco vyvodit. Navíc má vlastní počítadla, která lze nastavit, a on vám ukáže například počet zpráv, které zaznamenalo určité API. Dále jsem napsal rsyslog_exporter na Pythonu a všechno jsme to poslali do Promethea a vytvořili grafy. Na metriky Graylog jsme se velmi těšili, ale zatím jsme je nestihli nastavit.
S čím jsme měli problémy? Problémy nastaly, když jsme zjistili (NEČEKANĚ!), že naše Live API posílá 50k zpráv za sekundu. To je jen Live API bez stagingu. A Graylog nám ukazuje jen 12 tisíc zpráv za sekundu. A vznikla oprávněná otázka, kde jsou zbytky? Z čehož jsme usoudili, že Graylog jednoduše nezvládá. Podívali jsme se a opravdu, Graylog s Elasticsearch neunesli toto zatížení.
Dále jsme během procesu udělali další zjištění.
Zápis do socketu je blokován. Jak k tomu došlo? Když jsem používal rsyslog pro doručování, v určitém okamžiku došlo k poruše linky mezi datovými centry. Doručování se zastavilo na jednom místě a na druhém místě. Všechny tyto problémy se dostaly na stroj s API, které zapisují do socketu rsyslog. Fronta se naplnila. Poté se naplnila fronta pro zápis do unixového socketu, která je ve výchozím nastavení 128 paketů. A následující write() v aplikaci je blokováno. Když jsme se podívali do knihovny, kterou používáme v aplikacích na Go, bylo tam napsáno, že zápis do socketu probíhá v neblokujícím režimu. Byli jsme si jisti, že nic není blokováno. Protože jsme četli. , která o tom napsala. Ale je tady jeden okamžik. Kolem tohoto volání byl nekonečný cyklus, ve kterém se neustále pokoušelo vložit zprávu do socketu. To jsme si nevšimli. Museli jsme přepsat knihovnu. Od té doby se několikrát změnila, ale nyní se nám podařilo zbavit se zablokování ve všech subsystémech. Takže můžeme zastavit rsyslog a nic nespadne.
Je nutné monitorovat velikost front, což pomáhá se vyhnout těmto problémům. Za prvé, můžeme monitorovat, kdy začínáme ztrácet zprávy. Za druhé, můžeme monitorovat, že máme obecně problémy s dodávkou.
A ještě nepříjemný moment — amplifikace v 10násobku v mikroservisní architektuře — je to velmi snadné. Máme relativně málo příchozích požadavků, ale kvůli grafu, kterým zprávy běží dál, kvůli access-logům, skutečně zvyšujeme zatížení logy přibližně desetinásobně. Omlouvám se, že jsem nestihl spočítat přesná čísla, ale mikroservisy takové jsou. To je třeba mít na paměti. Vychází to tak, že v současné době je subsystém sběru logů nejvíce zatížený v Lazadě.
Jak vyřešit problém s elasticsearch? Pokud potřebujete rychle získat logy na jednom místě, abyste nemuseli běhat po všech strojích a sbírat je tam, použijte souborové úložiště. To funguje zaručeně. Můžete to vytvořit z jakéhokoli serveru. Stačí jen nainstalovat tam disky a nastavit syslog. Poté budete mít zaručeně všechny logy na jednom místě. Pak můžete klidně postupně nastavovat elasticsearch, graylog nebo něco jiného. Ale už budete mít všechny logy a můžete je ukládat, jak dlouho to disky dovolí.
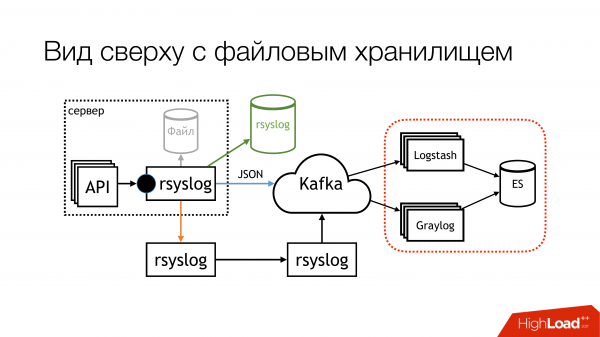
V době mé přednášky vypadala schéma takto. Prakticky jsme přestali psát do souborů. Teď, pravděpodobně, odpojíme zbytky. Na lokálních strojích, na kterých běží API, přestaneme psát do souborů. Za prvé, existuje souborové úložiště, které funguje velmi dobře. Za druhé, na těchto strojích se neustále vyčerpává místo, takže je třeba ho neustále monitorovat.
Tato část s Logstash a Graylogem je skutečně problematická. Takže se ji potřebujeme zbavit. Je třeba vybrat něco jednoho.
Rozhodli jsme se zahodit Logstash a Kibana. Protože máme bezpečnostní oddělení. Jaký je vztah? Vztah je v tom, že Kibana bez X-Pack a Shield neumožňuje rozdělit práva přístupu k logům. Proto jsme vzali Graylog. Ten má všechno potřebné. Neumím si na něj zvyknout, ale funguje. Koupili jsme novou techniku, nainstalovali tam čerstvý Graylog a přenesli všechny logy se striktními formáty do samostatného Graylogu. Vyřešili jsme problém s různými typy stejných polí organizačně.
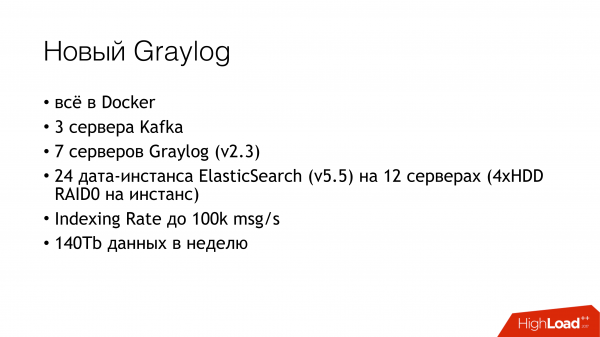
Co přesně nově zahrnuje Graylog? Všechno jsme jednoduše zapsali do Dockeru. Vzali jsme spoustu serverů, rozbalili tři instance Kafka, 7 serverů Graylog verze 2.3 (protože jsme chtěli Elasticsearch verzi 5). Všechno bylo na RAID z HDD. Viděli jsme indexační rychlost až 100 tisíc zpráv za sekundu. Viděli jsme číslo, že máme 140 terabajtů dat za týden.
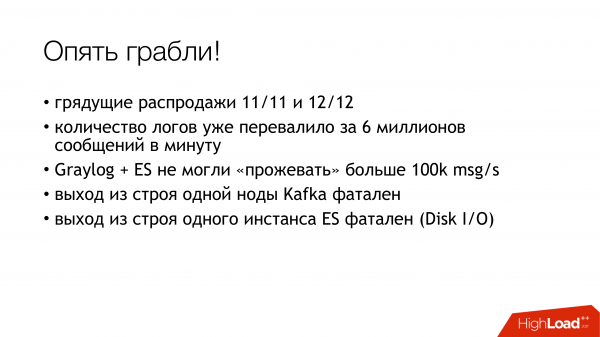
A zase jsme narazili na problémy! Čekají nás dvě výprodeje. Přesunuli jsme se k 6 milionům zpráv. Náš Graylog nestačí zpracovávat. Musíme nějak přežít.
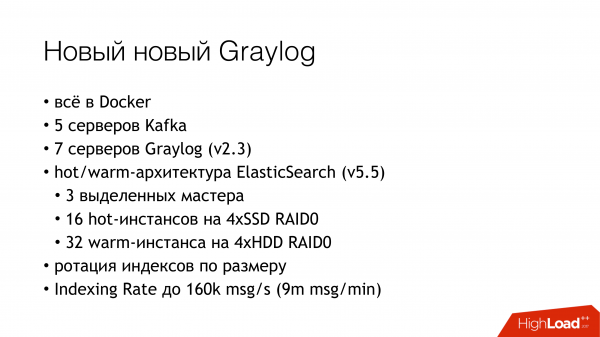
Přežili jsme takto. Přidali jsme pár serverů a SSD. V současnosti žijeme tímto způsobem. Teď zpracováváme už 160 tisíc zpráv za sekundu. Ještě jsme nenarazili na limit, takže zatím není jasné, kolik skutečně můžeme vytáhnout z tohoto.
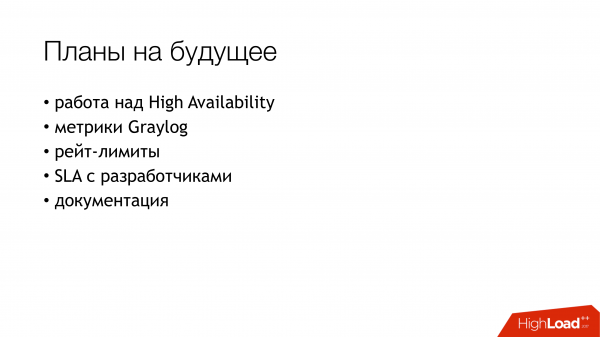
Takové máme plány do budoucna. Z nich je opravdu nejdůležitější pravděpodobně vysoká dostupnost. Tu zatím nemáme. Několik strojů je nastaveno stejně, ale vše zatím jede přes jeden stroj. Musíme si udělat čas, abychom nastavili failover mezi nimi.
Shromáždit metriky z Graylogu.
Nastavit omezení rychlosti, abychom měli jedno, šílené API, které nám nezabíjelo šířku pásma a všechno ostatní.
A nakonec podepsat nějakou SLA s vývojáři, že můžeme obsloužit tolik. Pokud budete psát víc, tak promiňte.
A napsat dokumentaci.
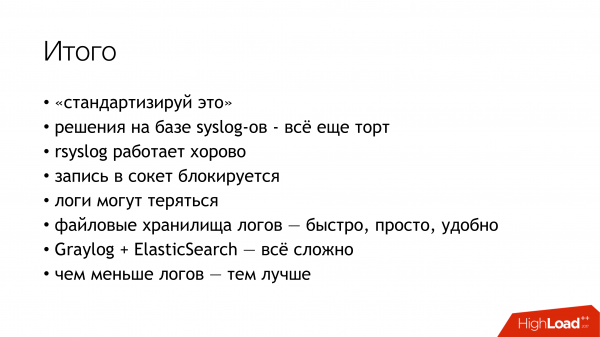
Krátce shrnutí všeho, co jsme zažili. Za prvé, standardy. Za druhé, syslog — dort. A za třetí, rsyslog funguje přesně tak, jak je napsáno na snímku. A přejděme k dotazům.
Otázky.
Otázka: Proč jsme se nakonec rozhodli nevzít… (filebeat?)
Odpověď: Musíme psát do souboru. Moc se mi nechtělo. Když máš API, které zapisuje tisíce zpráv za sekundu, i když budeš rotovat jednou za hodinu, stále to není možnost. Můžeš psát do pipu. Na což se mě vývojáři zeptali: „Co se stane, když proces, do kterého zapisujeme, spadne“? Jen jsem nenašel, co na to říct, a řekl jsem: „No dobře, tak to dělat nebudeme“.
Otázka: Proč nepíšete logy přímo do HDFS?
Odpověď: To je další krok. Přemýšleli jsme o tom na začátku, ale protože momentálně nemáme zdroje se tím zabývat, zůstává to pro nás jako dlouhodobé řešení.
Otázka: Sloupcový formát by byl vhodnější.
Odpověď: Všechno chápu. Jsme pro to oběma rukama.
Otázka: Píšete do rsyslogu. Tam je možné jak TCP, tak UDP. Ale pokud používáte UDP, jak zaručujete doručení?
Odpověď: Jsou zde dva body. První, okamžitě všem říkám, že nezaručujeme doručení logů. Protože když přijdou vývojáři a říkají: „A co kdybychom sem začali psát finanční data, a vy je někde uskladníte na případ, že by se něco stalo“, odpovědíme jim „Skvělé! Pojďte začít blokovat zápis do soketu a dělat to v transakcích, abyste nám garantovali, že jste nám to do soketu vložili a ujistili se, že jsme to z druhé strany dostali.“ A v ten moment se všem okamžitě nechce. A protože se nechce, tak jaké k nám mají otázky? Pokud nechcete garantovat zápis do soketu, proč bychom měli garantovat doručení? Děláme to nejlepší, co můžeme. Opravu se snažíme doručit co nejvíce a co nejlépe, ale nedáváme 100% záruku. Proto sem nepište finanční data. Na to jsou databáze s transakcemi.
Otázka: Když API generuje nějakou zprávu do logu a předává řízení mikroslužbám, nenarazili jste na problém, že zprávy z různých mikroslužeb přicházejí ve špatném pořadí? To způsobuje zmatek.
Odpověď: Je normální, že přicházejí v různé pořadí. Na to je třeba být připraven. Protože jakákoliv síťová dodávka vám nezaručuje pořadí, nebo na to je třeba speciálně vynakládat zdroje. Pokud vezmeme souborová úložiště, každé API ukládá logy do svého souboru. Omlouvám se, tam rsyslog je rozloží podle adresářů. Každé API má své logy, kam se dá jít podívat, a pak podle timestampu v tomto logu je lze porovnávat. Pokud se podívají do Graylogu, tam se to seřadí podle timestampu. Všechno bude v pořádku.
Otázka: Timestamp se může lišit o milisekundy.
Odpověď: Timestamp generuje samo API. To je vlastně celý trik. Máme NTP. API generuje timestamp už v samotné zprávě. Není to rsyslog, kdo ho přidává.
Otázka: Není úplně jasné, jak probíhá interakce mezi datovými centry. V rámci datového centra je jasné, jak se logy shromažďují a zpracovávají. Jak probíhá interakce mezi datovými centry? Nebo každé datové centrum žije svým vlastním životem?
Odpověď: Skoro. Každá země je umístěna v jednom konkrétním datovém centru. V současnosti nemáme rozložení, kde by jedna země byla umístěna v různých datových centrech. Nepotřebujeme je tedy spojovat. Uvnitř každého centra je Log Relay. To je server Rsyslog. Ve skutečnosti jsou to dva manažerské stroje. Jsou nastaveny stejně. V současnosti ale provoz prochází jedním z nich. Ten shromažďuje všechny logy. Má diskovou frontu pro případ nouze. Komprimuje logy a posílá je do centrálního datového centra (v Singapuru), odkud se dále odesílají do Graylog. A v každém datovém centru je vlastní úložiště souborů. V případě, že ztratíme spojení, máme tam všechny logy. Ty tam zůstanou. Bude tam uchovány.
Otázka: Při mimořádných situacích dostáváte logy odtamtud?
Odpověď: Můžete tam jít (do úložiště souborů) a zkontrolovat je.
Otázka: Jak monitorujete, že neztrácíte logy?
Odpověď: Ve skutečnosti je ztrácíme a monitorujeme to. Monitorování bylo spuštěno před měsícem. V knihovně používané Go API jsou metriky. Umí počítat, kolikrát se jí nepodařilo zapsat do socketu. V tuto chvíli je tam chytrá heuristika. Je tam buffer. Snaží se zapisovat z něho zprávy do socketu. Pokud se buffer přeplní, začne je odmítat. A počítá, kolik jich odmítl. Když začnou počítadla překračovat určité hodnoty, dozvíme se o tom. Aktuálně přicházejí také do Prometheus a v Grafana můžete vidět grafy. Můžete nastavit upozornění. Ale zatím není jasné, komu je posílat.
Otázka: V Elasticsearch uchováváte logy s replikací. Kolik máte replik?
Odpověď: Jedna replika.
Otázka: To je pouze jedna replika?
Odpověď: To je master a replika. Data jsou uchovávána ve dvou kopiích.
Otázka: Velikost bufferu rsyslog jste nějak upravovali?
Odpověď: Píšeme datagramy do vlastního unixového socketu. To nám okamžitě ukládá omezení 128 kilobajtů. Nemůžeme do něj zapsat více. Uvedli jsme to ve standardu. Kdo chce mít přístup ke storage, ten píše 128 kilobajtů. Knihovny navíc ořezávají a nastavují příznak, že zpráva byla oříznuta. V našem standardu zprávy existuje speciální pole, které ukazuje, zda byla při zápisu oříznuta či nikoli. Takže máme možnost to sledovat.
Otázka: Píšete neplatný JSON?
Odpověď: Neplatný JSON bude zamítnut buď během relay, protože balíček je příliš velký. Nebo bude zamítnut Graylog, protože nebude moci JSON zparsovat. Ale zde jsou nuance, které je potřeba opravit, a většinou jsou spojeny s rsyslog. Už jsem tam zanesl několik problémů, na kterých je ještě třeba pracovat.
Otázka: Proč Kafka? Zkoušeli jste RabbitMQ? Nebo se Graylog nevyrovnává s takovými zátěžemi?
Odpověď: S Graylogem se nám nedaří. Ale Graylog s námi vychází. Je to zvláštní věc. A ve skutečnosti není potřeba. Raději bych psal přímo z rsyslog do elasticsearch a pak se podíval do Kibany. Ale musíme vyřešit otázku se zabezpečením. To je možný směr našeho rozvoje, kdy bychom vyhodili Graylog a používali Kibanu. Nemá smysl používat Logstash. Protože totéž mohu udělat z rsyslog. A má modul pro zápis do elasticsearch. S Graylogem se snažíme nějak žít. Dokonce jsme ho trochu vyladili. Ale je tam ještě prostor pro zlepšení.
O Kafka. Tak to historicky vyplynulo. Když jsem přišel, již existovala a zapisovaly se do ní logy. Prostě jsme spustili náš cluster a přestěhovali do něj logy. Spravujeme ho, víme, jak se má. Co se týče RabbitMQ… s RabbitMQ nám to neklape. A s RabbitMQ nám to funguje. Máme ho v produkci a měly s ním problémy. Před touto akcí jsme ho upravili a začal normálně fungovat. Ale předtím jsem nebyl připraven ho pustit do produkce. Je tu ještě jeden bod. Graylog umí číst verzi AMQP 0.9, zatímco rsyslog umí zapisovat verzi AMQP 1.0. A není žádné řešení, které by umělo obojí. Buď jedno nebo druhé. Takže prozatím pouze Kafka. Ale tam také jsou své nuance. Protože omkafka té verze rsyslog, kterou používáme, může ztratit celý buffer zpráv, které načetla z rsyslog. Zatím se s tím smiřujeme.
Otázka: Používáte Kafku, protože už ji máte? Nevyužíváte ji pro žádné jiné účely?
Odpověď: Kafka, která byla, se používá týmem Data Science. To je zcela samostatný projekt, o kterém, bohužel, nemohu nic říct. Nejsem v obraze. Byla v péči týmu Data Science. Když začali zapisovat logy, rozhodli se ji použít, aby nebylo nutné instalovat ještě svou vlastní. Nyní jsme aktualizovali Graylog a ztratili jsme kompatibilitu, protože tam je stará verze Kafky. Museli jsme si vytvořit vlastní. Při té příležitosti jsme se zbavili těch čtyř témat pro každé API. Udělali jsme jedno široké téma pro všechny live, jedno široké téma pro všechny staging a jednoduše všechno tam naléváme. Graylog to všechno paralelně zpracovává.
Otázka: Proč je potřeba tohle "šamanství" se sockety? Zkoušeli jste použít log-drivers syslog pro kontejnery?
Odpověď: V době, kdy jsme se tímto problémem zabývali, jsme měli s Dockerem napjaté vztahy. Byla to verze docker 1.0 nebo 0.9. Docker sám o sobě byl podivný. Za druhé, pokud do něj ještě dáváte logy… Mám nepodložené podezření, že skrze sebe, skrze Docker démon, procházejí všechny logy. Pokud jedno API začíná blbnout, ostatní API narážejí na to, že nemohou poslat stdout a stderr. Nevím, kam to povede. Mám pocit, že v tomto místě bychom neměli používat syslog driver Dockeru. Naše oddělení funkčního testování má svůj vlastní malý cluster Graylog s logy. Používají Docker log drivery a zdá se, že tam mají vše v pořádku. Ale GELF posílají přímo do Graylogu. Když jsme to všechno plánovali, potřebovali jsme, aby to prostě fungovalo. Možná později, až někdo přijde a řekne, že to už dávno funguje normálně, to vyzkoušíme.
Otázka: Děláte dodávku mezi datovými centry na rsyslog. Proč ne na Kafka?
Odpověď: Děláme to vlastně oběma způsoby. Z dvou důvodů. Pokud je kanál úplně rozbitý, ani naše komprimované logy se tam nevejdou. A Kafka umožňuje je jednoduše ztrácet v procesu. Tímto způsobem se zbavujeme zasekávání těchto logů. V tomto případě jednoduše používáme Kafka přímo. Pokud máme dobrý kanál a chceme ho uvolnit, použijeme rsyslog. Ale ve skutečnosti ho lze nastavit tak, aby automaticky odstraňoval obsah, který se nevejde. V současnosti používáme někde dodávku rsyslog přímo, někde Kafka.
Zdroj: habr.com
