

Sdílím své osobní zkušenosti o tom, kde a kdy se co hodilo. Přehledně a v bodech, aby bylo jasné, co a kde se dá dále prozkoumat — ale zde mám čistě subjektivní osobní zkušenost, u vás to může být úplně jinak.
Proč je důležité znát a umět pracovat s dotazovacími jazyky? V Data Science existuje několik klíčových fází práce a nejprve a nejdůležitějším (bez toho to určitě nebude fungovat!) je získání nebo extrakce dat. Nejčastěji data v nějaké formě někde leží a je potřeba je tam "vytáhnout".
Dotazovací jazyky právě umožňují tato data extrahovat! A dnes vám povím o těch dotazovacích jazycích, které mi byly užitečné, a ukážu, kde a jak přesně — proč je to pro studium důležité.
Celkem budou tři hlavní bloky typů dotazů na data, které v tomto článku probereme:
- „Standardní“ dotazovací jazyky — to, co obvykle chápeme, když mluvíme o dotazovacích jazycích, jako například relační algebra nebo SQL.
- Skriptingové dotazovací jazyky: například pythoní nástroje jako pandas, numpy nebo shell scripting.
- Dotazovací jazyky pro znalostní grafy a grafové databáze.
Vše, co zde bylo napsáno, je prostě osobní zkušenost, co se hodilo, s popisem situací a "proč to bylo potřeba" — každý si může vyzkoušet, jak moc se takové situace mohou vyskytnout, a pokusit se na ně připravit, když se seznámí s těmito jazyky dříve, než je bude muset v (naléhavém pořadí) použít na projektu nebo se vůbec dostat na projekt, kde jsou potřeba.
„Standardní“ dotazovací jazyky
Standardní dotazovací jazyky právě v tom smyslu, že obvykle na ně myslíme, když mluvíme o dotazech.
Relační algebra
Proč je dnes potřebná relační algebra? Abychom měli dobré představy, proč jsou dotazovací jazyky uspořádány určitým způsobem, a vědomě je používat, musíme se podívat na základní jádro, které leží na jeho základě.
Co je to relační algebra?
Formální definice je následující: relační algebra — uzavřený systém operací nad relacemi v relačním modelu dat. Pokud to trochu převedeme do lidské řeči, jde o systém operací nad tabulkami, takže výsledek je také vždy tabulka.
Viz všechny relační operace v článku z Habr — zde popisujeme, proč je důležité rozumět a kde se to hodí.
Proč?
Začínáš chápat, jaké jazyky dotazů existují a jaké operace stojí za výrazy konkrétních jazyků dotazů — často to poskytuje hlubší porozumění tomu, co a jak funguje v jazycích dotazů.
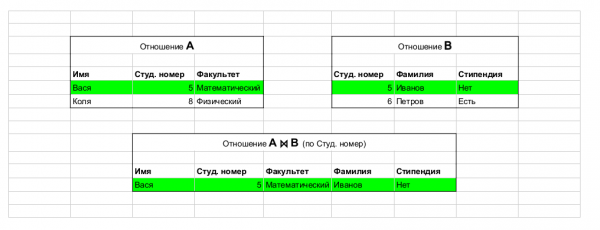
Vzato z článku. Příklad operace: join, která spojuje tabulky.
Materiály k učení:
. Celkově existuje mnoho materiálů o relační algebře a teorii — Coursera, Udacity. Také je obrovské množství materiálů online, včetně kvalitních . Můj osobní tip: musíte velmi dobře porozumět relační algebře — to je základ.
SQL
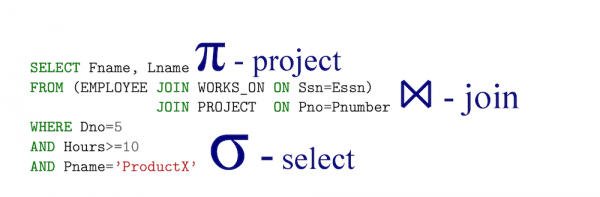
Vzato z článku.
SQL je v podstatě implementací relační algebry — s důležitou poznámkou, že SQL je deklarativní! To znamená, že při psaní dotazu v jazyce relační algebry v podstatě říkáte, jak by se mělo počítat — zatímco s SQL říkáte, co chcete vyjmout, a pak databázový systém už generuje (efektivní) výrazy v jazyce relační algebry (jejich ekvivalence je známá jako ).
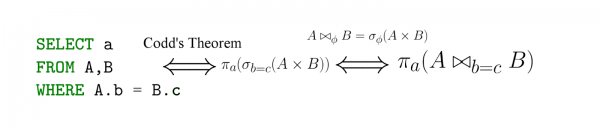
Vzato z článku.
Proč?
Relační DBMS: Oracle, Postgres, SQL Server atd. — stále jsou prakticky všude a je neuvěřitelně vysoká pravděpodobnost, že s nimi budete muset interagovat, což znamená, že budete muset buď číst SQL (což je velmi pravděpodobné), nebo na něm psát (také ne nepravděpodobné).
Co číst a studovat
Na stejných odkazech výše (o relační algebře) je obrovské množství materiálu, například .
Mimochodem, co je to NoSQL?
„Je třeba zdůraznit, že termín „NoSQL“ má zcela spontánní původ a nemá obecně uznávanou definici nebo vědeckou instituci za sebou.“ Příslušné na Habr.
V podstatě lidé pochopili, že úplný relační model není potřebný pro řešení mnoha úloh, zvláště pro ty, kde je například důležitá výkonnost a dominují určité jednoduché dotazy s agregací — je kritické rychle počítat metriky a zapisovat je do databáze, a většina funkcí relační síly se ukázala jako nejen nepotřebná, ale i škodlivá — proč normalizovat něco, pokud to poškodí to nejdůležitější pro nás (pro nějaký konkrétní úkol) — výkonnost?
Často potřebujeme flexibilnější schémata místo pevných matematických schémat klasického relačního modelu — což velmi usnadňuje vývoj aplikací, když je klíčové rychle nasadit systém a začít pracovat s výsledky — nebo schéma a typy uložených dat nejsou až tak důležité.
Například vytváříme expertní systém a chceme ukládat informace o určitém doméně spolu s nějakou metainformací — můžeme ani nevědět o všech polích a jednoduše ukládat JSON pro každý záznam — to nám dává velmi flexibilní prostředí pro rozšíření datového modelu a rychlou iteraci — proto v takovém případě bude NoSQL dokonce výhodnější a čitelnější. Příklad záznamu (z jednoho mého projektu, kde byl NoSQL přesně tam, kde bylo potřeba).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Více informací můžete přečíst o NoSQL.
Co se učit?
Zde je spíše potřeba dobře analyzovat svůj úkol, jaké má vlastnosti a které NoSQL systémy by mohly vyhovovat tomuto popisu — a poté se začít zabývat studiem daného systému.
Skriptovací jazyky dotazů
Zpočátku se může zdát, co má Python společného — je to programovací jazyk, a nikoliv jazyk pro dotazy.
- Pandas je jako švýcarský nůž Data Science, obrovské množství transformací dat, agregací atd. se v něm provádí.
- Numpy — vektorová výpočty, matice a lineární algebra zde.
- Scipy — v balíčku hodně matematiky, zejména statistiky.
- Jupyter lab — hodně explorativní analýzy dat se dobře hodí do notebooků — je dobré to umět.
- Requests — práce se sítí.
- Pyspark — velmi populární mezi datovými inženýry, pravděpodobně se budete muset zabývat tímto nebo Sparkem, jen kvůli jejich popularitě.
- *Selenium — velmi užitečný pro sběr dat z webových stránek a zdrojů, někdy není jiná cesta, jak data získat.
Moje hlavní rada: učte se Python!
Pandas
Vezmeme jako příklad následující kód:
import pandas as pd
df = pd.read_csv("data/dataset.csv")
# Vypočítat a přejmenovat agregace
all_together = (df[df['trip_type'] == "return"]
    .groupby(['start_station_name','end_station_name'])
    .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
    .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': 'min_duration_seconds',
           'amax': 'max_duration_seconds'}))
Ve skutečnosti vidíme, že kód zapadá do klasického SQL vzoru.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, .....
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Ale důležitá část — tento kód je součástí skriptu a pipeline, v podstatě vkládáme dotazy do Python pipeline. V této situaci jazyk dotazů přichází z knihoven jako Pandas nebo pySpark.
Celkově v pySpark vidíme podobný typ transformace dat skrze jazyk dotazů ve stylu:
df.filter(df.trip_type = "return")
  .groupby("day")
  .agg({duration: 'mean'})
  .sort()
Kde a co číst
O samém Pythonu vůbec najít materiály k učení. Na internetu je obrovské množství tutoriálů k , a kurzů k (a také o samotném ). Celkově se tyto materiály skvěle vyhledávají a pokud bych si měl vybrat jeden balíček, na který se vyplatí soustředit — bylo by to určitě pandas. K materiálům na propojení DS+Python je také .
Shell jako jazyk dotazů
Mnoho projektů pro zpracování a analýzu dat, s nimiž jsem pracoval — to jsou v podstatě shell skripty, které volají kód v Pythonu, v Javě a vlastně také samotné shell příkazy. Proto v zásadě můžeme pohlížet na pipeline v bash/zsh/atd. jako na určitý vysoce úrovňový dotaz (můžete do toho samozřejmě zahrnout i smyčky, ale to není obvyklé pro DS kód v shellových jazycích), uvedeme jednoduchý příklad — potřeboval jsem udělat mapping QID Wikidat a plných odkazů na ruskou a anglickou Wikipedii, k tomu jsem napsal jednoduchý dotaz z příkazů v bash a pro výstup napsal jednoduchý skript v Pythonu, který jsem sestavil takto:
pv "data/latest-all.json.gz" |
unpigz -c  |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py "output.csv"
kde
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' To byl v podstatě celý pipeline, který vytvářel potřebné mapování, jak vidíme, vše fungovalo v režimu streamu:
- pv filepath — zobrazuje progress bar na základě velikosti souboru a předává jeho obsah dál
- unpigz -c četl část archivu a poskytoval jq
- jq s klíčem — stream okamžitě vydával výsledek a předával ho postprocesoru (tak jako v prvním příkladu) na Pythonu
- uvnitř postprocesoru — to je jednoduchý stroj stavů, který formátoval výstup
Celkově složitý pipeline fungující v režimu proudu na velkých datech (0,5 TB), bez podstatných zdrojů a vyrobený z jednoduchého pipeline a několika nástrojů.
Další důležitá rada: umějte dobře a efektivně pracovat v terminálu a psát v bash/zsh/etc.
Kde to bude užitečné? V podstatě téměř všude – materiálů k učení je opět OPRAVDU hodně na internetu. Konkrétně, zde je můj předchozí článek.
R scripting
Opět může čtenář vykřiknout – vždyť je to celý programovací jazyk! A samozřejmě bude mít pravdu. Nicméně jsem se obvykle s R setkával v takovém kontextu, že to v podstatě bylo velmi podobné jazyku dotazů.
R je prostředí pro statistické výpočty a jazyk pro statistické výpočty a vizualizaci (podle ).
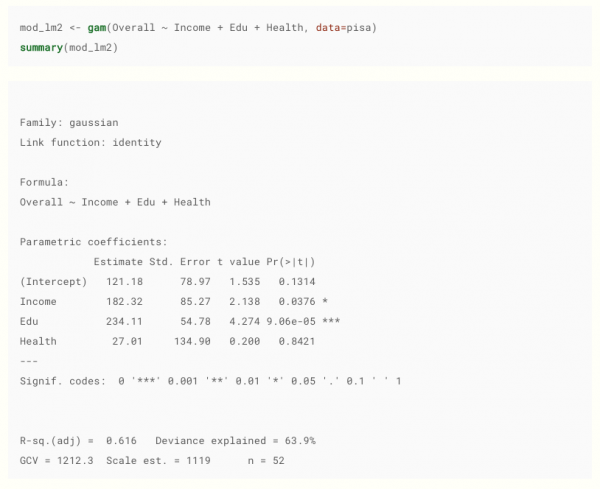
Vzato . Mimochodem, doporučuji, docela dobrý materiál.
Proč by se datový vědec měl učit R? Minimálně proto, že existuje obrovské množství lidí mimo IT, kteří se zabývají analýzou dat v R. Setkal jsem se s tím na následujících místech:
- Farmaceutický sektor.
- Biologové.
- Finanční sektor.
- Lidé s čistě matematickým vzděláním, kteří se zabývají statistikou.
- Specializované statistické modely a modely strojového učení (které lze často najít pouze v autorské verzi v podobě R balíčku).
Proč je to vlastně jazyk dotazů? V tom formátu, v jakém se často vyskytuje – to je vlastně dotaz na vytvoření modelu, včetně čtení dat a stanovení parametrů dotazu (modelu), stejně jako vizualizace dat v takových balíčcích jako ggplot2 – to je také forma psaní dotazů.
Příklad dotazů pro vizualizaci
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
Obecně mnoho myšlenek z R přechází do balíčků python, jako jsou pandas, numpy nebo scipy, jako datové rámce a vektorizace dat – proto se vám mnoho věcí v R bude zdát známých a pohodlných.
Zdroje pro studium jsou mnohé, například .
Grafy znalostí (Knowledge graph)
Zde mám trochu neobvyklou zkušenost, protože se často musím zabývat grafy znalostí a jazykem dotazů k grafům. Proto jen stručně přejdeme k základům, takto je tato část trochu exotická.
V klasických relačních databázích máme pevnou schéma – zde je schéma flexibilní, každý predikát je vlastně "sloupec" a ještě více.
Představte si, že modelujete člověka a chcete popsat klíčové věci, vezměme jako příklad konkrétní osobu Douglase Adamse, vyjdeme z tohoto popisu.
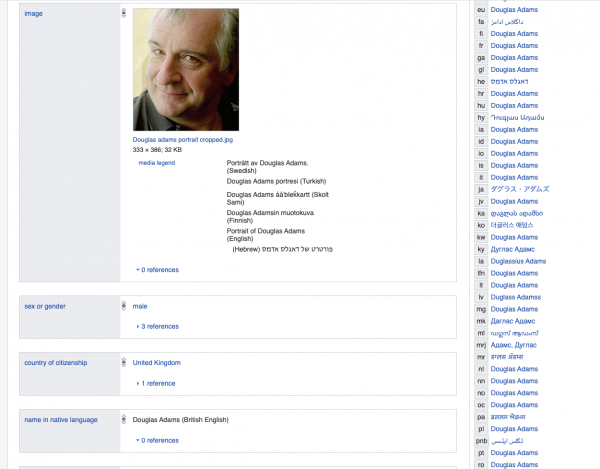
Pokud bychom použili relační databázi, museli bychom vytvořit obrovskou tabulku nebo tabulky s obrovským počtem sloupců, přičemž většina z nich by byla NULL nebo vyplněna nějakou výchozí hodnotou False, například málo z nás má zápis v národní korejské knihovně – samozřejmě bychom je mohli vyvést do samostatných tabulek, ale to by nakonec byla snaha modelovat flexibilní logickou schéma s predikáty pomocí pevné relační.
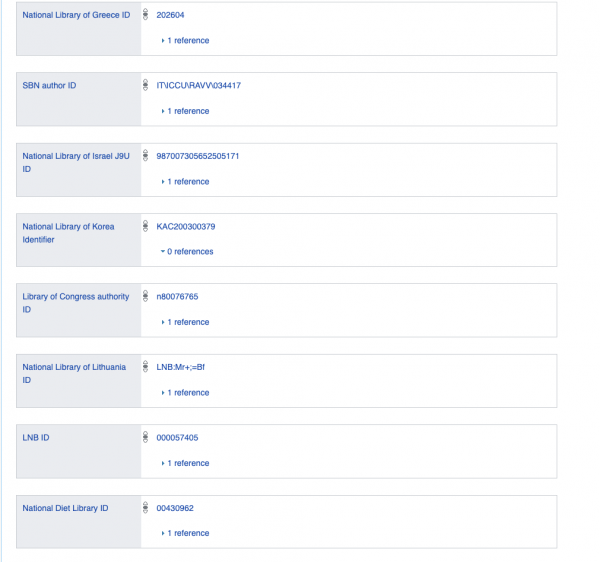
Takže si představte, že všechna data jsou uchovávána ve formě grafu nebo v podobě binárních a unárních logických výrazů.
Kde se s tím vlastně můžete setkat? Především při práci s , a také s jakýmikoli grafovými databázemi nebo propojenými daty.
Dále následují hlavní dotazovací jazyky, které jsem musel používat a se kterými jsem musel pracovat.
SPARQL
Wiki:
SPARQL ( od SPARQL Protocol and RDF Query Language) — , prezentovaná podle modelu , a také pro zasílání těchto dotazů a odpovědí na ně. SPARQL je doporučení a jedna z technologií .
Ve skutečnosti jde o jazyk dotazů na logické unární a binární predikáty. Jednoduše je podmíněně uvedeno, co je pevné v logickém výrazu a co ne (velmi zjednodušeně).
Samotná databáze RDF (Resource Description Framework), nad kterou se vykonávají SPARQL dotazy, je trojice objekt, predikát, subjekt – a dotaz vybírá potřebné trojice podle uvedených omezení ve smyslu: najít takové X, že p_55(X, q_33) je pravda – kde samozřejmě p_55 je nějaký vztah s ID 55 a q_33 je objekt s ID 33 (a to je vše, opět opouštíme různé detaily).
Příklad prezentace dat:
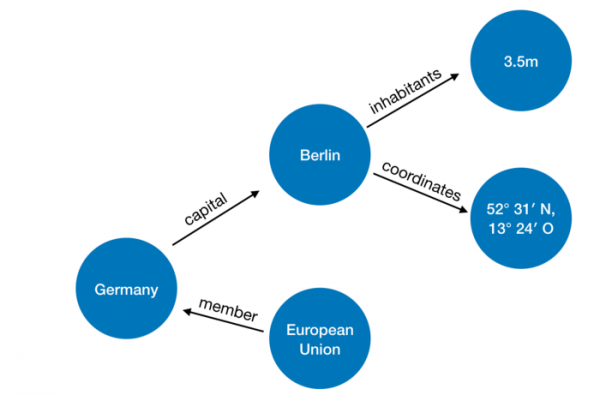
Obrázky a příklad se zeměmi jsou zde .
Příklad základního dotazu
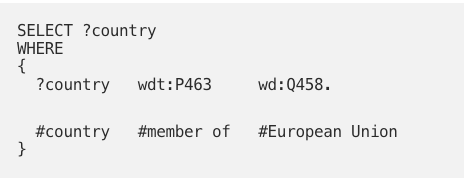
V podstatě chceme najít hodnotu proměnné ?country, tak že pro predikát
member_of je pravda, že member_of(?country,q458), a q458 je ID evropské unie.
Příklad skutečného dotazu SPARQL v rámci Python enginu:
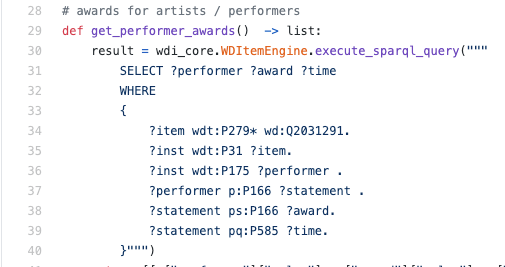
Obvykle jsem se setkával se čtením SPARQL, nikoli jeho psaním – v takové situaci je pravděpodobně užitečné mít alespoň základní porozumění jazyku, abychom pochopili, jak jsou data extrahována.
Online je k dispozici mnoho materiálů k učení: například zde a . Obvykle hledám konkrétní struktury a příklady a zatím to stačí.
Logické dotazovací jazyky
Více o tématu si můžete přečíst v mém článku . Zde se však pouze krátce podíváme na to, proč jsou logické jazyky vhodné pro psaní dotazů. V podstatě RDF představuje soubor logických tvrzení ve tvaru p(X) a h(X,Y), zatímco logický dotaz má následující podobu:
output(X) :- country(X), member_of(X, "EU").
Zde hovoříme o vytvoření nového predikátu output/1 (/1 znamená unární), za předpokladu, že pro X platí, že country(X) – tedy, X je země a také member_of(X, "EU").
To znamená, že jak data, tak pravidla jsou v tomto případě reprezentována zcela stejně, což umožňuje velmi snadné a efektivní modelování úloh.
Kde se v průmyslu setkáváme: velký projekt s firmou, která píše dotazy v takovém jazyce, a také aktuální projekt v jádru systému – na první pohled by se mohlo zdát, že jde o poměrně exotickou věc, ale občas se to objevuje.
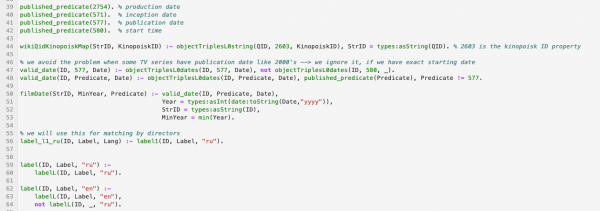
Příklad fragmentu kódu v logickém jazyce zpracovávajícím wikidata:
Materiály: zde uvedu pár odkazů na moderní logický programovací jazyk Answer Set Programming – doporučuji se ho učit:
Zdroj: habr.com
