

Drazí čtenáři, dobrý den. Dnes si trochu povíme o Apache Spark a jeho vyhlídkách na rozvoj.
V moderním světě Big Data je Apache Spark de facto standardem při vývoji úloh pro dávkovou zpracování dat. Kromě toho se využívá také k vytváření streamovacích aplikací, které pracují na principu micro batch a zpracovávají a dodávají data po malých dávkách (Spark Structured Streaming). Tradičně byl součástí celého Hadoop stacku, přičemž jako správce zdrojů využíval YARN (nebo v některých případech Apache Mesos). Do roku 2020 se jeho tradiční využití pro většinu firem dostává pod velký otazník kvůli nedostatku kvalitních distribucí Hadoop — vývoj HDP a CDH byl zastaven, CDH není dostatečně rozvinutý a má vysoké náklady, zatímco ostatní dodavatelé Hadoop buď přestali existovat, nebo mají nejasnou budoucnost. Proto stále větší zájem ze strany komunity a velkých společností vzbuzuje spuštění Apache Spark pomocí Kubernetes — jako standard v orchestraci kontejnerů a správě zdrojů v privátních a veřejných cloudech řeší problém s nepraktickým plánováním zdrojů úloh Spark na YARN a poskytuje stabilně se rozvíjející platformu s řadou komerčních a otevřených distribucí pro firmy všech velikostí a odvětví. Navíc, na vlně popularity si většina jich už stihla pořídit pár až tři vlastní instalace a nabrat odborné znalosti v jeho využívání, což usnadňuje přechod.
Od verze 2.3.0 získal Apache Spark oficiální podporu pro spuštění úloh v klastru Kubernetes a dnes si povíme o aktuální zralosti tohoto přístupu, různých možnostech jeho použití a úskalích, s nimiž se při implementaci setkáte.
Nejprve se podíváme na proces vývoje úloh a aplikací založených na Apache Spark a vymezíme typické případy, kdy je potřeba spustit úlohu na clusteru Kubernetes. Při přípravě tohoto příspěvku je jako distribuční systém použito OpenShift a budou uvedeny příkazy relevantní pro jeho příkazový řádek (oc). Pro jiné distribuce Kubernetes mohou být použity odpovídající příkazy standardního příkazového řádku Kubernetes (kubectl) nebo jejich analogy (například pro oc adm policy).
První možnost použití — spark-submit
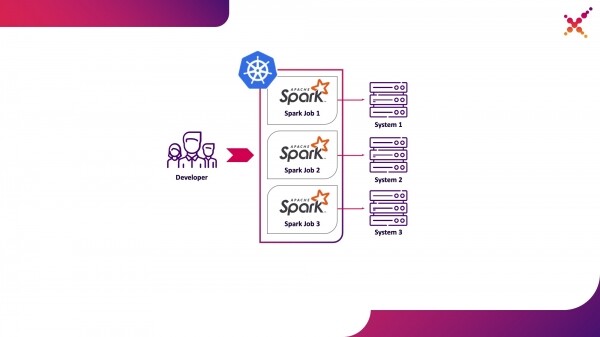
Během vývoje úloh a aplikací potřebuje vývojář spouštět úlohy pro ladění transformace dat. Teoreticky by pro tyto účely mohly být použity zástupné hodnoty, avšak vývoj s použitím skutečných (i když testovacích) instancí koncových systémů se v této třídě úloh ukázal být rychlejší a kvalitnější. V případě, že provádíme ladění na skutečných instancích koncových systémů, jsou možné dva scénáře činnosti:
- vývojář spouští úlohu Spark lokálně v režimu standalone;

- vývojář spouští úlohu Spark na clusteru Kubernetes v testovacím prostředí.
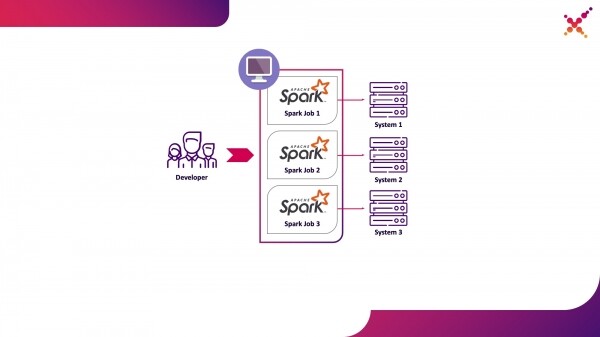
První možnost má své opodstatnění, ale nese s sebou řadu nevýhod:
- pro každého vývojáře je nutné zajistit přístup z pracovního místa ke všem potřebným instancím koncových systémů;
- na pracovní stanici je třeba mít dostatek zdrojů pro spuštění vyvíjené úlohy.
Druhá možnost je těchto neduhů zbavena, neboť využití clusteru Kubernetes umožňuje vyčlenit potřebný rozsah zdrojů pro spuštění úloh a zajistit pro něj potřebné přístupy k instancím koncových systémů, pružně poskytovat přístup pomocí modelu rolí Kubernetes všem členům vývojového týmu. Uvědomme si to jako první možnost použití — spuštění úloh Spark z lokálního stroje vývojáře na clusteru Kubernetes v testovacím prostředí.
Podrobněji si řekneme o procesu nastavení Spark pro lokální spuštění. Chcete-li začít používat Spark, je nutné jej nainstalovat:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Sestavujeme potřebné balíčky pro práci s Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Celá sestava zabere hodně času, a pro vytváření obrazů Docker a jejich spuštění na clusteru Kubernetes potřebujeme ve skutečnosti pouze jar soubory z adresáře „assembly/“, a tak můžeme sestavit jen tento podprojekt:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Pro spuštění úloh Spark v Kubernetes je nutné vytvořit obraz Docker, který bude použit jako základní. Zde jsou možné 2 přístupy:
- Vytvořený obraz Docker zahrnuje vykonávatelný kód úlohy Spark;
- Vytvořený obraz zahrnuje pouze Spark a potřebné závislosti, vykonávatelný kód je umístěn vzdáleně (například v HDFS).
Nejprve vytvoříme obraz Docker, který obsahuje testovací příklad úlohy Spark. Pro vytváření obrazů Docker má Spark odpovídající nástroj nazvaný „docker-image-tool“. Prozkoumejme jeho nápovědu:
./bin/docker-image-tool.sh --help
S jeho pomocí lze vytvářet obrazy Docker a provádět jejich nahrávání do vzdálených registrů, ale ve výchozím nastavení má řadu nedostatků:
- uctívá povinnost ihned vytvořit 3 obrazy Docker — pro Spark, PySpark a R;
- neumožňuje zadat název obrazu.
Proto budeme používat modifikovanou verzi tohoto nástroje, uvedenou níže:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
S její pomocí sestavujeme základní obraz Spark, který obsahuje testovací úlohu pro výpočet čísla Pi pomocí Spark (přičemž {docker-registry-url} je URL vašeho registru obrazů Docker, {repo} je název repozitáře uvnitř registru, který odpovídá projektu v OpenShift, {image-name} je název obrazu (pokud se používá tříúrovňové rozdělení obrazů, například v integrovaném registru obrazů Red Hat OpenShift), {tag} je tag této verze obrazu):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Přihlásíme se do clusteru OKD pomocí konzolového nástroje (zde {OKD-API-URL} je URL API clusteru OKD):
oc login {OKD-API-URL}
Získáme token aktuálního uživatele pro autorizaci v Docker Registry:
oc whoami -t
Přihlásíme se do interního Docker Registry clusteru OKD (jako heslo použijeme token získaný pomocí předchozího příkazu):
docker login {docker-registry-url}
Nahrajeme sestavený obraz Docker do Docker Registry OKD:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Zkontrolujeme, zda je shromážděný obraz dostupný v OKD. K tomu otevřeme v prohlížeči URL se seznamem obrazů odpovídajícího projektu (zde {project} — jméno projektu uvnitř klastru OpenShift, {OKD-WEBUI-URL} — URL webové konzole OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Pro spuštění úloh je třeba vytvořit servisní účet s oprávněním spouštět pody pod root (tento aspekt budeme dále probírat):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Proveďme příkaz spark-submit pro publikaci úlohy Spark v klastru OKD, přičemž uvedeme vytvořený servisní účet a obraz Docker:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Zde:
—name — jméno úlohy, které se zapojí do vytváření názvů podů Kubernetes;
—class — třída spouštěného souboru vyvolávaného při spuštění úlohy;
—conf — konfigurační parametry Spark;
spark.executor.instances — počet spouštěných exekutorů Spark;
spark.kubernetes.authenticate.driver.serviceAccountName — jméno služebního účtu Kubernetes používaného při spuštění podů (pro určení bezpečnostního kontextu a oprávnění při interakci s API Kubernetes);
spark.kubernetes.namespace — prostor názvů Kubernetes, ve kterém budou spuštěny pody řidiče a exekutorů;
spark.submit.deployMode — mód spuštění Spark (pro standardní spark-submit se používá „cluster“, pro Spark Operator a novější verze Spark „client“);
spark.kubernetes.container.image — obraz Docker používaný pro spuštění podů;
spark.master — URL API Kubernetes (uvádí se externě, takže přístup probíhá z místního počítače);
local:// — cesta k spouštěnému souboru Spark uvnitř obrazu Docker.
Přejdeme do odpovídajícího projektu OKD a prozkoumáme vytvořené pody — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Pro zjednodušení procesu vývoje může být použit další variant, kdy se vytvoří sdílený základní obraz Spark, který používají všechny úlohy pro spuštění, a snímky spouštěcích souborů se publikují do externího úložiště (například Hadoop) a uvádějí se při volání spark-submit jako odkaz. V tomto případě je možné spouštět různé verze úloh Spark bez opětovného sestavení obrazů Docker, přičemž pro publikaci obrazů lze používat například WebHDFS. Odesíláme požadavek na vytvoření souboru (zde {host} — hostitel služby WebHDFS, {port} — port služby WebHDFS, {path-to-file-on-hdfs} — požadovaná cesta k souboru na HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE"
Tím se získá odpověď ve formátu (zde {location} je URL, které je třeba použít pro nahrání souboru):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Nahráváme spustitelný soubor Spark do HDFS (zde {path-to-local-file} je cesta k spustitelnému souboru Spark na aktuálním hostiteli):
curl -i -X PUT -T {path-to-local-file} "{location}"
Po tomto můžeme provést spark-submit s použitím souboru Spark, který byl nahrán do HDFS (zde {class-name} je název třídy, kterou je třeba spustit pro provedení úkolu):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Je třeba poznamenat, že pro přístup k HDFS a zajištění funkčnosti úkolu může být nutné změnit Dockerfile a skript entrypoint.sh — přidat do Dockerfile direktivu pro kopírování závislých knihoven do adresáře /opt/spark/jars a zahrnout konfigurační soubor HDFS do SPARK_CLASSPATH v entrypoint.sh.
Druhá varianta použití — Apache Livy
Dále, když je úkol vyvinut a je třeba otestovat získaný výsledek, vzniká otázka jeho spuštění v rámci CI/CD procesu a sledování statusů jeho vykonávání. Samozřejmě, že je možné ho spouštět i pomocí lokálního volání spark-submit, ale to komplikuje infrastrukturu CI/CD, protože vyžaduje instalaci a konfiguraci Spark na agentech/běžitelích CI serveru a nastavení přístupu k Kubernetes API. Pro tento případ byla zvolena cílová implementace s využitím Apache Livy jako REST API pro spouštění úloh Spark, umístěného uvnitř clusteru Kubernetes. Pomocí něj je možné spouštět úlohy Spark v clusteru Kubernetes pomocí běžných cURL požadavků, což je snadno realizovatelné na jakémkoli CI řešení, a jeho umístění uvnitř clusteru Kubernetes řeší otázku autentizace při interakci s Kubernetes API.
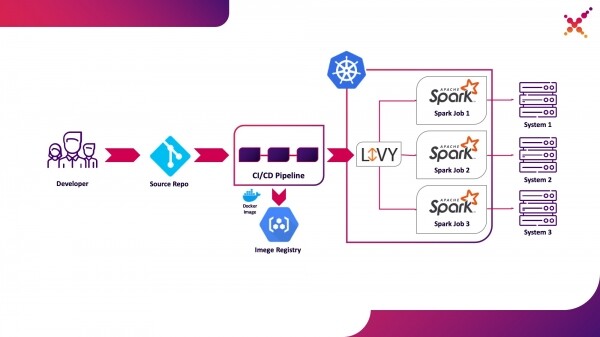
Vyčleňme ho jako druhou variantu použití — spuštění úloh Spark v rámci CI/CD procesu v clusteru Kubernetes v testovacím obvodu.
Něco málo o Apache Livy — funguje jako HTTP server, poskytující webové rozhraní a RESTful API, které umožňuje vzdáleně spustit spark-submit, předávat potřebné parametry. Tradičně se dodával v rámci distribuce HDP, ale může být také nasazen v OKD nebo jiné instalaci Kubernetes pomocí příslušného manifestu a sady Docker obrazů, například tohoto — . Pro náš případ byl sestaven podobný Docker obraz, který zahrnuje Spark verze 2.4.5 ze následujícího Dockerfile:
Z java:8-alpine

ENV SPARK_HOME=\/opt\/spark
ENV LIVY_HOME=\/opt\/livy
ENV HADOOP_CONF_DIR=\/etc\/hadoop\/conf
ENV SPARK_USER=spark

WORKDIR \/opt

RUN apk add --update openssl wget bash &&
    wget -P \/opt https:\/\/downloads.apache.org\/spark\/spark-2.4.5\/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s \/opt\/spark-2.4.5-bin-hadoop2.7 \/opt\/spark

RUN wget http:\/\/mirror.its.dal.ca\/apache\/incubator\/livy\/0.7.0-incubating\/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s \/opt\/apache-livy-0.7.0-incubating-bin \/opt\/livy &&
    mkdir \/var\/log\/livy &&
    ln -s \/var\/log\/livy \/opt\/livy\/logs &&
    cp \/opt\/livy\/conf\/log4j.properties.template \/opt\/livy\/conf\/log4j.properties

ADD livy.conf \/opt\/livy\/conf
ADD spark-defaults.conf \/opt\/spark\/conf\/spark-defaults.conf
ADD entrypoint.sh \/entrypoint.sh

ENV PATH="\/opt\/livy\/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["\/entrypoint.sh"]
CMD ["livy-server"]
Vytvořený obraz lze sestavit a nahrát do vašeho existujícího repozitáře Docker, například do interního repozitáře OKD. Pro jeho nasazení se používá následující manifest ({registry-url} — URL repozitáře obrazů Docker, {image-name} — název obrazu Docker, {tag} — tag obrazu Docker, {livy-url} — požadovaná URL, na které bude server Livy dostupný; manifest „Route“ se používá, pokud se jako distribuce Kubernetes používá Red Hat OpenShift, jinak se použije odpovídající manifest Ingress nebo typu Service NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Po jeho použití a úspěšném spuštění podu je grafické rozhraní Livy dostupné na odkazu: http://{livy-url}/ui. S Livy můžeme publikovat naši úlohu Spark pomocí REST požadavku, například z Postmanu. Příklad sbírky s požadavky je uveden níže (v poli „args“ mohou být předány konfigurační argumenty s proměnnými potřebnými pro fungování spouštěné úlohy):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Odeslat úlohu s jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt"file": "local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar", nt"className": "org.apache.spark.examples.SparkPi",nt"numExecutors":1,nt"name": "spark-test-1",nt"conf": {ntt"spark.jars.ivy": "/tmp/.ivy",ntt"spark.kubernetes.authenticate.driver.serviceAccountName": "spark",ntt"spark.kubernetes.namespace": "{project}",ntt"spark.kubernetes.container.image": "{docker-registry-url}/{repo}/{image-name}:{tag}"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Odeslat úlohu bez jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt"file": "hdfs://{host}:{port}/{path-to-file-on-hdfs}", nt"className": "{class-name}",nt"numExecutors":1,nt"name": "spark-test-2",nt"proxyUser": "0",nt"conf": {ntt"spark.jars.ivy": "/tmp/.ivy",ntt"spark.kubernetes.authenticate.driver.serviceAccountName": "spark",ntt"spark.kubernetes.namespace": "{project}",ntt"spark.kubernetes.container.image": "{docker-registry-url}/{repo}/{image-name}:{tag}"nt},nt"args": [ntt"HADOOP_CONF_DIR=/opt/spark/hadoop-conf",ntt"MASTER=k8s://https://kubernetes.default.svc:8443"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Spustíme první požadavek z kolekce, přejdeme do rozhraní OKD a zkontrolujeme, že úloha byla úspěšně spuštěna — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. V rozhraní Livy (http://{livy-url}/ui) se objeví relace, v rámci které lze pomocí API Livy nebo grafického rozhraní sledovat průběh provádění úlohy a zkoumat protokoly relace.
Nyní ukážeme mechanismus fungování Livy. K tomu prozkoumáme protokoly kontejneru Livy uvnitř podu se serverem Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Z nich je patrné, že při volání REST API Livy se v kontejneru s názvem „livy“ provádí spark-submit, obdobně jako bylo použito výše (zde {livy-pod-name} je název vytvořeného podu se serverem Livy). V kolekci je také představen druhý dotaz, který umožňuje spouštět úlohy s dálkovým umístěním spustitelného souboru Spark pomocí serveru Livy.
Třetí variantou použití je Spark Operator
Nyní, když byla úloha otestována, vyvstává otázka její pravidelné spouštění. Nativním způsobem pro pravidelné spouštění úloh v klastru Kubernetes je entita CronJob a lze ji použít, ale v současnosti má velkou popularitu používání operatorů pro správu aplikací v Kubernetes a pro Spark existuje dostatečně vyzrálý operator, který je mimo jiné používán v podnikových řešeních (například Lightbend FastData Platform). Doporučujeme jeho použití — aktuální stabilní verze Spark (2.4.5) má poměrně omezené možnosti konfigurace spuštění úloh Spark v Kubernetes, zatímco v následující majoritní verzi (3.0.0) byla oznámena plná podpora Kubernetes, ale datum jejího vydání zůstává neznámé. Spark Operator tento nedostatek kompenzuje přidáním důležitých konfiguračních parametrů (například montování ConfigMap s konfigurací přístupu k Hadoop do podů Spark) a možností pravidelného spuštění úlohy podle plánu.
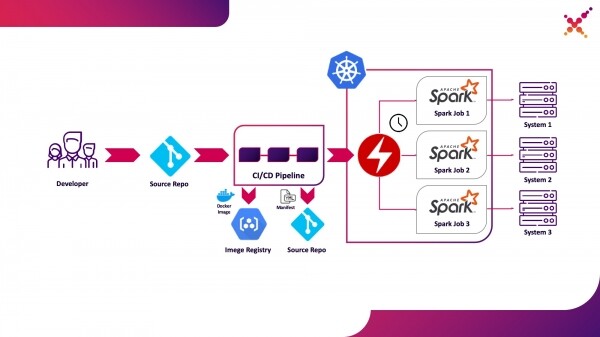
Vyčleňujeme ho jako třetí variantu použití — pravidelné spouštění úloh Spark v klastru Kubernetes v produkčním prostředí.
Spark Operator má otevřený zdrojový kód a je vyvíjen v rámci Google Cloud Platform — . Jeho instalace může být provedena třemi způsoby:
- V rámci instalace Lightbend FastData Platform/Cloudflow;
- Pomocí Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Použitím manifestů z oficiálního repozitáře (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Je třeba poznamenat, že Cloudflow obsahuje operátor s verzí API v1beta1. Pokud je použit tento typ instalace, popisy manifestů aplikací Spark by měly být založeny na příkladech z tagů v Gitu s odpovídající verzí API, například „v1beta1-0.9.0-2.4.0“. Verzi operátora lze zjistit v popisu CRD, který je součástí operátora ve slovníku „versions“:
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Pokud je operátor nainstalován správně, v odpovídajícím projektu se objeví aktivní pod s operátorem Spark (například cloudflow-fdp-sparkoperator v prostoru Cloudflow pro instalaci Cloudflow) a objeví se odpovídající typ zdrojů Kubernetes s názvem „sparkapplications“. K prozkoumání existujících aplikací Spark lze použít následující příkaz:
oc get sparkapplications -n {project}
Pro spuštění úloh pomocí Spark Operator je třeba provést 3 věci:
- vytvořit obraz Docker, který obsahuje všechny nezbytné knihovny, stejně jako konfigurační a spustitelné soubory. V cílovém obrazu jde o obraz vytvořený na etapě CI/CD a otestovaný na testovacím clusteru;
- publikovat obraz Docker do registru, který je dostupný z clusteru Kubernetes;
- vytvořit manifest typu „SparkApplication“ a popisované úlohy, která se má spustit. Příklady manifestů jsou dostupné v oficiálním repozitáři (například, ). Je třeba si uvědomit důležité body týkající se manifestu:
- ve slovníku „apiVersion“ by měla být uvedena verze API, která odpovídá verzi operátora;
- ve slovníku „metadata.namespace“ by mělo být uvedeno jméno prostoru, ve kterém bude aplikace spuštěna;
- ve slovníku „spec.image“ by měla být uvedena adresa vytvořeného obrazu Docker v dostupném registru;
- ve slovníku „spec.mainClass“ by měl být uveden název třídy úlohy Spark, kterou je třeba spustit při zahájení procesu;
- ve slovníku „spec.mainApplicationFile“ by měla být uvedena cesta k spustitelnému jar souboru;
- ve slovníku „spec.sparkVersion“ by měla být uvedena používaná verze Spark;
- ve slovníku „spec.driver.serviceAccount“ by měla být uvedena servisní účet uvnitř příslušného prostoru Kubernetes, který bude použit pro spuštění aplikace;
- ve slovníku „spec.executor“ by mělo být uvedeno množství prostředků, které budou aplikaci přiděleny.
- Ve slovníku „spec.volumeMounts“ musí být uveden místní adresář, ve kterém budou vytvářeny místní soubory úlohy Spark.
Příklad vytvoření manifestu (zde {spark-service-account} — servisní účet v rámci klastru Kubernetes pro spuštění úloh Spark):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
V tomto manifestu je uveden servisní účet, pro který je třeba před publikací manifestu vytvořit potřebné vazby rolí, které poskytují potřebná oprávnění pro interakci aplikace Spark s API Kubernetes (pokud je potřeba). V našem případě potřebuje aplikace oprávnění k vytváření Podů. Vytvoříme potřebnou vazbu role:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Také stojí za zmínku, že ve specifikaci tohoto manifestu může být uveden parametr „hadoopConfigMap“, který umožňuje specifikovat ConfigMap s konfigurací Hadoop bez nutnosti předchozího umístění příslušného souboru do obrazu Docker. Je také vhodný pro pravidelné spuštění úloh — pomocí parametru „schedule“ lze určit rozvrh spuštění této úlohy.
Poté uložíme náš manifest do souboru spark-pi.yaml a použijeme ho na našem klastru Kubernetes:
oc apply -f spark-pi.yaml
Přitom se vytvoří objekt typu „sparkapplications“:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Přitom se vytvoří pod s aplikací, jejíž stav bude zobrazen v vytvořených „sparkapplications“. Lze jej zobrazit následujícím příkazem:
oc get sparkapplications spark-pi -o yaml -n {project}
Po dokončení úlohy POD přejde do stavu „Completed“, který se také aktualizuje v „sparkapplications“. Logy aplikace lze zobrazit v prohlížeči nebo pomocí následujícího příkazu (zde {sparkapplications-pod-name} — název podu spuštěné úlohy):
oc logs {sparkapplications-pod-name} -n {project}
Správa úloh Spark může být také provedena pomocí specializovaného nástroje sparkctl. Pro jeho instalaci klonujeme repozitář s jeho zdrojovým kódem, nainstalujeme Go a sestavíme tento nástroj:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Podívejme se na seznam běžících úloh Spark:
sparkctl list -n {project}
Vytvoříme popis pro úlohu Spark:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "tmp"
Spustíme popsanou úlohu pomocí sparkctl:
sparkctl create spark-app.yaml -n {project}
Podívejme se na seznam běžících úloh Spark:
sparkctl list -n {project}
Podívejme se na seznam událostí spuštěné úlohy Spark:
sparkctl event spark-pi -n {project} -f
Podívejme se na stav spuštěné úlohy Spark:
sparkctl status spark-pi -n {project}
Na závěr bychom chtěli projednat nalezené nevýhody používání aktuální stabilní verze Spark (2.4.5) v Kubernetes:
- Prvním a pravděpodobně hlavním negativem je absence místní dostupnosti dat. I přes všechny nedostatky YARN mělo používání jeho výhody, například princip doručování kódu k datům (nikoli dat kódu). Díky tomu byly úkoly Spark prováděny na uzlech, kde se nacházela data, která byla součástí výpočtů, a tím se značně zkrátila doba potřebná k přenosu dat přes síť. Při používání Kubernetes se setkáváme s nutností přenášet data potřebná k práci úkolů přes síť. Pokud jsou dostatečně velká, může se výrazně zvýšit doba dokončení úkolu a také bude potřeba dostatečně velký objem diskového prostoru vyhrazeného pro instance úkolů Spark pro jejich dočasné uložení. Tento nedostatek lze zmírnit pomocí specializovaných softwarových nástrojů, které zajišťují místní dostupnost dat v Kubernetes (například Alluxio), což však de facto znamená, že je nutné uchovávat úplnou kopii dat na uzlech Kubernetes clusteru.
- Druhým důležitým negativem je bezpečnost. Funkce související s zajištěním bezpečnosti při spuštění úkolů Spark jsou ve výchozím nastavení vypnuté, možnost použití Kerberos není zmíněna v oficiální dokumentaci (i když odpovídající parametry se objevily ve verzi 3.0.0, což vyžaduje další zpracování), a v dokumentaci k zajištění bezpečnosti při použití Spark (https://spark.apache.org/docs/2.4.5/security.html) se jako úložiště klíčů uvádějí pouze YARN, Mesos a Standalone Cluster. Uživatel, pod kterým se úkoly Spark spouští, nemůže být zadán přímo — pouze nastavujeme servisní účet, pod kterým bude proces běžet, a uživatel je vybírán na základě nastavených bezpečnostních politik. V tomto ohledu buď používáme uživatele root, což není bezpečné v produkčním prostředí, nebo uživatele s náhodným UID, což je nepraktické při rozdělování přístupových práv k datům (což lze vyřešit vytvořením PodSecurityPolicies a jejich přiřazením k příslušným servisním účtům). V současnosti se to řeší buď umístěním všech potřebných souborů přímo do Docker obrázku, nebo úpravou spouštěcího skriptu Spark pro použití mechanismu ukládání a získávání tajemství přijatého ve vaší organizaci.
- Spuštění úloh Spark pomocí Kubernetes je oficiálně stále v experimentálním režimu a v budoucnu mohou nastat značné změny v používaných artefaktech (konfiguračních souborech, základních Docker obrazech a spouštěcích skriptech). Opravu – při přípravě materiálu byly testovány verze 2.3.0 a 2.4.5, jejich chování se výrazně lišilo.
Budeme čekat na aktualizace – nedávno byla vydána nová verze Spark (3.0.0), která přinesla významné změny v chodu Spark na Kubernetes, ale stále si ponechává experimentální status podpory tohoto správce zdrojů. Je možné, že příští aktualizace skutečně umožní plně doporučit opustit YARN a spouštět úlohy Spark na Kubernetes, aniž byste se museli obávat o bezpečnost vašeho systému a bez nutnosti samostatné úpravy funkčních komponentů.
Konec.
Zdroj: habr.com
